Globaler Weizenkopf-Datensatz#
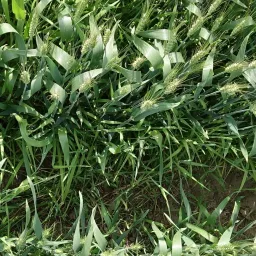
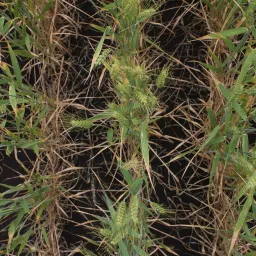
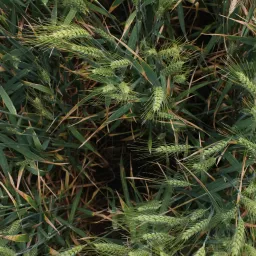
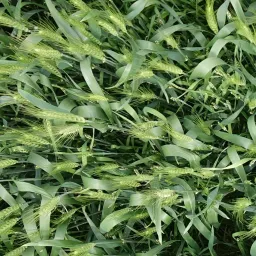
Der globale Weizenkopf-Datensatz (GWHD) ist ein Objekterkennungs-Datensatz mit einer Klasse, der Weizenähren – die Körner tragenden Ähren der Weizenpflanze – in Außenaufnahmen von Feldern erfasst. Er umfasst 3.422 Trainingsbilder, 748 Validierungsbilder und 1.276 Testbilder aus mehreren Anbaugebieten. Neun Forschungsinstitute aus sieben Ländern haben ihn gemeinsam erstellt, damit Modelle auf verschiedene Umgebungen generalisieren. Eine präzise Erkennung von Weizenähren bildet die Grundlage für Schätzungen der Ährendichte, der Ährengröße und des Ertragspotenzials in der Pflanzenphänotypisierung und im Pflanzenbau.
Wichtige Funktionen#
- Echte Außenaufnahmen von Feldern, die die natürliche Variabilität des Aussehens der Weizenähren, der Lichtverhältnisse und der Wachstumsstadien erfassen.
- Von neun Forschungsinstituten aus sieben Ländern zusammengestellt. Der Datensatz deckt Anbaugebiete in Europa, Nordamerika, Asien und Australien ab und ermöglicht eine zuverlässige Generalisierung auf unterschiedliche Umgebungen.
- Bounding-Box-Annotationen für eine Klasse,
wheat_head, bereit für Objekterkennungs- und Tracking-Abläufe. - Die Testbilder stammen aus Genotypen und Regionen, die im Training nicht vorkamen, und bieten so einen aussagekräftigen Maßstab für die Generalisierung.
Datensatzstruktur#
Der globale Weizenkopf-Datensatz ist in drei Teilmengen gegliedert, die in der Konfiguration GlobalWheat2020.yaml festgelegt sind. Alle Bilder sind mit einer einzigen Klasse annotiert: wheat_head:
| Aufteilung | Bilder | Regionen |
|---|---|---|
| Trainieren | 3,422 | Europa (Frankreich, Vereinigtes Königreich, Schweiz), Nordamerika (Kanada) |
| Validierung | 748 | Schweiz (ETH Zürich) |
| Test | 1,276 | Australien, Japan, China |
Der Validierungssatz (748 Bilder) ist die Teilmenge ethz_1, die auch im Trainingssatz enthalten ist – die Validierungsmetriken werden also anhand von Bildern gemessen, mit denen das Modell ebenfalls trainiert. Der zurückgehaltene Testsatz aus Australien, Japan und China misst die Generalisierungsfähigkeit auf Umgebungen, die während des Trainings nicht zu sehen waren.
Anwendungsfälle#
Der Global Wheat Head Dataset wird häufig zum Trainieren und Evaluieren von Modellen für Deep Learning zur Erkennung von Weizenähren verwendet. Die vielfältigen Aufnahmen aus verschiedenen Regionen, Genotypen und Bedingungen machen ihn zu einer wertvollen Ressource für die Pflanzenphänotypisierung und das Pflanzenmanagement – er unterstützt die Ertragsschätzung, die Überwachung der Pflanzengesundheit und die phänotypische Analyse.
Führe den gesamten Arbeitsablauf mit der Ultralytics Platform in deinem Browser aus, um Feldaufnahmen zu annotieren, Modelle zu trainieren und Dataset-Versionen zu verwalten.
YAML-Datei des Datensatzes#
Eine YAML-Datei dient zum Definieren der Dataset-Konfiguration. Sie enthält die Pfade, Klassen und weitere Konfigurationsdetails des Datasets. Für den Global Wheat Head Dataset wird die Datei GlobalWheat2020.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Global Wheat 2020 dataset https://www.global-wheat.com/ by University of Saskatchewan
# Documentation: https://docs.ultralytics.com/datasets/detect/globalwheat2020
# Example usage: yolo train data=GlobalWheat2020.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── GlobalWheat2020 ← downloads here (7.0 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: GlobalWheat2020 # dataset root dir
train: # train images (relative to 'path') 3422 images
  - images/arvalis_1
  - images/arvalis_2
  - images/arvalis_3
  - images/ethz_1
  - images/rres_1
  - images/inrae_1
  - images/usask_1
val: # val images (relative to 'path') 748 images (WARNING: train set contains ethz_1)
  - images/ethz_1
test: # test images (optional) 1276 images
  - images/utokyo_1
  - images/utokyo_2
  - images/nau_1
  - images/uq_1

# Classes
names:
  0: wheat_head

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  from pathlib import Path

  from ultralytics.utils.downloads import download

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = [
      "https://zenodo.org/record/4298502/files/global-wheat-codalab-official.zip",
      "https://github.com/ultralytics/assets/releases/download/v0.0.0/GlobalWheat2020_labels.zip",
  ]
  download(urls, dir=dir)

  # Make Directories
  for p in "annotations", "images", "labels":
      (dir / p).mkdir(parents=True, exist_ok=True)

  # Move
  for p in (
      "arvalis_1",
      "arvalis_2",
      "arvalis_3",
      "ethz_1",
      "rres_1",
      "inrae_1",
      "usask_1",
      "utokyo_1",
      "utokyo_2",
      "nau_1",
      "uq_1",
  ):
      (dir / "global-wheat-codalab-official" / p).rename(dir / "images" / p)  # move to /images
      f = (dir / "global-wheat-codalab-official" / p).with_suffix(".json")  # json file
      if f.exists():
f.rename((dir / "annotations" / p).with_suffix(".json")) # move to /annotationsVerwendung#
Um ein YOLO26n-Modell 100 Epochen lang mit einer Bildgröße von 640 auf dem Global Wheat Head Dataset zu trainieren, kannst du die folgenden Codebeispiele verwenden. Das Dataset (~7.0 GB) wird beim ersten Verwenden automatisch heruntergeladen. Eine umfassende Liste der verfügbaren Argumente findest du auf der Seite Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
Der Global Wheat Head Dataset enthält eine vielfältige Auswahl an Außenaufnahmen von Feldern, die die natürliche Variabilität des Aussehens von Weizenähren sowie ihrer Umgebungen und Bedingungen erfassen. Hier siehst du ein Beispielbild aus dem Dataset mit den zugehörigen Annotationen:
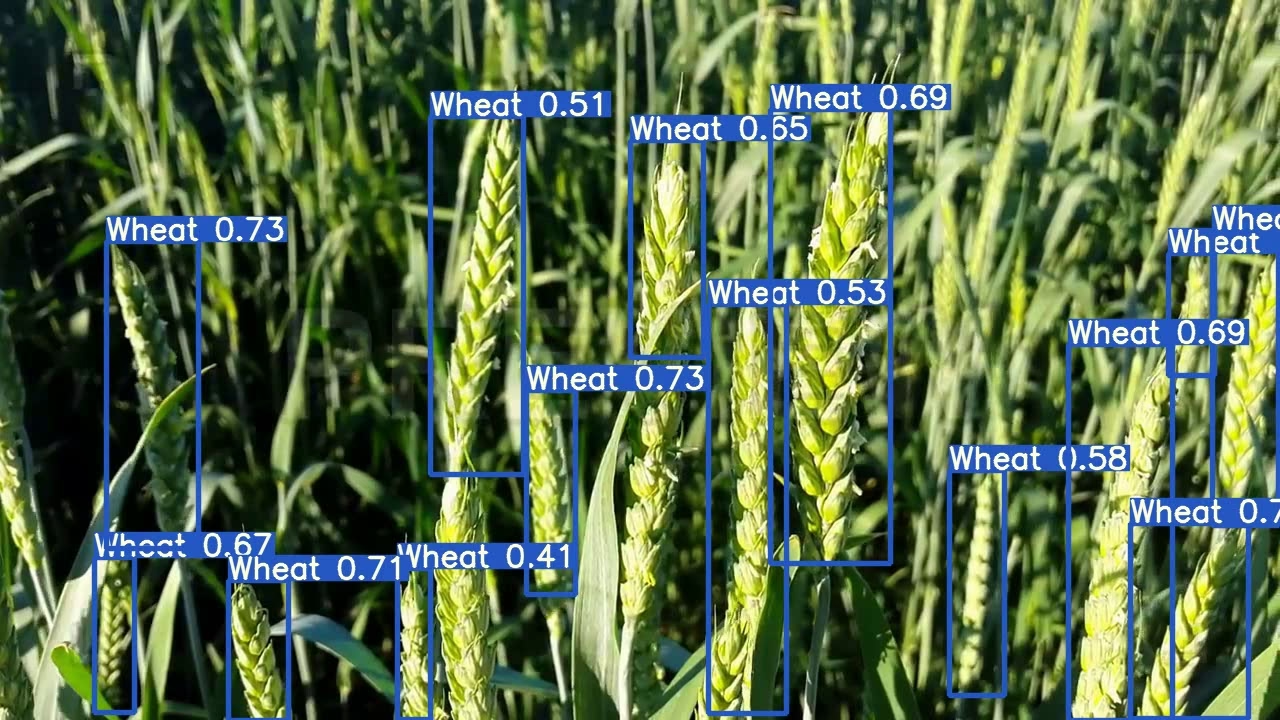
- Erkennung von Weizenähren: Weizenähren sind unter verschiedenen Feldbedingungen mit Begrenzungsrahmen für die Objekterkennung annotiert. Die Bedingungen spiegeln die Vielfalt und Komplexität des Datasets wider.
Zitate und Danksagungen#
Wenn du den Global Wheat Head Dataset für deine Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Veröffentlichung:
@article{david2020global,
         title={Global Wheat Head Detection (GWHD) Dataset: A Large and Diverse Dataset of High-Resolution RGB-Labelled Images to Develop and Benchmark Wheat Head Detection Methods},
         author={David, Etienne and Madec, Simon and Sadeghi-Tehran, Pouria and Aasen, Helge and Zheng, Bangyou and Liu, Shouyang and Kirchgessner, Norbert and Ishikawa, Goro and Nagasawa, Koichi and Badhon, Minhajul and others},
         journal={arXiv preprint arXiv:2005.02162},
         year={2020}
}
Wir möchten den Forschenden und Institutionen danken, die zur Erstellung und Pflege des Global Wheat Head Dataset als wertvolle Ressource für die Forschungsgemeinschaft im Bereich Pflanzenphänotypisierung und Pflanzenmanagement beigetragen haben. Weitere Informationen zum Dataset und seinen Erstellern findest du auf der Website des Global Wheat Head Dataset.
Häufig gestellte Fragen#
Der Global Wheat Head Dataset wird vor allem zum Entwickeln und Trainieren von Modellen für Deep Learning zur Erkennung von Weizenähren verwendet. Dies ist für Anwendungen in der Weizenphänotypisierung und im Pflanzenmanagement entscheidend, denn so lassen sich Dichte und Größe der Weizenähren sowie das Ertragspotenzial der gesamten Ernte genauer schätzen. Präzise Erkennungsmethoden helfen bei der Beurteilung von Pflanzengesundheit und Reifegrad – wichtige Voraussetzungen für ein effizientes Pflanzenmanagement.
Der Global Wheat Head Dataset umfasst eine einzelne Klasse,
wheat_head, und ist in drei Teilmengen aufgeteilt: 3.422 Trainingsbilder, 748 Validierungsbilder und 1.276 Testbilder. Die Trainings- und Validierungsbilder stammen aus Europa und Nordamerika. Der Testsatz umfasst Bilder aus Australien, Japan und China, um die Generalisierungsfähigkeit auf unbekannte Umgebungen zu bewerten.Um ein YOLO26n-Modell mit dem Global Wheat Head Dataset zu trainieren, kannst du die folgenden Codebeispiele verwenden. Stelle sicher, dass du die Konfigurationsdatei
GlobalWheat2020.yamlmit den Dataset-Pfaden und Klassen hast:Trainingsbeispielfrom ultralytics import YOLO # Ein vortrainiertes Modell laden (für das Training empfohlen) model = YOLO("yolo26n.pt") # Das Modell trainieren results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)Eine umfassende Liste der verfügbaren Argumente findest du auf der Seite Training des Modells.
Das Dataset (~7.0 GB) wird beim ersten Training mit
data="GlobalWheat2020.yaml"automatisch heruntergeladen – ein manueller Schritt ist nicht erforderlich. Ultralytics ruft die Bilder und Labels ab und entpackt sie in dein lokales Dataset-Verzeichnis. Weitere verwandte Datasets findest du in der Übersicht der Erkennungs-Datasets.Die YAML-Konfigurationsdatei für den Global Wheat Head Dataset heißt
GlobalWheat2020.yamlund ist auf GitHub verfügbar. Du findest sie unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml. Diese Datei enthält die Dataset-Pfade, Klassen und weitere Konfigurationsdetails, die für das Modelltraining mit Ultralytics YOLO benötigt werden.Die Erkennung von Weizenähren ist für das Pflanzenmanagement entscheidend, weil sie eine präzise Schätzung der Dichte und Größe der Weizenähren ermöglicht. Diese Werte sind wichtig, um Pflanzengesundheit, Reifegrad und Ertragspotenzial zu beurteilen. Mithilfe von Deep-Learning-Modellen, die mit Datasets wie dem Global Wheat Head Dataset trainiert wurden, können Landwirte und Forschende ihre Kulturen besser überwachen und bewirtschaften. Das steigert die Produktivität und optimiert den Ressourceneinsatz in der Landwirtschaft. Dieser technologische Fortschritt unterstützt Initiativen für nachhaltige Landwirtschaft und Ernährungssicherheit.
Weitere Informationen zu KI-Anwendungen in der Landwirtschaft findest du unter KI in der Landwirtschaft.