Ein vortrainiertes YOLO-Modell mit Ultralytics für Inferenz auf Vertex AI bereitstellen#
Diese Anleitung zeigt dir, wie du ein vortrainiertes YOLO26-Modell mit Ultralytics containerisierst, dafür einen FastAPI-Inferenzserver erstellst und das Modell mit dem Inferenzserver auf Google Cloud Vertex AI bereitstellst. Die Beispielimplementierung behandelt den Anwendungsfall Objekterkennung für YOLO26. Dieselben Prinzipien gelten jedoch auch für andere YOLO-Aufgaben.
Bevor wir beginnen, musst du ein Google Cloud Platform (GCP)-Projekt erstellen. Als neuer Nutzer erhältst du 300 $ GCP-Guthaben zur kostenlosen Nutzung. Dieser Betrag reicht aus, um eine laufende Einrichtung zu testen, die du später für jeden anderen YOLO26-Anwendungsfall erweitern kannst, einschließlich Training sowie Batch- und Streaming-Inferenz.
Das lernst du#
- Ein Inferenz-Backend für das Ultralytics YOLO26-Modell mit FastAPI erstellen.
- Ein GCP Artifact Registry-Repository erstellen, um dein Docker-Image zu speichern.
- Das Docker-Image mit dem Modell erstellen und in Artifact Registry übertragen.
- Dein Modell in Vertex AI importieren.
- Einen Vertex AI-Endpunkt erstellen und das Modell bereitstellen.
- Volle Kontrolle über das Modell mit Ultralytics: Du kannst benutzerdefinierte Inferenzlogik nutzen und hast die volle Kontrolle über Vorverarbeitung, Nachverarbeitung und Formatierung der Antworten.
- Vertex AI übernimmt den Rest: Der Dienst skaliert automatisch und bietet dir gleichzeitig Flexibilität bei der Konfiguration von Rechenressourcen, Arbeitsspeicher und GPU.
- Native GCP-Integrationen und Sicherheit: Einfache Einrichtung mit Cloud Storage, BigQuery, Cloud Functions, VPC-Steuerungen, IAM-Richtlinien und Auditprotokollen.
Voraussetzungen#
- Installiere Docker auf deinem Computer.
- Installiere das Google Cloud SDK und authentifiziere dich für die Verwendung der gcloud CLI.
- Wir empfehlen dir dringend, die Docker-Schnellstartanleitung für Ultralytics durchzuarbeiten, da du im Rahmen dieser Anleitung eines der offiziellen Ultralytics-Docker-Images erweitern musst.
1. Ein Inferenz-Backend mit FastAPI erstellen#
Zuerst musst du eine FastAPI-Anwendung erstellen, die Inferenzanfragen für das YOLO26-Modell verarbeitet. Diese Anwendung übernimmt das Laden des Modells, die Bildvorverarbeitung und die Inferenzlogik (Vorhersage).
Grundlagen zur Compliance mit Vertex AI#
Vertex AI erwartet, dass dein Container zwei bestimmte Endpunkte implementiert:
-
Health-Endpunkt (
/health): Muss den HTTP-Status200 OKzurückgeben, wenn der Dienst bereit ist. -
Predict-Endpunkt (
/predict): Akzeptiert strukturierte Vorhersageanfragen mit base64-kodierten Bildern und optionalen Parametern. Je nach Endpunkttyp gelten Beschränkungen für die Nutzlastgröße.Nutzlasten für den Endpunkt
/predictsollten dieser JSON-Struktur entsprechen:{ "instances": [{ "image": "base64_encoded_image" }], "parameters": { "confidence": 0.5 } }
Projektordnerstruktur#
Der Großteil unseres Builds findet im Docker-Container statt. Außerdem lädt Ultralytics ein vortrainiertes YOLO26-Modell. Daher kannst du die lokale Ordnerstruktur einfach halten:
YOUR_PROJECT/
├── src/
│   ├── __init__.py
│   ├── app.py              # Core YOLO26 inference logic
│   └── main.py             # FastAPI inference server
├── tests/
├── .env                    # Environment variables for local development
├── Dockerfile              # Container configuration
├── LICENSE                 # AGPL-3.0 License
└── pyproject.toml # Python dependencies and project configDie Ultralytics YOLO26-Modelle und das Framework sind unter AGPL-3.0 lizenziert, die wichtige Compliance-Anforderungen stellt. Lies unbedingt die Ultralytics-Dokumentation dazu, wie du die Lizenzbedingungen einhältst.
pyproject.toml mit Abhängigkeiten erstellen#
Damit du dein Projekt bequem verwalten kannst, erstelle eine Datei pyproject.toml mit den folgenden Abhängigkeiten:
[project]
name = "YOUR_PROJECT_NAME"
version = "0.0.1"
description = "YOUR_PROJECT_DESCRIPTION"
requires-python = ">=3.10,<3.13"
dependencies = [
   "ultralytics>=8.4.0",
   "fastapi[all]>=0.89.1",
   "uvicorn[standard]>=0.20.0",
   "pillow>=9.0.0",
   "loguru",
]

[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"uvicornwird zum Ausführen des FastAPI-Servers verwendet.loguruwird für die Protokollierung im FastAPI-Server verwendet.pillowwird für die Bildverarbeitung verwendet. Du bist jedoch nicht auf PIL-Bilder beschränkt – Ultralytics unterstützt viele weitere Formate.
Inferenzlogik mit Ultralytics YOLO26 erstellen#
Nachdem du die Projektstruktur und Abhängigkeiten eingerichtet hast, kannst du die zentrale YOLO26-Inferenzlogik implementieren. Erstelle eine Datei src/app.py, die das Laden des Modells, die Bildverarbeitung und die Vorhersage mit der Ultralytics Python API übernimmt.
# src/app.py

from ultralytics import YOLO

# Model initialization and readiness state
model_yolo = None
_model_ready = False

def _initialize_model():
    """Initialize the YOLO model."""
    global model_yolo, _model_ready

    try:
        # Use pretrained YOLO26n model from Ultralytics base image
        model_yolo = YOLO("yolo26n.pt")
        _model_ready = True

    except Exception as e:
        print(f"Error initializing YOLO model: {e}")
        _model_ready = False
        model_yolo = None

# Initialize model on module import
_initialize_model()

def is_model_ready() -> bool:
    """Check if the model is ready for inference."""
    return _model_ready and model_yolo is not None
Dadurch wird das Modell einmal beim Start des Containers geladen und anschließend für alle Anfragen gemeinsam genutzt. Wenn dein Modell eine hohe Inferenzlast bewältigen muss, empfiehlt es sich, beim späteren Import des Modells in Vertex AI einen Maschinentyp mit mehr Arbeitsspeicher auszuwählen.
Erstelle als Nächstes zwei Hilfsfunktionen für die Bildverarbeitung bei Ein- und Ausgaben mit pillow. YOLO26 unterstützt PIL-Bilder nativ.
def get_image_from_bytes(binary_image: bytes) -> Image.Image:
    """Convert image from bytes to PIL RGB format."""
    input_image = Image.open(io.BytesIO(binary_image)).convert("RGB")
    return input_image
def get_bytes_from_image(image: Image.Image) -> bytes:
"""Convert PIL image to bytes."""
return_image = io.BytesIO()
image.save(return_image, format="JPEG", quality=85)
return_image.seek(0)
return return_image.getvalue()Implementiere schließlich die Funktion run_inference, die die Objekterkennung übernimmt. In diesem Beispiel extrahieren wir Begrenzungsrahmen, Klassennamen und Konfidenzwerte aus den Modellvorhersagen. Die Funktion gibt ein Wörterbuch mit Erkennungen und Rohdaten zurück, die weiterverarbeitet oder annotiert werden können.
def run_inference(input_image: Image.Image, confidence_threshold: float = 0.5) -> Dict[str, Any]:
    """Run inference on an image using YOLO26n model."""
    # Check if model is ready
    if not is_model_ready():
        print("Model not ready for inference")
        return {"detections": [], "results": None}

    try:
        # Make predictions and get raw results
        results = model_yolo.predict(
            imgsz=640, source=input_image, conf=confidence_threshold, save=False, augment=False, verbose=False
        )

        # Extract detections (bounding boxes, class names, and confidences)
        detections = []
        if results and len(results) > 0:
            result = results[0]
            if result.boxes is not None and len(result.boxes.xyxy) > 0:
                boxes = result.boxes

                # Convert tensors to numpy for processing
                xyxy = boxes.xyxy.cpu().numpy()
                conf = boxes.conf.cpu().numpy()
                cls = boxes.cls.cpu().numpy().astype(int)

                # Create detection dictionaries
                for i in range(len(xyxy)):
                    detection = {
                        "xmin": float(xyxy[i][0]),
                        "ymin": float(xyxy[i][1]),
                        "xmax": float(xyxy[i][2]),
                        "ymax": float(xyxy[i][3]),
                        "confidence": float(conf[i]),
                        "class": int(cls[i]),
                        "name": model_yolo.names.get(int(cls[i]), f"class_{int(cls[i])}"),
                    }
                    detections.append(detection)

        return {
            "detections": detections,
            "results": results,  # Keep raw results for annotation
        }
    except Exception as e:
        # If there's an error, return empty structure
        print(f"Error in YOLO detection: {e}")
        return {"detections": [], "results": None}
Optional kannst du eine Funktion hinzufügen, die das Bild mithilfe der integrierten Plot-Funktion von Ultralytics mit Begrenzungsrahmen und Beschriftungen versieht. Das ist nützlich, wenn du in der Vorhersageantwort annotierte Bilder zurückgeben möchtest.
def get_annotated_image(results: list) -> Image.Image:
    """Get annotated image using Ultralytics built-in plot method."""
    if not results or len(results) == 0:
        raise ValueError("No results provided for annotation")

    result = results[0]
    # Die integrierte Plot-Funktion von Ultralytics mit PIL-Ausgabe verwenden
    return result.plot(pil=True)
HTTP-Inferenzserver mit FastAPI erstellen#
Nachdem du die zentrale YOLO26-Inferenzlogik erstellt hast, kannst du eine FastAPI-Anwendung dafür einrichten. Dazu gehören der Health-Check- und der Vorhersage-Endpunkt, die Vertex AI benötigt.
Erstelle zunächst src/main.py, füge die Importe hinzu, erstelle die FastAPI-App und konfiguriere die Protokollierung für Vertex AI. Da Vertex AI stderr als Fehlerausgabe behandelt, empfiehlt es sich, die Protokolle an stdout weiterzuleiten.
# src/main.py

import sys

from fastapi import FastAPI
from loguru import logger

app = FastAPI()

# Logger konfigurieren
logger.remove()
logger.add(
    sys.stdout,
    colorize=True,
    format="<green>{time:HH:mm:ss}</green> | <level>{message}</level>",
    level=10,
)
logger.add("log.log", rotation="1 MB", level="DEBUG", compression="zip")
Damit die Anwendung die Vertex AI-Anforderungen vollständig erfüllt, definiere die erforderlichen Endpunkte in Umgebungsvariablen und lege die Größenbeschränkung für Anfragen fest. Für den produktiven Einsatz empfehlen sich private Vertex AI-Endpunkte. So erhältst du eine höhere Nutzlastgrenze für Anfragen (10 MB statt 1,5 MB bei öffentlichen Endpunkten) sowie robuste Sicherheits- und Zugriffskontrollen.
# Vertex AI-Umgebungsvariablen
AIP_HTTP_PORT = int(os.getenv("AIP_HTTP_PORT", "8080"))
AIP_HEALTH_ROUTE = os.getenv("AIP_HEALTH_ROUTE", "/health")
AIP_PREDICT_ROUTE = os.getenv("AIP_PREDICT_ROUTE", "/predict")

# Größenbeschränkung für Anfragen (10 MB für private Endpunkte, 1,5 MB für öffentliche Endpunkte)
MAX_REQUEST_SIZE = 10 * 1024 * 1024  # 10 MB in Byte
Füge zwei Pydantic-Modelle zur Validierung deiner Anfragen und Antworten hinzu:
# Pydantic-Modelle für Anfrage und Antwort
class PredictionRequest(BaseModel):
    instances: list
    parameters: Optional[Dict[str, Any]] = None

class PredictionResponse(BaseModel):
    predictions: list
Füge den Health-Check-Endpunkt hinzu, um die Bereitschaft deines Modells zu überprüfen. Das ist für Vertex AI wichtig, denn ohne einen dedizierten Health-Check fragt der Orchestrator beliebige Sockets ab und kann nicht feststellen, ob das Modell für die Inferenz bereit ist. Bei Erfolg muss deine Prüfung 200 OK und bei einem Fehler 503 Service Unavailable zurückgeben:
# Health-Check-Endpunkt
@app.get(AIP_HEALTH_ROUTE, status_code=status.HTTP_200_OK)
def health_check():
    """Health check endpoint for Vertex AI."""
    if not is_model_ready():
        raise HTTPException(status_code=503, detail="Model not ready")
    return {"status": "healthy"}
Jetzt kannst du den Vorhersage-Endpunkt implementieren, der Inferenzanfragen verarbeitet. Er nimmt eine Bilddatei entgegen, führt die Inferenz aus und gibt die Ergebnisse zurück. Beachte, dass das Bild base64-kodiert sein muss, wodurch sich die Nutzlast zusätzlich um bis zu 33 % vergrößert.
@app.post(AIP_PREDICT_ROUTE, response_model=PredictionResponse)
async def predict(request: PredictionRequest):
    """Prediction endpoint for Vertex AI."""
    try:
        predictions = []

        for instance in request.instances:
            if isinstance(instance, dict):
                if "image" in instance:
                    image_data = base64.b64decode(instance["image"])
                    input_image = get_image_from_bytes(image_data)
                else:
                    raise HTTPException(status_code=400, detail="Instance must contain 'image' field")
            else:
                raise HTTPException(status_code=400, detail="Invalid instance format")

            # Extract YOLO26 parameters if provided
            parameters = request.parameters or {}
            confidence_threshold = parameters.get("confidence", 0.5)
            return_annotated_image = parameters.get("return_annotated_image", False)

            # Run inference with YOLO26n model
            result = run_inference(input_image, confidence_threshold=confidence_threshold)
            detections_list = result["detections"]

            # Format predictions for Vertex AI
            detections = []
            for detection in detections_list:
                formatted_detection = {
                    "class": detection["name"],
                    "confidence": detection["confidence"],
                    "bbox": {
                        "xmin": detection["xmin"],
                        "ymin": detection["ymin"],
                        "xmax": detection["xmax"],
                        "ymax": detection["ymax"],
                    },
                }
                detections.append(formatted_detection)

            # Build prediction response
            prediction = {"detections": detections, "detection_count": len(detections)}

            # Add annotated image if requested and detections exist
            if (
                return_annotated_image
                and result["results"]
                and result["results"][0].boxes is not None
                and len(result["results"][0].boxes) > 0
            ):
                annotated_image = get_annotated_image(result["results"])
                img_bytes = get_bytes_from_image(annotated_image)
                prediction["annotated_image"] = base64.b64encode(img_bytes).decode("utf-8")

            predictions.append(prediction)

        logger.info(
            f"Processed {len(request.instances)} instances, found {sum(len(p['detections']) for p in predictions)} total detections"
        )

        return PredictionResponse(predictions=predictions)

    except HTTPException:
        # Re-raise HTTPException as-is (don't catch and convert to 500)
        raise
    except Exception as e:
        logger.error(f"Prediction error: {e}")
        raise HTTPException(status_code=500, detail=f"Prediction failed: {e}")
Füge schließlich den Anwendungseinstiegspunkt hinzu, um den FastAPI-Server zu starten.
if __name__ == "__main__":
    import uvicorn

    logger.info(f"Starting server on port {AIP_HTTP_PORT}")
    logger.info(f"Health check route: {AIP_HEALTH_ROUTE}")
    logger.info(f"Predict route: {AIP_PREDICT_ROUTE}")
    uvicorn.run(app, host="0.0.0.0", port=AIP_HTTP_PORT)
Du hast jetzt eine vollständige FastAPI-Anwendung, die YOLO26-Inferenzanfragen verarbeiten kann. Du kannst sie lokal testen, indem du die Abhängigkeiten installierst und den Server beispielsweise mit uv ausführst.
# Install dependencies
uv pip install -e .

# Run the FastAPI server directly
uv run src/main.py
Um den Server zu testen, kannst du die Endpunkte /health und /predict mit cURL abfragen. Lege ein Testbild im Ordner tests ab. Führe dann in deinem Terminal die folgenden Befehle aus:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
Du solltest eine JSON-Antwort mit den erkannten Objekten erhalten. Bei der ersten Anfrage kann es zu einer kurzen Verzögerung kommen, da Ultralytics das YOLO26-Modell abrufen und laden muss.
2. Das Ultralytics-Docker-Image um deine Anwendung erweitern#
Ultralytics bietet mehrere Docker-Images, die du als Basis für dein Anwendungsimage verwenden kannst. Sie enthalten Ultralytics und die erforderlichen CUDA-Bibliotheken, sodass du nur noch deine Anwendung darauf aufbauen musst.
Um die vollen Funktionen der Ultralytics-YOLO-Modelle zu nutzen, solltest du für die GPU-Inferenz das für CUDA optimierte Image auswählen. Reicht für deine Aufgabe hingegen die CPU-Inferenz aus, kannst du auch mit dem reinen CPU-Image Rechenressourcen sparen:
- Dockerfile: Für YOLO26-Training und -Inferenz mit einer oder mehreren GPUs optimiertes CUDA-Image.
- Dockerfile-cpu: Image nur mit CPU für YOLO26-Inferenz.
Ein Docker-Image für deine Anwendung erstellen#
Erstelle im Stammverzeichnis deines Projekts eine Datei Dockerfile mit folgendem Inhalt:
# Extends official Ultralytics Docker image for YOLO26
FROM ultralytics/ultralytics:latest

ENV PYTHONUNBUFFERED=1

# Install FastAPI and dependencies
RUN uv pip install --system fastapi[all] uvicorn[standard] loguru

WORKDIR /app
COPY src/ ./src/
COPY pyproject.toml ./

# Install the application package
RUN uv pip install --system -e .

RUN mkdir -p /app/logs
ENV PYTHONPATH=/app/src

# Port for Vertex AI
EXPOSE 8080

# Start the inference server
ENTRYPOINT ["python", "src/main.py"]
Im Beispiel dient das offizielle Ultralytics-Docker-Image ultralytics:latest als Basis. Es enthält bereits das YOLO26-Modell und alle erforderlichen Abhängigkeiten. Der Einstiegspunkt des Servers ist derselbe, den wir zum lokalen Testen der FastAPI-Anwendung verwendet haben.
Das Docker-Image erstellen und testen#
Jetzt kannst du das Docker-Image mit folgendem Befehl erstellen:
docker build --platform linux/amd64 -t IMAGE_NAME:IMAGE_VERSION .Ersetze IMAGE_NAME und IMAGE_VERSION durch die gewünschten Werte, zum Beispiel yolo26-fastapi:0.1. Beachte, dass du das Image für die Architektur linux/amd64 erstellen musst, wenn du es auf Vertex AI bereitstellst. Der Parameter --platform muss ausdrücklich angegeben werden, wenn du das Image auf einem Mac mit Apple Silicon oder einer anderen Architektur als x86 erstellst.
Sobald das Image erstellt ist, kannst du es lokal testen:
docker run --platform linux/amd64 -p 8080:8080 IMAGE_NAME:IMAGE_VERSIONDein Docker-Container führt jetzt auf Port 8080 einen FastAPI-Server aus, der Inferenzanfragen entgegennimmt. Du kannst die Endpunkte /health und /predict mit denselben cURL-Befehlen wie zuvor testen:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
3. Das Docker-Image in GCP Artifact Registry hochladen#
Um dein containerisiertes Modell in Vertex AI zu importieren, musst du das Docker-Image in Google Cloud Artifact Registry hochladen. Falls du noch kein Artifact Registry-Repository hast, musst du zuerst eines erstellen.
Ein Repository in Google Cloud Artifact Registry erstellen#
Öffne in der Google Cloud Console die Artifact Registry-Seite. Wenn du Artifact Registry zum ersten Mal verwendest, wirst du möglicherweise aufgefordert, zuerst die Artifact Registry API zu aktivieren.

- Wähle „Repository erstellen“ aus.
- Gib den Namen deines Repositorys ein. Wähle die gewünschte Region aus und verwende für die übrigen Optionen die Standardeinstellungen, sofern du sie nicht ausdrücklich ändern musst.
Die Auswahl der Region kann sich auf die Verfügbarkeit von Maschinen und bestimmte Rechenbeschränkungen für Nutzer außerhalb der Enterprise-Version auswirken. Weitere Informationen findest du in der offiziellen Vertex AI-Dokumentation: Vertex AI-Kontingente und -Beschränkungen
- Sobald das Repository erstellt wurde, speichere PROJECT_ID, Location (Region) und Repository Name in deinem Geheimnisspeicher oder in der Datei
.env. Du brauchst diese Angaben später, um dein Docker-Image zu taggen und in Artifact Registry hochzuladen.
Docker bei Artifact Registry authentifizieren#
Authentifiziere deinen Docker-Client beim gerade erstellten Artifact Registry-Repository. Führe den folgenden Befehl in deinem Terminal aus:
gcloud auth configure-docker YOUR_REGION-docker.pkg.devDein Image taggen und in Artifact Registry hochladen#
Das Docker-Image taggen und in Google Artifact Registry hochladen.
Wir empfehlen, bei jeder Aktualisierung deines Images ein eindeutiges Tag zu verwenden. Die meisten GCP-Dienste, einschließlich Vertex AI, verwenden Image-Tags für die automatische Versionierung und Skalierung. Daher empfiehlt es sich, Tags nach semantischer Versionierung oder nach Datum zu vergeben.
Tagge dein Image mit der URL des Artifact Registry-Repositorys. Ersetze die Platzhalter durch die zuvor gespeicherten Werte.
docker tag IMAGE_NAME:IMAGE_VERSION YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONÜbertrage das getaggte Image in das Artifact Registry-Repository.
docker push YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONWarte, bis der Vorgang abgeschlossen ist. Jetzt solltest du das Bild in deinem Artifact Registry-Repository sehen.
Eine ausführlichere Anleitung zur Arbeit mit Images in Artifact Registry findest du in der Artifact Registry-Dokumentation: Images übertragen und abrufen.
4. Importiere dein Modell in Vertex AI#
Mit dem Docker-Image, das du gerade übertragen hast, kannst du das Modell jetzt in Vertex AI importieren.
-
Öffne im Navigationsmenü von Google Cloud Vertex AI > Model Registry. Alternativ kannst du in der Suchleiste oben in der Google Cloud Console nach „Vertex AI“ suchen.

-
Klicke auf „Importieren“.
-
Wähle „Als neues Modell importieren“ aus.
-
Wähle die Region aus. Du kannst dieselbe Region wie für dein Artifact Registry-Repository auswählen. Deine Auswahl sollte sich jedoch danach richten, welche Maschinentypen und Kontingente in deiner Region verfügbar sind.
-
Wähle „Vorhandenen Modellcontainer importieren“ aus.

-
Rufe im Feld „Container-Image“ das zuvor erstellte Artifact Registry-Repository auf und wähle das gerade hochgeladene Image aus.
-
Scrolle zum Abschnitt „Umgebungsvariablen“ und gib die Predict- und Health-Endpunkte sowie den Port ein, die du in deiner FastAPI-Anwendung definiert hast.

-
Klicke auf „Importieren“. Vertex AI benötigt einige Minuten, um das Modell zu registrieren und für die Bereitstellung vorzubereiten. Sobald der Import abgeschlossen ist, erhältst du eine E-Mail-Benachrichtigung.
5. Erstelle einen Vertex AI-Endpunkt und stelle dein Modell bereit#
In der Terminologie von Vertex AI bezeichnen Endpunkte die bereitgestellten Modelle, da sie die HTTP-Endpunkte darstellen, an die du Inferenzanfragen sendest. Modelle sind dagegen die trainierten ML-Artefakte, die in der Model Registry gespeichert sind.
Um ein Modell bereitzustellen, musst du in Vertex AI einen Endpunkt erstellen.
-
Öffne im Navigationsmenü von Vertex AI die Option Endpoints. Wähle die Region aus, die du beim Importieren deines Modells verwendet hast. Klicke auf Create.

-
Gib den Namen des Endpunkts ein.
-
Für den Zugriff empfiehlt Vertex AI die Verwendung privater Vertex AI-Endpunkte. Neben den Sicherheitsvorteilen erhältst du bei Auswahl eines privaten Endpunkts ein höheres Payload-Limit. Allerdings musst du dein VPC-Netzwerk und die Firewallregeln so konfigurieren, dass der Zugriff auf den Endpunkt möglich ist. Weitere Anweisungen findest du in der Vertex AI-Dokumentation zu privaten Endpunkten.
-
Klicke auf „Weiter“.
-
Wähle im Dialogfeld „Modelleinstellungen“ das zuvor importierte Modell aus. Jetzt kannst du den Maschinentyp, den Arbeitsspeicher und die GPU-Einstellungen für dein Modell konfigurieren. Plane ausreichend Arbeitsspeicher ein, wenn du mit hoher Inferenzlast rechnest, damit keine E/A-Engpässe die ordnungsgemäße Leistung von YOLO26 beeinträchtigen.
-
Wähle unter „Beschleunigertyp“ den GPU-Typ aus, den du für die Inferenz verwenden möchtest. Wenn du nicht sicher bist, welche GPU du auswählen sollst, kannst du mit NVIDIA T4 beginnen, die CUDA unterstützt.
Denk daran, dass die Rechenkontingente in bestimmten Regionen sehr begrenzt sind. Deshalb kannst du in deiner Region möglicherweise bestimmte Maschinentypen oder GPUs nicht auswählen. Wenn das entscheidend ist, ändere die Region deiner Bereitstellung und wähle eine Region mit einem höheren Kontingent. Weitere Informationen findest du in der offiziellen Vertex AI-Dokumentation: Vertex AI-Kontingente und -Beschränkungen.
- Sobald du den Maschinentyp ausgewählt hast, kannst du auf Continue klicken. Jetzt kannst du die Modellüberwachung in Vertex AI aktivieren – ein zusätzlicher Dienst, der die Leistung deines Modells erfasst und Einblicke in sein Verhalten bietet. Diese Option ist freiwillig und verursacht zusätzliche Kosten. Wähle sie daher nach Bedarf aus. Klicke auf Create.
Die Bereitstellung des Modells durch Vertex AI dauert einige Minuten (in manchen Regionen bis zu 30 Minuten). Sobald die Bereitstellung abgeschlossen ist, erhältst du eine E-Mail-Benachrichtigung.
6. Teste dein bereitgestelltes Modell#
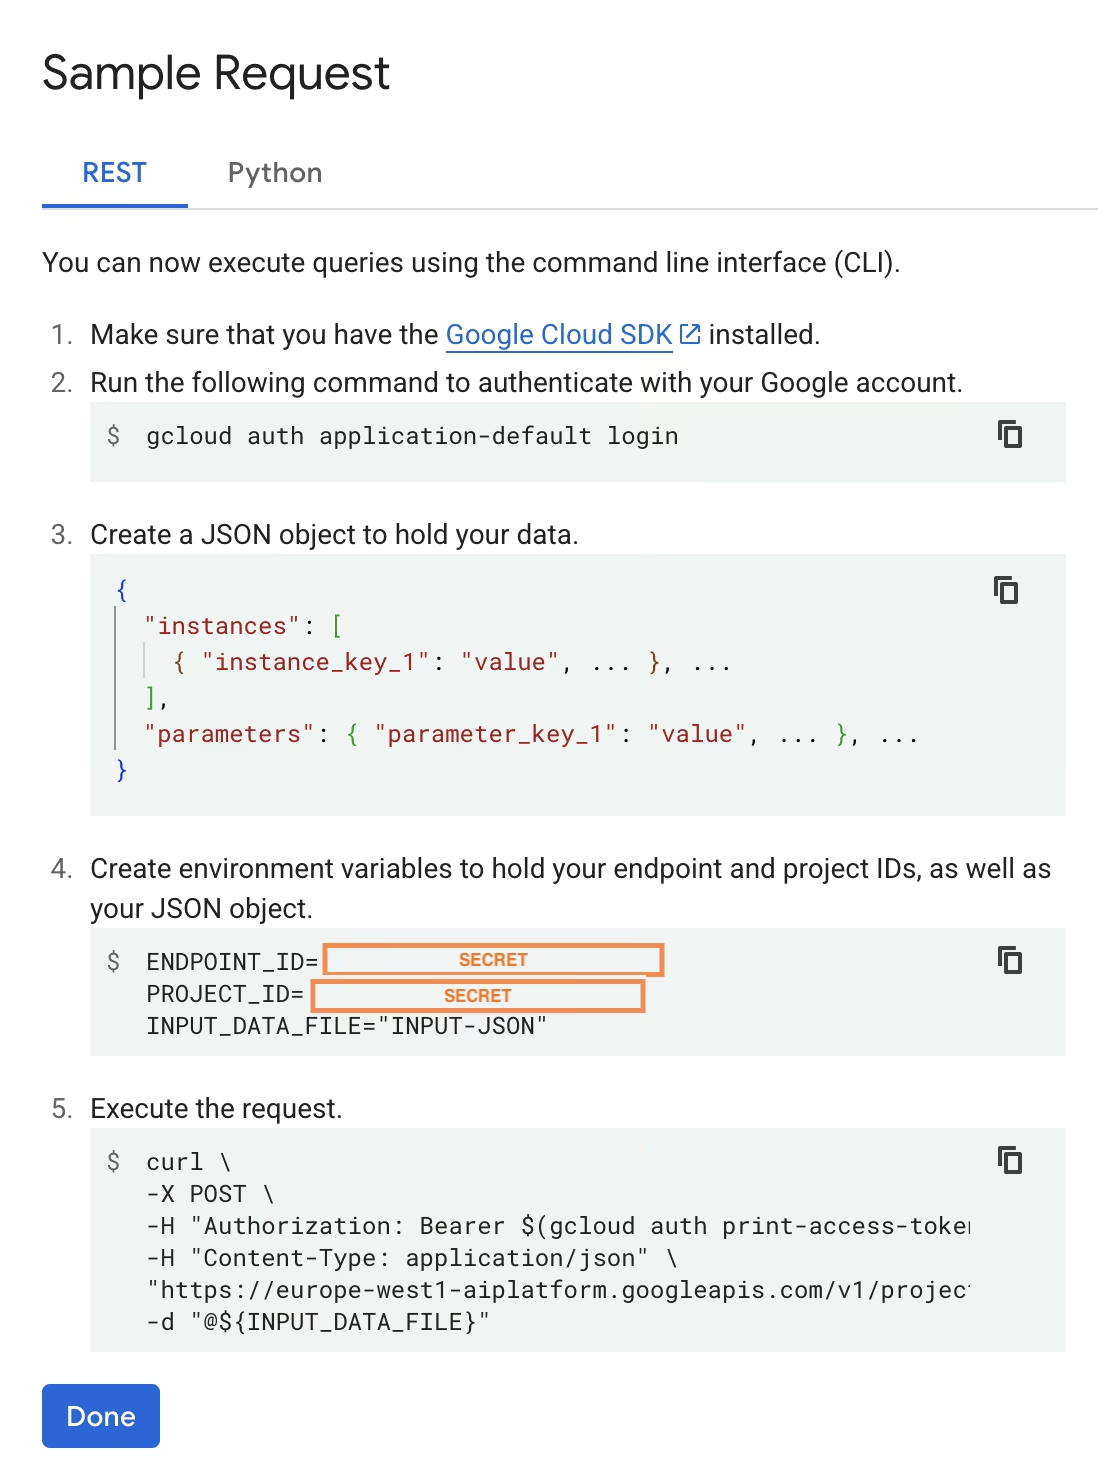
Sobald die Bereitstellung abgeschlossen ist, stellt Vertex AI eine Beispiel-API-Oberfläche bereit, mit der du dein Modell testen kannst.
Um die Remote-Inferenz zu testen, kannst du den bereitgestellten cURL-Befehl verwenden oder eine weitere Python-Clientbibliothek erstellen, die Anfragen an das bereitgestellte Modell sendet. Denk daran, dass du dein Bild vor dem Senden an den Endpunkt /predict in Base64 kodieren musst.
Wie beim lokalen Testen solltest du bei der ersten Anfrage mit einer kurzen Verzögerung rechnen, da Ultralytics das YOLO26-Modell in den laufenden Container laden muss.
Du hast erfolgreich ein vortrainiertes YOLO26-Modell mit Ultralytics auf Google Cloud Vertex AI bereitgestellt.
Häufig gestellte Fragen#
Ja. Allerdings musst du das Modell zunächst in ein mit Vertex AI kompatibles Format exportieren, etwa TensorFlow, Scikit-learn oder XGBoost. Google Cloud bietet eine Anleitung zur Ausführung von
.pt-Modellen auf Vertex mit einem umfassenden Überblick über den Konvertierungsprozess: PyTorch-Modelle auf Vertex AI ausführen.Beachte, dass die resultierende Konfiguration ausschließlich auf der standardmäßigen Bereitstellungsebene von Vertex AI basiert und die erweiterten Funktionen des Ultralytics-Frameworks nicht unterstützt. Da Vertex AI containerisierte Modelle vollständig unterstützt und sie gemäß deiner Bereitstellungskonfiguration automatisch skalieren kann, kannst du den vollen Funktionsumfang der Ultralytics-YOLO-Modelle nutzen, ohne sie in ein anderes Format konvertieren zu müssen.
FastAPI bietet einen hohen Durchsatz für Inferenz-Workloads. Die Unterstützung asynchroner Verarbeitung ermöglicht es, mehrere gleichzeitige Anfragen zu bearbeiten, ohne den Hauptthread zu blockieren. Das ist wichtig, wenn Computer-Vision-Modelle bereitgestellt werden.
Die automatische Validierung von Anfragen und Antworten mit FastAPI reduziert Laufzeitfehler in produktiven Inferenzdiensten. Das ist besonders wertvoll für APIs zur Objekterkennung, bei denen ein einheitliches Eingabeformat entscheidend ist.
FastAPI verursacht nur einen minimalen Rechenaufwand in deiner Inferenzpipeline. Dadurch bleiben mehr Ressourcen für die Modellausführung und die Bildverarbeitung verfügbar.
FastAPI unterstützt außerdem SSE (Server-Sent Events), was für Inferenzszenarien mit Datenstrom nützlich ist.
Das ist tatsächlich eine vielseitige Funktion der Google Cloud Platform: Du musst für jeden verwendeten Dienst eine Region auswählen. Wenn du ein containerisiertes Modell auf Vertex AI bereitstellst, ist die wichtigste Regionsauswahl die für die Model Registry. Sie bestimmt, welche Maschinentypen und Kontingente für die Modellbereitstellung verfügbar sind.
Wenn du die Konfiguration außerdem erweitern und Vorhersagedaten oder Ergebnisse in Cloud Storage oder BigQuery speichern möchtest, musst du dieselbe Region wie für die Model Registry verwenden. So minimierst du die Latenz und stellst einen hohen Datendurchsatz sicher.