YOLOE: Erkennung und Segmentierung mit offenem Vokabular in Echtzeit
Ultralytics YOLOE (Echtzeit-Erkennung beliebiger Objekte) ist ein Modell für Open-Vocabulary-Erkennung und Instanzsegmentierung: Statt einer beim Training festgelegten Klassenliste verwendet es die Kategorien, die du bei der Inferenz angibst – als Text-Prompt, visuelles Beispiel oder über ein integriertes Vokabular mit 4.585 Bezeichnungen. YOLOE basiert auf den Ultralytics-YOLO-Architekturen – YOLOv8, YOLO11 und YOLO26 – und ist von YOLO-World inspiriert. Das Modell erreicht eine hohe Zero-Shot-Genauigkeit bei nahezu der Geschwindigkeit von YOLO-Modellen mit geschlossenem Vokabular.
Ansehen: So verwendest du Ultralytics YOLOE-26 (Neu) | Open Vocabulary und Echtzeit-Erkennung beliebiger Objekte
Schnellstart#
Gib die gewünschten Klassen an und starte das Modell. YOLOE-26 gibt Begrenzungsrahmen und Instanzsegmentierungsmasken für Kategorien zurück, mit denen es nie trainiert wurde.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# "double-decker bus" ist keine COCO-Klasse; YOLOE erkennt sie allein anhand der Wörter
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
Beim ersten Aufruf von set_classes() wird ein Textencoder heruntergeladen. Lies vor dem Einsatz auf einem Rechner ohne Netzwerkzugriff die Installations- und Systemanforderungen.
Auswahl eines Aufforderungsmodus#
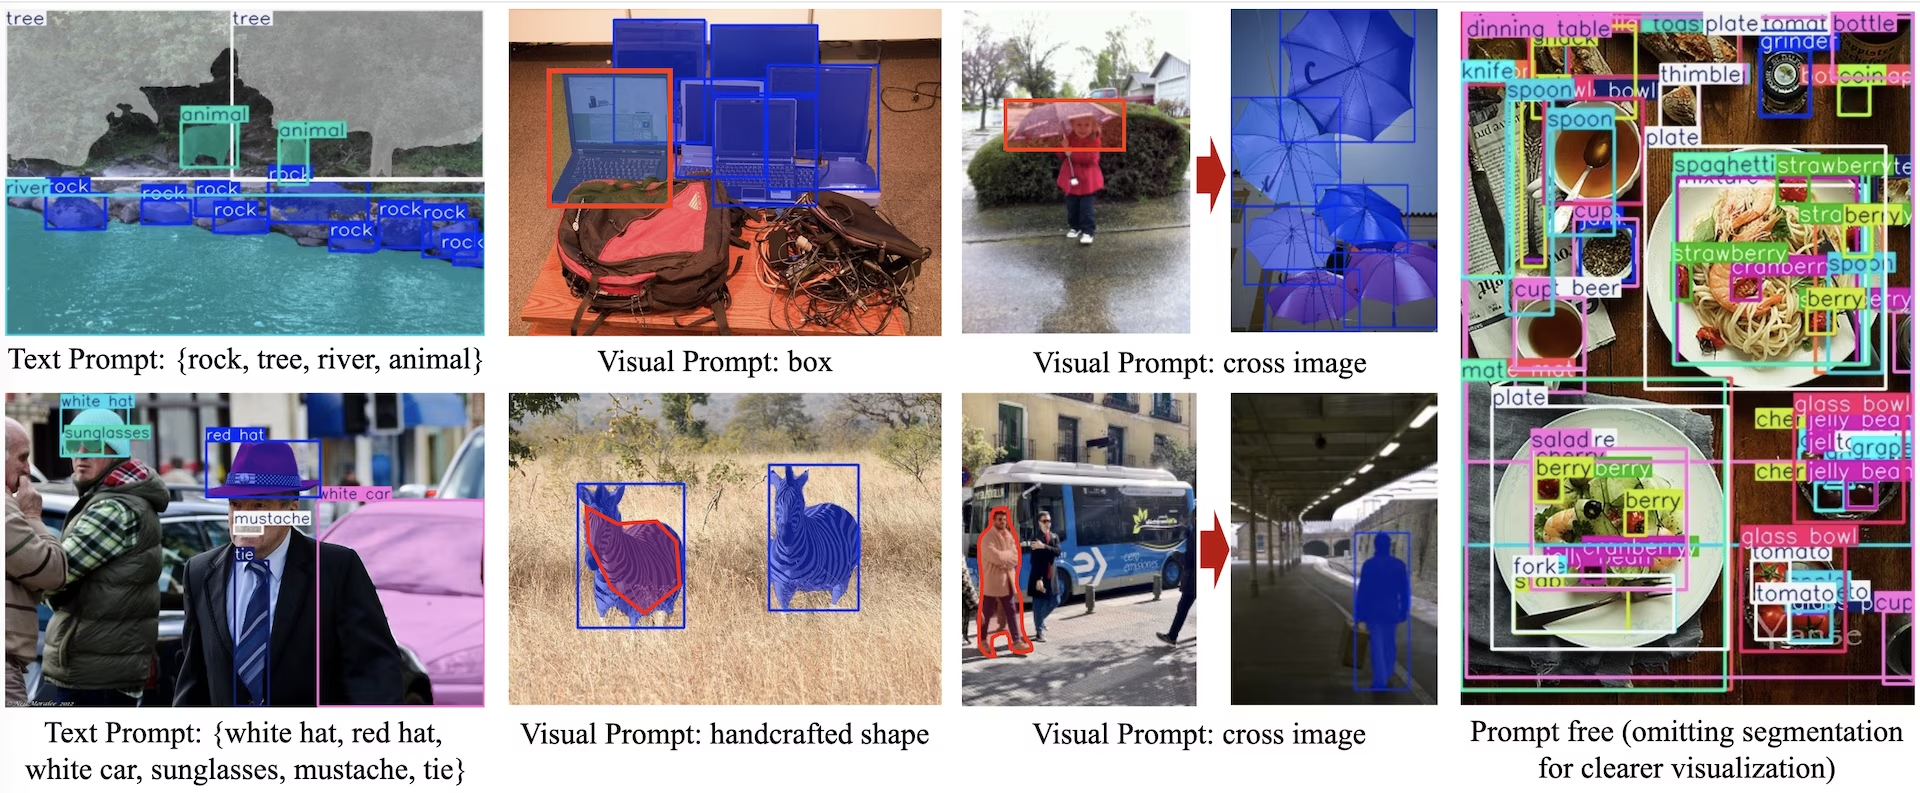
YOLOE unterstützt drei Aufforderungsmodi. Deine Auswahl bestimmt, welchen Checkpoint du lädst und wie deine Klassenbezeichnungen aussehen. Wähle die Zeile, die dem entspricht, was du zum Inferenzzeitpunkt bereitstellen kannst.
| Modus | Checkpoint | Deine Eingabe | Klassennamen in den Ergebnissen | Verwende diesen Modus, wenn |
|---|---|---|---|---|
| Textaufforderung | *-seg.pt | Klassennamen als Zeichenfolgen | Genau die von dir angegebenen Namen | Du das Ziel in Worten beschreiben kannst – die übliche Wahl |
| Visuelle Aufforderung | *-seg.pt | Beispielboxen auf einem Referenzbild | Allgemeine object0, object1, … | Du das Ziel nicht in Worte fassen kannst: ein bestimmtes Teil, Logo oder ein Defekt |
| Aufforderungsfrei | *-seg-pf.pt | Nichts | Namen aus dem integrierten Vokabular mit 4.585 Bezeichnungen | Du einen Katalog erstellst oder etwas erkundest und im Voraus nicht weißt, wonach du suchen sollst |
- Visuelle Aufforderungen übernehmen deine Bezeichnungen nicht. Die Klassen-IDs in
visual_promptsgruppieren Beispiele; das Modell gibt sie alsobject0,object1und so weiter aus. Ordne sie selbst deinen eigenen Namen zu. - Aufforderungsfreie Checkpoints akzeptieren
set_classes()nicht. Ein Aufruf damit für ein*-seg-pf.pt-Modell löstAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.aus. Lade stattdessen einen*-seg.pt-Checkpoint, wenn du deine eigenen Klassen brauchst.
Installation und Systemanforderungen#
YOLOE ist im Ultralytics-Hauptpaket enthalten:
pip install -U ultralyticsFür Textaufforderungen wird zusätzlich ein Textencoder benötigt, der bei der ersten Verwendung und nicht während der Installation abgerufen wird:
- Beim ersten Aufruf von
set_classes()wird ultralytics/CLIP von GitHub mitpipinstalliert (dieses Paket stellt den Tokenizer bereit) und ein TorchScript-Textencoder in das aktuelle Arbeitsverzeichnis heruntergeladen. YOLOE-26 lädtmobileclip2_b.tsherunter, etwa 254 MB; YOLOE-11 und YOLOE-v8 ladenmobileclip_blt.tsherunter. Führe den Download einmal aus dem Verzeichnis aus, von dem aus du arbeiten wirst, oder kopiere die Datei dorthin. Andernfalls wird sie erneut heruntergeladen. - Für beide Schritte ist Netzwerkzugriff erforderlich. Führe daher vor der Bereitstellung auf einem Rechner ohne Netzwerkzugriff oder in einer abgeschotteten Umgebung eine Vorhersage mit Aufforderung aus.
- Für visuelle Aufforderungen und aufforderungsfreie Checkpoints ist kein Textencoder erforderlich.
Für die YOLOE-26-Checkpoints ist ultralytics 8.4.0 oder neuer erforderlich. Die YOLOE-11- und YOLOE-v8-Familien sind in älteren Versionen verfügbar. Eine Vorhersage mit Textaufforderung führt den gesamten Ablauf aus – Checkpoint-Download, CLIP-Installation, Textencoder und Inferenz:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Wenn du den Download des Textencoders zur Inferenzzeit vollständig vermeiden möchtest, hinterlege die Aufforderungen einmalig in den Gewichten und verwende sie wieder – siehe Eingabeaufforderungs-Embeddings wiederverwenden.
Architekturüberblick#

YOLOE behält die Standardstruktur von YOLO bei – einen Faltungs-Backbone zur Merkmalsextraktion, einen Neck zur Fusion auf mehreren Skalen und einen ankerlfreien, entkoppelten Kopf, der Klassen und Boxen vorhersagt – und ergänzt drei Module, eines pro Aufforderungsmodus:
- Re-parameterisierbare Region-Text-Ausrichtung (RepRTA) verfeinert Text-Einbettungen von CLIP mithilfe eines kleinen Zusatznetzwerks. Dieses Netzwerk wird einmal pro Aufruf von
set_classes()ausgeführt und beim Export entfernt, sodass pro Frame kein zusätzlicher Aufwand entsteht. Bei jedem Forward-Pass werden jedoch die gespeicherten Prompt-Einbettungen mit den Regionsmerkmalen verglichen. Welche Kosten bei einer großen Prompt-Menge entstehen, erfährst du unter Einschränkungen. - Semantic-Activated Visual Prompt Encoder (SAVPE) codiert semantische Merkmale und Aktivierungsmerkmale aus einer Beispielbox und konditioniert das Modell auf Objekte, die diesem Beispiel ähneln. Dies ist der One-Shot-Pfad für Ziele, die sich nur schwer benennen lassen, etwa ein Logo oder ein bestimmtes Teil.
- Lazy Region-Prompt Contrast (LRPC) gleicht Regions-Embeddings mit einem integrierten Vokabular mit 4.585 Bezeichnungen ab. Dadurch erkennen aufforderungsfreie Checkpoints Objekte ohne externe Aufforderung und ohne Textencoder.
Die Instanzsegmentierung erfolgt über einen Maskenzweig im Erkennungskopf, wie bei YOLOv8-Seg. Jede Vorhersage enthält eine Maske für results[0].masks. Nach dem Export werden die Open-World-Module zu einem standardmäßigen YOLO-Kopf re-parametrisiert, sodass die exportierte Datei den gewöhnlichen Erkennungs- und Segmentierungspfad ausführt.
Verfügbare Modelle#
Jeder der folgenden Checkpoints ist ein Instanzsegmentierungsmodell und unterstützt val, predict, export und track. Lade eine *-seg.pt-Datei für Text- oder visuelle Prompts und eine *-seg-pf.pt-Datei für Inferenz ohne Prompts. Die Dateien sind nicht austauschbar; weitere Informationen findest du unter Auswahl eines Prompt-Modus. Nur die Dateien *-seg.pt unterstützen train. Ein Checkpoint ohne Prompts wird aus einem trainierten Modell mit Text-Prompts erstellt; siehe Offizielle Modelle von Grund auf trainieren.
| Modell | Textuelle / visuelle Aufforderung | Aufforderungsfrei |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
YOLOE-Leistung auf LVIS#
Zero-Shot-Ergebnisse auf LVIS minival bei 640 Pixeln aus dem Ultralytics-YOLO26-Paper.
Textuelle und visuelle Aufforderungen#
Jede Zelle mit Genauigkeit und Parameterzahl zeigt Textaufforderung / visuelle Aufforderung; FLOPs werden nur einmal angegeben. Parameterzahl und FLOPs beziehen sich auf die Erkennungskonfiguration, die im Paper ausgewertet wird. Die Genauigkeit ist der Non-E2E-Wert des Papers, das einzige Protokoll, für das Ergebnisse zu jedem Modell im Vergleich angegeben werden. Der End-to-End-Kopf von YOLOE-26 liegt bei Textaufforderungen höchstens 1,1 AP und bei visuellen Aufforderungen höchstens 2,6 AP darunter.
| Modell | mAP50-95 | mAPr | mAPc | mAPf | Parameter (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
Aufforderungsfrei#
Die aufforderungsfreien Checkpoints liefern Ergebnisse anhand ihres integrierten Vokabulars, ohne dass eine Aufforderung eingegeben werden muss. Jede Zelle mit Genauigkeit zeigt End-to-End / Non-E2E, die beiden Protokolle, nach denen das Paper YOLOE-26 bewertet. Auf der YOLO26-Seite wird die Spalte Non-E2E zitiert.
| Modell | mAP50-95 | mAPr | mAPc | mAPf | Parameter (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
Bei Text- und visuellen Prompts liegen die YOLOE-26-Modelle bei mAP50-95 in jedem Größenvergleich vor ihren YOLOE-11- und YOLOE-v8-Pendants, bleiben bei Parameterzahl und FLOPs aber unter der v8-Reihe. Für denselben Split nennt die Studie für YOLO-Worldv2 Werte von 24.4 (S), 32.4 (M) und 35.5 (L) sowie für die Transformer-basierten Detektoren GLIP-T 26.0, GDINO-T 27.4 und DetCLIP-T 34.4; jedes dieser Modelle hat 155 bis 232 M Parameter. Die ursprüngliche YOLOE-Studie ergänzt zwei Ergebnisse für die von ihr eingeführten Modelle auf v8-Größenniveau. Auf LVIS übertrifft YOLOE-v8s YOLO-Worldv2-S um 3.5 AP – bei einem Drittel der Trainingskosten und 1,4-facher Inferenzgeschwindigkeit. Auf COCO übertragen erzielt YOLOE-v8l gegenüber YOLOv8-L mit geschlossenem Klassenumfang 0.6 box AP und 0.4 mask AP mehr, bei fast 4× kürzerer Trainingszeit.
Die YOLO26-Studie wertet eine Detektorkonfiguration aus. Bei den veröffentlichten Gewichten handelt es sich um Segmentierungs-Checkpoints mit einem Maskenzweig, SAVPE und einer zusätzlichen Textprojektion. Ein geladenes yoloe-26l-seg.pt weist daher 35.4 M und 142.0 B statt der obigen 25.5 M und 89.0 B aus. In beiden Fällen berücksichtigt der FLOPs-Wert nicht die Ähnlichkeit zwischen Regionen und Text, sodass die tatsächlichen Kosten mit der Größe des Prompt-Sets steigen, obwohl sich der Spaltenwert nicht ändert; siehe Einschränkungen.
Anwendungsbeispiele#
Jedes YOLOE-Beispiel unten wird über die Python-API ausgeführt. Vorhersagen mit Textprompts, Validierung, Export, Tracking und einfaches Training funktionieren auch über die CLI; die Anleitungen zur Feinabstimmung übergeben eine Trainerklasse und das visuelle Prompting NumPy-Prompt-Arrays, was nur die Python-API unterstützt.
Training verwenden#
Stimme jeden veröffentlichten *-seg.pt-Checkpoint mit deinem eigenen YOLO-Datensatz fein ab. Das entspricht größtenteils dem standardmäßigen YOLO-Trainingsverfahren; der Unterschied liegt darin, welchen Trainer du übergibst. YOLOEPESegTrainer integriert deine Klassennamen in den Modellkopf und stimmt das Modell anschließend fein ab. Genau das brauchst du für deine eigenen Labels; der Standard-Trainer trainiert nicht mit deinen Klassennamen. Der resultierende Checkpoint sagt die Klassen deines Datensatzes direkt voraus: Sein Modellkopf verarbeitet keine Prompts mehr. Deshalb gibt set_classes() einen Fehler aus, wenn sich die Klassen ändern; dasselbe gilt für visuelle Prompts. Verwende den ursprünglichen Checkpoint mit Prompts für andere Klassen.
Ansehen: So trainierst du YOLOE mit einem Datensatz zur Segmentierung von Autoteilen | Open-Vocabulary-Modell, Vorhersage und Export
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Wichtig: der Trainer für die Feinabstimmung, nicht der Standardtrainer
)Alle verfügbaren Checkpoints sind Segmentierungsmodelle. Um einen Detektor zu trainieren, erstellst du das Modell anhand der passenden YAML-Datei, lädst die Segmentierungsgewichte derselben Größenklasse und wechselst zum Detektionstrainer. Alles andere bleibt unverändert.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Verwendung für Vorhersagen#
Der Aufruf mit Textprompt ist der in Schnellstart gezeigte. Für visuelles Prompting kommt das Argument visual_prompts hinzu; für promptfreie Vorhersagen wird stattdessen ein -pf-Checkpoint geladen:
Bei visuellen Prompts zeigst du dem Modell ein Beispiel, statt es zu beschreiben. visual_prompts erwartet ein Array bboxes mit Beispiel-Bounding-Boxen und ein Array cls mit Klassen-IDs, eine pro Box. Die IDs dienen als temporäre Gruppierungen, nicht als Labels — sie müssen bei 0 beginnen und lückenlos aufeinanderfolgen. Die Ergebnisse werden unter object0, object1, … zurückgegeben und nicht unter selbst gewählten Namen.
Die Beispiel-Bounding-Boxen können sich auf dem Bild befinden, für das du eine Vorhersage erstellst:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# Eine Beispiel-Bounding-Box pro Zielobjekt, jeweils mit eigener Klassen-ID
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # Person, Brille
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
Du kannst die Boxen auch auf einem separaten Referenzbild platzieren, das als refer_image übergeben wird. In diesem Fall beschreiben bboxes und cls Objekte in der Referenz und nicht im Zielbild:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Zielbild
    refer_image="ultralytics/assets/bus.jpg",  # Hier befinden sich die Beispiel-Bounding-Boxen
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image legt außerdem die Klassen dauerhaft fest, sodass spätere Aufrufe keine Prompts mehr benötigen
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # Auch beim Export bleiben sie erhaltenWenn source ein Video oder ein Stream ist, wird das erste Bild automatisch zum refer_image. Die übergebenen Prompts werden somit auf dieses Bild angewendet und für den Rest des Videos beibehalten. Übergib refer_image explizit, um ein anderes Bild auszuwählen.
Sowohl source als auch refer_image akzeptieren torch-Tensoren direkt. Das ist nützlich, wenn die Bilder bereits aus einer bestehenden Pipeline stammen. Gib die Boxen in den Pixelkoordinaten des Tensors an:
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # (1, 3, H, W) float-Tensor im Bereich [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Um mehrere Bilder gleichzeitig vorherzusagen, verschachtelst du die Prompts eine Ebene tiefer: je ein Array bboxes und ein Array cls pro Quellbild, in derselben Reihenfolge wie die Quellen.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: Person, Brille
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: Person
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Verwendung zur Validierung#
Die Validierung erfolgt wie bei jedem anderen Modell anhand eines Segmentierungsdatensatzes:
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # oder yoloe-26s/m-seg.pt für andere Größen

metrics = model.val(data="coco128-seg.yaml")
data kann auch eine NDJSON-Datei oder eine URI für einen Plattform-ul://-Datensatz sein; sie wird in das YOLO-Format umgewandelt, bevor die Text- oder visuellen Prompts erstellt werden.
Zwei Varianten desselben Aufrufs decken die anderen Prompt-Modi ab:
- Visuelle Prompts —
model.val(data="coco128-seg.yaml", load_vp=True)extrahiert für jede Kategorie ein visuelles Embedding direkt aus dem Datensatz. Ergänzerefer_data="coco.yaml", um die Embeddings aus einem anderen Datensatz zu übernehmen. Dieser muss genau dieselben Kategorien enthalten. - Ohne Prompts — lade einen
*-seg-pf.pt-Checkpoint und übergibsingle_cls=True.
Export verwenden#
Prompt-Embeddings lassen sich einmal speichern und für statische Exporte wie ONNX, OpenVINO, TensorRT, CoreML, LiteRT und RKNN wiederverwenden. Das NPZ-Profil wird vor dem Export in das ursprüngliche PyTorch-Modell geladen. Es ist keine zusätzliche Laufzeiteingabe erforderlich, und das exportierte Modell benötigt die NPZ-Datei nicht.
Klassen, die mit set_classes() (oder bei visuellen Prompts über refer_image) konfiguriert wurden, sind fest in die exportierten Gewichte integriert. Nach dem Export kann das Modell keine neuen Prompts mehr entgegennehmen: Ein Aufruf von set_classes() oder die Übergabe von visual_prompts=... an predict() bei einem geladenen Export schlägt fehl. Um die erkannten Klassen zu ändern, exportierst du den ursprünglichen .pt-Checkpoint mit den neu konfigurierten Prompts erneut. Die exportierte Datei verhält sich wie ein gewöhnliches YOLO-Modell und kann statt mit YOLOE() auch mit YOLO() geladen werden.
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# Das Profil ist an den Quell-Checkpoint gebunden und kann für spätere Exporte wiederverwendet werden.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
Dasselbe Prompt-Profil kann auch ein reines Detektionsmodell konfigurieren, das auf der passenden YOLOE-Architektur basiert. Dadurch wird der Maskenzweig entfernt, während die mit Prompts ausgewählten Klassen erhalten bleiben:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)Tracking-Nutzung#
Die mit Prompts ausgewählten Klassen lassen sich direkt zum Tracking übernehmen. So kannst du Objekte verfolgen, mit denen der Tracker nie trainiert wurde:
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True sorgt dafür, dass die Track-IDs über mehrere Bilder hinweg stabil bleiben
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
YOLOE im Vergleich#
YOLOE liegt zwischen einem Detektor mit geschlossenem Klassenumfang und einem umfangreichen Modell mit offenem Vokabular. Drei Vergleiche zeigen, ob YOLOE die richtige Wahl ist:
- Im Vergleich zu einem YOLO-Modell mit geschlossenem Klassenumfang. Sobald die Prompts festgelegt sind, erstellt YOLOE Vorhersagen über den üblichen Detektions- und Segmentierungspfad und lässt sich wie jedes andere Modell exportieren. Der Vorteil: Die Klassenliste lässt sich zur Inferenzzeit ändern, ohne neu zu trainieren. Der Nachteil: Die Zero-Shot-Genauigkeit liegt deutlich unter der eines Modells, das auf deinen eigenen Klassen trainiert wurde.
- Im Vergleich zu früheren YOLOE-Modellfamilien. YOLOE-26 übernimmt den NMS-freien End-to-End-Kopf von YOLO26, deckt fünf Größenklassen ab (n/s/m/l/x) statt der drei früheren (s/m/l) und liegt in jeder vergleichbaren Größenklasse in der Leistung vorn.
- Im Vergleich zu Transformer-basierten Detektoren mit offenem Vokabular. GLIP und OWL-ViT führen bei der Inferenz einen Vision-Language-Transformer aus. YOLOE kodiert die Prompts einmal und vergleicht sie anschließend in einem Faltungskopf mit den Merkmalen der Regionen.
Die nächstliegenden Alternativen akzeptieren alle einen Text-Prompt, aber nur YOLOE und SAM 3 geben Masken zurück. Die drei Modelle beantworten unterschiedliche Fragen:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Entwickelt für | Echtzeit-Detektion und -Segmentierung benannter Klassen | Konzeptsegmentierung und Tracking mit Prompts | Detektion mit offenem Vokabular in Echtzeit |
| Masken | Ja, mit den *-seg.pt-Checkpoints | Ja | Nein, nur Boxen |
| Visuelle Prompts | Ja (SAVPE) | Ja | Nein |
| Modus ohne Prompts | Ja, Vokabular mit 4,585 Namen | Nein | Nein |
| Wähle dieses Modell, wenn | Du hohen Durchsatz brauchst und die Klassen benennen kannst | Du die leistungsstärkste Konzeptsegmentierung brauchst und den Rechenaufwand in Kauf nehmen kannst | Du es bereits verwendest — siehe den Migrationshinweis unten |
Du kommst von YOLO-World? Die API hat denselben Aufbau: Ersetze YOLOWorld durch YOLOE, lade einen *-seg.pt-Checkpoint und lass deinen Aufruf von set_classes() unverändert. Du erhältst Masken und visuelle Prompts; der Hinweis zum Export bezüglich eingefrorener Klassen gilt für beide Modelle.
Anwendungsfälle und Einsatzbereiche#
Bei der Detektion mit offenem Vokabular entfällt das erneute Training für jede Klasse. Das ist besonders wichtig, wenn die Zielliste im Voraus nicht bekannt ist:
- Detektion in offenen Umgebungen — Robotik und Sicherheitssysteme, in denen Objekte auftauchen, die zum Trainingszeitpunkt niemand aufgelistet hat.
- One-Shot-Detektion anhand eines Beispiels — Mit visuellen Prompts lässt sich ein bestimmtes Bauteil, Logo oder ein Defekt anhand einer einzelnen Referenzbox erkennen. Das ist nützlich für die industrielle Inspektion.
- Erfassung einer großen Bandbreite von Objekten — Das integrierte Vokabular mit 4,585 Namen ist breit genug für Biodiversitätsmonitoring oder die Bestandsaufnahme im Einzelhandel.
- Datensatzaufbau — Bilder vor der menschlichen Prüfung mit Boxen und Masken vorbeschriften und anschließend mit den Ergebnissen ein schnelles Modell mit geschlossenem Klassenumfang trainieren.
- Segmentierung beliebiger Zielobjekte — Die verfügbaren
*-seg.pt-Checkpoints geben für jede Vorhersage eine Maske zurück. So erhältst du in der medizinischen Bildgebung und bei der Satellitenbildanalyse pixelgenaue Ergebnisse ohne ein zweites Modell.
Ein gängiges Vorgehen kombiniert zwei Modi: Zuerst wird einmal der Modus ohne Prompts ausgeführt, um die vorhandenen Objekte zu entdecken. Anschließend wechselst du für die relevanten Kategorien zu Text-Prompts.
Einschränkungen#
YOLOE tauscht Genauigkeit gegen die Möglichkeit ein, Klassen zur Inferenzzeit zu ändern. Das solltest du vor deiner Entscheidung wissen:
- Die Zero-Shot-Genauigkeit liegt deutlich unter der eines Modells, das auf deinen Klassen trainiert wurde. Die Checkpoints mit Prompts erreichen auf LVIS minival ungefähr 22–40 mAP. Ein YOLO-Modell mit geschlossenem Klassenumfang, das auf deinen eigenen Daten trainiert wurde, erzielt bei diesen Klassen bessere Ergebnisse. Nutze YOLOE für Klassen, für die du nicht trainieren kannst, und nicht als Ersatz für das Training.
- Seltene Kategorien sind die Schwachstelle. Die Spalte mAPr unter Leistung gibt die Genauigkeit speziell für seltene Klassen in LVIS an. Bei Text-Prompts liegt sie in jeder Zeile unter den Werten für häufige und sehr häufige Klassen. Wenn deine Zielobjekte ungewöhnlich sind, prüfe diesen Wert statt der Gesamt-mAP.
- Ein Prompt beschreibt das Erscheinungsbild, nicht Beziehungen. Die Detektion vergleicht Regionsmerkmale mit dem Prompt-Embedding. Für Prompts, die von Zustand, Kontext oder Vergleichen abhängen — etwa „beschädigt“, „ganz links“ oder „die Person, die getragen wird“ — gibt es daher keine zuverlässige Grundlage für einen Treffer. Verwende möglichst Formulierungen, die gebräuchlichen Kategorienamen entsprechen.
- Große Prompt-Sets erhöhen die Latenz. Die Prompt-Embeddings werden einmal berechnet, aber bei jedem Vorwärtslauf mit den Regionsmerkmalen verglichen. Bei Messungen auf einer CPU mit
yoloe-26s-seg.ptverlängert sich ein Vorwärtslauf beim Wechsel von 80 auf 1,203 Klassen um etwa 19 % und beim vollständigen Vokabular mit 4,585 Namen um etwa 89 %. Die ausgewiesenen FLOPs ändern sich überhaupt nicht, da die Ähnlichkeit zwischen Regionen und Text nicht mitgezählt wird. Das Profil weist dich daher nicht auf den Mehraufwand hin. - Klassennamen sind Platzhalter, bis du Prompts übergibst. Ein frisch geladener
*-seg.pt-Checkpoint gibtnc=80mit numerischen Namen zurück ("0","1", …). Rufe daherset_classes()auf, bevor du die Labels ausliest. Bei Checkpoints ohne Prompts ist das vollständige Vokabular bereits enthalten.
Hinweise zur Bereitstellung#
- Hardware. Für die Inferenz benötigst du eine NVIDIA-GPU mit 4–8 GB VRAM. Die Größenklassen
nundslaufen mit geringerer Auflösung auf Edge-GPUs wie Jetson oder auf einer CPU. Für das Fine-Tuning ist eine einzelne GPU erforderlich. - NMS ist standardmäßig klassenunabhängig. YOLOE erstellt Vorhersagen mit
agnostic_nms=True. Standardmäßig werden dabei überlappende Boxen mit niedrigeren Konfidenzwerten auch dann unterdrückt, wenn sie zu anderen Klassen gehören, statt nur Boxen derselben Klasse. So werden Duplikate vermieden, wenn ein Objekt zu mehreren Kategorien passt. Mitnms=Falsewendet YOLOE-26 keine IoU-Unterdrückung an. Im klassenunabhängigen Modus bleibt nur die beste Klasse pro Anker erhalten, statt dass ein Anker mehrere Klassenlabels ausgibt. Übergibagnostic_nms=False, um dieses Verhalten zu überschreiben. - Für visuelle Prompts gilt standardmäßig
conf=0.05. Boxen für visuelle Prompts sind häufiger korrekt, als ihre Scores vermuten lassen: Auf LVIS minival übersieht YOLOE-26 bei einer Instanz einer Klasse als Prompt 44 bis 55 % der übrigen Instanzen, die YOLOE-26 beiconf=0.05findet, wennconf=0.25verwendet wird. Dicht gedrängte Szenen mit nahezu identischen Objekten, etwa in Verkaufsregalen oder bei Zellen, können niedrigere Werte erfordern. Mitnms=Falseerzielt der One-to-One-Head von YOLOE-26 sogar noch niedrigere Scores; sein bester Schwellenwert liegt nahe bei0.01. Jeder weitere Aufruf verwendetconf=0.25, einschließlich späterer Aufrufe sowie gespeicherter Embeddings und Exporte, die Klassen wiederverwenden, die mitrefer_imagefestgelegt wurden. Übergibconf, um den Wert zu überschreiben. - Batch-Verarbeitung. Batch-Inferenz wird direkt unterstützt. Visuelle Prompts können sich außerdem innerhalb desselben Aufrufs von Bild zu Bild unterscheiden.
Die offiziellen Modelle von Grund auf trainieren#
Die meisten Leserinnen und Leser benötigen das nicht. Damit lassen sich die veröffentlichten Checkpoints mit offenem Vokabular anhand von Objects365, GQA und Flickr30k reproduzieren — ungefähr 1,4 Mio. Trainingsbeispiele auf 8× RTX 4090. Das hat nichts mit dem Fine-Tuning auf deinen eigenen Daten zu tun, das oben unter Training verwenden beschrieben wird.
Jeder Trainer, der von YOLOETrainer erbt, verweigert compile=True. Das betrifft auch den Standardtrainer YOLOESegTrainer und alle unten aufgeführten Trainer für das Training von Grund auf. Übergib compile=False (den Standardwert). Für die beiden oben verwendeten Trainer zur Feinabstimmung, YOLOEPESegTrainer und YOLOEPETrainer, gilt diese Einschränkung nicht.
Für das Training werden Segmentierungsannotationen benötigt. Lade entweder die unten aufbereiteten Dateien herunter oder erstelle eigene mithilfe des vom offiziellen Team bereitgestellten Skripts, das auf SAM 2.1 basiert. Für die Validierung wird LVIS minival verwendet.
| Datensatz | Typ | Beispiele | Boxen | Aufbereitete Segmentierungsannotationen |
|---|---|---|---|---|
| Objects365v1 | Erkennung | 609k | 9621k | objects365_train_segm.json |
| GQA | Grounding | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Grounding | 149k | 641k | final_flickr_separateGT_train_segm.json |
Zuerst wird das Modell mit Text-Prompts trainiert. Die beiden anderen Prompt-Modi bauen darauf auf:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # oder der Pfad zu einer YAML-Datei mit derselben Struktur
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
Die Checkpoints für visuelle Prompts und promptfreie Inferenz gehen vom trainierten Text-Prompt-Modell aus und aktualisieren jeweils ein Modul. YOLOESegVPTrainer ist das Rezept für visuelle Prompts und YOLOEPEFreeTrainer das promptfreie Rezept. Keine der beiden Klassen friert jedoch selbst etwas ein: Das selektive Training wird durch die Liste freeze gesteuert, die du zusammen mit der Klasse übergibst. Sie führt alle untergeordneten Elemente des Heads außer savpe auf (beziehungsweise alle Klassifizierungstürme). Für den promptfreien Lauf wird zusätzlich single_cls=True benötigt. Das YOLOE-Repository des Upstream-Projekts enthält die vollständigen Rezepte für die Modelle im v8-Maßstab.
Ein abgeschlossener promptfreier Lauf wird in einen reparametrisierten Checkpoint umgewandelt, der bei der Inferenz seine Klassennamen ohne Prompt ausgibt. Dafür werden get_vocab und set_vocab verwendet:
from ultralytics import YOLOE

# Gewichte, die vom promptfreien Lauf und vom Text-Prompt-Lauf geschrieben wurden, mit dem er gestartet wurde. Jeder
# erneute Lauf erstellt ein neues Verzeichnis (train-2, train-3, ...); verwende daher die von den Läufen ausgegebenen Pfade.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # promptfreier Lauf, sein Head ist bereits fusioniert
text_model = YOLOE("runs/segment/train/weights/best.pt")  # Text-Prompt-Lauf, sein Head ist noch nicht fusioniert

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # das Vokabular mit 4.585 Namen oder deine eigene Liste
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt")  # überschreibe niemals den veröffentlichten Checkpoint
get_vocab gibt den Zweig zurück, den das Flag end2end des Modells auswählt, und set_vocab reparametrisiert diesen Zweig. Die veröffentlichten YOLOE-26-Dateien enthalten stattdessen ein Vokabular pro Zweig. Dadurch kann nms zwischen den Zweigen auswählen. Um das nachzubilden, nimm das zweite Vokabular aus einer weiteren Kopie des Text-Prompt-Modells. YOLOE-11 und YOLOE-v8 haben nur einen Zweig; dort kannst du den obigen Aufruf unverändert verwenden.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab fusioniert den eingelesenen Head; lade daher eine zweite Kopie
one2one_model.model.end2end = True  # den NMS-freien Zweig einlesen

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Zitate und Danksagungen#
Wenn YOLOE zu deiner Forschung oder deinem Projekt beigetragen hat, zitiere bitte die Originalarbeit von Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han und Guiguang Ding von der Tsinghua-Universität:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Weitere Informationen findest du in der Originalarbeit zu YOLOE auf arXiv. Den Quellcode des Projekts und weitere Ressourcen findest du im GitHub-Repository.
Häufig gestellte Fragen#
Ultralytics YOLOE bietet zwei Funktionen, die YOLO-World nicht hat: visuelle Prompts, bei denen eine Beispielbox den Klassennamen ersetzt, und promptfreie Checkpoints, die ohne Prompt anhand eines integrierten Vokabulars mit 4.585 Namen antworten. Jede Vorhersage der veröffentlichten
*-seg.pt-Checkpoints enthält außerdem eine Maske zur Instanzsegmentierung. Bei der Genauigkeit liegt YOLOE-v8s laut Originalarbeit zu YOLOE bei LVIS um 3,5 AP vor YOLO-Worldv2-S – bei einem Drittel der Trainingskosten und 1,4-facher Inferenzgeschwindigkeit. Die Umstellung erfordert nur eine einzige Codezeile – siehe YOLOE im Vergleich.Ultralytics YOLOE unterstützt drei Prompt-Modi. Ein Text-Prompt besteht aus Klassennamen als Zeichenfolgen auf einem
*-seg.pt-Checkpoint und ist die übliche Wahl. Ein visueller Prompt besteht aus einer oder mehreren Beispielboxen auf einem Referenzbild und eignet sich für Objekte, die sich nur schwer in Worte fassen lassen. Bei der promptfreien Inferenz wird ein separater*-seg-pf.pt-Checkpoint verwendet, der anhand eines integrierten Vokabulars mit 4.585 Namen antwortet, ohne dass etwas übergeben werden muss. Für Text- und visuelle Prompts werden dieselben Checkpoints verwendet; promptfreie Prompts nutzen andere Dateien und weisenset_classes()zurück. Einen vollständigen Vergleich findest du unter Den passenden Prompt-Modus wählen.Beginne mit
yoloe-26s-seg.pt: Die YOLOE-26-Familie übertrifft YOLOE-11 und YOLOE-v8 bei allen vergleichbaren Größen, und die Größesist die kleinste mit mehr als 30 mAP auf LVIS minival. Wechsle zum,loderx, wenn die Genauigkeit bei seltenen Kategorien wichtiger ist als die Latenz – vergleiche dazu die Spalte mAPr unter Leistung. Verwendennur für den Einsatz auf Edge-Geräten. Lade stattdessen die Datei*-seg-pf.ptderselben Größe, wenn du das integrierte Vokabular anstelle deiner eigenen Klassennamen verwenden möchtest.Bezeichnungen wie
object0undobject1bedeuten, dass die Vorhersage von einem visuellen Prompt stammt. Dabei werden die Beispielboxen zu temporären nummerierten Klassen zusammengefasst, anstatt deine Namen zu übernehmen. Die Klassen-IDs, die du invisual_prompts["cls"]übergibst, dienen nur dieser Gruppierung. Das Modell gibt sie alsobject0,object1usw. in der Reihenfolge der von dir zugewiesenen IDs aus. Ordne sie daher im Ergebnis wieder deinen eigenen Bezeichnungen zu. Wenn deine Namen in der Ausgabe erscheinen sollen, verwende stattdessen einen Text-Prompt.Promptfreie Checkpoints (
*-seg-pf.pt) ordnen Klassen anhand ihres eigenen integrierten Vokabulars zu und weisenset_classes()mitAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.zurück. Visuelle Prompts lösenAssertionError: Visual prompts need an unfused YOLOE model.aus. Lade einen*-seg.pt-Checkpoint, wenn du eine eigene Klassenliste benötigst. Siehe Einen Prompt-Modus auswählen.Beim ersten Text-Prompt installiert Ultralytics YOLOE ultralytics/CLIP von GitHub mit
pipund lädt einen TorchScript-Text-Encoder in das aktuelle Arbeitsverzeichnis herunter – etwa 254 MB für YOLOE-26. Die genauen Ressourcen für die einzelnen Modellfamilien findest du unter Installation und Anforderungen. Für visuelle Prompts und promptfreie Checkpoints ist beides nicht erforderlich. Um den Download auf dem Zielsystem zu vermeiden, lege die Prompts einmal fest und speichere sie mitsave_prompt_embeddings(), oder exportiere das Modell mit bereits konfigurierten Klassen.Nein – YOLOE speichert die vorgegebenen Klassen beim Export in den Gewichten. Ein geladener Export weist daher sowohl
set_classes()als auchvisual_prompts=zurück. Exportiere das Modell erneut aus dem ursprünglichen.pt-Checkpoint, nachdem du die neuen Prompts konfiguriert hast. Die exportierte Datei verhält sich wie ein standardmäßiges YOLO-Modell und kann sowohl mitYOLO()als auch mitYOLOE()geladen werden.Verwende YOLOE, wenn du einen hohen Durchsatz in Echtzeit benötigst und die Klassen benennen kannst, und SAM 3, wenn die Segmentierungsqualität eines Konzepts wichtiger ist als die Geschwindigkeit. Beide akzeptieren visuelle Beispiele; nur YOLOE bietet einen promptfreien Modus. Den vollständigen Vergleich findest du unter YOLOE im Vergleich.


Kommentare60
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(bearbeitet)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(bearbeitet)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.