Conjunto de datos ImageNet#
El conjunto de datos Ultralytics ImageNet (data="imagenet") es el subconjunto ImageNet-1k / ILSVRC-2012 utilizado para entrenar y evaluar modelos de clasificación de imágenes. Contiene 1.000 clases de objetos, con 1.281.167 imágenes de entrenamiento y 50.000 imágenes de validación con un tamaño de imagen de 224x224, y ocupa aproximadamente 144 GB al descargarse. La base de datos ImageNet completa es mucho más grande —más de 14 millones de imágenes de alta resolución anotadas con synsets de WordNet en más de 20.000 categorías—, pero Ultralytics entrena con el subconjunto ILSVRC estandarizado de 1.000 clases, que se convirtió en el estándar de facto para el aprendizaje profundo en visión artificial.
Modelos de ImageNet preentrenados#
| Modelo | tamaño (píxeles) | acc top1 | acc top5 | Velocidad CPU ONNX (ms) | Velocidad T4 TensorRT10 (ms) | parámetros (M) | FLOPs (B) a 224 |
|---|---|---|---|---|---|---|---|
| YOLO26n-cls | 224 | 71.4 | 90.1 | 5.0 ± 0.3 | 1.1 ± 0.0 | 2.8 | 0.4 |
| YOLO26s-cls | 224 | 76.0 | 92.9 | 7.9 ± 0.2 | 1.3 ± 0.0 | 6.7 | 1.5 |
| YOLO26m-cls | 224 | 78.1 | 94.2 | 17.2 ± 0.4 | 2.0 ± 0.0 | 11.6 | 4.8 |
| YOLO26l-cls | 224 | 79.0 | 94.6 | 23.2 ± 0.3 | 2.8 ± 0.0 | 14.1 | 6.0 |
| YOLO26x-cls | 224 | 79.9 | 95.0 | 41.4 ± 0.9 | 3.8 ± 0.0 | 29.6 | 13.5 |
Características principales#
- El conjunto de datos
imagenetde Ultralytics proporciona 1.000 clases, con 1.281.167 imágenes de entrenamiento y 50.000 de validación (ILSVRC-2012), el estándar para el preentrenamiento de modelos de clasificación de imágenes. - Las clases se organizan según la jerarquía de WordNet, donde cada clase corresponde a un synset (un conjunto de términos sinónimos).
- Las imágenes se entrenan con un tamaño de 224x224, y el conjunto de datos completo ocupa aproximadamente ~144 GB al descargarse.
- El Desafío de Reconocimiento Visual a Gran Escala de ImageNet (ILSVRC), celebrado anualmente, ha sido fundamental para impulsar la investigación en visión artificial.
Estructura del dataset#
El conjunto de datos ImageNet de Ultralytics utiliza la división ILSVRC-2012:
| Subconjunto | Imágenes | Clases |
|---|---|---|
| Entrenar | 1,281,167 | 1,000 |
| Validación | 50,000 | 1,000 |
Las imágenes se almacenan en carpetas independientes por clase, cuyos nombres son los ID de los synsets de WordNet (por ejemplo, n01440764), que es la estructura que espera el entrenamiento de clasificación de Ultralytics. Cada una de las 1.000 clases se corresponde con un synset de WordNet y no existe una división de prueba independiente, por lo que el conjunto de validación de 50.000 imágenes se utiliza para medir la precisión.
ImageNet-1k ocupa aproximadamente ~144 GB al descargarse, así que asegúrate de tener suficiente espacio en disco antes de entrenar. Para hacer pruebas rápidas, los subconjuntos más pequeños ImageNette e ImageNet10 utilizan el mismo formato de carpetas y se entrenan en una fracción del tiempo.
Desafío de Reconocimiento Visual a Gran Escala de ImageNet (ILSVRC)#
El Desafío de Reconocimiento Visual a Gran Escala de ImageNet (ILSVRC), celebrado anualmente, permitió a los investigadores comparar algoritmos en un conjunto de datos estandarizado y a gran escala, con métricas de evaluación coherentes. Impulsó grandes avances en aprendizaje profundo para la clasificación de imágenes, la detección de objetos y otras tareas de visión, especialmente la victoria de AlexNet en 2012, que contribuyó a inaugurar la era moderna del aprendizaje profundo.
Aplicaciones#
El conjunto de datos ImageNet se utiliza ampliamente para entrenar y evaluar modelos de aprendizaje profundo destinados a la clasificación de imágenes, la detección de objetos y la localización de objetos. Arquitecturas emblemáticas como AlexNet, VGG y ResNet se desarrollaron y evaluaron en ImageNet, y los pesos preentrenados con ImageNet siguen siendo un punto de partida habitual para el aprendizaje por transferencia en distintas tareas de visión.
Uso#
Para entrenar un modelo de clasificación YOLO con ImageNet durante 100 épocas y con un tamaño de imagen de 224x224, utiliza los fragmentos de código siguientes. Para consultar una lista completa de los argumentos disponibles, visita la página de Entrenamiento del modelo.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="imagenet", epochs=100, imgsz=224)
También puedes gestionar conjuntos de datos de clasificación y ejecutar entrenamientos en la nube con Ultralytics Platform.
Imágenes de ejemplo y anotaciones#
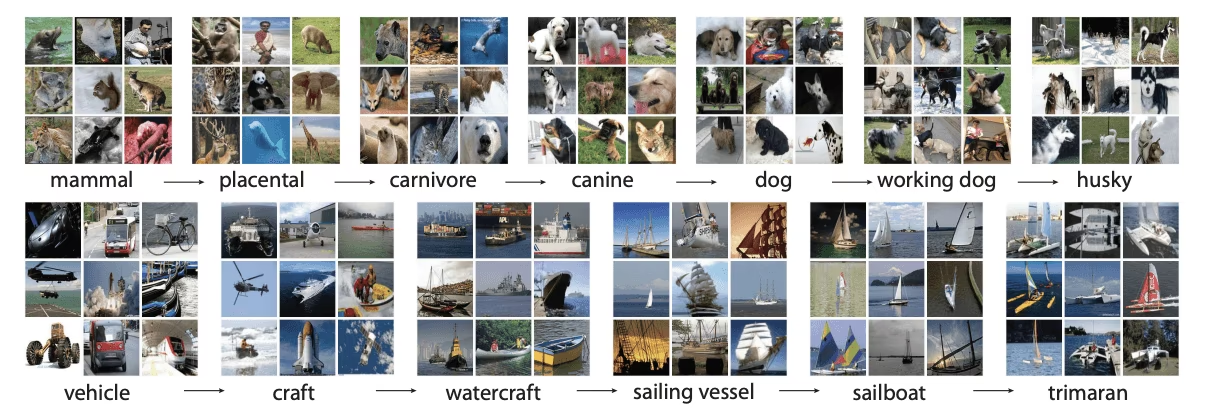
El conjunto de datos ImageNet abarca las 1.000 clases de ILSVRC-2012 y proporciona un recurso diverso y extenso para entrenar y evaluar modelos de visión artificial. Estas son algunas imágenes de ejemplo del conjunto de datos:
Citas y agradecimientos#
Si utilizas el conjunto de datos ImageNet en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
@article{ILSVRC15,
         author = {Olga Russakovsky and Jia Deng and Hao Su and Jonathan Krause and Sanjeev Satheesh and Sean Ma and Zhiheng Huang and Andrej Karpathy and Aditya Khosla and Michael Bernstein and Alexander C. Berg and Li Fei-Fei},
         title={ImageNet Large Scale Visual Recognition Challenge},
         year={2015},
         journal={International Journal of Computer Vision (IJCV)},
         volume={115},
         number={3},
         pages={211-252}
}
Queremos reconocer al equipo de ImageNet, liderado por Olga Russakovsky, Jia Deng y Li Fei-Fei, por crear y mantener el conjunto de datos ImageNet como un recurso valioso para la comunidad de investigación en aprendizaje automático y visión artificial. Para obtener más información sobre el conjunto de datos ImageNet y sus creadores, visita el sitio web de ImageNet.
Preguntas frecuentes#
El conjunto de datos ImageNet es una base de datos de imágenes a gran escala cuya colección completa contiene más de 14 millones de imágenes de alta resolución anotadas con synsets de WordNet. En Ultralytics,
data="imagenet"entrena con el subconjunto ILSVRC-2012 estandarizado de 1.000 clases, que es el estándar de facto para el preentrenamiento de clasificación de imágenes. Modelos emblemáticos como AlexNet, VGG y ResNet se entrenaron y evaluaron en ImageNet, lo que pone de manifiesto su papel en el avance de la visión artificial.El conjunto de datos
imagenetde Ultralytics utiliza el subconjunto ILSVRC-2012 con 1.000 clases, 1.281.167 imágenes de entrenamiento y 50.000 imágenes de validación con un tamaño de imagen de 224x224, y ocupa aproximadamente 144 GB al descargarse. La base de datos completa de ImageNet es mucho más grande (más de 14 millones de imágenes distribuidas entre más de 20.000 synsets de WordNet), pero el subconjunto de 1.000 clases es el que se utiliza para entrenar y evaluar modelos de clasificación.Para entrenar un modelo YOLO de Ultralytics con ImageNet, carga un modelo de clasificación preentrenado y asigna
dataaimagenet:Ejemplo de entrenamientofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="imagenet", epochs=100, imgsz=224)Para obtener instrucciones de entrenamiento más detalladas, consulta nuestra página de Entrenamiento.
Los modelos YOLO26 preentrenados de Ultralytics ofrecen un rendimiento de vanguardia en velocidad y precisión para diversas tareas de visión artificial. Por ejemplo, el modelo YOLO26n-cls, con una precisión top-1 del 71,4 % y una precisión top-5 del 90,1 %, está optimizado para aplicaciones en tiempo real. Los modelos preentrenados reducen los recursos computacionales necesarios para entrenar desde cero y aceleran los ciclos de desarrollo. Descubre más información sobre las métricas de rendimiento de los modelos YOLO26 en la sección Modelos de ImageNet preentrenados.
El Desafío de Reconocimiento Visual a Gran Escala de ImageNet (ILSVRC), celebrado anualmente, impulsó avances en visión artificial al proporcionar una plataforma competitiva para evaluar algoritmos con un conjunto de datos estandarizado y a gran escala. Sus métricas de evaluación coherentes fomentaron la innovación en clasificación de imágenes, detección de objetos y segmentación de imágenes, ampliando continuamente los límites del aprendizaje profundo y la visión artificial.