Conjunto de datos de tumores cerebrales
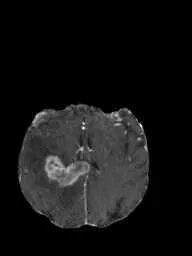
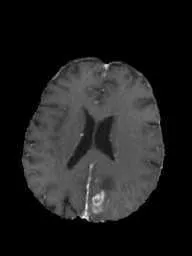
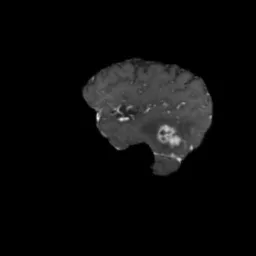
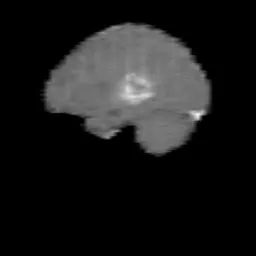

El conjunto de datos Brain Tumor de Ultralytics es un conjunto de datos de detección de objetos con 1.115 imágenes de resonancia magnética cerebral (994 para entrenamiento y 121 para validación) y 1.180 cajas delimitadoras en una sola clase, tumor. Cada imagen contiene de 1 a 3 cajas de tumores. El subconjunto de validación contiene las imágenes de 25 pacientes identificados, y ningún paciente identificado aparece en ambos subconjuntos. Con un tamaño de 4,06 MB, es un conjunto de datos compacto para aprender y crear prototipos de modelos de visión artificial destinados a aplicaciones sanitarias, y no es un recurso de diagnóstico validado clínicamente.
Ver: Detección de tumores cerebrales con Ultralytics Platform y Ultralytics YOLO26 | Detección de objetos 🚀
Estructura del conjunto de datos#
El conjunto de datos Brain Tumor de Ultralytics contiene 1.115 imágenes de resonancia magnética cerebral y 1.180 cajas delimitadoras en dos subconjuntos definidos en la configuración brain-tumor.yaml:
| División | Imágenes | Cajas delimitadoras | Pacientes |
|---|---|---|---|
| Entrenar | 994 | 1,057 | 95 con ID, más 541 imágenes sin ID de paciente |
| Validación | 121 | 123 | 25 |
| Total | 1,115 | 1,180 |
Cada imagen contiene de 1 a 3 cajas delimitadoras de la única clase tumor, y los tamaños de imagen van de 192x256 a 512x512 píxeles. La configuración no define un subconjunto de prueba independiente.
El subconjunto de validación se crea por paciente. Algunos nombres de archivo empiezan por un ID de paciente de cinco dígitos: por ejemplo, 00097_77.jpg corresponde al paciente 00097. Las imágenes con los ID de 25 de estos pacientes forman el subconjunto de validación, mientras que las imágenes de los otros 95 pacientes identificados están en el de entrenamiento, por lo que ningún paciente identificado aparece en ambos subconjuntos. Las 541 imágenes restantes no tienen ID de paciente en el nombre del archivo y están todas en el subconjunto de entrenamiento.
El conjunto de datos se descarga automáticamente (4,06 MB) desde los recursos de Ultralytics en GitHub la primera vez que entrenas, por lo que no hace falta descargarlo ni prepararlo manualmente.
El conjunto de datos pasó a tener una sola clase tumor en noviembre de 2026. Si tu carpeta local brain-tumor/images/train contiene 893 imágenes en lugar de 994, elimina la carpeta brain-tumor del directorio de conjuntos de datos (consulta datasets_dir en yolo settings) y actualiza el paquete con pip install -U ultralytics. La versión actual se descargará en el siguiente entrenamiento.
Explora Tumores cerebrales en Ultralytics Platform para ver las imágenes con sus superposiciones de anotaciones, consultar la distribución de clases y los mapas de calor de los cuadros delimitadores en la pestaña Charts, y clonarlo para entrenar tu propio modelo en la nube.
Aplicaciones#
Los modelos de detección de tumores cerebrales localizan tumores en imágenes de resonancia magnética cerebral. Con 1.115 imágenes y una descarga de 4,06 MB, el conjunto de datos Brain Tumor de Ultralytics es adecuado para:
- Aprender el flujo de trabajo: ejecutar el ciclo completo de entrenamiento, validación y predicción con imágenes médicas y un conjunto de datos pequeño.
- Crear prototipos: desarrollar y probar una canalización de localización de tumores antes de pasar a un conjunto de datos clínicos de mayor tamaño.
- Evaluar con pacientes identificados: medir la detección en los 25 pacientes de validación. Como 541 imágenes de entrenamiento no tienen ID de paciente, no se puede descartar que haya solapamiento con estos pacientes.
- Investigación y formación: comparar modelos de detección y estudiar el análisis de imágenes médicas y la IA en radiología.
Los modelos entrenados con este conjunto de datos están destinados a la investigación y la formación, y no están validados para el diagnóstico clínico.
YAML del conjunto de datos#
La configuración brain-tumor.yaml define la ruta del conjunto de datos, las carpetas de imágenes de entrenamiento y validación, la única clase tumor y la URL de descarga. Las etiquetas utilizan el formato YOLO de Ultralytics.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Brain-tumor dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor
# Example usage: yolo train data=brain-tumor.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── brain-tumor ← downloads here (4.06 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: brain-tumor # dataset root dir
train: images/train # train images (relative to 'path') 994 images
val: images/val # val images (relative to 'path') 121 images

# Classes
names:
  0: tumor

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipUso#
Para entrenar un modelo YOLO26n con el conjunto de datos de tumores cerebrales durante 100 épocas y con un tamaño de imagen de 640, utiliza los fragmentos de código siguientes.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Cargar un modelo
model = YOLO("path/to/best.pt") # carga un modelo ajustado con brain-tumor
# Inferencia con el modelo
results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Imágenes de muestra y anotaciones#
A continuación se muestran imágenes de ejemplo del conjunto de datos Brain Tumor de Ultralytics con sus anotaciones:
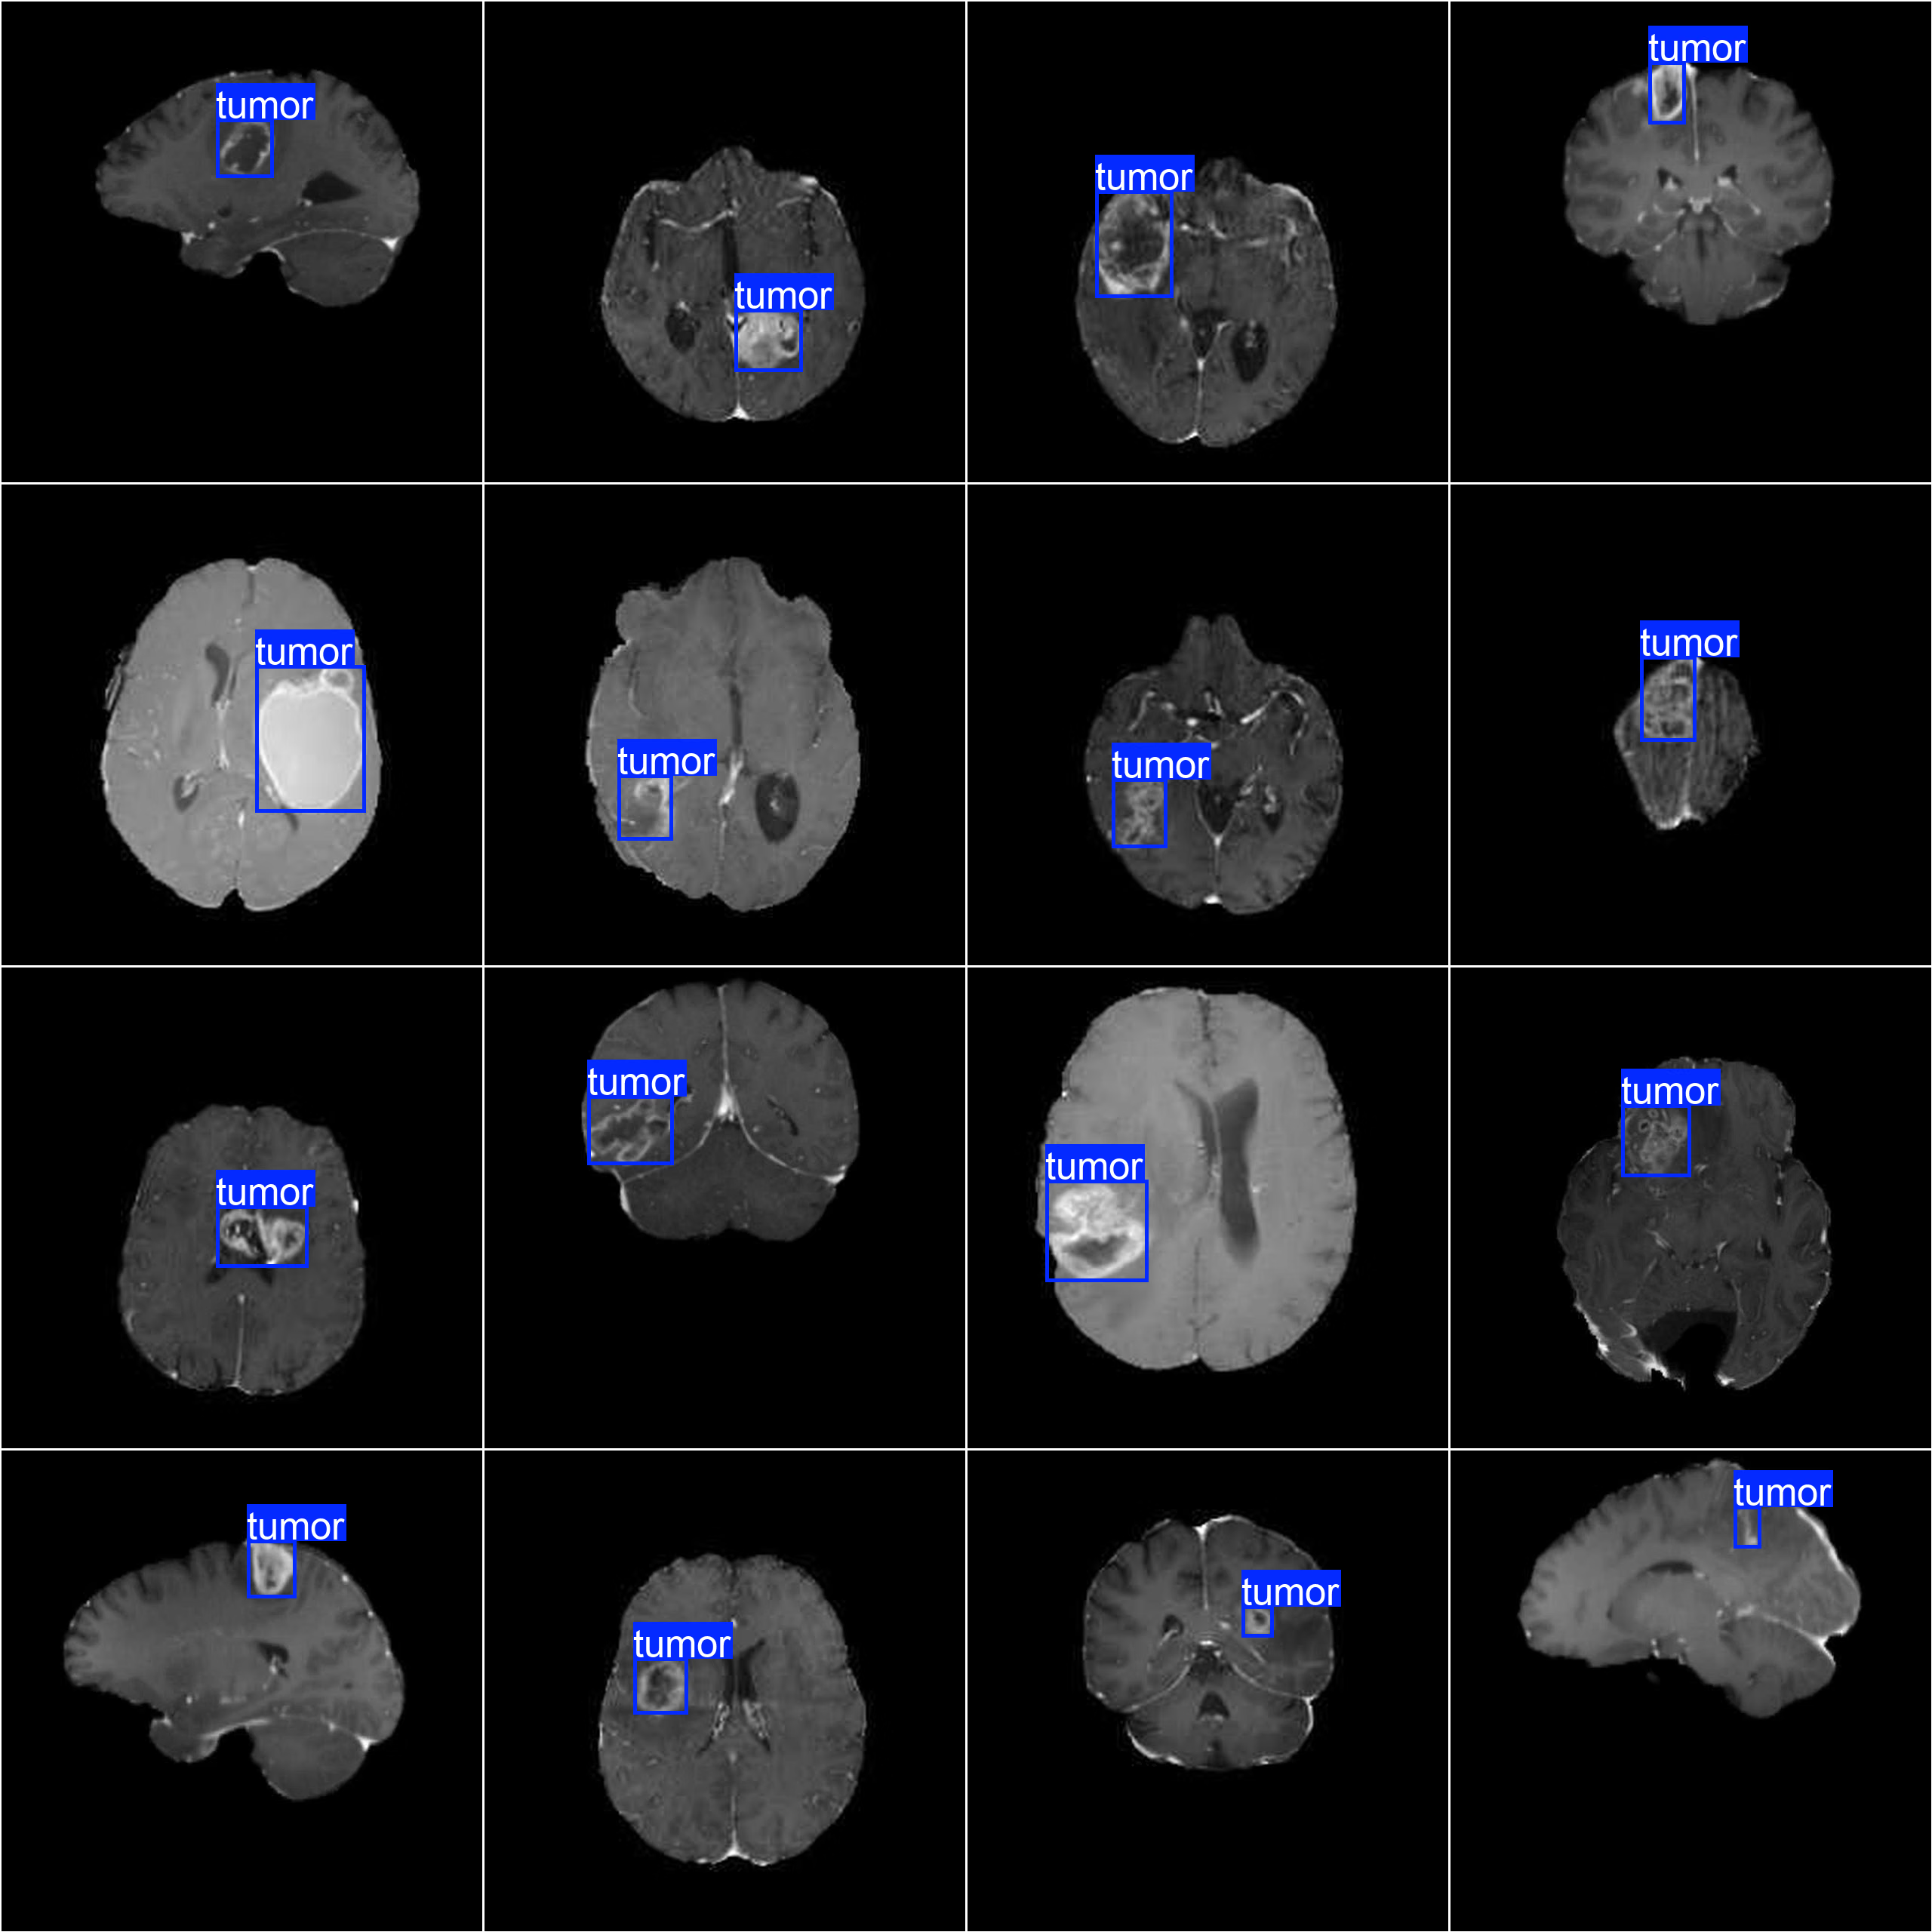
- Imágenes anotadas: la cuadrícula muestra 16 imágenes de entrenamiento, cada una con una caja delimitadora
tumoralrededor de la lesión. Los tumores varían en tamaño, forma y ubicación en el conjunto de datos, lo que ayuda a un modelo de detección a generalizar.
Citas y agradecimientos#
El conjunto de datos está disponible con la Licencia AGPL-3.0.
Si utilizas el conjunto de datos de tumores cerebrales en tu trabajo de investigación o desarrollo, cita la siguiente referencia:
@dataset{Ultralytics_Brain_Tumor_Dataset_2023,
    author = {Ultralytics},
    title = {Brain Tumor Detection Dataset},
    year = {2023},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/brain-tumor}
}
Preguntas frecuentes#
El conjunto de datos Brain Tumor de Ultralytics tiene 1.115 imágenes de resonancia magnética cerebral y 1 clase,
tumor: 994 imágenes de entrenamiento con 1.057 cajas delimitadoras y 121 imágenes de validación con 123 cajas delimitadoras. Cada imagen tiene de 1 a 3 cajas y no hay un subconjunto de prueba independiente. Consulta Estructura del conjunto de datos para ver los detalles de los subconjuntos.El conjunto de datos Brain Tumor de Ultralytics contiene imágenes de resonancia magnética cerebral y no incluye tomografías computarizadas. Los tamaños de imagen van de 192x256 a 512x512 píxeles, y cada imagen está etiquetada con de 1 a 3 cajas delimitadoras
tumoren el formato YOLO de Ultralytics.No, el conjunto de datos Brain Tumor de Ultralytics no contiene imágenes sin tumores ni una clase negativa. Las 1.115 imágenes tienen de 1 a 3 cajas delimitadoras
tumor, por lo que un modelo entrenado con este conjunto aprende dónde está un tumor, no si una imagen es normal. Los modelos entrenados con este conjunto de datos están destinados a la investigación y la formación, no al diagnóstico clínico.El conjunto de datos Brain Tumor de Ultralytics se divide por paciente: las 121 imágenes de validación llevan los ID de 25 pacientes, y ningún paciente identificado aparece en ambos subconjuntos. Los pacientes se identifican mediante el prefijo de cinco dígitos del nombre del archivo, como
00097_77.jpg. El conjunto de entrenamiento contiene los otros 95 pacientes identificados y 541 imágenes cuyos nombres de archivo no tienen ID de paciente.El conjunto de datos Brain Tumor de Ultralytics (4,06 MB) se descarga automáticamente desde los recursos de Ultralytics en GitHub la primera vez que entrenas con
data="brain-tumor.yaml", así que no hace falta descargarlo manualmente. Si ya tienes guardada una copia anterior con 893 imágenes de entrenamiento, elimina su carpetabrain-tumory actualiza primero el paqueteultralyticspara que se descargue la versión actual con una sola clase. Para ver otro conjunto de datos pequeño de imágenes médicas, consulta el conjunto de datos de detección de pastillas médicas.Para entrenar YOLO26 con el conjunto de datos Brain Tumor de Ultralytics, pasa
data="brain-tumor.yaml"al comando de entrenamiento y el conjunto de datos se descargará automáticamente. Los ejemplos siguientes entrenan YOLO26n durante 100 épocas con un tamaño de imagen de 640:Ejemplo de entrenamientofrom ultralytics import YOLO # Cargar un modelo model = YOLO("yolo26n.pt") # Carga un modelo preentrenado (recomendado para el entrenamiento) # Entrenar el modelo results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)Para consultar una lista detallada de los argumentos disponibles, visita la página de entrenamiento.
Para ejecutar inferencias con un modelo YOLO26 ajustado con el conjunto de datos Brain Tumor de Ultralytics, carga tus pesos
best.pty llama a predict con una imagen de resonancia magnética cerebral. Cada resultado contiene las cajas delimitadorastumorcon sus puntuaciones de confianza:Ejemplo de inferenciafrom ultralytics import YOLO # Cargar un modelo model = YOLO("path/to/best.pt") # carga un modelo ajustado con brain-tumor # Inferencia con el modelo results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")El conjunto de datos Brain Tumor de Ultralytics fue creado por Ultralytics y se distribuye con la Licencia AGPL-3.0.


Comentarios11
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
ZoltinZyc
how can i download this datasett??
1 Paula DerrengerUltralytics(editado)
Hey there! 😊 The easiest way is to train with
data=brain-tumor.yaml, which downloads the dataset automatically the first time. To download it manually, use:wget https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zip unzip brain-tumor.zip -d path/to/destinationReplace
path/to/destinationwith the directory where you'd like the dataset stored. Once you have the dataset, you're all set to start training or inferencing with YOLO models on brain tumor images!Should you need further guidance, feel free to ask. Happy coding! 🚀
G-qingqian
Thank you for your reply. I noticed that in the original dataset, the images in the train folder do have ID prefixes, but the images in the val folder are all prefixed with val1_, making it impossible to distinguish which patient the data belongs to. Therefore, I cannot redivide the dataset. Could you please provide data with complete identifiers? ---- Replied Message ---- FromGlenn @.>Date1/18/2026 @.>@.>, @.>SubjectRe: [ultralytics/ultralytics] zh/datasets/detect/brain-tumor/ (Discussion #9988) The packaged brain-tumor dataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to *.txt image lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.
my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
— Reply to this email directly, view it on GitHub, or unsubscribe. You are receiving this because you commented.Message ID: @.***>
 Glenn JocherUltralytics
The packaged
brain-tumorzip only includes image-level labels with anonymized filenames (no patient IDs/metadata), so we can’t provide “complete identifiers” or guarantee a patient-disjoint re-split; for patient-wise splitting you’ll need to rebuild from a source that includes patient IDs (e.g., your DICOM/NIfTI originals) and then generatetrain.txt/val.txt, and if you just need stronger evaluation without IDs you can use our K-Fold Cross Validation guide—please keep follow-ups here in the GitHub discussion (we can’t provide support over email/DM).
Can your dataset ensure that the data are independently and identically distributed by patient? That is, there will be no data from the same patient in both the training set and the validation set.
- Glenn JocherUltralytics
The packaged
brain-tumordataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to*.txtimage lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.# my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
pizzas17
How could I download this dataset on COCO format or how could I convert it? (Since I wish to have an EDA on it
xySun17
How can i train the yoloV8 using this dataset without loading the pre-trained weights?
- Paula DerrengerUltralytics(editado)
@xySun17 hello!
To train YOLO26 without loading the pre-trained weights, you can initialize the model from scratch by specifying the model architecture file (e.g.,
yolo26n.yaml) instead of the pre-trained weights file. Here’s how you can do it:Python
from ultralytics import YOLO

# Load a model architecture without pre-trained weights
model = YOLO("yolo26n.yaml")  # build a new model from YAML

# Train the model
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)
CLI
# Train from scratch using the model architecture file
yolo detect train data=brain-tumor.yaml model=yolo26n.yaml epochs=100 imgsz=640
This approach ensures that the model starts training with random weights rather than pre-trained ones. If you encounter any issues, please ensure you are using the latest version of the Ultralytics package and provide a minimum reproducible example if the problem persists. You can find more details on creating a reproducible example here.
Feel free to reach out if you have any further questions. Happy training! 🚀
1 Thank you!! However, there is another problem, that is, why it says the path of dataset is not found? I already downloaded the dataset files and changed the path in "brain-tumor.yaml" file.
The threw error was follows: "Dataset 'brain-tumor.yaml' images not found ⚠️, missing path '/valid/images' Note dataset download directory is '/home/ros/datasets'. You can update this in '/home/ros/.config/Ultralytics/settings.yaml'"
- Paula DerrengerUltralytics(editado)
Hello @xySun17,
Thank you for reaching out! It looks like the issue might be related to the dataset path configuration in your
brain-tumor.yamlfile. Here are a few steps to troubleshoot and resolve this:-
Verify Dataset Path: Ensure that the paths specified in your
brain-tumor.yamlfile correctly point to the locations of your dataset images. For example:path: /home/ros/datasets/brain-tumor train: images/train val: images/val -
Check Directory Structure: Confirm that the directory structure matches what is specified in the YAML file. The
images/trainandimages/valdirectories should exist within/home/ros/datasets/brain-tumor. -
Update Configuration: If the dataset is located in a different directory, update the
pathin the YAML file accordingly. For instance, if your dataset is in/home/ros/my-datasets/brain-tumor, update thepathto:path: /home/ros/my-datasets/brain-tumor -
Reproducible Example: If the issue persists, providing a minimum reproducible example can greatly help in diagnosing the problem. You can find guidance on creating a reproducible example here.
-
Latest Version: Ensure you are using the latest version of the Ultralytics package. You can update it using:
pip install --upgrade ultralytics
Here’s an example of how your
brain-tumor.yamlshould look:# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license # Brain-tumor dataset by Ultralytics # Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor/ # Example usage: yolo train data=brain-tumor.yaml path: /home/ros/datasets/brain-tumor # dataset root dir train: images/train # train images (relative to 'path') val: images/val # val images (relative to 'path') # Classes names: 0: negative 1: positive # Download script/URL (optional) download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipIf you follow these steps and still encounter issues, please share more details or any error messages you receive. This will help us assist you better.
Best regards and happy coding! 🚀
-