Conjunto de datos Dog-Pose
Introducción#
El conjunto de datos Dog-Pose de Ultralytics es un conjunto de datos de estimación de poses seleccionado para estimar los puntos clave de perros, con 6,773 imágenes de entrenamiento y 1,703 de validación.
Ver: Cómo entrenar un modelo Ultralytics YOLO con el conjunto de datos de estimación de pose de perros de Stanford | Tutorial paso a paso
Cada imagen anotada incluye 24 puntos clave con 3 dimensiones por punto clave (x, y, visibilidad), lo que permite investigar y desarrollar aplicaciones de estimación de poses caninas.
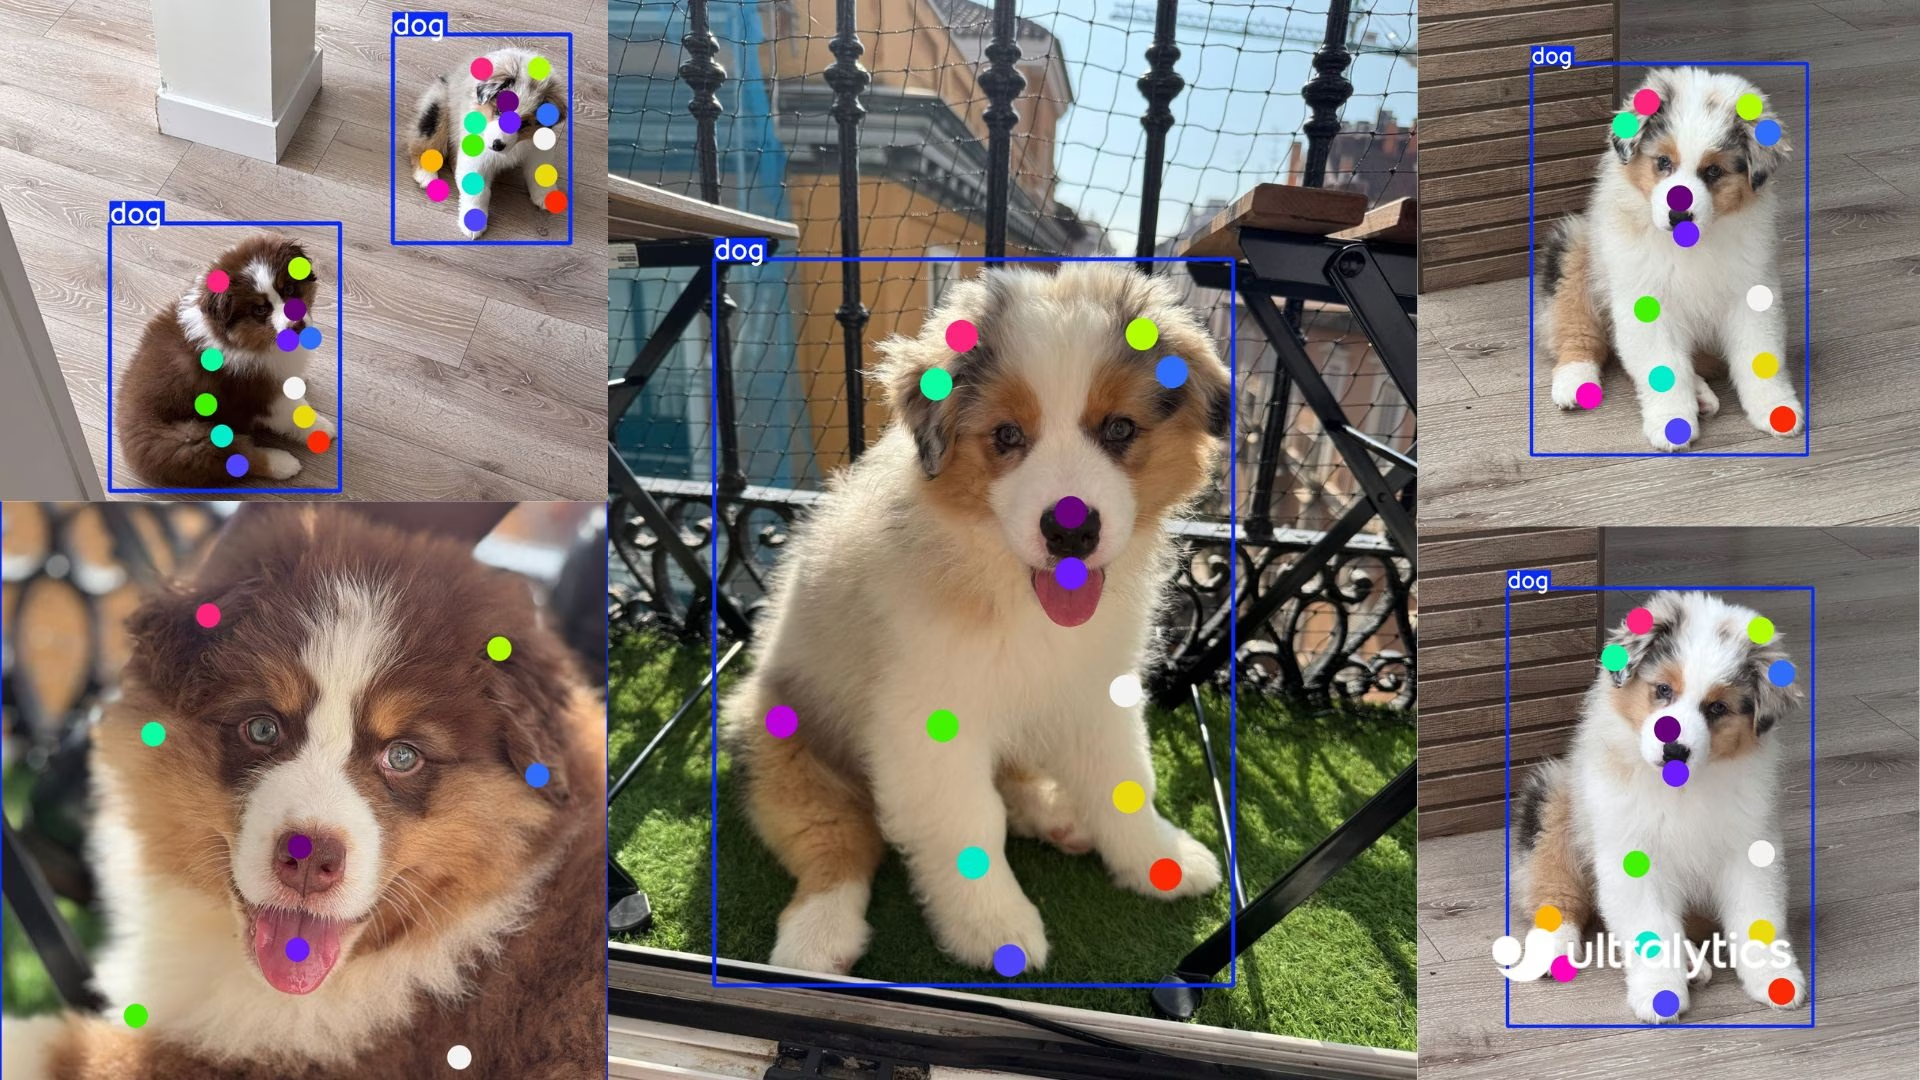
Si buscas una raza concreta u otro animal, Ultralytics Platform te permite subir datos propios, etiquetarlos y entrenar un modelo personalizado de puntos clave sin tener que gestionar la infraestructura.
Estructura del conjunto de datos#
-
Total de imágenes: 8.476 (6.773 de entrenamiento / 1.703 de validación), con los archivos de etiquetas correspondientes en formato YOLO.
-
Puntos clave: 24 por perro, en tripletas
(x, y, visibility). -
Tamaño de descarga: ~337 MB.
-
Estructura:
datasets/dog-pose/
├── images/{train,val}
└── labels/{train,val}
YAML del conjunto de datos#
Se utiliza un archivo YAML para definir la configuración del conjunto de datos. Incluye las rutas, los detalles de los puntos clave y otros datos relevantes. En el caso del conjunto de datos Dog-Pose, el archivo dog-pose.yaml está disponible en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Dogs dataset http://vision.stanford.edu/aditya86/ImageNetDogs/ by Stanford
# Documentation: https://docs.ultralytics.com/datasets/pose/dog-pose
# Example usage: yolo train data=dog-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dog-pose ← downloads here (337 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dog-pose # dataset root dir
train: images/train # train images (relative to 'path') 6773 images
val: images/val # val images (relative to 'path') 1703 images

# Keypoints
kpt_shape: [24, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)

# Classes
names:
  0: dog

# Keypoint names per class
kpt_names:
  0:
    - front_left_paw
    - front_left_knee
    - front_left_elbow
    - rear_left_paw
    - rear_left_knee
    - rear_left_elbow
    - front_right_paw
    - front_right_knee
    - front_right_elbow
    - rear_right_paw
    - rear_right_knee
    - rear_right_elbow
    - tail_start
    - tail_end
    - left_ear_base
    - right_ear_base
    - nose
    - chin
    - left_ear_tip
    - right_ear_tip
    - left_eye
    - right_eye
    - withers
    - throat

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dog-pose.zipUso#
Para entrenar un modelo YOLO26n-pose con el conjunto de datos Dog-Pose durante 100 épocas y con un tamaño de imagen de 640, puedes usar los siguientes fragmentos de código.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-pose.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="dog-pose.yaml", epochs=100, imgsz=640)
Imágenes de muestra y anotaciones#
Aquí tienes algunos ejemplos de imágenes del conjunto de datos Dog-Pose junto con sus anotaciones correspondientes:
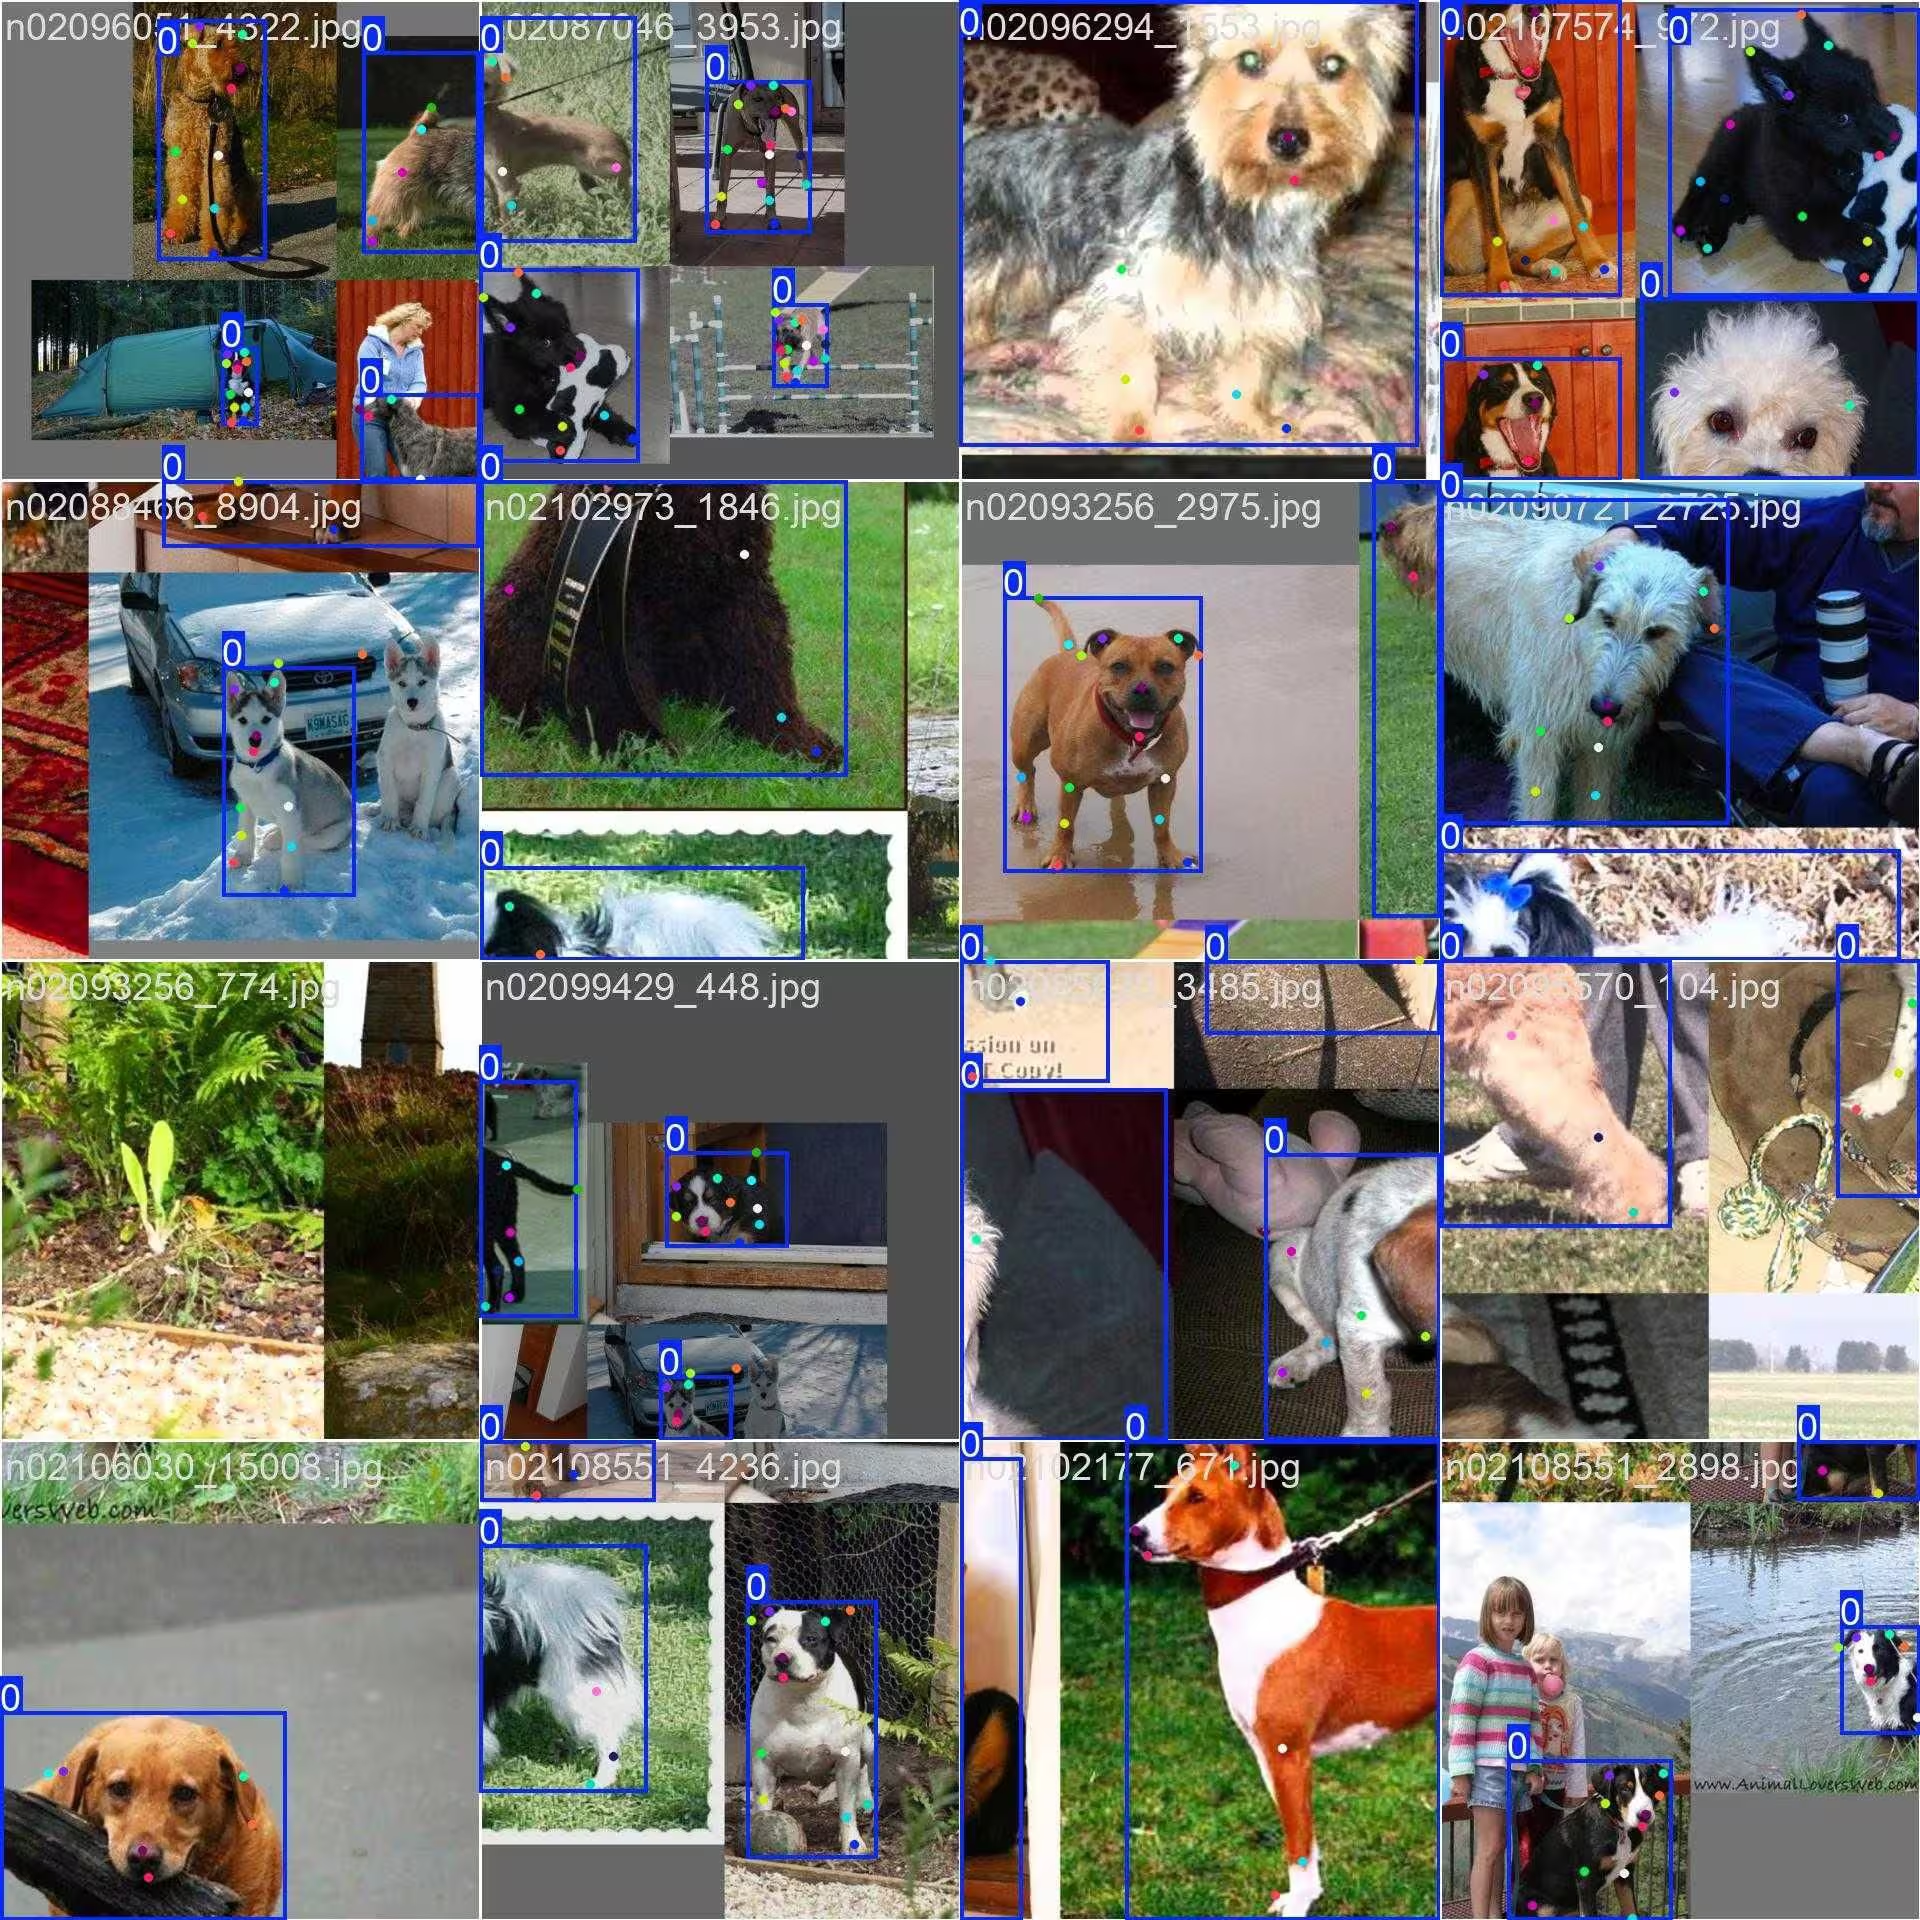
- Imagen en mosaico: Esta imagen muestra un lote de entrenamiento compuesto por imágenes del conjunto de datos dispuestas en mosaico. El mosaico es una técnica que se utiliza durante el entrenamiento para combinar varias imágenes en una sola y aumentar la variedad de objetos y escenas de cada lote de entrenamiento. Esto ayuda a mejorar la capacidad del modelo para generalizar a distintos tamaños de objetos, relaciones de aspecto y contextos.
El ejemplo muestra la variedad y complejidad de las imágenes del conjunto de datos Dog-Pose y las ventajas de usar mosaicos durante el entrenamiento.
Citas y agradecimientos#
Si utilizas el conjunto de datos Dog-Pose en tu investigación o trabajo de desarrollo, cita el siguiente artículo:
@inproceedings{khosla2011fgvc,
  title={Novel dataset for Fine-Grained Image Categorization},
  author={Aditya Khosla and Nityananda Jayadevaprakash and Bangpeng Yao and Li Fei-Fei},
  booktitle={First Workshop on Fine-Grained Visual Categorization (FGVC), IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
  year={2011}
}
@inproceedings{deng2009imagenet,
  title={ImageNet: A Large-Scale Hierarchical Image Database},
  author={Jia Deng and Wei Dong and Richard Socher and Li-Jia Li and Kai Li and Li Fei-Fei},
  booktitle={IEEE Computer Vision and Pattern Recognition (CVPR)},
  year={2009}
}
Queremos reconocer la labor del equipo de Stanford por crear y mantener este valioso recurso para la comunidad de visión artificial. Para obtener más información sobre el conjunto de datos Dog-Pose y sus creadores, visita el sitio web del conjunto de datos Stanford Dogs.
Preguntas frecuentes#
El conjunto de datos Dog-Pose contiene 6,773 imágenes de entrenamiento y 1,703 de validación, anotadas con 24 puntos clave para la estimación de poses de perros. Está diseñado para entrenar y validar modelos con Ultralytics YOLO26 y permite desarrollar aplicaciones como el análisis del comportamiento animal, la monitorización de mascotas y los estudios veterinarios. Sus anotaciones detalladas lo hacen idóneo para desarrollar modelos precisos de estimación de poses caninas.
Carga
yolo26n-pose.pty llama amodel.train(data="dog-pose.yaml", epochs=100, imgsz=640); consulta el ejemplo de entrenamiento anterior para ver los fragmentos completos de Python y CLI, y la página de entrenamiento del modelo para consultar una lista completa de argumentos.Con un total de 8.476 imágenes (6.773 de entrenamiento y 1.703 de validación) que abarcan una amplia variedad de razas y poses de perros, y 24 puntos clave en 3 dimensiones (x, y, visibilidad) por anotación, el conjunto de datos Dog-Pose ofrece a los modelos la cobertura de situaciones reales que necesitan aplicaciones como la monitorización de mascotas y el análisis del comportamiento.
La creación de mosaicos combina varias imágenes de Dog-Pose en una sola imagen de entrenamiento, lo que aumenta la variedad de poses, tamaños y fondos de perros que el modelo ve en cada paso. Esto mejora la generalización a nuevos contextos y escalas, a la vez que reduce el sobreajuste. Para ver imágenes de ejemplo, consulta la sección Imágenes de ejemplo y anotaciones.
El archivo YAML del conjunto de datos Dog-Pose se encuentra en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. Define la configuración del conjunto de datos, incluidas las rutas, las clases, los detalles de los puntos clave y otros datos relevantes. El YAML especifica 24 puntos clave con 3 dimensiones por punto, por lo que es adecuado para tareas detalladas de estimación de pose.
Para utilizar este archivo con los scripts de entrenamiento de YOLO26, inclúyelo en el comando de entrenamiento como se muestra en la sección Uso. El conjunto de datos se descargará automáticamente la primera vez que lo utilices, por lo que la configuración es sencilla.
Para obtener más información sobre los modelos de puntos clave, consulta la documentación de la tarea de estimación de pose.


Comentarios12
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
legend-zhen
Hello, although YOLOv11-pose can perform both object detection and pose estimation tasks simultaneously, there seems to be little correlation between the performance of pose estimation and object detection. What could be the reason for this? As I understand, YOLOv11-pose was specifically designed for human pose estimation, so can it also be perfectly adapted for animal pose estimation, as it is for humans? Are any special settings required when performing animal pose estimation?
 Glenn JocherUltralytics(editado)
@legend-zhen YOLO26 and YOLO11 pose models are indeed versatile and can be adapted for animal pose estimation, such as with the Dog-Pose dataset. While the architecture is optimized for human pose estimation, adapting it to animals typically requires a dataset with accurate annotations (e.g., 24 keypoints for dogs in Dog-Pose). No special settings are mandatory beyond ensuring the dataset YAML file is properly configured. For details on Dog-Pose, check here.
Peakednesss
I can just find 20 points, 4 for ears, 1 for nose, 1 for mouth, 2 for tail, and 12 for legs, where are the other four points?
- Glenn JocherUltralytics(editado)
@Peakednesss the Dog-Pose dataset has 24 keypoints. Beyond the 20 you found (ears, nose, chin, tail and legs), the other four are the left eye, right eye, withers and throat. The full list is in
kpt_namesin the dataset YAML: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. thank you very much
goodbetterbest1
do you know where are the other 4 points’ definitions? I can’t find any useful information in the yaml document. thx
chengziNaomi
When we annotate the key point data set in a picture, if the two boxes have overlapping parts, how to annotate the key points in the overlapping boxes?
- Glenn JocherUltralytics
@chengziNaomi when annotating overlapping bounding boxes in a keypoint dataset, ensure that each object's keypoints are labeled independently, even if they share overlapping regions. Annotate each keypoint based on its respective object, maintaining clear separation to avoid ambiguity during model training. For guidelines on keypoint annotation, refer to Dog-Pose Dataset Documentation.
If I have multiple objects in a picture, should I frame all the objects at once and then label the key points together, or should I frame an object, label the key points of that object, then frame an object, and then label the key points of that object?
- Glenn JocherUltralytics
@chengziNaomi when annotating a single image with multiple objects, you should annotate each object separately. Frame one object, label its keypoints completely, then move to the next object. This ensures clarity and avoids confusion during model training. Refer to Dog-Pose Dataset Documentation for more annotation insights.
Thank you very much! and how can I draw heatmap for key point detection?
- Glenn JocherUltralytics
You're welcome! To draw a heatmap for keypoint detection, you can preprocess the keypoints into Gaussian blobs on a blank image using libraries like OpenCV or NumPy, then overlay them on the original image. For detailed implementation, check external heatmap solutions or visualization tools as it currently falls outside YOLO's built-in features. Let me know if you have further questions!