Mantenimiento de tus modelos de visión por ordenador después de la implementación#
Supervisar y mantener un modelo de visión por ordenador significa realizar un seguimiento continuo de sus predicciones para detectar el desvío de datos y las caídas de precisión, volver a entrenarlo con datos recientes cuando el rendimiento se degrade y documentar cada cambio para que el trabajo siga siendo reproducible. Esta es la etapa final de un proyecto de visión por ordenador: después de haber recopilado los requisitos, anotado los datos, entrenado el modelo e implementado, es lo que permite que el modelo siga cumpliendo los objetivos de tu proyecto una vez que está funcionando en producción.
Watch: How to Maintain Computer Vision Models after Deployment | Data Drift Detection
En esta guía, veremos con más detalle cómo puedes mantener tus modelos de visión por ordenador después de la implementación. Exploraremos cómo la supervisión de modelos puede ayudarte a detectar problemas desde el principio, cómo mantener tu modelo preciso y actualizado, y por qué la documentación es importante para resolver problemas.
Supervisión de modelos#
Es fundamental vigilar de cerca tus modelos de visión por ordenador implementados. Sin una supervisión adecuada, los modelos pueden perder precisión. Un problema habitual es el cambio en la distribución de los datos o el desvío de datos, que se produce cuando los datos que encuentra el modelo cambian con respecto a aquellos con los que se entrenó. Cuando el modelo tiene que realizar predicciones sobre datos que no reconoce, puede generar interpretaciones incorrectas y un rendimiento deficiente. Los valores atípicos, es decir, puntos de datos inusuales, también pueden afectar a la precisión del modelo.
La supervisión periódica de modelos ayuda a los desarrolladores a realizar un seguimiento del rendimiento del modelo, detectar anomalías y solucionar rápidamente problemas como el desvío de datos. También ayuda a gestionar los recursos, ya que indica cuándo son necesarias las actualizaciones, evita costosas revisiones completas y mantiene la relevancia del modelo.
Prácticas recomendadas para la supervisión de modelos#
Estas son algunas prácticas recomendadas que debes tener en cuenta al supervisar tu modelo de visión por ordenador en producción:
- Realiza un seguimiento periódico del rendimiento: Supervisa continuamente el rendimiento del modelo para detectar cambios a lo largo del tiempo.
- Comprueba dos veces la calidad de los datos: Comprueba si faltan valores o si hay anomalías en los datos.
- Utiliza fuentes de datos diversas: Supervisa datos procedentes de varias fuentes para obtener una visión completa del rendimiento del modelo.
- Combina técnicas de supervisión: Utiliza una combinación de algoritmos de detección de desvíos y enfoques basados en reglas para identificar una amplia variedad de problemas.
- Supervisa las entradas y las salidas: Vigila tanto los datos que procesa el modelo como los resultados que produce para asegurarte de que todo funciona correctamente.
- Configura alertas: Implementa alertas para comportamientos inusuales, como caídas de rendimiento, para poder aplicar medidas correctivas rápidamente.
Supervisión con Ultralytics Platform#
Ultralytics Platform proporciona supervisión de modelos integrada para endpoints de YOLO implementados, de modo que puedes vigilar tu modelo en producción sin crear una pila de supervisión independiente. El panel Deploy realiza un seguimiento en tiempo real de señales clave:
- Métricas de solicitudes: Volumen total de solicitudes, tasa de errores y latencia P95 de cada endpoint, con tendencias en sparklines para periodos de entre 1 hora y 30 días.
- Comprobaciones de estado: Sondeo automático del estado de los endpoints que marca las implementaciones que no funcionan correctamente e informa de la latencia de respuesta.
- Registros: Registros de solicitudes filtrados por gravedad (de DEBUG a CRITICAL) para diagnosticar solicitudes fallidas y picos de latencia.
- Vista global: Un mapa mundial interactivo y tarjetas de resumen que muestran todos los despliegues de distintas regiones en una sola vista.
Como la supervisión se ofrece mediante URL de endpoints estándar y una comprobación /health, también puedes integrar estas señales en tu configuración de observabilidad actual cuando necesites un análisis más profundo. Para obtener información sobre la configuración, consulta la guía de supervisión de despliegues.
Detección de anomalías y sistemas de alertas#
Una anomalía es cualquier punto o patrón de datos que se desvía considerablemente de lo esperado. En el caso de los modelos de visión por ordenador, las anomalías pueden ser imágenes muy diferentes de aquellas con las que se entrenó el modelo. Estas imágenes inesperadas pueden indicar problemas como cambios en la distribución de los datos, valores atípicos o comportamientos que podrían reducir el rendimiento del modelo. Configurar sistemas de alertas para detectar estas anomalías es una parte importante de la supervisión de modelos.
Al establecer niveles de rendimiento y límites estándar para las métricas clave, puedes detectar los problemas desde el principio. Cuando el rendimiento supera estos límites, se activan alertas que impulsan una solución rápida. Actualizar y volver a entrenar periódicamente los modelos con datos nuevos permite que sigan siendo relevantes y precisos a medida que cambian los datos.
Configuración de umbrales y alertas#
Al configurar tus sistemas de alertas, ten en cuenta estas prácticas recomendadas:
- Alertas estandarizadas: Utiliza herramientas y formatos coherentes para todas las alertas, como el correo electrónico o aplicaciones de mensajería como Slack. La estandarización facilita que entiendas y respondas rápidamente a las alertas.
- Incluye el comportamiento esperado: Los mensajes de alerta deben indicar claramente qué ha fallado, qué se esperaba y el periodo de tiempo evaluado. Esto te ayuda a valorar la urgencia y el contexto de la alerta.
- Alertas configurables: Haz que las alertas sean fáciles de configurar para adaptarlas a las condiciones cambiantes. Permite editar los umbrales, posponer, desactivar o confirmar las alertas.
Detección del desvío de datos#
La detección del desvío de datos es un concepto que ayuda a identificar cuándo cambian con el tiempo las propiedades estadísticas de los datos de entrada, lo que puede degradar el rendimiento del modelo. Esta técnica ayuda a detectar que existe un problema antes de decidir si debes volver a entrenar o ajustar tus modelos. El desvío de datos aborda los cambios en el panorama general de los datos a lo largo del tiempo, mientras que la detección de anomalías se centra en identificar puntos de datos poco frecuentes o inesperados que pueden requerir atención inmediata.
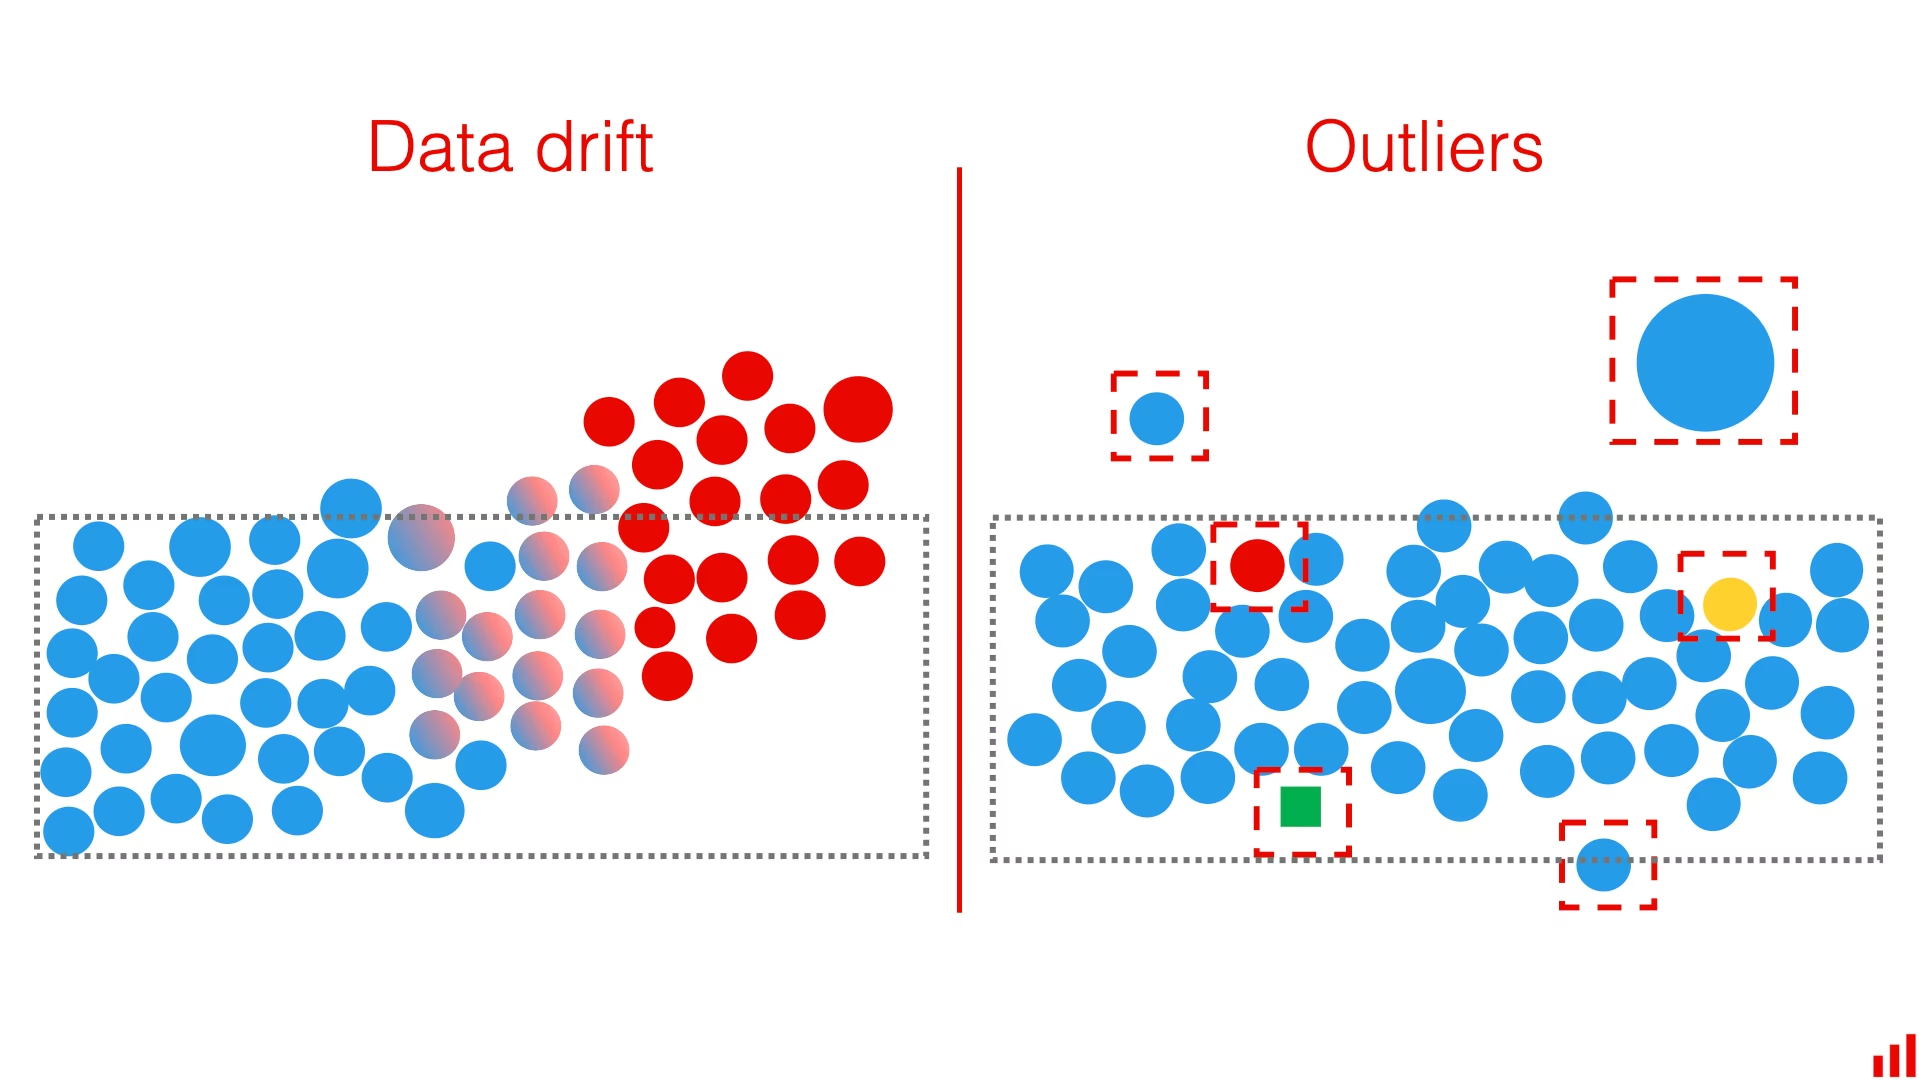
Estos son varios métodos para detectar el desvío de datos:
- Supervisión continua: Supervisa periódicamente los datos de entrada y las salidas del modelo para detectar indicios de desvío. Realiza un seguimiento de las métricas clave y compáralas con datos históricos para identificar cambios importantes.
- Técnicas estadísticas: Utiliza métodos como la prueba de Kolmogorov-Smirnov o el índice de estabilidad de la población (PSI) para detectar cambios en las distribuciones de los datos. Estas pruebas comparan la distribución de los datos nuevos con los datos de entrenamiento para identificar diferencias importantes.
- Desvío de características: Supervisa individualmente las características para detectar desvíos. A veces, la distribución general de los datos puede permanecer estable, mientras que algunas características se desvían. Identificar qué características se están desviando ayuda a ajustar el proceso de reentrenamiento.
Mantenimiento de modelos#
El mantenimiento de modelos mantiene la precisión y la relevancia de los modelos de visión por ordenador a lo largo del tiempo mediante su actualización y reentrenamiento periódicos, la gestión del desvío de datos y la adaptación a los cambios en los datos y los entornos. Es el complemento de la supervisión: la supervisión observa el rendimiento del modelo en tiempo real para detectar los problemas desde el principio, mientras que el mantenimiento consiste en solucionar esos problemas.
Actualizaciones y reentrenamiento periódicos#
Una vez implementado un modelo, es posible que, mientras lo supervisas, observes cambios en los patrones de los datos o en el rendimiento que indiquen un desvío del modelo. Las actualizaciones y el reentrenamiento periódicos se convierten en partes esenciales del mantenimiento del modelo para garantizar que pueda gestionar nuevos patrones y situaciones. Puedes utilizar varias técnicas en función de cómo cambien tus datos.
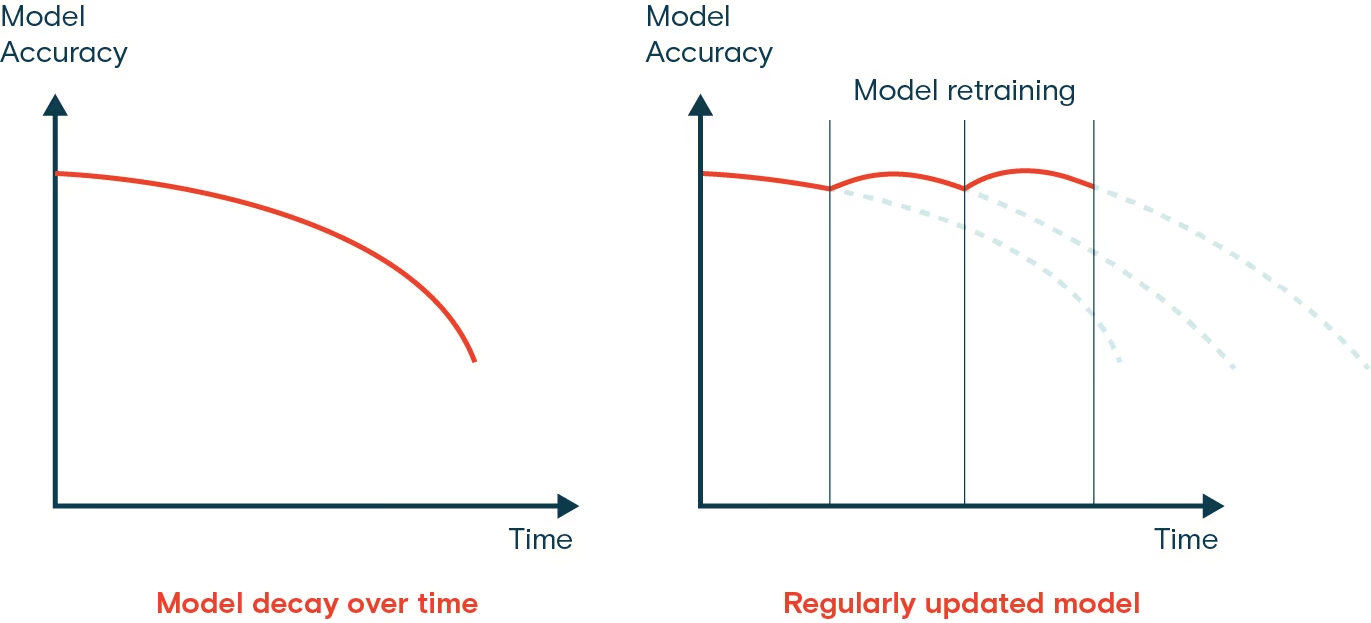
Por ejemplo, si los datos cambian gradualmente con el tiempo, el aprendizaje incremental es un buen enfoque. El aprendizaje incremental consiste en actualizar el modelo con datos nuevos sin volver a entrenarlo por completo desde cero, lo que ahorra recursos computacionales y tiempo. Sin embargo, si los datos han cambiado drásticamente, puede ser mejor realizar un reentrenamiento completo periódico para asegurarte de que el modelo no sobreajuste los datos nuevos mientras pierde de vista los patrones anteriores.
Independientemente del método, la validación y las pruebas son imprescindibles después de las actualizaciones. Es importante validar el modelo con un conjunto de datos de prueba independiente para comprobar si el rendimiento ha mejorado o empeorado.
Cómo decidir cuándo volver a entrenar tu modelo#
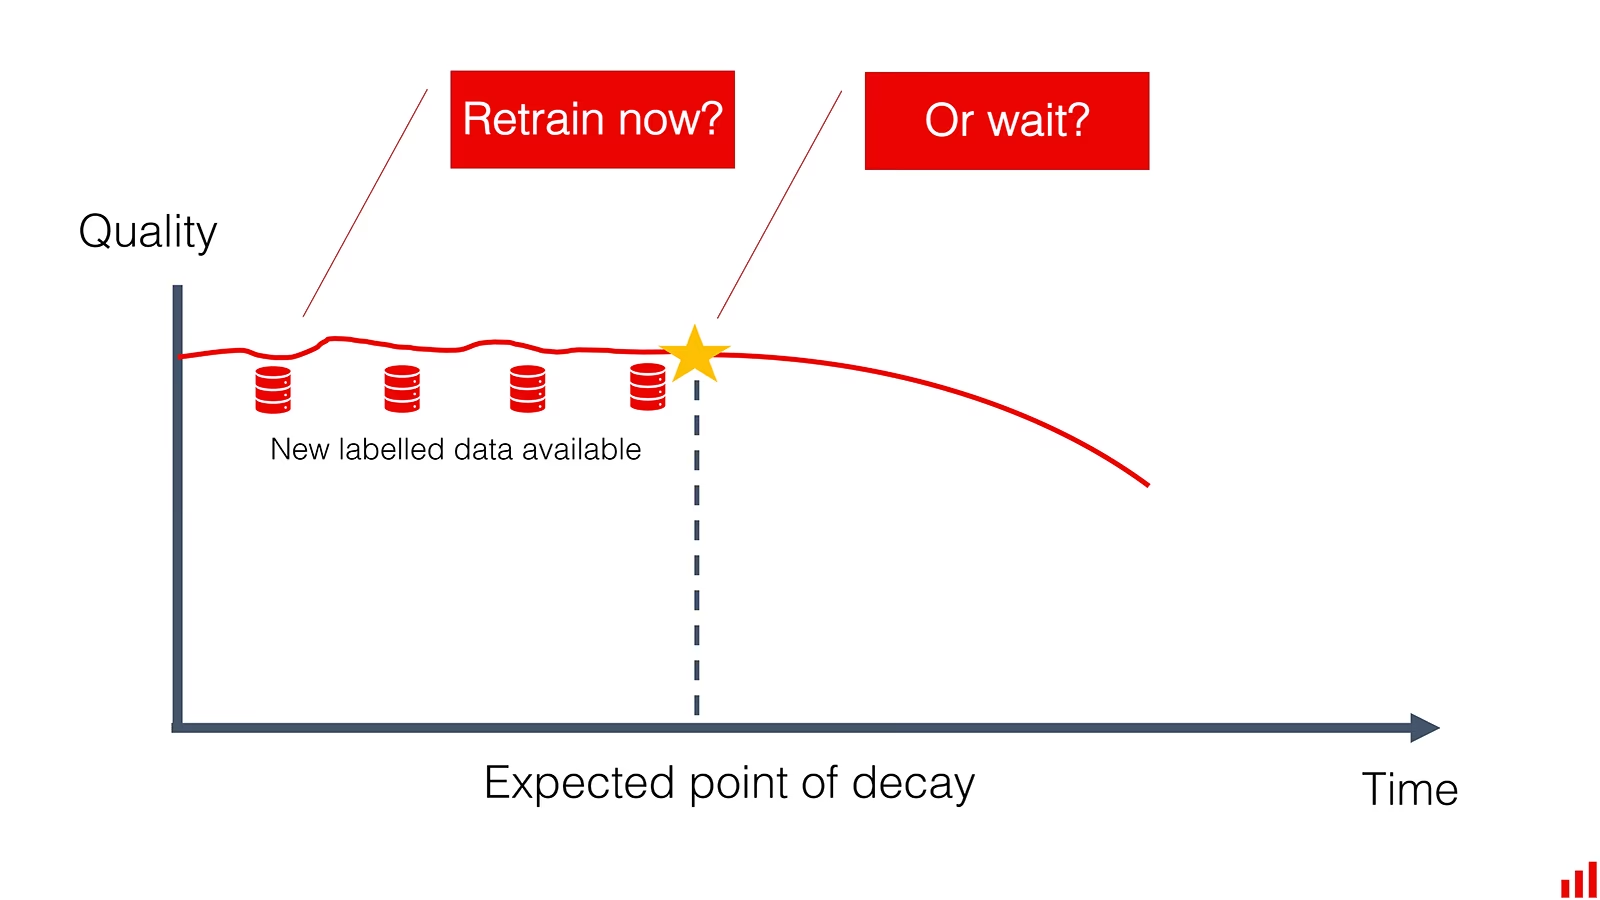
La frecuencia con la que debes volver a entrenar tu modelo de visión por ordenador depende de los cambios en los datos y del rendimiento del modelo. Vuelve a entrenar tu modelo siempre que observes una caída significativa del rendimiento o detectes un desvío de datos. Las evaluaciones periódicas pueden ayudarte a determinar el calendario de reentrenamiento adecuado probando el modelo con datos nuevos. Supervisar las métricas de rendimiento y los patrones de los datos te permite decidir si tu modelo necesita actualizaciones más frecuentes para mantener la precisión.
Documentación#
Documentar un proyecto de visión por ordenador facilita su comprensión, reproducción y desarrollo colaborativo. Una buena documentación abarca la arquitectura del modelo, los hiperparámetros, los conjuntos de datos, las métricas de evaluación y mucho más. Proporciona transparencia y ayuda a los miembros del equipo y a las partes interesadas a entender qué se ha hecho y por qué. La documentación también facilita la resolución de problemas, el mantenimiento y las futuras mejoras al ofrecer una referencia clara de las decisiones y los métodos utilizados anteriormente.
Elementos clave que debes documentar#
Estos son algunos de los elementos clave que deben incluirse en la documentación del proyecto:
- Descripción general del proyecto: Proporciona un resumen general del proyecto, incluida la definición del problema, el enfoque de la solución, los resultados esperados y el alcance del proyecto. Explica el papel de la visión por ordenador a la hora de abordar el problema y describe sus etapas y entregables.
- Arquitectura del modelo: Detalla la estructura y el diseño del modelo, incluidos sus componentes, capas y conexiones. Explica los hiperparámetros elegidos y el razonamiento que sustenta estas decisiones.
- Preparación de los datos: Describe las fuentes, los tipos, los formatos y los tamaños de los datos, así como los pasos de preprocesamiento. Trata la calidad y fiabilidad de los datos y cualquier transformación aplicada antes de entrenar el modelo.
- Proceso de entrenamiento: Documenta el procedimiento de entrenamiento, incluidos los conjuntos de datos utilizados, los parámetros de entrenamiento y las funciones de pérdida. Explica cómo se entrenó el modelo y cualquier dificultad encontrada durante el entrenamiento.
- Métricas de evaluación: Especifica las métricas utilizadas para evaluar el rendimiento del modelo, como la precisión, la precisión positiva, la exhaustividad y la puntuación F1. Incluye los resultados del rendimiento y un análisis de estas métricas.
- Pasos de implementación: Describe los pasos seguidos para implementar el modelo, incluidas las herramientas y plataformas utilizadas, las configuraciones de implementación y cualquier dificultad o consideración específica.
- Procedimiento de supervisión y mantenimiento: Proporciona un plan detallado para supervisar el rendimiento del modelo después de la implementación. Incluye métodos para detectar y abordar el desvío de datos y del modelo, y describe el proceso de actualización y reentrenamiento periódicos.
Conclusión#
Supervisar, mantener y documentar tu modelo es lo que permite que un proyecto de visión por ordenador siga teniendo éxito mucho después de su implementación: la supervisión continua detecta los problemas desde el principio, el reentrenamiento periódico adapta el modelo a los datos nuevos y al desvío, y una documentación clara facilita cada actualización futura. Trátalo como un ciclo continuo y vuelve a revisar las etapas de tu proyecto de visión por ordenador a medida que evolucionen tus datos y requisitos.
Preguntas frecuentes#
Para supervisar un modelo de visión por ordenador implementado, realiza un seguimiento en producción del volumen de solicitudes, la tasa de errores y la latencia, mientras vigilas las anomalías y el desvío de datos que indican una disminución de la precisión. El panel Deploy de Ultralytics Platform cubre de forma integrada las métricas de producción, con métricas en tiempo real, comprobaciones de estado automáticas y registros filtrados por gravedad. Supervisa periódicamente las entradas y salidas, configura alertas para comportamientos inusuales y utiliza fuentes de datos diversas para obtener una visión completa del rendimiento de tu modelo. Para obtener más información, consulta nuestra sección sobre supervisión de modelos.
Mantener modelos de visión por ordenador implica actualizarlos, volver a entrenarlos y supervisarlos periódicamente para garantizar que sigan siendo precisos y relevantes. Entre las prácticas recomendadas se incluyen:
- Supervisión continua: Realiza un seguimiento periódico de las métricas de rendimiento y de la calidad de los datos.
- Detección del desvío de datos: Utiliza técnicas estadísticas para identificar cambios en las distribuciones de los datos.
- Actualizaciones y reentrenamiento periódicos: Implementa aprendizaje incremental o un reentrenamiento completo periódico en función de los cambios en los datos.
- Documentación: Mantén una documentación detallada de la arquitectura del modelo, los procesos de entrenamiento y las métricas de evaluación. Para obtener más información, visita nuestra sección sobre mantenimiento de modelos.
La detección del desvío de datos es esencial porque ayuda a identificar cuándo cambian con el tiempo las propiedades estadísticas de los datos de entrada, lo que puede degradar el rendimiento del modelo. Técnicas como la supervisión continua, las pruebas estadísticas (por ejemplo, la prueba de Kolmogorov-Smirnov) y el análisis del desvío de características pueden ayudar a detectar los problemas desde el principio. Abordar el desvío de datos garantiza que tu modelo siga siendo preciso y relevante en entornos cambiantes. Obtén más información sobre la detección del desvío de datos en nuestra sección Detección del desvío de datos.
Para detectar anomalías en modelos de visión por ordenador, establece niveles de rendimiento estándar para las métricas clave y activa alertas siempre que los valores queden fuera de esos límites. Ultralytics Platform lo permite mediante métricas de tasa de errores y latencia en tiempo real, comprobaciones de estado automáticas y registros filtrados por gravedad que muestran rápidamente los comportamientos inusuales. Las alertas configurables y los mensajes estandarizados te ayudan a responder rápidamente a posibles problemas. Descubre más en nuestra sección Detección de anomalías y sistemas de alertas.
La documentación eficaz de un proyecto de visión por ordenador debe incluir:
- Descripción general del proyecto: Resumen general, definición del problema y enfoque de la solución.
- Arquitectura del modelo: Detalles de la estructura, los componentes y los hiperparámetros del modelo.
- Preparación de los datos: Información sobre las fuentes de datos, los pasos de preprocesamiento y las transformaciones.
- Proceso de entrenamiento: Descripción del procedimiento de entrenamiento, los conjuntos de datos utilizados y las dificultades encontradas.
- Métricas de evaluación: Métricas utilizadas para la evaluación y el análisis del rendimiento.
- Pasos de implementación: Pasos seguidos para la implementación del modelo y cualquier dificultad específica.
- Procedimiento de supervisión y mantenimiento: Plan para la supervisión y el mantenimiento continuos. Para obtener directrices más completas, consulta nuestra sección de documentación.