Optimización de la inferencia de YOLO con OpenVINO#
Introducción#
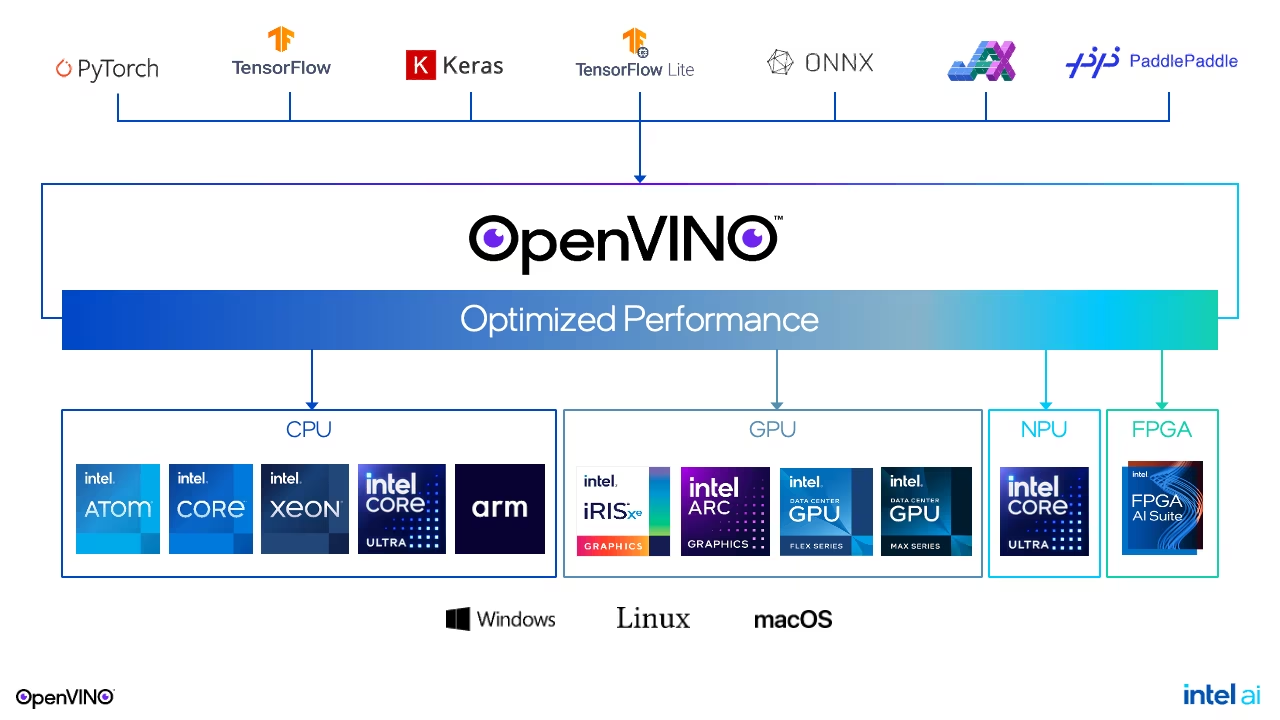
Al implementar modelos de aprendizaje profundo, en particular los destinados a la detección de objetos, como los modelos Ultralytics YOLO, es fundamental conseguir un rendimiento óptimo. En esta guía se explica cómo aprovechar el kit de herramientas OpenVINO de Intel para optimizar la inferencia, centrándose en la latencia y el rendimiento. Tanto si trabajas en aplicaciones para el consumidor como en implementaciones a gran escala, comprender y aplicar estas estrategias de optimización garantizará que tus modelos se ejecuten de forma eficiente en distintos dispositivos.
Optimización de la latencia#
La optimización de la latencia es esencial en las aplicaciones que requieren una respuesta inmediata de un único modelo ante una única entrada, algo habitual en escenarios de consumo. El objetivo es reducir al mínimo el tiempo entre la entrada y el resultado de la inferencia. Sin embargo, conseguir una latencia baja requiere tener en cuenta varios factores, sobre todo al ejecutar inferencias simultáneas o gestionar varios modelos.
Estrategias clave para optimizar la latencia#
- Una inferencia por dispositivo: La forma más sencilla de conseguir una latencia baja es limitar cada dispositivo a una sola inferencia a la vez. La concurrencia adicional suele aumentar la latencia.
- Aprovecha los subdispositivos: Los dispositivos, como las CPU con varios sockets o las GPU con varios mosaicos, pueden ejecutar varias solicitudes con un aumento mínimo de la latencia al aprovechar sus subdispositivos internos.
- Sugerencias de rendimiento de OpenVINO: Utilizar
ov::LATENCYpara la propiedadov::performance_modedurante la compilación del modelo simplifica el ajuste del rendimiento y ofrece un método independiente del dispositivo y preparado para el futuro.
Gestión de la latencia de la primera inferencia#
- Caché de modelos: Para evitar que los tiempos de carga y compilación del modelo afecten a la latencia, utiliza la caché de modelos siempre que sea posible. Si no puedes usarla, las CPU suelen ofrecer los tiempos de carga de modelos más rápidos.
- Asignación de modelos frente a lectura: Para reducir los tiempos de carga, OpenVINO sustituyó la lectura de modelos por su asignación en memoria. Sin embargo, si el modelo está en una unidad extraíble o de red, plantéate usar
ov::enable_mmap(false)para volver a la lectura. - Selección automática del dispositivo: Este modo inicia la inferencia en la CPU y la traslada a un acelerador cuando está listo, lo que reduce sin interrupciones la latencia de la primera inferencia.
Optimización del rendimiento#
La optimización del rendimiento es fundamental en escenarios que atienden simultáneamente numerosas solicitudes de inferencia y maximizan la utilización de recursos sin sacrificar significativamente el rendimiento de cada solicitud.
Métodos para optimizar el rendimiento#
-
Sugerencias de rendimiento de OpenVINO: Un método de alto nivel y preparado para el futuro que mejora el rendimiento en distintos dispositivos mediante sugerencias de rendimiento.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Procesamiento por lotes explícito y flujos: Un método más detallado que emplea el procesamiento por lotes explícito y flujos para ajustar el rendimiento de forma avanzada.
Diseño de aplicaciones orientadas al rendimiento#
Para maximizar el rendimiento, las aplicaciones deben:
- Procesar las entradas en paralelo y aprovechar al máximo las capacidades del dispositivo.
- Descomponer el flujo de datos en solicitudes de inferencia simultáneas, programadas para ejecutarse en paralelo.
- Utilizar la API asíncrona con funciones de retorno de llamada para mantener la eficiencia y evitar que el dispositivo se quede sin trabajo.
Ejecución en varios dispositivos#
El modo multidispositivo de OpenVINO simplifica la ampliación del rendimiento al distribuir automáticamente las solicitudes de inferencia entre los dispositivos, sin necesidad de gestionar los dispositivos desde la aplicación.
Mejoras de rendimiento en condiciones reales#
La aplicación de optimizaciones de OpenVINO a los modelos Ultralytics YOLO puede mejorar considerablemente el rendimiento. Como muestran las pruebas de rendimiento, puedes obtener velocidades de inferencia hasta 3 veces mayores en CPU Intel, con aceleraciones aún mayores en toda la gama de hardware de Intel, incluidas las GPU integradas, las GPU dedicadas y las NPU.
Por ejemplo, al ejecutar modelos YOLO26 en CPU Intel Xeon, las versiones optimizadas con OpenVINO superan sistemáticamente a sus equivalentes de PyTorch en tiempo de inferencia por imagen, sin comprometer la precisión.
Implementación práctica#
Para exportar y optimizar tu modelo Ultralytics YOLO para OpenVINO, puedes utilizar la función de exportación:
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato OpenVINO
model.export(format="openvino", quantize=16)  # Exporta con precisión FP16
Tras exportar el modelo, puedes ejecutar inferencias con la versión optimizada:
# Carga el modelo OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")

# Ejecuta la inferencia (Ultralytics compila los modelos OpenVINO con la sugerencia de rendimiento LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)Conclusión#
Optimizar los modelos Ultralytics YOLO para reducir la latencia y mejorar el rendimiento con OpenVINO puede mejorar considerablemente el funcionamiento de tu aplicación. Si aplican con cuidado las estrategias descritas en esta guía, los desarrolladores pueden conseguir que sus modelos se ejecuten de forma eficiente y satisfagan las exigencias de distintos escenarios de implementación. Recuerda que la elección entre optimizar la latencia o el rendimiento depende de las necesidades concretas de tu aplicación y de las características del entorno de implementación.
Para obtener información técnica más detallada y conocer las últimas novedades, consulta la documentación de OpenVINO y el repositorio de Ultralytics YOLO. Estos recursos ofrecen guías detalladas, tutoriales y ayuda de la comunidad para que aproveches al máximo tus modelos de aprendizaje profundo.
Conseguir un rendimiento óptimo para tus modelos no consiste solo en retocar la configuración: también exige comprender las necesidades de tu aplicación y tomar decisiones fundamentadas. Tanto si optimizas las respuestas en tiempo real como si maximizas el rendimiento para procesar datos a gran escala, la combinación de los modelos Ultralytics YOLO y OpenVINO ofrece a los desarrolladores un potente conjunto de herramientas para implementar soluciones de IA de alto rendimiento.
Preguntas frecuentes#
La optimización de los modelos Ultralytics YOLO para reducir la latencia implica varias estrategias clave:
- Una inferencia por dispositivo: Limita las inferencias a una cada vez por dispositivo para minimizar las demoras.
- Aprovecha los subdispositivos: Utiliza dispositivos como las CPU con varios sockets o las GPU con varios mosaicos, capaces de gestionar varias solicitudes con un aumento mínimo de la latencia.
- Sugerencias de rendimiento de OpenVINO: Utiliza
ov::LATENCYde OpenVINO durante la compilación del modelo para simplificar el ajuste independiente del dispositivo.
Para obtener más consejos prácticos sobre cómo optimizar la latencia, consulta la sección sobre optimización de la latencia de nuestra guía.
OpenVINO mejora el rendimiento de los modelos Ultralytics YOLO al maximizar la utilización de los recursos del dispositivo sin sacrificar el rendimiento. Entre sus principales ventajas se incluyen:
- Sugerencias de rendimiento: Ajuste del rendimiento sencillo y de alto nivel en distintos dispositivos.
- Procesamiento por lotes explícito y flujos: Ajuste preciso para mejorar el rendimiento de forma avanzada.
- Ejecución en varios dispositivos: Equilibrio automático de la carga de inferencia que simplifica la gestión desde la aplicación.
Ejemplo de configuración:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Descubre más sobre la optimización del rendimiento en la sección sobre optimización del rendimiento de nuestra guía detallada.
Para reducir la latencia de la primera inferencia, ten en cuenta estas prácticas:
- Caché de modelos: Utiliza la caché de modelos para reducir los tiempos de carga y compilación.
- Asignación de modelos frente a lectura: Utiliza la asignación (
ov::enable_mmap(true)) de forma predeterminada, pero cambia a la lectura (ov::enable_mmap(false)) si el modelo está en una unidad extraíble o de red. - Selección automática del dispositivo: Utiliza el modo AUTO para iniciar la inferencia en la CPU y pasar a un acelerador sin interrupciones.
Para consultar estrategias detalladas sobre la gestión de la latencia de la primera inferencia, visita la sección sobre gestión de la latencia de la primera inferencia.
Para equilibrar la optimización de la latencia y el rendimiento, debes comprender las necesidades de tu aplicación:
- Optimización de la latencia: Ideal para aplicaciones en tiempo real que requieren respuestas inmediatas (p. ej., aplicaciones para el consumidor).
- Optimización del rendimiento: Idónea para escenarios con muchas inferencias simultáneas que maximizan el uso de recursos (p. ej., implementaciones a gran escala).
Las sugerencias de rendimiento de alto nivel y los modos multidispositivo de OpenVINO pueden ayudarte a encontrar el equilibrio adecuado. Elige las sugerencias de rendimiento de OpenVINO que mejor se adapten a tus requisitos.
Sí, los modelos Ultralytics YOLO son muy versátiles y se pueden integrar con distintos marcos de IA. Algunas opciones son:
- TensorRT: Para optimizar en GPU NVIDIA, sigue la guía de integración de TensorRT.
- CoreML: Para dispositivos Apple, consulta nuestras instrucciones de exportación a CoreML.
- LiteRT.js: Para aplicaciones web y de Node.js, consulta la guía de integración de LiteRT y el entorno de ejecución web de LiteRT.js.
Descubre más integraciones en la página de integraciones de Ultralytics.