Implementa un modelo YOLO preentrenado con Ultralytics en Vertex AI para realizar inferencias#
Esta guía te mostrará cómo contenerizar un modelo YOLO26 preentrenado con Ultralytics, crear un servidor de inferencia FastAPI y desplegar el modelo con el servidor de inferencia en Google Cloud Vertex AI. La implementación de ejemplo cubrirá el caso de uso de detección de objetos de YOLO26, pero los mismos principios se aplicarán a otras tareas de YOLO.
Antes de empezar, tendrás que crear un proyecto de Google Cloud Platform (GCP). Como usuario nuevo, recibirás 300 $ en créditos de GCP para usar gratis, una cantidad suficiente para probar una configuración en funcionamiento que más adelante podrás ampliar para cualquier otro caso de uso de YOLO26, incluido el entrenamiento y la inferencia por lotes y en streaming.
Qué aprenderás#
- Crear un backend de inferencia para un modelo Ultralytics YOLO26 con FastAPI.
- Crear un repositorio de GCP Artifact Registry para almacenar tu imagen de Docker.
- Crear y subir la imagen de Docker con el modelo a Artifact Registry.
- Importar tu modelo en Vertex AI.
- Crear un endpoint de Vertex AI y desplegar el modelo.
- Control total del modelo con Ultralytics: puedes usar una lógica de inferencia personalizada y controlar por completo el preprocesamiento, el posprocesamiento y el formato de las respuestas.
- Vertex AI se encarga del resto: escala automáticamente y, a la vez, te permite configurar con flexibilidad los recursos de computación, la memoria y las GPU.
- Integraciones nativas y seguridad de GCP: configuración sencilla con Cloud Storage, BigQuery, Cloud Functions, controles de VPC, políticas de IAM y registros de auditoría.
Requisitos previos#
- Instala Docker en tu equipo.
- Instala el Google Cloud SDK y autentícate para usar la CLI de gcloud.
- Te recomendamos encarecidamente que consultes la guía de inicio rápido de Docker para Ultralytics, porque tendrás que ampliar una de las imágenes oficiales de Docker de Ultralytics siguiendo esta guía.
1. Crear un backend de inferencia con FastAPI#
Primero, tendrás que crear una aplicación FastAPI que gestione las solicitudes de inferencia del modelo YOLO26. Esta aplicación se encargará de cargar el modelo, preprocesar las imágenes y ejecutar la lógica de inferencia (predicción).
Fundamentos de cumplimiento de Vertex AI#
Vertex AI espera que tu contenedor implemente dos endpoints específicos:
-
Endpoint Health (
/health): debe devolver el estado HTTP200 OKcuando el servicio esté listo. -
Endpoint Predict (
/predict): acepta solicitudes de predicción estructuradas con imágenes codificadas en base64 y parámetros opcionales. Se aplican límites de tamaño de la carga útil según el tipo de endpoint.Las cargas útiles de las solicitudes al endpoint
/predictdeben seguir esta estructura JSON:{ "instances": [{ "image": "base64_encoded_image" }], "parameters": { "confidence": 0.5 } }
Estructura de carpetas del proyecto#
La mayor parte de la compilación se realizará dentro del contenedor de Docker, y Ultralytics también cargará un modelo YOLO26 preentrenado, así que puedes mantener sencilla la estructura de carpetas local:
YOUR_PROJECT/
├── src/
│   ├── __init__.py
│   ├── app.py              # Core YOLO26 inference logic
│   └── main.py             # FastAPI inference server
├── tests/
├── .env                    # Environment variables for local development
├── Dockerfile              # Container configuration
├── LICENSE                 # AGPL-3.0 License
└── pyproject.toml # Python dependencies and project configLos modelos Ultralytics YOLO26 y el framework se distribuyen bajo la licencia AGPL-3.0, que conlleva importantes requisitos de cumplimiento. Asegúrate de leer la documentación de Ultralytics sobre cómo cumplir las condiciones de la licencia.
Crea pyproject.toml con las dependencias#
Para gestionar tu proyecto cómodamente, crea un archivo pyproject.toml con las siguientes dependencias:
[project]
name = "YOUR_PROJECT_NAME"
version = "0.0.1"
description = "YOUR_PROJECT_DESCRIPTION"
requires-python = ">=3.10,<3.13"
dependencies = [
   "ultralytics>=8.4.0",
   "fastapi[all]>=0.89.1",
   "uvicorn[standard]>=0.20.0",
   "pillow>=9.0.0",
   "loguru",
]

[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"uvicornse usará para ejecutar el servidor FastAPI.loguruse usará para registrar eventos en el servidor FastAPI.pillowse usará para procesar imágenes, pero no estás limitado a las imágenes PIL: Ultralytics admite muchos otros formatos.
Crea la lógica de inferencia con Ultralytics YOLO26#
Ahora que ya tienes configuradas la estructura del proyecto y las dependencias, puedes implementar la lógica principal de inferencia de YOLO26. Crea un archivo src/app.py que se encargue de cargar el modelo, procesar las imágenes y realizar predicciones mediante la API de Python de Ultralytics.
# src/app.py

from ultralytics import YOLO

# Model initialization and readiness state
model_yolo = None
_model_ready = False

def _initialize_model():
    """Initialize the YOLO model."""
    global model_yolo, _model_ready

    try:
        # Use pretrained YOLO26n model from Ultralytics base image
        model_yolo = YOLO("yolo26n.pt")
        _model_ready = True

    except Exception as e:
        print(f"Error initializing YOLO model: {e}")
        _model_ready = False
        model_yolo = None

# Initialize model on module import
_initialize_model()

def is_model_ready() -> bool:
    """Check if the model is ready for inference."""
    return _model_ready and model_yolo is not None
Esto cargará el modelo una sola vez cuando se inicie el contenedor, y el modelo se compartirá entre todas las solicitudes. Si el modelo va a gestionar una carga de inferencia elevada, te recomendamos elegir un tipo de máquina con más memoria al importar el modelo en Vertex AI en un paso posterior.
A continuación, crea dos funciones auxiliares para procesar las imágenes de entrada y salida con pillow. YOLO26 admite imágenes PIL de forma nativa.
def get_image_from_bytes(binary_image: bytes) -> Image.Image:
    """Convert image from bytes to PIL RGB format."""
    input_image = Image.open(io.BytesIO(binary_image)).convert("RGB")
    return input_image
def get_bytes_from_image(image: Image.Image) -> bytes:
"""Convert PIL image to bytes."""
return_image = io.BytesIO()
image.save(return_image, format="JPEG", quality=85)
return_image.seek(0)
return return_image.getvalue()Por último, implementa la función run_inference que se encargará de la detección de objetos. En este ejemplo, extraeremos los cuadros delimitadores, los nombres de las clases y las puntuaciones de confianza de las predicciones del modelo. La función devolverá un diccionario con las detecciones y los resultados sin procesar para su posterior procesamiento o anotación.
def run_inference(input_image: Image.Image, confidence_threshold: float = 0.5) -> Dict[str, Any]:
    """Run inference on an image using YOLO26n model."""
    # Check if model is ready
    if not is_model_ready():
        print("Model not ready for inference")
        return {"detections": [], "results": None}

    try:
        # Make predictions and get raw results
        results = model_yolo.predict(
            imgsz=640, source=input_image, conf=confidence_threshold, save=False, augment=False, verbose=False
        )

        # Extract detections (bounding boxes, class names, and confidences)
        detections = []
        if results and len(results) > 0:
            result = results[0]
            if result.boxes is not None and len(result.boxes.xyxy) > 0:
                boxes = result.boxes

                # Convert tensors to numpy for processing
                xyxy = boxes.xyxy.cpu().numpy()
                conf = boxes.conf.cpu().numpy()
                cls = boxes.cls.cpu().numpy().astype(int)

                # Create detection dictionaries
                for i in range(len(xyxy)):
                    detection = {
                        "xmin": float(xyxy[i][0]),
                        "ymin": float(xyxy[i][1]),
                        "xmax": float(xyxy[i][2]),
                        "ymax": float(xyxy[i][3]),
                        "confidence": float(conf[i]),
                        "class": int(cls[i]),
                        "name": model_yolo.names.get(int(cls[i]), f"class_{int(cls[i])}"),
                    }
                    detections.append(detection)

        return {
            "detections": detections,
            "results": results,  # Keep raw results for annotation
        }
    except Exception as e:
        # If there's an error, return empty structure
        print(f"Error in YOLO detection: {e}")
        return {"detections": [], "results": None}
Si quieres, puedes añadir una función para anotar la imagen con cuadros delimitadores y etiquetas mediante el método de trazado integrado de Ultralytics. Te resultará útil si quieres devolver imágenes anotadas en la respuesta de predicción.
def get_annotated_image(results: list) -> Image.Image:
    """Get annotated image using Ultralytics built-in plot method."""
    if not results or len(results) == 0:
        raise ValueError("No results provided for annotation")

    result = results[0]
    # Usa el método de trazado integrado de Ultralytics con salida PIL
    return result.plot(pil=True)
Crea un servidor de inferencia HTTP con FastAPI#
Ahora que tienes la lógica principal de inferencia de YOLO26, puedes crear una aplicación FastAPI para ofrecerla. Incluirá los endpoints de comprobación del estado y de predicción que requiere Vertex AI.
Primero, crea src/main.py, añade las importaciones, crea la aplicación FastAPI y configura el registro de eventos para Vertex AI. Como Vertex AI trata stderr como salida de error, es conveniente redirigir los registros a stdout.
# src/main.py

import sys

from fastapi import FastAPI
from loguru import logger

app = FastAPI()

# Configura el registrador
logger.remove()
logger.add(
    sys.stdout,
    colorize=True,
    format="<green>{time:HH:mm:ss}</green> | <level>{message}</level>",
    level=10,
)
logger.add("log.log", rotation="1 MB", level="DEBUG", compression="zip")
Para cumplir todos los requisitos de Vertex AI, define los endpoints necesarios en variables de entorno y establece el límite de tamaño de las solicitudes. Te recomendamos usar endpoints privados de Vertex AI en los despliegues de producción. Así tendrás un límite mayor para las cargas útiles de las solicitudes (10 MB en lugar de 1,5 MB para los endpoints públicos), además de una seguridad y un control de acceso sólidos.
# Variables de entorno de Vertex AI
AIP_HTTP_PORT = int(os.getenv("AIP_HTTP_PORT", "8080"))
AIP_HEALTH_ROUTE = os.getenv("AIP_HEALTH_ROUTE", "/health")
AIP_PREDICT_ROUTE = os.getenv("AIP_PREDICT_ROUTE", "/predict")

# Límite de tamaño de las solicitudes (10 MB para endpoints privados, 1,5 MB para públicos)
MAX_REQUEST_SIZE = 10 * 1024 * 1024  # 10 MB en bytes
Añade dos modelos Pydantic para validar tus solicitudes y respuestas:
# Modelos Pydantic para solicitud/respuesta
class PredictionRequest(BaseModel):
    instances: list
    parameters: Optional[Dict[str, Any]] = None

class PredictionResponse(BaseModel):
    predictions: list
Añade el endpoint de comprobación del estado para verificar que el modelo está listo. Esto es importante para Vertex AI: sin una comprobación del estado específica, su orquestador enviará solicitudes a sockets aleatorios y no podrá determinar si el modelo está listo para realizar inferencias. La comprobación debe devolver 200 OK si todo va bien y 503 Service Unavailable si hay un error:
# Endpoint de comprobación del estado
@app.get(AIP_HEALTH_ROUTE, status_code=status.HTTP_200_OK)
def health_check():
    """Health check endpoint for Vertex AI."""
    if not is_model_ready():
        raise HTTPException(status_code=503, detail="Model not ready")
    return {"status": "healthy"}
Ahora ya tienes todo lo necesario para implementar el endpoint de predicción que gestionará las solicitudes de inferencia. Aceptará un archivo de imagen, ejecutará la inferencia y devolverá los resultados. Ten en cuenta que la imagen debe estar codificada en base64, lo que aumenta el tamaño de la carga útil hasta un 33 %.
@app.post(AIP_PREDICT_ROUTE, response_model=PredictionResponse)
async def predict(request: PredictionRequest):
    """Prediction endpoint for Vertex AI."""
    try:
        predictions = []

        for instance in request.instances:
            if isinstance(instance, dict):
                if "image" in instance:
                    image_data = base64.b64decode(instance["image"])
                    input_image = get_image_from_bytes(image_data)
                else:
                    raise HTTPException(status_code=400, detail="Instance must contain 'image' field")
            else:
                raise HTTPException(status_code=400, detail="Invalid instance format")

            # Extract YOLO26 parameters if provided
            parameters = request.parameters or {}
            confidence_threshold = parameters.get("confidence", 0.5)
            return_annotated_image = parameters.get("return_annotated_image", False)

            # Run inference with YOLO26n model
            result = run_inference(input_image, confidence_threshold=confidence_threshold)
            detections_list = result["detections"]

            # Format predictions for Vertex AI
            detections = []
            for detection in detections_list:
                formatted_detection = {
                    "class": detection["name"],
                    "confidence": detection["confidence"],
                    "bbox": {
                        "xmin": detection["xmin"],
                        "ymin": detection["ymin"],
                        "xmax": detection["xmax"],
                        "ymax": detection["ymax"],
                    },
                }
                detections.append(formatted_detection)

            # Build prediction response
            prediction = {"detections": detections, "detection_count": len(detections)}

            # Add annotated image if requested and detections exist
            if (
                return_annotated_image
                and result["results"]
                and result["results"][0].boxes is not None
                and len(result["results"][0].boxes) > 0
            ):
                annotated_image = get_annotated_image(result["results"])
                img_bytes = get_bytes_from_image(annotated_image)
                prediction["annotated_image"] = base64.b64encode(img_bytes).decode("utf-8")

            predictions.append(prediction)

        logger.info(
            f"Processed {len(request.instances)} instances, found {sum(len(p['detections']) for p in predictions)} total detections"
        )

        return PredictionResponse(predictions=predictions)

    except HTTPException:
        # Re-raise HTTPException as-is (don't catch and convert to 500)
        raise
    except Exception as e:
        logger.error(f"Prediction error: {e}")
        raise HTTPException(status_code=500, detail=f"Prediction failed: {e}")
Por último, añade el punto de entrada de la aplicación para ejecutar el servidor FastAPI.
if __name__ == "__main__":
    import uvicorn

    logger.info(f"Starting server on port {AIP_HTTP_PORT}")
    logger.info(f"Health check route: {AIP_HEALTH_ROUTE}")
    logger.info(f"Predict route: {AIP_PREDICT_ROUTE}")
    uvicorn.run(app, host="0.0.0.0", port=AIP_HTTP_PORT)
Ya tienes una aplicación FastAPI completa que puede gestionar solicitudes de inferencia de YOLO26. Puedes probarla localmente instalando las dependencias y ejecutando el servidor, por ejemplo, con uv.
# Install dependencies
uv pip install -e .

# Run the FastAPI server directly
uv run src/main.py
Para probar el servidor, puedes consultar los endpoints /health y /predict con cURL. Coloca una imagen de prueba en la carpeta tests. Después, ejecuta los siguientes comandos en el Terminal:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
Deberías recibir una respuesta JSON con los objetos detectados. La primera solicitud puede tardar un poco, ya que Ultralytics tiene que descargar y cargar el modelo YOLO26.
2. Amplía la imagen de Docker de Ultralytics con tu aplicación#
Ultralytics ofrece varias imágenes de Docker que puedes usar como base para la imagen de tu aplicación. Incluyen Ultralytics y las bibliotecas CUDA necesarias, así que solo tienes que añadir tu aplicación encima.
Para aprovechar todas las capacidades de los modelos Ultralytics YOLO, te recomendamos elegir la imagen optimizada para CUDA y realizar inferencias con GPU. Sin embargo, si la inferencia con CPU es suficiente para tu tarea, también puedes ahorrar recursos de computación eligiendo la imagen que solo usa CPU:
- Dockerfile: imagen optimizada para CUDA para entrenar y realizar inferencias con YOLO26 en una o varias GPU.
- Dockerfile-cpu: imagen solo para CPU para realizar inferencias con YOLO26.
Crea una imagen de Docker para tu aplicación#
Crea un archivo Dockerfile en la raíz del proyecto con el siguiente contenido:
# Extends official Ultralytics Docker image for YOLO26
FROM ultralytics/ultralytics:latest

ENV PYTHONUNBUFFERED=1

# Install FastAPI and dependencies
RUN uv pip install --system fastapi[all] uvicorn[standard] loguru

WORKDIR /app
COPY src/ ./src/
COPY pyproject.toml ./

# Install the application package
RUN uv pip install --system -e .

RUN mkdir -p /app/logs
ENV PYTHONPATH=/app/src

# Port for Vertex AI
EXPOSE 8080

# Start the inference server
ENTRYPOINT ["python", "src/main.py"]
En el ejemplo se usa como base la imagen oficial de Docker de Ultralytics ultralytics:latest. Ya incluye el modelo YOLO26 y todas las dependencias necesarias. El punto de entrada del servidor es el mismo que usamos para probar la aplicación FastAPI localmente.
Compila y prueba la imagen de Docker#
Ahora puedes crear la imagen de Docker con el siguiente comando:
docker build --platform linux/amd64 -t IMAGE_NAME:IMAGE_VERSION .Sustituye IMAGE_NAME y IMAGE_VERSION por los valores que quieras, por ejemplo, yolo26-fastapi:0.1. Ten en cuenta que debes crear la imagen para la arquitectura linux/amd64 si vas a desplegarla en Vertex AI. El parámetro --platform debe establecerse explícitamente si estás creando la imagen en un Mac con Apple Silicon o en cualquier otra arquitectura que no sea x86.
Cuando termine la creación de la imagen, puedes probarla localmente:
docker run --platform linux/amd64 -p 8080:8080 IMAGE_NAME:IMAGE_VERSIONTu contenedor de Docker ya está ejecutando un servidor FastAPI en el puerto 8080, listo para aceptar solicitudes de inferencia. Puedes probar los endpoints /health y /predict con los mismos comandos cURL de antes:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
3. Sube la imagen de Docker a GCP Artifact Registry#
Para importar tu modelo en contenedor a Vertex AI, tendrás que subir la imagen de Docker a Google Cloud Artifact Registry. Si aún no tienes un repositorio de Artifact Registry, primero tendrás que crear uno.
Crea un repositorio en Google Cloud Artifact Registry#
Abre la página de Artifact Registry en Google Cloud Console. Si es la primera vez que usas Artifact Registry, puede que se te pida activar primero la API de Artifact Registry.

- Selecciona «Crear repositorio».
- Introduce el nombre del repositorio. Selecciona la región que quieras y mantén la configuración predeterminada para las demás opciones, salvo que necesites cambiarlas.
La selección de la región puede afectar a la disponibilidad de máquinas y a ciertos límites de computación para los usuarios que no sean de Enterprise. Encontrarás más información en la documentación oficial de Vertex AI: cuotas y límites de Vertex AI
- Cuando hayas creado el repositorio, guarda el PROJECT_ID, la ubicación (región) y el nombre del repositorio en tu almacén de secretos o en el archivo
.env. Los necesitarás más adelante para etiquetar y subir tu imagen de Docker a Artifact Registry.
Autentica Docker en Artifact Registry#
Autentica tu cliente de Docker en el repositorio de Artifact Registry que acabas de crear. Ejecuta el siguiente comando en el terminal:
gcloud auth configure-docker YOUR_REGION-docker.pkg.devEtiqueta y sube tu imagen a Artifact Registry#
Etiqueta y sube la imagen de Docker a Google Artifact Registry.
Te recomendamos usar etiquetas únicas cada vez que actualices la imagen. La mayoría de los servicios de GCP, incluido Vertex AI, se basan en las etiquetas de las imágenes para automatizar el control de versiones y el escalado, por lo que es buena práctica usar versiones semánticas o etiquetas basadas en fechas.
Etiqueta tu imagen con la URL del repositorio de Artifact Registry. Sustituye los marcadores de posición por los valores que guardaste antes.
docker tag IMAGE_NAME:IMAGE_VERSION YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONSube la imagen etiquetada al repositorio de Artifact Registry.
docker push YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONEspera a que termine el proceso. Ahora deberías ver la imagen en tu repositorio de Artifact Registry.
Para obtener instrucciones más específicas sobre cómo trabajar con imágenes en Artifact Registry, consulta la documentación de Artifact Registry: Subir y descargar imágenes.
4. Importa tu modelo en Vertex AI#
Con la imagen de Docker que acabas de subir, ya puedes importar el modelo en Vertex AI.
-
En el menú de navegación de Google Cloud, ve a Vertex AI > Model Registry. También puedes buscar «Vertex AI» en la barra de búsqueda de la parte superior de Google Cloud Console.

-
Haz clic en Importar.
-
Selecciona Importar como un modelo nuevo.
-
Selecciona la región. Puedes elegir la misma región que tu repositorio de Artifact Registry, pero tu elección debe depender de la disponibilidad de tipos de máquina y cuotas en tu región.
-
Selecciona Importar un contenedor de modelo existente.

-
En el campo Imagen del contenedor, busca el repositorio de Artifact Registry que has creado antes y selecciona la imagen que acabas de enviar.
-
Desplázate hasta la sección Variables de entorno e introduce los endpoints de predicción y estado, así como el puerto que has definido en tu aplicación FastAPI.

-
Haz clic en Importar. Vertex AI tardará varios minutos en registrar el modelo y prepararlo para la implementación. Recibirás una notificación por correo electrónico cuando se complete la importación.
5. Crea un endpoint de Vertex AI e implementa tu modelo#
En la terminología de Vertex AI, los endpoints son los modelos implementados, ya que representan los endpoints HTTP a los que envías solicitudes de inferencia, mientras que los modelos son los artefactos de ML entrenados que se almacenan en Model Registry.
Para implementar un modelo, debes crear un endpoint en Vertex AI.
-
En el menú de navegación de Vertex AI, ve a Endpoints. Selecciona la región que utilizaste al importar el modelo. Haz clic en Create.

-
Introduce el nombre del endpoint.
-
En Acceso, Vertex AI recomienda utilizar endpoints privados de Vertex AI. Además de las ventajas de seguridad, obtendrás un límite de carga útil más alto si seleccionas un endpoint privado; sin embargo, tendrás que configurar la red VPC y las reglas del cortafuegos para permitir el acceso al endpoint. Consulta la documentación de Vertex AI para obtener más instrucciones sobre los endpoints privados.
-
Haz clic en Continuar.
-
En el cuadro de diálogo Configuración del modelo, selecciona el modelo que has importado antes. Ahora puedes configurar el tipo de máquina, la memoria y los ajustes de GPU del modelo. Si prevés una carga de inferencia elevada, asigna memoria suficiente para evitar cuellos de botella de E/S y garantizar un rendimiento adecuado de YOLO26.
-
En Tipo de acelerador, selecciona el tipo de GPU que quieres utilizar para la inferencia. Si no tienes claro qué GPU elegir, puedes empezar con NVIDIA T4, compatible con CUDA.
Recuerda que algunas regiones tienen cuotas de computación muy limitadas, por lo que quizá no puedas seleccionar determinados tipos de máquina o GPU en tu región. Si esto es fundamental, cambia la región de implementación por otra con una cuota mayor. Encontrarás más información en la documentación oficial de Vertex AI: Cuotas y límites de Vertex AI.
- Cuando hayas seleccionado el tipo de máquina, puedes hacer clic en Continue. En este punto, puedes habilitar la supervisión de modelos en Vertex AI, un servicio adicional que hará un seguimiento del rendimiento de tu modelo y te ofrecerá información sobre su comportamiento. Es opcional y conlleva costes adicionales, así que elige según tus necesidades. Haz clic en Create.
Vertex AI tardará varios minutos (hasta 30 minutos en algunas regiones) en implementar el modelo. Recibirás una notificación por correo electrónico cuando termine la implementación.
6. Prueba el modelo implementado#
Cuando termine la implementación, Vertex AI te proporcionará una interfaz de API de ejemplo para probar el modelo.
Para probar la inferencia remota, puedes utilizar el comando cURL proporcionado o crear otra biblioteca cliente de Python que envíe solicitudes al modelo implementado. Recuerda que debes codificar la imagen en base64 antes de enviarla al endpoint /predict.
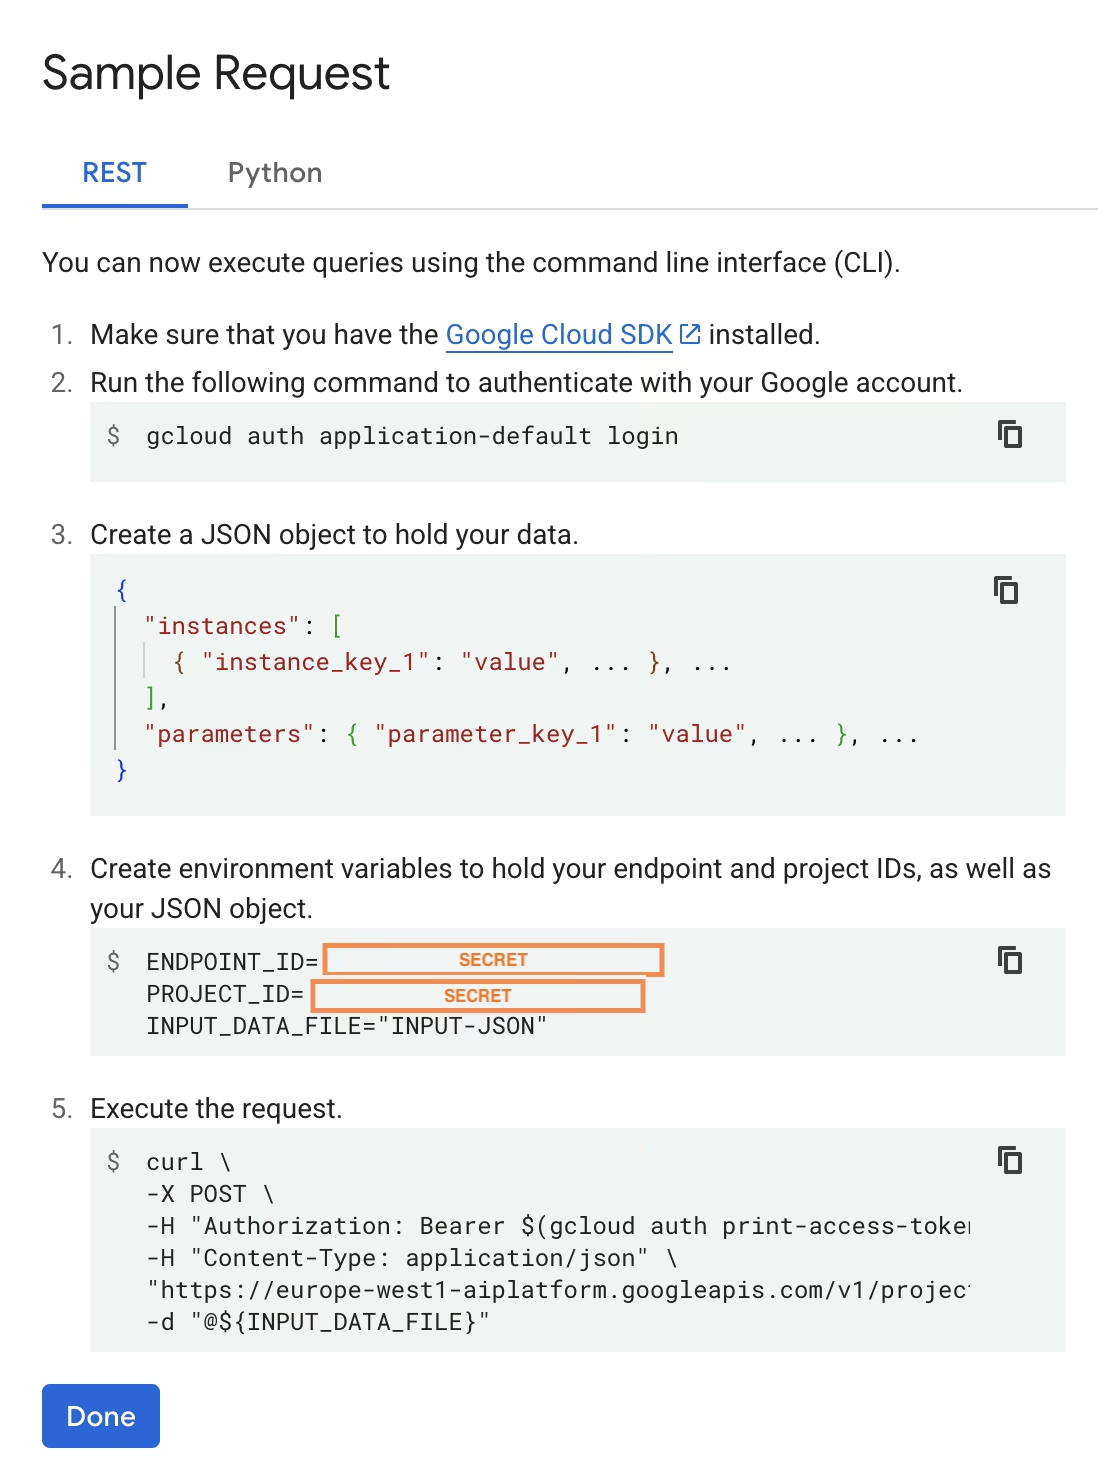
Al igual que en las pruebas locales, espera un breve retraso en la primera solicitud, ya que Ultralytics tendrá que descargar y cargar el modelo YOLO26 en el contenedor en ejecución.
Has implementado correctamente un modelo YOLO26 preentrenado con Ultralytics en Google Cloud Vertex AI.
Preguntas frecuentes#
Sí; sin embargo, primero tendrás que exportar el modelo a un formato compatible con Vertex AI, como TensorFlow, Scikit-learn o XGBoost. Google Cloud ofrece una guía para ejecutar modelos
.pten Vertex, con una descripción completa del proceso de conversión: Ejecutar modelos PyTorch en Vertex AI.Ten en cuenta que la configuración resultante dependerá únicamente de la capa de servicio estándar de Vertex AI y no admitirá las funciones avanzadas del framework Ultralytics. Como Vertex AI admite por completo los modelos en contenedores y puede escalarlos automáticamente según la configuración de implementación, te permite aprovechar todas las capacidades de los modelos Ultralytics YOLO sin tener que convertirlos a otro formato.
FastAPI ofrece un alto rendimiento para las cargas de trabajo de inferencia. La compatibilidad con operaciones asíncronas permite gestionar varias solicitudes simultáneas sin bloquear el hilo principal, algo importante al servir modelos de visión artificial.
La validación automática de solicitudes y respuestas de FastAPI reduce los errores en tiempo de ejecución en los servicios de inferencia de producción. Esto es especialmente útil para las API de detección de objetos, en las que es fundamental que el formato de entrada sea coherente.
FastAPI añade una sobrecarga computacional mínima a tu canal de inferencia, lo que deja más recursos disponibles para ejecutar el modelo y procesar imágenes.
FastAPI también admite SSE (eventos enviados por el servidor), una función útil para los casos de inferencia en streaming.
En realidad, esta es una característica de flexibilidad de Google Cloud Platform: debes seleccionar una región para cada servicio que utilices. Para implementar un modelo en contenedor en Vertex AI, la selección de región más importante es la de Model Registry. Esta determinará la disponibilidad de tipos de máquina y las cuotas para implementar el modelo.
Además, si amplías la configuración y almacenas datos o resultados de predicción en Cloud Storage o BigQuery, tendrás que utilizar la misma región que para Model Registry para minimizar la latencia y garantizar un alto rendimiento en el acceso a los datos.