YOLOv7: conjunto de técnicas gratuitas entrenables
YOLOv7, lanzado en julio de 2022, supuso un avance significativo en la detección de objetos en tiempo real en el momento de su lanzamiento. Alcanzó un 56,8 % de AP, la mayor precisión entre los detectores en tiempo real que funcionaban a 30 FPS o más en una GPU V100 cuando se presentó. YOLOv7 superó a detectores de objetos contemporáneos como YOLOR, YOLOX, Scaled-YOLOv4 y YOLOv5 en velocidad y precisión. El modelo se entrena desde cero con el conjunto de datos MS COCO, sin usar otros conjuntos de datos ni pesos preentrenados. El código fuente de YOLOv7 está disponible en GitHub. Ten en cuenta que desde entonces modelos más recientes como YOLO26 y YOLO11 han alcanzado una precisión superior y una eficiencia mejorada.
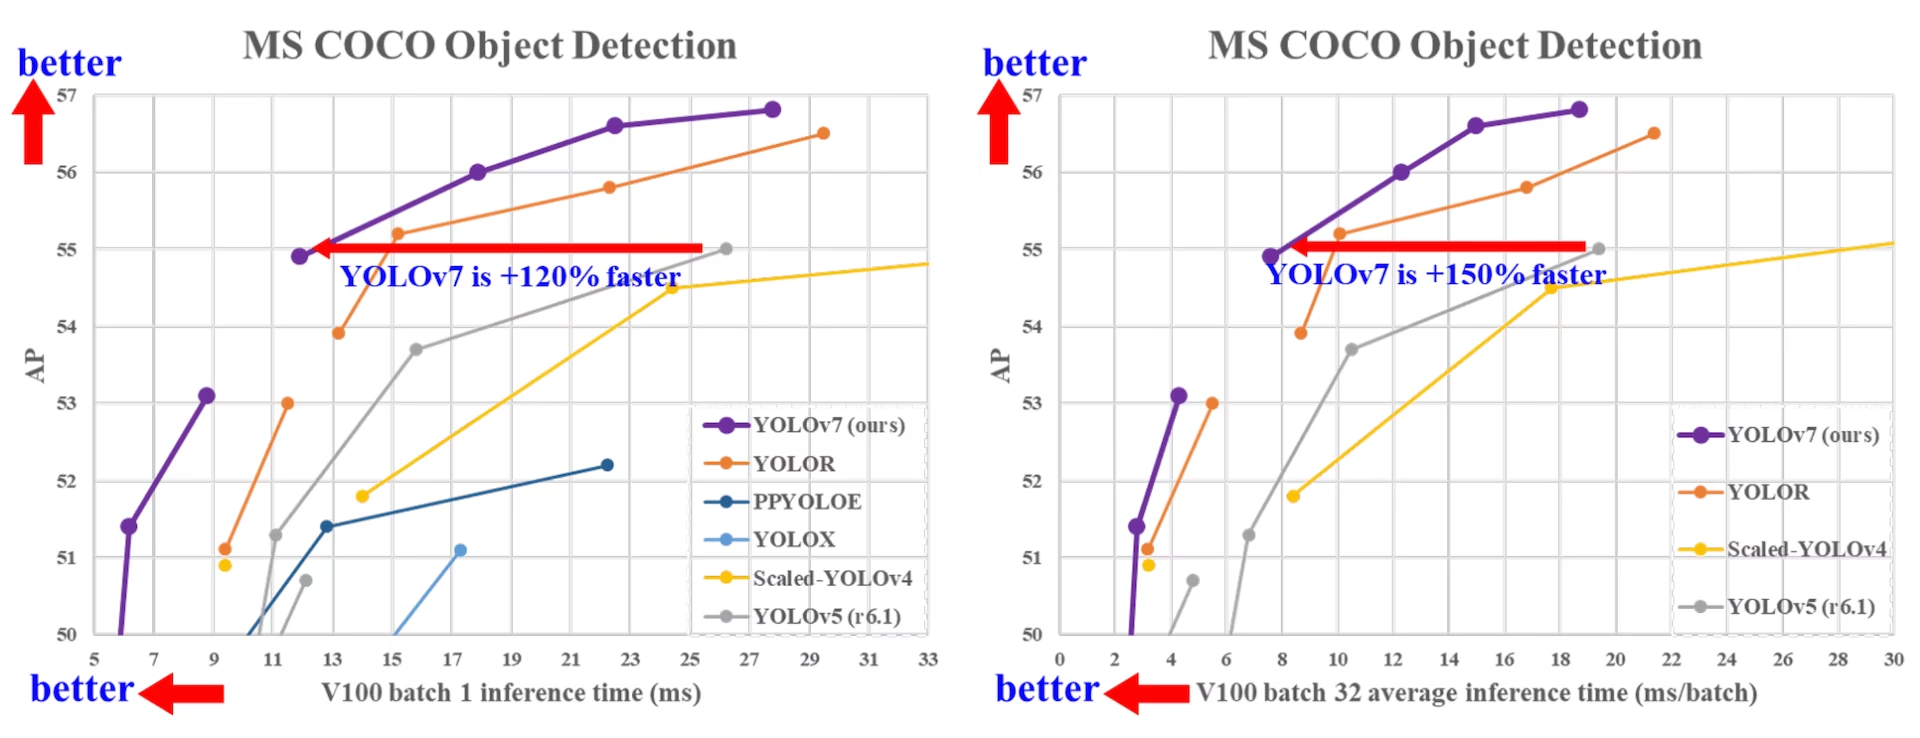
Comparación de detectores de objetos de última generación#
Según la tabla comparativa del artículo de YOLOv7, YOLOv7 ofrece el mejor equilibrio general entre velocidad y precisión. En comparación con YOLOv5-N (r6.1), YOLOv7-tiny-SiLU es 127 fps más rápido y un 10,7 % más preciso en AP. Además, YOLOv7 alcanza un 51,4 % de AP a 161 fps, mientras que PPYOLOE-L alcanza el mismo AP a solo 78 fps, y YOLOv7 utiliza un 41 % menos de parámetros que PPYOLOE-L.
En comparación con YOLOv5-L (r6.1), que alcanza 99 fps, YOLOv7-X funciona a 114 fps y mejora el AP en un 3,9 %. En comparación con YOLOv5-X (r6.1), de tamaño similar, YOLOv7-X es 31 fps más rápido, utiliza un 22 % menos de parámetros y un 8 % menos de cálculos, y mejora el AP en un 2,2 % (fuente).
| Modelo | Parámetros (M) | FLOPs (G) | Tamaño (píxeles) | FPS | APprueba / val50-95 | APprueba50 | APprueba75 | APpruebaS | APpruebaM | APpruebaL |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOX-S | 9.0 | 26.8 | 640 | 102 | 40.5% / 40.5% | - | - | - | - | - |
| YOLOX-M | 25.3 | 73.8 | 640 | 81 | 47.2% / 46.9% | - | - | - | - | - |
| YOLOX-L | 54.2 | 155.6 | 640 | 69 | 50.1% / 49.7% | - | - | - | - | - |
| YOLOX-X | 99.1 | 281.9 | 640 | 58 | 51.5% / 51.1% | - | - | - | - | - |
| PPYOLOE-S | 7.9 | 17.4 | 640 | 208 | 43.1% / 42.7% | 60.5% | 46.6% | 23.2% | 46.4% | 56.9% |
| PPYOLOE-M | 23.4 | 49.9 | 640 | 123 | 48.9% / 48.6% | 66.5% | 53.0% | 28.6% | 52.9% | 63.8% |
| PPYOLOE-L | 52.2 | 110.1 | 640 | 78 | 51.4% / 50.9% | 68.9% | 55.6% | 31.4% | 55.3% | 66.1% |
| PPYOLOE-X | 98.4 | 206.6 | 640 | 45 | 52.2% / 51.9% | 69.9% | 56.5% | 33.3% | 56.3% | 66.4% |
| YOLOv5-N (r6.1) | 1.9 | 4.5 | 640 | 159 | - / 28.0% | - | - | - | - | - |
| YOLOv5-S (r6.1) | 7.2 | 16.5 | 640 | 156 | - / 37.4% | - | - | - | - | - |
| YOLOv5-M (r6.1) | 21.2 | 49.0 | 640 | 122 | - / 45.4% | - | - | - | - | - |
| YOLOv5-L (r6.1) | 46.5 | 109.1 | 640 | 99 | - / 49.0% | - | - | - | - | - |
| YOLOv5-X (r6.1) | 86.7 | 205.7 | 640 | 83 | - / 50.7% | - | - | - | - | - |
| YOLOR-CSP | 52.9 | 120.4 | 640 | 106 | 51.1% / 50.8% | 69.6% | 55.7% | 31.7% | 55.3% | 64.7% |
| YOLOR-CSP-X | 96.9 | 226.8 | 640 | 87 | 53.0% / 52.7% | 71.4% | 57.9% | 33.7% | 57.1% | 66.8% |
| YOLOv7-tiny-SiLU | 6.2 | 13.8 | 640 | 286 | 38.7% / 38.7% | 56.7% | 41.7% | 18.8% | 42.4% | 51.9% |
| YOLOv7 | 36.9 | 104.7 | 640 | 161 | 51.4% / 51.2% | 69.7% | 55.9% | 31.8% | 55.5% | 65.0% |
| YOLOv7-X | 71.3 | 189.9 | 640 | 114 | 53.1% / 52.9% | 71.2% | 57.8% | 33.8% | 57.1% | 67.4% |
| YOLOv5-N6 (r6.1) | 3.2 | 18.4 | 1280 | 123 | - / 36.0% | - | - | - | - | - |
| YOLOv5-S6 (r6.1) | 12.6 | 67.2 | 1280 | 122 | - / 44.8% | - | - | - | - | - |
| YOLOv5-M6 (r6.1) | 35.7 | 200.0 | 1280 | 90 | - / 51.3% | - | - | - | - | - |
| YOLOv5-L6 (r6.1) | 76.8 | 445.6 | 1280 | 63 | - / 53.7% | - | - | - | - | - |
| YOLOv5-X6 (r6.1) | 140.7 | 839.2 | 1280 | 38 | - / 55.0% | - | - | - | - | - |
| YOLOR-P6 | 37.2 | 325.6 | 1280 | 76 | 53.9% / 53.5% | 71.4% | 58.9% | 36.1% | 57.7% | 65.6% |
| YOLOR-W6 | 79.8 | 453.2 | 1280 | 66 | 55.2% / 54.8% | 72.7% | 60.5% | 37.7% | 59.1% | 67.1% |
| YOLOR-E6 | 115.8 | 683.2 | 1280 | 45 | 55.8% / 55.7% | 73.4% | 61.1% | 38.4% | 59.7% | 67.7% |
| YOLOR-D6 | 151.7 | 935.6 | 1280 | 34 | 56.5% / 56.1% | 74.1% | 61.9% | 38.9% | 60.4% | 68.7% |
| YOLOv7-W6 | 70.4 | 360.0 | 1280 | 84 | 54.9% / 54.6% | 72.6% | 60.1% | 37.3% | 58.7% | 67.1% |
| YOLOv7-E6 | 97.2 | 515.2 | 1280 | 56 | 56.0% / 55.9% | 73.5% | 61.2% | 38.0% | 59.9% | 68.4% |
| YOLOv7-D6 | 154.7 | 806.8 | 1280 | 44 | 56.6% / 56.3% | 74.0% | 61.8% | 38.8% | 60.1% | 69.5% |
| YOLOv7-E6E | 151.7 | 843.2 | 1280 | 36 | 56.8% / 56.8% | 74.4% | 62.1% | 39.3% | 60.5% | 69.0% |
Descripción general#
La detección de objetos en tiempo real es un componente importante de muchos sistemas de visión artificial, como el seguimiento de varios objetos, la conducción autónoma, la robótica y el análisis de imágenes médicas. En los últimos años, el desarrollo de la detección de objetos en tiempo real se ha centrado en diseñar arquitecturas eficientes y mejorar la velocidad de inferencia de diversas CPU, GPU y unidades de procesamiento neuronal (NPU). YOLOv7 admite tanto GPU móviles como otros dispositivos con GPU, desde el edge hasta la nube.
A diferencia de los detectores de objetos en tiempo real tradicionales, que se centran en optimizar la arquitectura, YOLOv7 pone el foco en optimizar el proceso de entrenamiento. Esto incluye módulos y métodos de optimización diseñados para mejorar la precisión de la detección de objetos sin aumentar el coste de inferencia, un concepto conocido como «trainable bag-of-freebies».
Características principales#
YOLOv7 incorpora varias características clave:
-
Reparametrización del modelo: YOLOv7 propone un modelo reparametrizado planificado, una estrategia aplicable a capas de distintas redes basada en el concepto de la ruta de propagación del gradiente.
-
Asignación dinámica de etiquetas: El entrenamiento del modelo con varias capas de salida plantea un nuevo problema: «¿Cómo se asignan objetivos dinámicos a las salidas de las distintas ramas?». Para resolverlo, YOLOv7 incorpora un nuevo método de asignación de etiquetas denominado asignación guiada de etiquetas de grueso a fino.
-
Escalado extendido y compuesto: YOLOv7 propone métodos de «extensión» y «escalado compuesto» para el detector de objetos en tiempo real, que permiten aprovechar eficazmente los parámetros y el cálculo.
-
Eficiencia: el método propuesto por YOLOv7 reduce aproximadamente un 40 % los parámetros y un 50 % los cálculos de los detectores de objetos en tiempo real de última generación, al tiempo que ofrece una inferencia más rápida y una mayor precisión de detección.
Ejemplos de uso#
Ultralytics no publica pesos preentrenados yolov7.pt ni archivos YAML ultralytics/cfg/models/v7/, y el paquete Python de Ultralytics no admite el entrenamiento ni la inferencia nativos de YOLOv7 con PyTorch. Sin embargo, puedes incorporar a Ultralytics un punto de control de YOLOv7 entrenado en el repositorio upstream de YOLOv7 exportándolo a ONNX o TensorRT, como se muestra a continuación.
Exportación a ONNX#
Para usar un modelo ONNX de YOLOv7 con Ultralytics:
-
(Opcional) Instala Ultralytics y exporta un modelo ONNX para que se instalen automáticamente las dependencias necesarias:
pip install ultralytics yolo export model=yolo26n.pt format=onnx -
Exporta el modelo YOLOv7 que quieras con el exportador del repositorio de YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 cd yolov7 python export.py --weights yolov7-tiny.pt --grid --end2end --simplify --topk-all 100 --iou-thres 0.65 --conf-thres 0.35 --img-size 640 640 --max-wh 640 -
Modifica el grafo del modelo ONNX para que sea compatible con Ultralytics mediante el siguiente script:
import numpy as np import onnx from onnx import helper, numpy_helper # Load the ONNX model model_path = "yolov7/yolov7-tiny.onnx" # Replace with your model path model = onnx.load(model_path) graph = model.graph # Fix input shape to batch size 1 input_shape = graph.input[0].type.tensor_type.shape input_shape.dim[0].dim_value = 1 # Define the output of the original model original_output_name = graph.output[0].name # Create slicing nodes sliced_output_name = f"{original_output_name}_sliced" # Define initializers for slicing (remove the first value) start = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_start") end = numpy_helper.from_array(np.array([7], dtype=np.int64), name="slice_end") axes = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_axes") steps = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_steps") graph.initializer.extend([start, end, axes, steps]) slice_node = helper.make_node( "Slice", inputs=[original_output_name, "slice_start", "slice_end", "slice_axes", "slice_steps"], outputs=[sliced_output_name], name="SliceNode", ) graph.node.append(slice_node) # Define segment slicing seg1_start = numpy_helper.from_array(np.array([0], dtype=np.int64), name="seg1_start") seg1_end = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg1_end") seg2_start = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg2_start") seg2_end = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg2_end") seg3_start = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg3_start") seg3_end = numpy_helper.from_array(np.array([6], dtype=np.int64), name="seg3_end") graph.initializer.extend([seg1_start, seg1_end, seg2_start, seg2_end, seg3_start, seg3_end]) # Create intermediate tensors for segments segment_1_name = f"{sliced_output_name}_segment1" segment_2_name = f"{sliced_output_name}_segment2" segment_3_name = f"{sliced_output_name}_segment3" # Add segment slicing nodes graph.node.extend( [ helper.make_node( "Slice", inputs=[sliced_output_name, "seg1_start", "seg1_end", "slice_axes", "slice_steps"], outputs=[segment_1_name], name="SliceSegment1", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg2_start", "seg2_end", "slice_axes", "slice_steps"], outputs=[segment_2_name], name="SliceSegment2", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg3_start", "seg3_end", "slice_axes", "slice_steps"], outputs=[segment_3_name], name="SliceSegment3", ), ] ) # Concatenate the segments concat_output_name = f"{sliced_output_name}_concat" concat_node = helper.make_node( "Concat", inputs=[segment_1_name, segment_3_name, segment_2_name], outputs=[concat_output_name], axis=1, name="ConcatSwapped", ) graph.node.append(concat_node) # Reshape to [1, -1, 6] reshape_shape = numpy_helper.from_array(np.array([1, -1, 6], dtype=np.int64), name="reshape_shape") graph.initializer.append(reshape_shape) final_output_name = f"{concat_output_name}_batched" reshape_node = helper.make_node( "Reshape", inputs=[concat_output_name, "reshape_shape"], outputs=[final_output_name], name="AddBatchDimension", ) graph.node.append(reshape_node) # Get the shape of the reshaped tensor shape_node_name = f"{final_output_name}_shape" shape_node = helper.make_node( "Shape", inputs=[final_output_name], outputs=[shape_node_name], name="GetShapeDim", ) graph.node.append(shape_node) # Extract the second dimension dim_1_index = numpy_helper.from_array(np.array([1], dtype=np.int64), name="dim_1_index") graph.initializer.append(dim_1_index) second_dim_name = f"{final_output_name}_dim1" gather_node = helper.make_node( "Gather", inputs=[shape_node_name, "dim_1_index"], outputs=[second_dim_name], name="GatherSecondDim", ) graph.node.append(gather_node) # Subtract from 100 to determine how many values to pad target_size = numpy_helper.from_array(np.array([100], dtype=np.int64), name="target_size") graph.initializer.append(target_size) pad_size_name = f"{second_dim_name}_padsize" sub_node = helper.make_node( "Sub", inputs=["target_size", second_dim_name], outputs=[pad_size_name], name="CalculatePadSize", ) graph.node.append(sub_node) # Build the [2, 3] pad array: # 1st row -> [0, 0, 0] (no padding at the start of any dim) # 2nd row -> [0, pad_size, 0] (pad only at the end of the second dim) pad_starts = numpy_helper.from_array(np.array([0, 0, 0], dtype=np.int64), name="pad_starts") graph.initializer.append(pad_starts) zero_scalar = numpy_helper.from_array(np.array([0], dtype=np.int64), name="zero_scalar") graph.initializer.append(zero_scalar) pad_ends_name = "pad_ends" concat_pad_ends_node = helper.make_node( "Concat", inputs=["zero_scalar", pad_size_name, "zero_scalar"], outputs=[pad_ends_name], axis=0, name="ConcatPadEnds", ) graph.node.append(concat_pad_ends_node) pad_values_name = "pad_values" concat_pad_node = helper.make_node( "Concat", inputs=["pad_starts", pad_ends_name], outputs=[pad_values_name], axis=0, name="ConcatPadStartsEnds", ) graph.node.append(concat_pad_node) # Create Pad operator to pad with zeros pad_output_name = f"{final_output_name}_padded" pad_constant_value = numpy_helper.from_array( np.array([0.0], dtype=np.float32), name="pad_constant_value", ) graph.initializer.append(pad_constant_value) pad_node = helper.make_node( "Pad", inputs=[final_output_name, pad_values_name, "pad_constant_value"], outputs=[pad_output_name], mode="constant", name="PadToFixedSize", ) graph.node.append(pad_node) # Update the graph's final output to [1, 100, 6] new_output_type = onnx.helper.make_tensor_type_proto( elem_type=graph.output[0].type.tensor_type.elem_type, shape=[1, 100, 6] ) new_output = onnx.helper.make_value_info(name=pad_output_name, type_proto=new_output_type) # Replace the old output with the new one graph.output.pop() graph.output.extend([new_output]) # Save the modified model onnx.save(model, "yolov7-ultralytics.onnx") -
A continuación, puedes cargar el modelo ONNX modificado y ejecutar inferencias con él en Ultralytics como de costumbre:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.onnx", task="detect")

results = model(ASSETS / "bus.jpg")
Exportación a TensorRT#
-
Sigue los pasos 1 y 2 de la sección Exportación a ONNX.
-
Instala el paquete Python
TensorRT:pip install tensorrt -
Ejecuta el siguiente script para convertir el modelo ONNX modificado en un motor TensorRT:
from ultralytics.utils.export import onnx2engine onnx2engine("yolov7-ultralytics.onnx", quantize=16) -
Carga y ejecuta el modelo en Ultralytics:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.engine", task="detect")

results = model(ASSETS / "bus.jpg")
Citas y agradecimientos#
Queremos reconocer las importantes contribuciones de los autores de YOLOv7 al campo de la detección de objetos en tiempo real:
@inproceedings{wang2023yolov7,
  title={YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors},
  author={Wang, Chien-Yao and Bochkovskiy, Alexey and Liao, Hong-Yuan Mark},
  booktitle={Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition (CVPR)},
  pages={7464--7475},
  year={2023}
}
El artículo oficial de YOLOv7 se publicó en CVPR 2023 y está disponible en CVF Open Access, con una prepublicación en arXiv. Los autores han puesto su trabajo a disposición del público y el código se puede consultar en GitHub. Agradecemos sus esfuerzos por impulsar el campo y hacer que su trabajo esté al alcance de una comunidad más amplia.
Preguntas frecuentes#
YOLOv7, lanzado en julio de 2022, era un modelo de detección de objetos en tiempo real que, en el momento de su lanzamiento, ofrecía velocidad y precisión de vanguardia. Superaba a modelos contemporáneos como YOLOX, YOLOv5 y PPYOLOE tanto en el uso de parámetros como en la velocidad de inferencia. Entre sus características distintivas se encuentran la reparametrización del modelo y la asignación dinámica de etiquetas, que optimizan el rendimiento sin aumentar los costes de inferencia.
YOLOv7 incorpora varias innovaciones, como la reparametrización del modelo y la asignación dinámica de etiquetas, que mejoran el proceso de entrenamiento y la precisión de inferencia. En comparación con YOLOv5, YOLOv7 aumenta considerablemente la velocidad y la precisión. Por ejemplo, YOLOv7-X mejora la precisión en un 2,2 % y reduce los parámetros en un 22 % frente a YOLOv5-X. Encontrarás comparaciones detalladas en la tabla de rendimiento Comparación de YOLOv7 con detectores de objetos SOTA.
Actualmente, Ultralytics solo admite la inferencia de YOLOv7 con ONNX y TensorRT. Para ejecutar con Ultralytics las versiones de YOLOv7 exportadas a ONNX y TensorRT, consulta la sección Ejemplos de uso.
Para instalar y entrenar un modelo YOLOv7 personalizado, sigue estos pasos:
-
Clona el repositorio de YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 -
Ve al directorio clonado e instala las dependencias:
cd yolov7 pip install -r requirements.txt -
Prepara tu conjunto de datos y configura los parámetros del modelo según las instrucciones de uso proporcionadas en el repositorio.
-
Tras el entrenamiento, puedes exportar el modelo a ONNX o TensorRT para usarlo en Ultralytics, como se muestra en Ejemplos de uso.
-
YOLOv7 incorpora varias funciones clave para la detección de objetos en tiempo real:
- Reparametrización del modelo: Mejora el rendimiento del modelo al optimizar las rutas de propagación del gradiente.
- Asignación dinámica de etiquetas: Utiliza un método guiado de grueso a fino para asignar objetivos dinámicos a las salidas de las distintas ramas y mejorar la precisión.
- Escalado extendido y compuesto: Aprovecha eficazmente los parámetros y el cálculo para escalar el modelo en distintas aplicaciones en tiempo real.
- Eficiencia: Reduce en un 40 % el número de parámetros y en un 50 % el cálculo frente a otros modelos de vanguardia, al tiempo que ofrece velocidades de inferencia superiores.


Comentarios2
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
naps22
YOLOv7's approach as a trainable bag-of-freebies really stands out, especially in how it optimizes performance without additional inference cost. It's impressive how techniques like re-parameterization and dynamic label assignment enhance accuracy. However, after doing a YOLOv8 comparison, it’s clear that while YOLOv8 brings some architectural improvements and streamlined workflows, YOLOv7 still holds strong in many real-time detection scenarios due to its training-time flexibility.
 Glenn JocherUltralytics(editado)
You're absolutely right about YOLOv7's innovative "trainable bag-of-freebies" approach - it was a game-changing concept that improved accuracy purely through training optimizations rather than architectural changes. The re-parameterization and dynamic label assignment techniques were particularly clever solutions that set new standards for efficiency.
While YOLOv7 remains excellent for real-time detection scenarios, you might want to explore YOLO26 as well - it's our latest model that builds upon these innovations with even better performance across detection, segmentation, and other tasks, all within the streamlined Ultralytics framework.