Jeu de données Global Wheat Head#
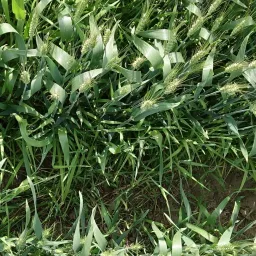
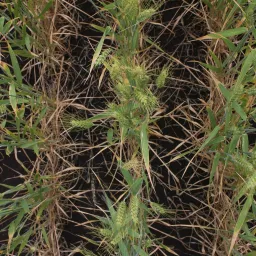
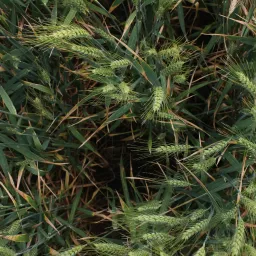
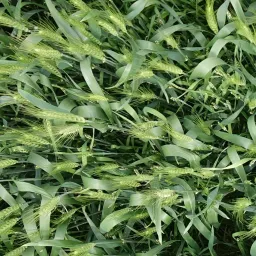
Le jeu de données Global Wheat Head (GWHD) est un jeu de données à classe unique de détection d’objets destiné à détecter les épis de blé — les inflorescences porteuses de grains de la plante de blé — dans des images de champs en extérieur. Il comprend 3,422 images d’entraînement, 748 images de validation et 1,276 images de test capturées dans plusieurs régions de culture. Il a été créé par neuf instituts de recherche de sept pays afin que les modèles généralisent à différents environnements. La détection précise des épis de blé permet d’estimer leur densité, leur taille et le potentiel de rendement dans le cadre du phénotypage végétal et de la gestion des cultures.
Fonctionnalités clés#
- Des images réelles de champs en extérieur qui illustrent la variabilité naturelle de l’apparence des épis de blé, de l’éclairage et des stades de croissance.
- Créé par neuf instituts de recherche répartis dans sept pays, couvrant des régions de culture en Europe, en Amérique du Nord, en Asie et en Australie pour une forte capacité de généralisation entre différents environnements.
- Annotations par boîtes englobantes pour une seule classe,
wheat_head, prêtes à l’emploi dans les pipelines de détection d’objets et de suivi. - Les images de test proviennent de génotypes et de régions absents des données d’entraînement, offrant ainsi une véritable référence pour évaluer la généralisation.
Structure du jeu de données#
Le jeu de données Global Wheat Head est organisé en trois sous-ensembles définis par la configuration GlobalWheat2020.yaml, tous annotés avec une seule classe, wheat_head :
| Partition | Images | Régions |
|---|---|---|
| Entraînement | 3,422 | Europe (France, Royaume-Uni, Suisse), Amérique du Nord (Canada) |
| Validation | 748 | Suisse (ETH Zürich) |
| Test | 1,276 | Australie, Japon, Chine |
L’ensemble de validation (748 images) correspond au sous-ensemble ethz_1, qui est également inclus dans l’ensemble d’entraînement : les métriques de validation sont donc mesurées sur des images utilisées aussi pour entraîner le modèle. L’ensemble de test tenu à l’écart, composé d’images d’Australie, du Japon et de Chine, mesure la capacité de généralisation à des environnements jamais vus pendant l’entraînement.
Applications#
Le Global Wheat Head Dataset est largement utilisé pour entraîner et évaluer des modèles de deep learning destinés à détecter les épis de blé. La diversité des images, issues de différentes régions, de différents génotypes et de différentes conditions, en fait une ressource précieuse pour le phénotypage des plantes et la gestion des cultures ; elle contribue à l’estimation du rendement, au suivi de la santé des cultures et à l’analyse phénotypique.
Pour annoter des images de terrain, entraîner des modèles et gérer les versions de tes jeux de données dans ton navigateur, exécute l’ensemble du flux de travail avec Ultralytics Platform.
Fichier YAML du jeu de données#
Un fichier YAML sert à définir la configuration du jeu de données. Il définit les chemins d’accès, les classes et d’autres détails de configuration du jeu de données. Pour le Global Wheat Head Dataset, le fichier GlobalWheat2020.yaml est maintenu à l’adresse https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Global Wheat 2020 dataset https://www.global-wheat.com/ by University of Saskatchewan
# Documentation: https://docs.ultralytics.com/datasets/detect/globalwheat2020
# Example usage: yolo train data=GlobalWheat2020.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── GlobalWheat2020 ← downloads here (7.0 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: GlobalWheat2020 # dataset root dir
train: # train images (relative to 'path') 3422 images
  - images/arvalis_1
  - images/arvalis_2
  - images/arvalis_3
  - images/ethz_1
  - images/rres_1
  - images/inrae_1
  - images/usask_1
val: # val images (relative to 'path') 748 images (WARNING: train set contains ethz_1)
  - images/ethz_1
test: # test images (optional) 1276 images
  - images/utokyo_1
  - images/utokyo_2
  - images/nau_1
  - images/uq_1

# Classes
names:
  0: wheat_head

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  from pathlib import Path

  from ultralytics.utils.downloads import download

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = [
      "https://zenodo.org/record/4298502/files/global-wheat-codalab-official.zip",
      "https://github.com/ultralytics/assets/releases/download/v0.0.0/GlobalWheat2020_labels.zip",
  ]
  download(urls, dir=dir)

  # Make Directories
  for p in "annotations", "images", "labels":
      (dir / p).mkdir(parents=True, exist_ok=True)

  # Move
  for p in (
      "arvalis_1",
      "arvalis_2",
      "arvalis_3",
      "ethz_1",
      "rres_1",
      "inrae_1",
      "usask_1",
      "utokyo_1",
      "utokyo_2",
      "nau_1",
      "uq_1",
  ):
      (dir / "global-wheat-codalab-official" / p).rename(dir / "images" / p)  # move to /images
      f = (dir / "global-wheat-codalab-official" / p).with_suffix(".json")  # json file
      if f.exists():
f.rename((dir / "annotations" / p).with_suffix(".json")) # move to /annotationsUtilisation#
Pour entraîner un modèle YOLO26n sur le Global Wheat Head Dataset pendant 100 époques avec une taille d’image de 640, tu peux utiliser les extraits de code suivants. Le jeu de données (~7.0 GB) est téléchargé automatiquement lors de sa première utilisation. Pour consulter la liste complète des arguments disponibles, reporte-toi à la page Entraînement du modèle.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)

# Entraîner le modèle
results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)
Exemples d’images et annotations#
Le Global Wheat Head Dataset contient un ensemble diversifié d’images prises en extérieur dans des champs, qui illustrent la variabilité naturelle de l’apparence des épis de blé, des environnements et des conditions. Voici un exemple d’image du jeu de données et les annotations correspondantes :
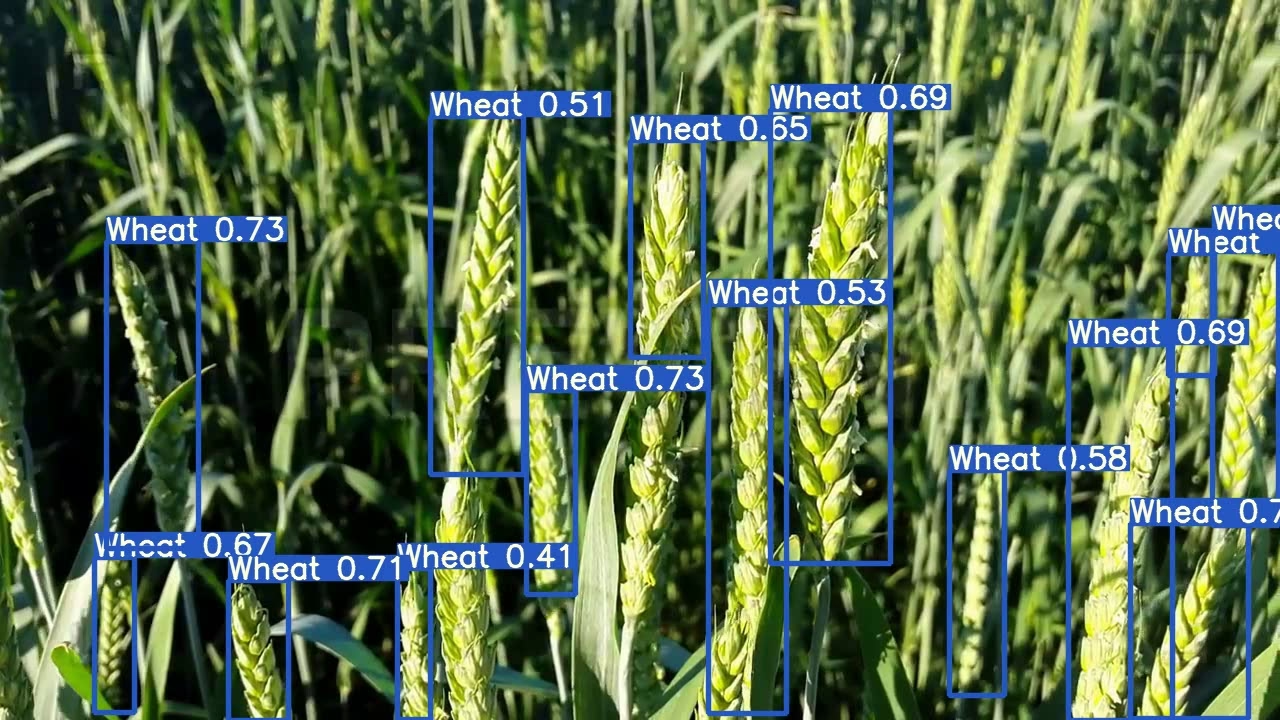
- Détection des épis de blé : les épis de blé sont annotés à l’aide de boîtes englobantes pour la détection d’objets, dans diverses conditions de terrain qui reflètent la diversité et la complexité du jeu de données.
Citations et remerciements#
Si tu utilises le Global Wheat Head Dataset dans tes travaux de recherche ou de développement, cite l’article suivant :
@article{david2020global,
         title={Global Wheat Head Detection (GWHD) Dataset: A Large and Diverse Dataset of High-Resolution RGB-Labelled Images to Develop and Benchmark Wheat Head Detection Methods},
         author={David, Etienne and Madec, Simon and Sadeghi-Tehran, Pouria and Aasen, Helge and Zheng, Bangyou and Liu, Shouyang and Kirchgessner, Norbert and Ishikawa, Goro and Nagasawa, Koichi and Badhon, Minhajul and others},
         journal={arXiv preprint arXiv:2005.02162},
         year={2020}
}
Nous souhaitons remercier les chercheurs et les établissements qui ont contribué à la création et à la maintenance du Global Wheat Head Dataset, une ressource précieuse pour la communauté de recherche sur le phénotypage des plantes et la gestion des cultures. Pour en savoir plus sur le jeu de données et ses créateurs, consulte le site Web du Global Wheat Head Dataset.
FAQ#
Le Global Wheat Head Dataset sert principalement à développer et à entraîner des modèles de deep learning destinés à détecter les épis de blé. Cette tâche est essentielle pour les applications de phénotypage du blé et de gestion des cultures, car elle permet d’estimer plus précisément la densité et la taille des épis de blé, ainsi que le potentiel de rendement global des cultures. Des méthodes de détection précises aident à évaluer la santé et la maturité des cultures, des facteurs essentiels à une gestion efficace.
Le Global Wheat Head Dataset comporte une seule classe,
wheat_head, et est réparti en trois sous-ensembles : 3,422 images d’entraînement, 748 images de validation et 1,276 images de test. Les images d’entraînement et de validation proviennent d’Europe et d’Amérique du Nord, tandis que l’ensemble de test est constitué d’images d’Australie, du Japon et de Chine afin d’évaluer la généralisation à des environnements jamais vus.Pour entraîner un modèle YOLO26n sur le Global Wheat Head Dataset, tu peux utiliser les extraits de code suivants. Assure-toi de disposer du fichier de configuration
GlobalWheat2020.yaml, qui spécifie les chemins d’accès au jeu de données et ses classes :Exemple d’entraînementfrom ultralytics import YOLO # Charger un modèle préentraîné (recommandé pour l’entraînement) model = YOLO("yolo26n.pt") # Entraîner le modèle results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)Pour consulter la liste complète des arguments disponibles, reporte-toi à la page Entraînement du modèle.
Le jeu de données (~7.0 GB) est téléchargé automatiquement la première fois que tu lances un entraînement avec
data="GlobalWheat2020.yaml": aucune étape manuelle n’est nécessaire. Ultralytics récupère les images et les étiquettes, puis les extrait dans le répertoire local de tes jeux de données. Tu peux consulter des jeux de données apparentés dans la vue d’ensemble des jeux de données de détection.Le fichier de configuration YAML du Global Wheat Head Dataset, nommé
GlobalWheat2020.yaml, est disponible sur GitHub. Tu peux y accéder à l’adresse https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml. Ce fichier contient les chemins d’accès au jeu de données, les classes et d’autres détails de configuration nécessaires à l’entraînement des modèles dans Ultralytics YOLO.La détection des épis de blé est essentielle à la gestion des cultures, car elle permet d’estimer précisément leur densité et leur taille, des mesures indispensables pour évaluer la santé, la maturité et le potentiel de rendement des cultures. En exploitant des modèles de deep learning entraînés sur des jeux de données comme le Global Wheat Head Dataset, les agriculteurs et les chercheurs peuvent mieux surveiller et gérer les cultures, ce qui améliore la productivité et optimise l’utilisation des ressources agricoles. Cette avancée technologique soutient l’agriculture durable et les initiatives de sécurité alimentaire.
Pour en savoir plus sur les applications de l’IA en agriculture, consulte IA en agriculture.