Déployer un modèle YOLO préentraîné avec Ultralytics sur Vertex AI pour l’inférence#
Ce guide t’explique comment conteneuriser un modèle YOLO26 préentraîné avec Ultralytics, créer un serveur d’inférence FastAPI pour ce modèle et le déployer avec un serveur d’inférence sur Google Cloud Vertex AI. L’exemple d’implémentation porte sur la détection d’objets avec YOLO26, mais les mêmes principes s’appliquent à d’autres tâches YOLO.
Avant de commencer, tu dois créer un projet Google Cloud Platform (GCP). En tant que nouvel utilisateur, tu reçois 300 $ de crédits GCP gratuits, ce qui suffit pour tester une configuration fonctionnelle que tu pourras ensuite étendre à d’autres cas d’utilisation de YOLO26, notamment l’entraînement, l’inférence par lots et l’inférence en continu.
Ce que tu vas apprendre#
- Créer un backend d’inférence pour un modèle Ultralytics YOLO26 avec FastAPI.
- Créer un dépôt GCP Artifact Registry pour stocker ton image Docker.
- Créer l’image Docker contenant le modèle et l’envoyer vers Artifact Registry.
- Importer ton modèle dans Vertex AI.
- Créer un point de terminaison Vertex AI et y déployer le modèle.
- Contrôle complet du modèle avec Ultralytics : tu peux utiliser une logique d’inférence personnalisée et contrôler entièrement le prétraitement, le post-traitement et le format des réponses.
- Vertex AI s’occupe du reste : le service ajuste automatiquement la capacité, tout en te laissant configurer les ressources de calcul, la mémoire et les GPU.
- Intégrations natives et sécurité GCP : configuration fluide avec Cloud Storage, BigQuery, Cloud Functions, les contrôles VPC, les stratégies IAM et les journaux d’audit.
Prérequis#
- Installe Docker sur ta machine.
- Installe le Google Cloud SDK et authentifie-toi pour utiliser la CLI gcloud.
- Il est vivement recommandé de consulter le guide de démarrage rapide de Docker pour Ultralytics, car tu devras étendre l’une des images Docker officielles d’Ultralytics en suivant ce guide.
1. Créer un backend d’inférence avec FastAPI#
Commence par créer une application FastAPI qui traitera les requêtes d’inférence du modèle YOLO26. Cette application gérera le chargement du modèle, le prétraitement des images et la logique d’inférence (prédiction).
Principes fondamentaux de la conformité de Vertex AI#
Vertex AI exige que ton conteneur implémente deux points de terminaison spécifiques :
-
Point de terminaison de santé (
/health) : doit renvoyer le statut HTTP200 OKlorsque le service est prêt. -
Point de terminaison de prédiction (
/predict) : accepte des requêtes de prédiction structurées contenant des images encodées en base64 et des paramètres facultatifs. Des limites de taille de charge utile s’appliquent selon le type de point de terminaison.Les charges utiles des requêtes destinées au point de terminaison
/predictdoivent respecter cette structure JSON :{ "instances": [{ "image": "base64_encoded_image" }], "parameters": { "confidence": 0.5 } }
Structure du dossier du projet#
L’essentiel de la compilation se fera dans le conteneur Docker. Ultralytics chargera également un modèle YOLO26 préentraîné ; tu peux donc garder une structure de dossiers locale simple :
YOUR_PROJECT/
├── src/
│   ├── __init__.py
│   ├── app.py              # Core YOLO26 inference logic
│   └── main.py             # FastAPI inference server
├── tests/
├── .env                    # Environment variables for local development
├── Dockerfile              # Container configuration
├── LICENSE                 # AGPL-3.0 License
└── pyproject.toml # Python dependencies and project configLes modèles Ultralytics YOLO26 et le framework sont sous licence AGPL-3.0, qui impose d’importantes exigences de conformité. Veille à lire la documentation Ultralytics sur la manière de respecter les conditions de la licence.
Créer pyproject.toml avec les dépendances#
Pour gérer facilement ton projet, crée un fichier pyproject.toml contenant les dépendances suivantes :
[project]
name = "YOUR_PROJECT_NAME"
version = "0.0.1"
description = "YOUR_PROJECT_DESCRIPTION"
requires-python = ">=3.10,<3.13"
dependencies = [
   "ultralytics>=8.4.0",
   "fastapi[all]>=0.89.1",
   "uvicorn[standard]>=0.20.0",
   "pillow>=9.0.0",
   "loguru",
]

[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"uvicornservira à exécuter le serveur FastAPI.loguruservira à consigner les journaux du serveur FastAPI.pillowservira au traitement des images, mais tu n’es pas limité aux images PIL : Ultralytics prend en charge de nombreux autres formats.
Créer la logique d’inférence avec Ultralytics YOLO26#
Maintenant que la structure du projet et les dépendances sont en place, tu peux implémenter la logique d’inférence YOLO26 principale. Crée un fichier src/app.py qui gérera le chargement du modèle, le traitement des images et la prédiction à l’aide de l’API Python d’Ultralytics.
# src/app.py

from ultralytics import YOLO

# Model initialization and readiness state
model_yolo = None
_model_ready = False

def _initialize_model():
    """Initialize the YOLO model."""
    global model_yolo, _model_ready

    try:
        # Use pretrained YOLO26n model from Ultralytics base image
        model_yolo = YOLO("yolo26n.pt")
        _model_ready = True

    except Exception as e:
        print(f"Error initializing YOLO model: {e}")
        _model_ready = False
        model_yolo = None

# Initialize model on module import
_initialize_model()

def is_model_ready() -> bool:
    """Check if the model is ready for inference."""
    return _model_ready and model_yolo is not None
Le modèle sera chargé une seule fois au démarrage du conteneur, puis partagé entre toutes les requêtes. Si ton modèle doit gérer une charge d’inférence importante, il est recommandé de choisir une machine dotée de plus de mémoire lors de l’importation du modèle dans Vertex AI, à une étape ultérieure.
Ensuite, crée deux fonctions utilitaires pour traiter les images en entrée et en sortie avec pillow. YOLO26 prend en charge nativement les images PIL.
def get_image_from_bytes(binary_image: bytes) -> Image.Image:
    """Convert image from bytes to PIL RGB format."""
    input_image = Image.open(io.BytesIO(binary_image)).convert("RGB")
    return input_image
def get_bytes_from_image(image: Image.Image) -> bytes:
"""Convert PIL image to bytes."""
return_image = io.BytesIO()
image.save(return_image, format="JPEG", quality=85)
return_image.seek(0)
return return_image.getvalue()Enfin, implémente la fonction run_inference qui gérera la détection d’objets. Dans cet exemple, nous extrairons les boîtes englobantes, les noms des classes et les scores de confiance des prédictions du modèle. La fonction renverra un dictionnaire contenant les détections et les résultats bruts, pour un traitement ultérieur ou l’annotation.
def run_inference(input_image: Image.Image, confidence_threshold: float = 0.5) -> Dict[str, Any]:
    """Run inference on an image using YOLO26n model."""
    # Check if model is ready
    if not is_model_ready():
        print("Model not ready for inference")
        return {"detections": [], "results": None}

    try:
        # Make predictions and get raw results
        results = model_yolo.predict(
            imgsz=640, source=input_image, conf=confidence_threshold, save=False, augment=False, verbose=False
        )

        # Extract detections (bounding boxes, class names, and confidences)
        detections = []
        if results and len(results) > 0:
            result = results[0]
            if result.boxes is not None and len(result.boxes.xyxy) > 0:
                boxes = result.boxes

                # Convert tensors to numpy for processing
                xyxy = boxes.xyxy.cpu().numpy()
                conf = boxes.conf.cpu().numpy()
                cls = boxes.cls.cpu().numpy().astype(int)

                # Create detection dictionaries
                for i in range(len(xyxy)):
                    detection = {
                        "xmin": float(xyxy[i][0]),
                        "ymin": float(xyxy[i][1]),
                        "xmax": float(xyxy[i][2]),
                        "ymax": float(xyxy[i][3]),
                        "confidence": float(conf[i]),
                        "class": int(cls[i]),
                        "name": model_yolo.names.get(int(cls[i]), f"class_{int(cls[i])}"),
                    }
                    detections.append(detection)

        return {
            "detections": detections,
            "results": results,  # Keep raw results for annotation
        }
    except Exception as e:
        # If there's an error, return empty structure
        print(f"Error in YOLO detection: {e}")
        return {"detections": [], "results": None}
Tu peux aussi ajouter une fonction qui annote l’image avec des boîtes englobantes et des étiquettes à l’aide de la méthode de tracé intégrée à Ultralytics. Cette fonction sera utile si tu veux renvoyer des images annotées dans la réponse de prédiction.
def get_annotated_image(results: list) -> Image.Image:
    """Get annotated image using Ultralytics built-in plot method."""
    if not results or len(results) == 0:
        raise ValueError("No results provided for annotation")

    result = results[0]
    # Utiliser la méthode de tracé intégrée d’Ultralytics avec une sortie PIL
    return result.plot(pil=True)
Créer un serveur d’inférence HTTP avec FastAPI#
Maintenant que tu disposes de la logique d’inférence YOLO26 principale, tu peux créer une application FastAPI pour la mettre à disposition. Elle comprendra les points de terminaison de vérification de l’état de santé et de prédiction requis par Vertex AI.
Commence par créer src/main.py, ajouter les imports, créer l’application FastAPI et configurer la journalisation pour Vertex AI. Comme Vertex AI traite stderr comme une sortie d’erreur, il est judicieux de rediriger les journaux vers stdout.
# src/main.py

import sys

from fastapi import FastAPI
from loguru import logger

app = FastAPI()

# Configurer le journaliseur
logger.remove()
logger.add(
    sys.stdout,
    colorize=True,
    format="<green>{time:HH:mm:ss}</green> | <level>{message}</level>",
    level=10,
)
logger.add("log.log", rotation="1 MB", level="DEBUG", compression="zip")
Pour assurer une conformité complète avec Vertex AI, définis les points de terminaison requis dans les variables d’environnement et fixe la taille maximale des requêtes. Il est recommandé d’utiliser des points de terminaison Vertex AI privés pour les déploiements en production. Tu bénéficieras ainsi d’une limite de charge utile plus élevée (10 MB au lieu de 1.5 MB pour les points de terminaison publics), ainsi que d’une sécurité et d’un contrôle d’accès robustes.
# Variables d’environnement de Vertex AI
AIP_HTTP_PORT = int(os.getenv("AIP_HTTP_PORT", "8080"))
AIP_HEALTH_ROUTE = os.getenv("AIP_HEALTH_ROUTE", "/health")
AIP_PREDICT_ROUTE = os.getenv("AIP_PREDICT_ROUTE", "/predict")

# Limite de taille des requêtes (10 MB pour les points de terminaison privés, 1.5 MB pour les points publics)
MAX_REQUEST_SIZE = 10 * 1024 * 1024  # 10 MB en octets
Ajoute deux modèles Pydantic pour valider tes requêtes et tes réponses :
# Modèles Pydantic pour les requêtes/réponses
class PredictionRequest(BaseModel):
    instances: list
    parameters: Optional[Dict[str, Any]] = None

class PredictionResponse(BaseModel):
    predictions: list
Ajoute le point de terminaison de vérification de l’état de santé pour vérifier que ton modèle est prêt. C’est important pour Vertex AI : sans vérification dédiée, son orchestrateur enverra des requêtes à des sockets aléatoires et ne pourra pas déterminer si le modèle est prêt pour l’inférence. Ta vérification doit renvoyer 200 OK en cas de réussite et 503 Service Unavailable en cas d’échec :
# Point de terminaison de vérification de l’état de santé
@app.get(AIP_HEALTH_ROUTE, status_code=status.HTTP_200_OK)
def health_check():
    """Health check endpoint for Vertex AI."""
    if not is_model_ready():
        raise HTTPException(status_code=503, detail="Model not ready")
    return {"status": "healthy"}
Tu as maintenant tout ce qu’il faut pour implémenter le point de terminaison de prédiction qui traitera les requêtes d’inférence. Il acceptera un fichier image, effectuera l’inférence et renverra les résultats. Note que l’image doit être encodée en base64, ce qui peut augmenter la taille de la charge utile jusqu’à 33 %.
@app.post(AIP_PREDICT_ROUTE, response_model=PredictionResponse)
async def predict(request: PredictionRequest):
    """Prediction endpoint for Vertex AI."""
    try:
        predictions = []

        for instance in request.instances:
            if isinstance(instance, dict):
                if "image" in instance:
                    image_data = base64.b64decode(instance["image"])
                    input_image = get_image_from_bytes(image_data)
                else:
                    raise HTTPException(status_code=400, detail="Instance must contain 'image' field")
            else:
                raise HTTPException(status_code=400, detail="Invalid instance format")

            # Extract YOLO26 parameters if provided
            parameters = request.parameters or {}
            confidence_threshold = parameters.get("confidence", 0.5)
            return_annotated_image = parameters.get("return_annotated_image", False)

            # Run inference with YOLO26n model
            result = run_inference(input_image, confidence_threshold=confidence_threshold)
            detections_list = result["detections"]

            # Format predictions for Vertex AI
            detections = []
            for detection in detections_list:
                formatted_detection = {
                    "class": detection["name"],
                    "confidence": detection["confidence"],
                    "bbox": {
                        "xmin": detection["xmin"],
                        "ymin": detection["ymin"],
                        "xmax": detection["xmax"],
                        "ymax": detection["ymax"],
                    },
                }
                detections.append(formatted_detection)

            # Build prediction response
            prediction = {"detections": detections, "detection_count": len(detections)}

            # Add annotated image if requested and detections exist
            if (
                return_annotated_image
                and result["results"]
                and result["results"][0].boxes is not None
                and len(result["results"][0].boxes) > 0
            ):
                annotated_image = get_annotated_image(result["results"])
                img_bytes = get_bytes_from_image(annotated_image)
                prediction["annotated_image"] = base64.b64encode(img_bytes).decode("utf-8")

            predictions.append(prediction)

        logger.info(
            f"Processed {len(request.instances)} instances, found {sum(len(p['detections']) for p in predictions)} total detections"
        )

        return PredictionResponse(predictions=predictions)

    except HTTPException:
        # Re-raise HTTPException as-is (don't catch and convert to 500)
        raise
    except Exception as e:
        logger.error(f"Prediction error: {e}")
        raise HTTPException(status_code=500, detail=f"Prediction failed: {e}")
Enfin, ajoute le point d’entrée de l’application pour lancer le serveur FastAPI.
if __name__ == "__main__":
    import uvicorn

    logger.info(f"Starting server on port {AIP_HTTP_PORT}")
    logger.info(f"Health check route: {AIP_HEALTH_ROUTE}")
    logger.info(f"Predict route: {AIP_PREDICT_ROUTE}")
    uvicorn.run(app, host="0.0.0.0", port=AIP_HTTP_PORT)
Tu disposes maintenant d’une application FastAPI complète capable de traiter les requêtes d’inférence YOLO26. Tu peux la tester localement en installant les dépendances et en lançant le serveur, par exemple avec uv.
# Install dependencies
uv pip install -e .

# Run the FastAPI server directly
uv run src/main.py
Pour tester le serveur, tu peux interroger les points de terminaison /health et /predict avec cURL. Place une image de test dans le dossier tests. Ensuite, dans ton terminal, exécute les commandes suivantes :
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
Tu devrais recevoir une réponse JSON contenant les objets détectés. Prévois un court délai lors de ta première requête, car Ultralytics doit récupérer et charger le modèle YOLO26.
2. Étendre l’image Docker d’Ultralytics avec ton application#
Ultralytics fournit plusieurs images Docker que tu peux utiliser comme base pour l’image de ton application. Elles incluent Ultralytics et les bibliothèques CUDA nécessaires ; il te suffit donc d’ajouter ton application par-dessus.
Pour profiter pleinement des modèles Ultralytics YOLO, choisis l’image optimisée pour CUDA afin d’effectuer l’inférence sur GPU. Toutefois, si l’inférence sur CPU suffit pour ta tâche, tu peux aussi économiser des ressources de calcul en choisissant l’image réservée au CPU :
- Dockerfile : image optimisée pour CUDA, destinée à l’entraînement et à l’inférence YOLO26 sur un ou plusieurs GPU.
- Dockerfile-cpu : image réservée au CPU, destinée à l’inférence YOLO26.
Créer une image Docker pour ton application#
Crée un fichier Dockerfile à la racine de ton projet avec le contenu suivant :
# Extends official Ultralytics Docker image for YOLO26
FROM ultralytics/ultralytics:latest

ENV PYTHONUNBUFFERED=1

# Install FastAPI and dependencies
RUN uv pip install --system fastapi[all] uvicorn[standard] loguru

WORKDIR /app
COPY src/ ./src/
COPY pyproject.toml ./

# Install the application package
RUN uv pip install --system -e .

RUN mkdir -p /app/logs
ENV PYTHONPATH=/app/src

# Port for Vertex AI
EXPOSE 8080

# Start the inference server
ENTRYPOINT ["python", "src/main.py"]
Dans cet exemple, l’image Docker officielle d’Ultralytics ultralytics:latest sert d’image de base. Elle contient déjà le modèle YOLO26 et toutes les dépendances nécessaires. Le point d’entrée du serveur est le même que celui utilisé pour tester l’application FastAPI en local.
Créer et tester l’image Docker#
Tu peux maintenant créer l’image Docker à l’aide de la commande suivante :
docker build --platform linux/amd64 -t IMAGE_NAME:IMAGE_VERSION .Remplace IMAGE_NAME et IMAGE_VERSION par les valeurs de ton choix, par exemple yolo26-fastapi:0.1. Note que tu dois créer l’image pour l’architecture linux/amd64 si tu la déploies sur Vertex AI. Le paramètre --platform doit être défini explicitement si tu crées l’image sur un Mac avec Apple Silicon ou toute autre architecture non x86.
Une fois la création de l’image terminée, tu peux la tester localement :
docker run --platform linux/amd64 -p 8080:8080 IMAGE_NAME:IMAGE_VERSIONTon conteneur Docker exécute maintenant un serveur FastAPI sur le port 8080, prêt à recevoir des requêtes d’inférence. Tu peux tester les points de terminaison /health et /predict avec les mêmes commandes cURL qu’auparavant :
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
3. Envoyer l’image Docker vers GCP Artifact Registry#
Pour importer ton modèle conteneurisé dans Vertex AI, tu dois envoyer l’image Docker vers Google Cloud Artifact Registry. Si tu n’as pas encore de dépôt Artifact Registry, tu dois d’abord en créer un.
Créer un dépôt dans Google Cloud Artifact Registry#
Ouvre la page Artifact Registry dans la console Google Cloud. Si tu utilises Artifact Registry pour la première fois, tu devras peut-être d’abord activer son API.

- Sélectionne Create Repository.
- Saisis le nom de ton dépôt. Sélectionne la région souhaitée et conserve les paramètres par défaut pour les autres options, sauf si tu dois les modifier.
Le choix de la région peut influer sur la disponibilité des machines et certaines limites de calcul pour les utilisateurs qui ne disposent pas d’une offre Enterprise. Tu trouveras plus d’informations dans la documentation officielle de Vertex AI : quotas et limites de Vertex AI
- Une fois le dépôt créé, enregistre ton PROJECT_ID, ton emplacement (région) et le nom de ton dépôt dans ton coffre-fort de secrets ou dans le fichier
.env. Tu en auras besoin plus tard pour baliser ton image Docker et l’envoyer vers Artifact Registry.
Authentifier Docker auprès d’Artifact Registry#
Authentifie ton client Docker auprès du dépôt Artifact Registry que tu viens de créer. Exécute la commande suivante dans ton terminal :
gcloud auth configure-docker YOUR_REGION-docker.pkg.devBaliser et envoyer ton image vers Artifact Registry#
Balise l’image Docker et envoie-la vers Google Artifact Registry.
Il est recommandé d’utiliser des balises uniques chaque fois que tu mets à jour ton image. La plupart des services GCP, notamment Vertex AI, s’appuient sur les balises des images pour automatiser le versionnage et la mise à l’échelle ; il est donc conseillé d’utiliser le versionnage sémantique ou des balises basées sur la date.
Balise ton image avec l’URL du dépôt Artifact Registry. Remplace les espaces réservés par les valeurs que tu as enregistrées précédemment.
docker tag IMAGE_NAME:IMAGE_VERSION YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONEnvoie l’image balisée vers le dépôt Artifact Registry.
docker push YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONAttends la fin du processus. Tu devrais maintenant voir l’image dans ton dépôt Artifact Registry.
Pour obtenir des instructions plus détaillées sur l’utilisation des images dans Artifact Registry, consulte la documentation Artifact Registry : Envoyer et récupérer des images.
4. Importer ton modèle dans Vertex AI#
À l’aide de l’image Docker que tu viens d’envoyer, tu peux maintenant importer le modèle dans Vertex AI.
-
Dans le menu de navigation de Google Cloud, accède à Vertex AI > Model Registry. Tu peux aussi rechercher « Vertex AI » dans la barre de recherche située en haut de la console Google Cloud.

-
Clique sur Import.
-
Sélectionne Import as a new model.
-
Sélectionne la région. Tu peux choisir la même région que celle de ton dépôt Artifact Registry, mais ton choix doit dépendre de la disponibilité des types de machines et des quotas dans ta région.
-
Sélectionne Import an existing model container.

-
Dans le champ Container image, accède au dépôt Artifact Registry que tu as créé précédemment et sélectionne l’image que tu viens d’envoyer.
-
Fais défiler jusqu’à la section Environment variables et indique les points de terminaison predict et health, ainsi que le port que tu as défini dans ton application FastAPI.

-
Clique sur Import. Vertex AI mettra plusieurs minutes à enregistrer le modèle et à le préparer pour le déploiement. Tu recevras une notification par e-mail une fois l’importation terminée.
5. Créer un point de terminaison Vertex AI et déployer ton modèle#
Dans la terminologie de Vertex AI, les points de terminaison désignent les modèles déployés, car ils représentent les points de terminaison HTTP auxquels tu envoies les requêtes d’inférence, tandis que les modèles sont les artefacts d’apprentissage automatique entraînés, stockés dans le Model Registry.
Pour déployer un modèle, tu dois créer un point de terminaison dans Vertex AI.
-
Dans le menu de navigation de Vertex AI, accède à Endpoints. Sélectionne la région que tu as utilisée lors de l’importation de ton modèle. Clique sur Create.

-
Saisis le nom du point de terminaison.
-
Pour l’accès, Vertex AI recommande d’utiliser des points de terminaison Vertex AI privés. En plus des avantages en matière de sécurité, tu bénéficies d’une limite de charge utile plus élevée si tu sélectionnes un point de terminaison privé, mais tu devras configurer ton réseau VPC et tes règles de pare-feu pour autoriser l’accès au point de terminaison. Consulte la documentation Vertex AI pour obtenir plus d’instructions sur les points de terminaison privés.
-
Clique sur Continue.
-
Dans la boîte de dialogue des paramètres du modèle, sélectionne le modèle que tu as importé précédemment. Tu peux maintenant configurer le type de machine, la mémoire et les paramètres GPU de ton modèle. Prévois suffisamment de mémoire si tu t’attends à une charge d’inférence élevée afin d’éviter les goulots d’étranglement des E/S et de garantir des performances optimales de YOLO26.
-
Dans le champ Accelerator type, sélectionne le type de GPU que tu veux utiliser pour l’inférence. Si tu ne sais pas quel GPU choisir, tu peux commencer avec le NVIDIA T4, compatible avec CUDA.
N’oublie pas que certaines régions disposent de quotas de calcul très limités. Tu ne pourras donc peut-être pas sélectionner certains types de machines ou certains GPU dans ta région. Si c’est essentiel, change la région de ton déploiement pour une région dont le quota est plus élevé. Tu trouveras plus d’informations dans la documentation officielle de Vertex AI : Quotas et limites de Vertex AI.
- Une fois le type de machine sélectionné, tu peux cliquer sur Continue. À cette étape, tu peux choisir d’activer la surveillance des modèles dans Vertex AI : un service supplémentaire qui suivra les performances de ton modèle et fournira des informations sur son comportement. Cette option est facultative et entraîne des coûts supplémentaires ; fais donc ton choix en fonction de tes besoins. Clique sur Create.
Le déploiement du modèle par Vertex AI prendra plusieurs minutes (jusqu’à 30 minutes dans certaines régions). Tu recevras une notification par e-mail une fois le déploiement terminé.
6. Tester ton modèle déployé#
Une fois le déploiement terminé, Vertex AI te fournira une interface API d’exemple pour tester ton modèle.
Pour tester l’inférence à distance, tu peux utiliser la commande cURL fournie ou créer une autre bibliothèque cliente Python qui enverra des requêtes au modèle déployé. N’oublie pas que tu dois encoder ton image en base64 avant de l’envoyer au point de terminaison /predict.
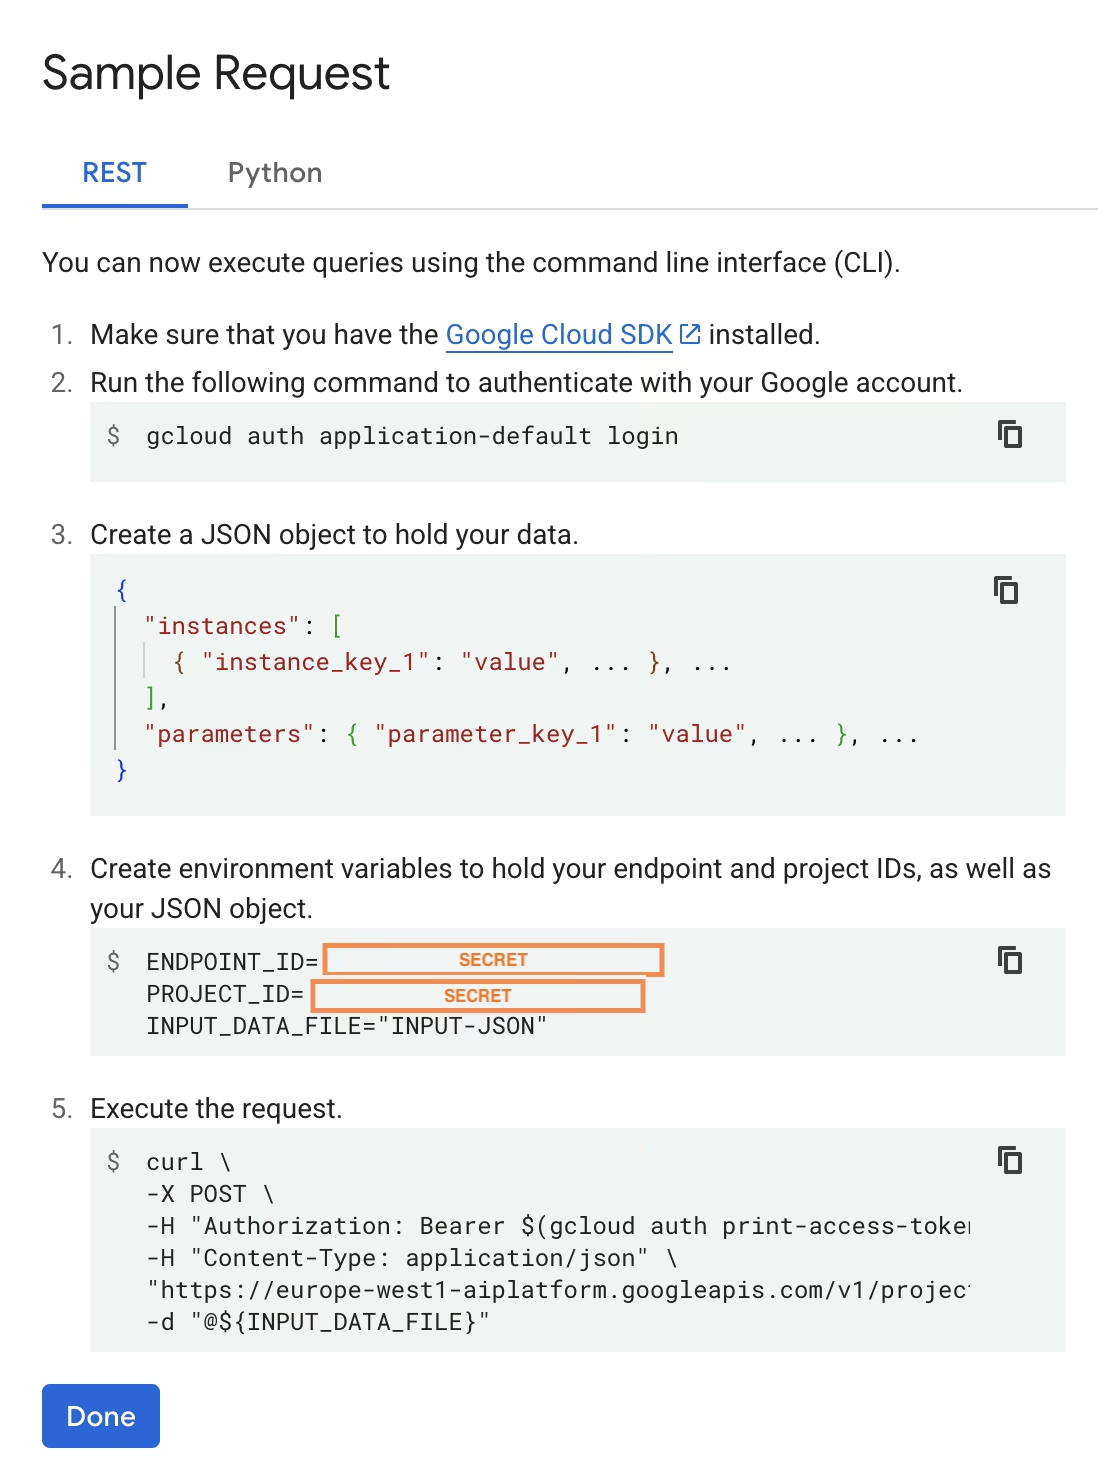
Comme lors des tests locaux, prévois un court délai pour la première requête, car Ultralytics devra récupérer et charger le modèle YOLO26 dans le conteneur en cours d’exécution.
Tu as déployé avec succès un modèle YOLO26 préentraîné avec Ultralytics sur Google Cloud Vertex AI.
FAQ#
Oui ; cependant, tu dois d’abord exporter le modèle dans un format compatible avec Vertex AI, comme TensorFlow, Scikit-learn ou XGBoost. Google Cloud fournit un guide sur l’exécution des modèles
.ptsur Vertex, avec une présentation complète du processus de conversion : Exécuter des modèles PyTorch sur Vertex AI.Note que la configuration obtenue reposera uniquement sur la couche standard de service de Vertex AI et ne prendra pas en charge les fonctionnalités avancées du framework Ultralytics. Comme Vertex AI prend entièrement en charge les modèles conteneurisés et peut les mettre à l’échelle automatiquement en fonction de ta configuration de déploiement, tu peux exploiter toutes les capacités des modèles Ultralytics YOLO sans avoir à les convertir dans un autre format.
FastAPI offre un débit élevé pour les charges de travail d’inférence. La prise en charge de l’asynchrone permet de traiter plusieurs requêtes simultanées sans bloquer le thread principal, ce qui est important pour servir des modèles de vision par ordinateur.
La validation automatique des requêtes et des réponses avec FastAPI réduit les erreurs à l’exécution dans les services d’inférence en production. C’est particulièrement utile pour les API de détection d’objets, où la cohérence du format d’entrée est essentielle.
FastAPI ajoute une surcharge de calcul minimale à ton pipeline d’inférence, laissant davantage de ressources disponibles pour l’exécution du modèle et le traitement des images.
FastAPI prend également en charge SSE (Server-Sent Events), ce qui est utile pour les scénarios d’inférence en continu.
Il s’agit en fait d’une caractéristique de flexibilité de Google Cloud Platform : tu dois sélectionner une région pour chaque service utilisé. Pour déployer un modèle conteneurisé sur Vertex AI, le choix de région le plus important est celui du Model Registry. Il détermine la disponibilité des types de machines et des quotas pour le déploiement de ton modèle.
De plus, si tu souhaites étendre la configuration et stocker les données de prédiction ou les résultats dans Cloud Storage ou BigQuery, tu devras utiliser la même région que celle du Model Registry afin de réduire la latence et de garantir un débit élevé pour l’accès aux données.