Modèle rapide Segment Anything (FastSAM)
Le Fast Segment Anything Model (FastSAM) est une solution en temps réel basée sur un réseau neuronal convolutif (CNN) pour la tâche Segment Anything. Cette tâche vise à segmenter n’importe quel objet dans une image à partir de divers prompts d’interaction possibles. FastSAM réduit considérablement les besoins en calcul tout en conservant des performances compétitives, ce qui en fait un choix pratique pour diverses tâches de vision par ordinateur.
Regarder : Suivi d’objets avec FastSAM et Ultralytics
Architecture du modèle#
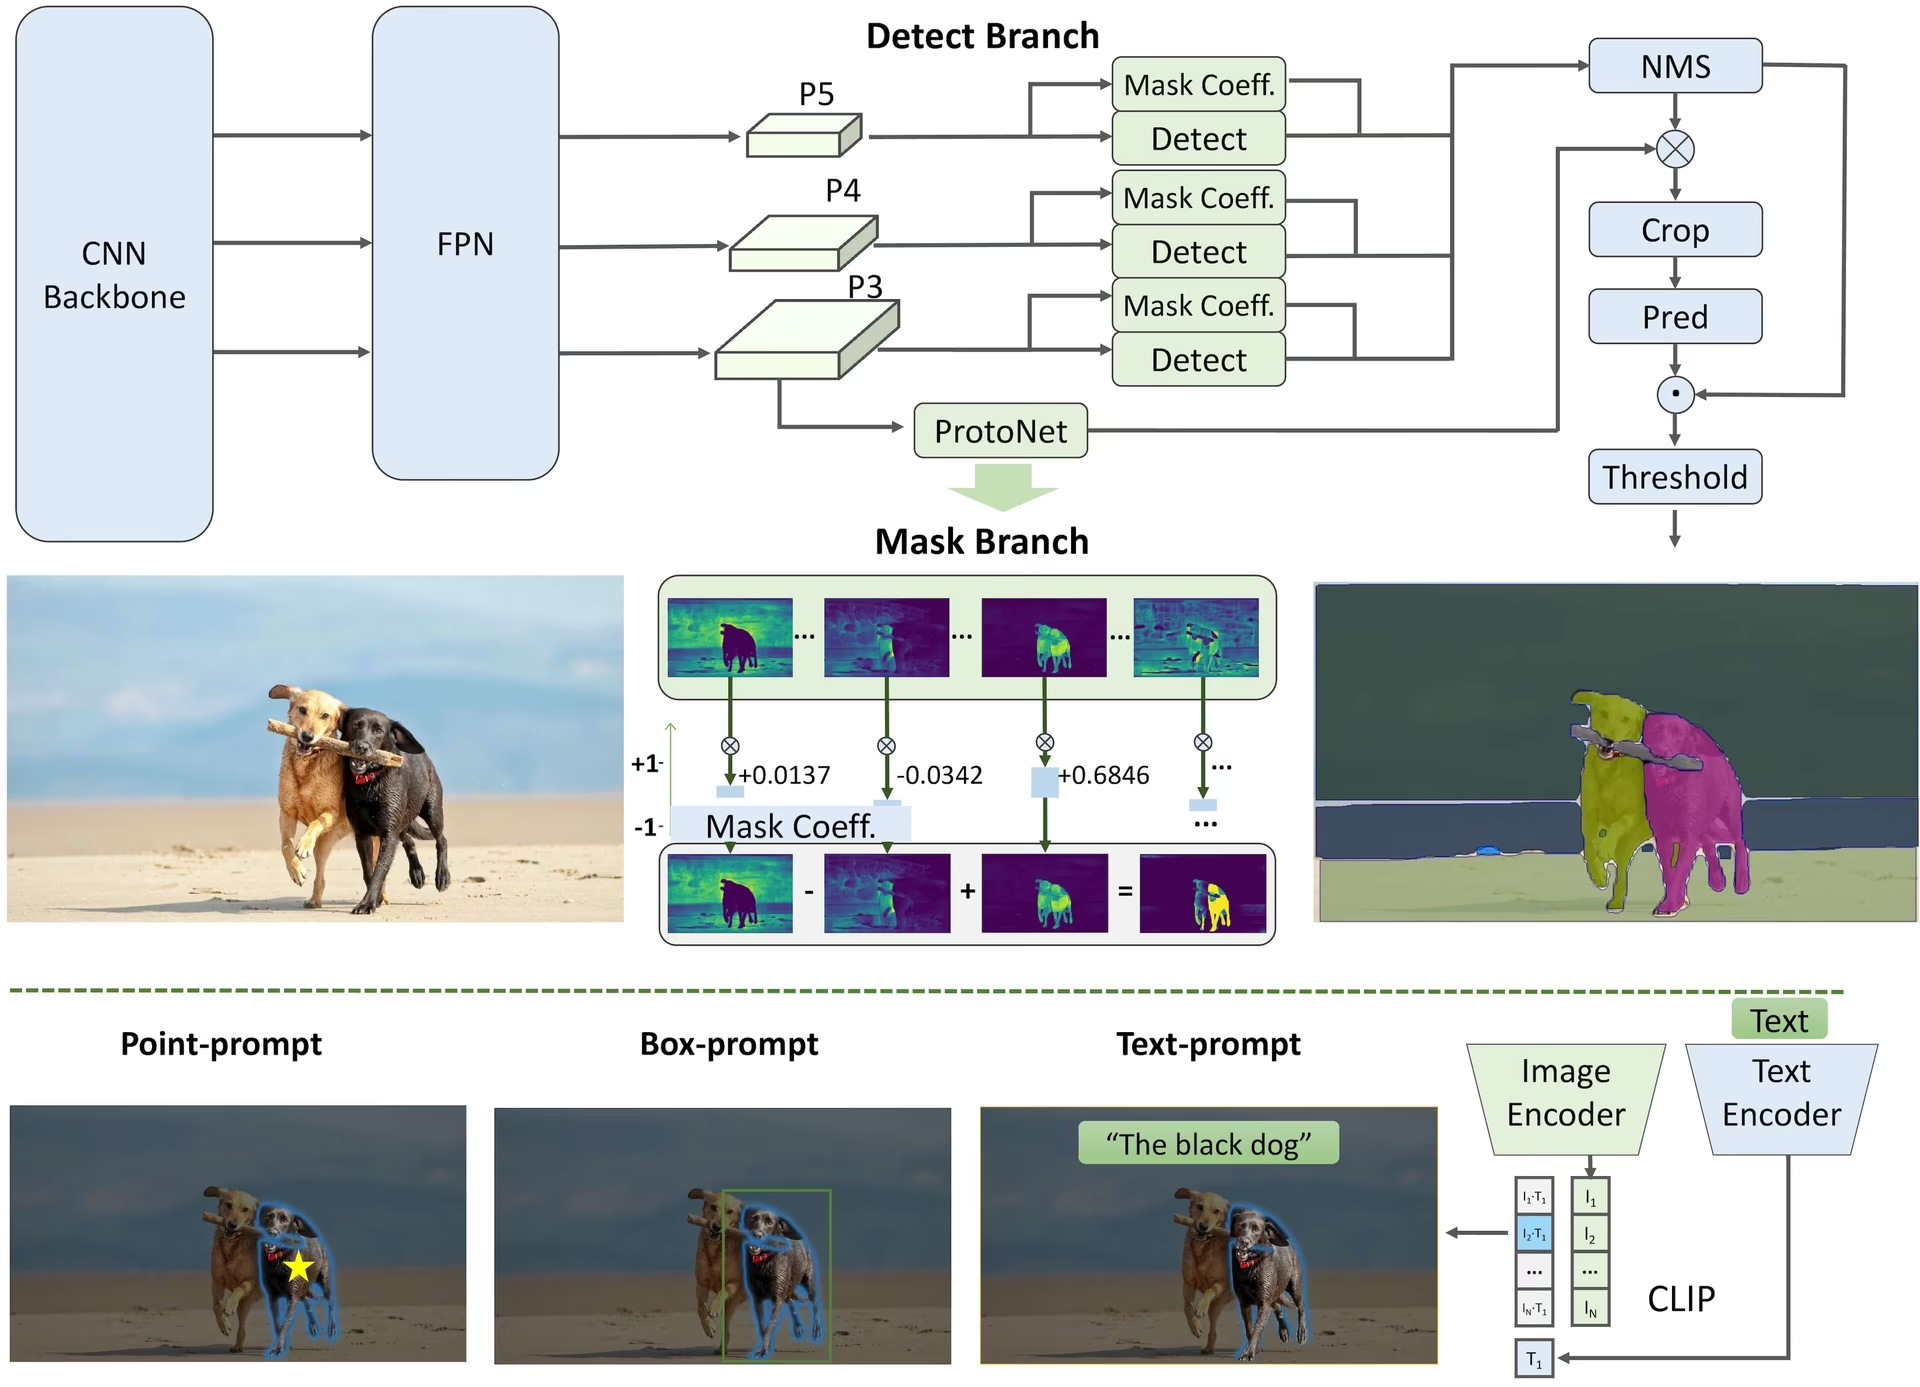
Présentation#
FastSAM est conçu pour remédier aux limites du Segment Anything Model (SAM), un modèle lourd de type Transformer qui nécessite d’importantes ressources de calcul. FastSAM divise la tâche Segment Anything en deux étapes successives : la segmentation de toutes les instances et la sélection guidée par prompt. La première étape utilise YOLOv8-seg pour produire les masques de segmentation de toutes les instances présentes dans l’image. À la deuxième étape, le modèle renvoie la région d’intérêt correspondant au prompt.
Fonctionnalités clés#
-
Solution en temps réel : en tirant parti de l’efficacité de calcul des réseaux neuronaux convolutifs, FastSAM fournit une solution en temps réel pour la tâche Segment Anything, ce qui la rend utile aux applications industrielles nécessitant des résultats rapides.
-
Efficacité et performances : FastSAM réduit considérablement les besoins en calcul et en ressources tout en atteignant des performances comparables à celles de SAM, ce qui permet des applications en temps réel.
-
Segmentation guidée par des prompts : FastSAM peut segmenter n’importe quel objet dans une image à l’aide de divers prompts d’interaction utilisateur, offrant ainsi flexibilité et adaptabilité dans différents scénarios.
-
Basé sur YOLOv8-seg : FastSAM repose sur YOLOv8-seg, un détecteur d’objets doté d’une branche de segmentation d’instances. Il peut ainsi produire efficacement les masques de segmentation de toutes les instances d’une image.
-
Résultats compétitifs sur les benchmarks : pour la tâche de proposition d’objets sur MS COCO, FastSAM obtient des scores élevés à une vitesse nettement supérieure à celle de SAM sur un seul NVIDIA RTX 3090, ce qui démontre son efficacité et ses capacités.
-
Applications pratiques : cette approche offre une solution pratique pour de nombreuses tâches de vision par ordinateur et s’exécute des dizaines, voire des centaines de fois plus vite que les méthodes antérieures de type Segment Anything.
-
Viabilité de la compression des modèles : FastSAM démontre qu’une approche consistant à introduire un a priori artificiel dans la structure peut réduire considérablement les efforts de calcul, ouvrant ainsi de nouvelles possibilités pour les architectures de grands modèles dédiés aux tâches générales de vision.
Modèles disponibles, tâches prises en charge et modes de fonctionnement#
Ce tableau présente les modèles disponibles, leurs poids préentraînés spécifiques, les tâches qu’ils prennent en charge et leur compatibilité avec différents modes d’utilisation, comme l’entraînement, la validation, l’inférence et l’export. Les modes pris en charge sont indiqués par ✅ et les modes non pris en charge par ❌.
| Type de modèle | Poids préentraînés | Tâches prises en charge | Entraînement | Validation | Inférence | Export |
|---|---|---|---|---|---|---|
| FastSAM-s | FastSAM-s.pt | Segmentation d'instances | ❌ | ✅ | ✅ | ✅ |
| FastSAM-x | FastSAM-x.pt | Segmentation d'instances | ❌ | ✅ | ✅ | ✅ |
Comparaison de FastSAM avec YOLO#
Nous comparons ici FastSAM-s aux variantes SAM de Meta et aux modèles de segmentation d’Ultralytics, notamment YOLO26 :
| Modèle | Taille (MB) | Paramètres (M) | Vitesse (CPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s avec backbone YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (11.0x plus petit) | 3.4 (11.4x moins) | 24.8 (945x plus rapide) |
| Ultralytics YOLO11n-seg | 6.2 (12.6x plus petit) | 2.9 (13.4x moins) | 24.3 (964x plus rapide) |
| Ultralytics YOLO26n-seg | 6.7 (11.7x plus petit) | 2.7 (14.4x moins) | 25.2 (930x plus rapide) |
Cette comparaison met en évidence les différences considérables de taille et de vitesse entre les variantes de SAM et les modèles de segmentation YOLO. SAM offre des capacités uniques de segmentation automatique, mais les modèles YOLO, en particulier YOLOv8n-seg, YOLO11n-seg et YOLO26n-seg, sont nettement plus petits, plus rapides et plus efficaces sur le plan des calculs.
Les vitesses de SAM ont été mesurées avec PyTorch, et celles de YOLO avec ONNX Runtime. Les tests ont été réalisés sur un Apple M4 Air de 2025 doté de 16 Go de RAM, avec torch==2.10.0, ultralytics==8.4.31 et onnxruntime==1.24.4. Pour reproduire ce test :
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Profiler SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Profiler FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Profiler les modèles YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Tête sans NMS de YOLO26 ; sans effet pour YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Exemples d'utilisation#
Les modèles FastSAM s’intègrent facilement à tes applications Python. Ultralytics fournit une API Python et des commandes CLI.
Utilisation pour la prédiction#
Pour segmenter une image, utilise la méthode predict comme indiqué ci-dessous :
from ultralytics import FastSAM

# Définir une source d’inférence
source = "path/to/bus.jpg"

# Créer un modèle FastSAM
model = FastSAM("FastSAM-s.pt")  # ou FastSAM-x.pt

# Effectuer une inférence sur une image
everything_results = model(source, device="cpu", retina_masks=True, imgsz=1024, conf=0.4, iou=0.9)

# Exécuter l’inférence avec des bboxes comme invite
results = model(source, bboxes=[439, 437, 524, 709])

# Lancer l’inférence avec des prompts de points
results = model(source, points=[[200, 200]], labels=[1])

# Lancer l’inférence avec des prompts textuels
results = model(source, texts="a photo of a dog")

# Lancer simultanément l’inférence avec des bboxes, des points et des prompts textuels
results = model(source, bboxes=[439, 437, 524, 709], points=[[200, 200]], labels=[1], texts="a photo of a dog")
Cet extrait montre à quel point il est simple de charger un modèle préentraîné et de lancer une prédiction sur une image.
Exécute l’inférence une seule fois sur une image pour obtenir tous les segments results, puis applique plusieurs prompts à ces résultats sans relancer l’inférence.
from ultralytics.models.fastsam import FastSAMPredictor

# Créer FastSAMPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "FastSAM-s.pt", "save": False, "imgsz": 1024}
predictor = FastSAMPredictor(overrides=overrides)

# Tout segmenter
everything_results = predictor("ultralytics/assets/bus.jpg")

# Inférence avec prompt
bbox_results = predictor.prompt(everything_results, bboxes=[[200, 200, 300, 300]])
point_results = predictor.prompt(everything_results, points=[200, 200])
text_results = predictor.prompt(everything_results, texts="a photo of a dog")Tous les objets results renvoyés dans les exemples ci-dessus sont des objets Results qui donnent accès aux masques prédits et à l’image source.
Utilisation pour la validation#
FastSAM ne prend en charge que la détection et la segmentation d’une seule classe d’objets ; il reconnaît et segmente donc tous les objets comme appartenant à la même classe. Lors de la préparation du jeu de données, convertis tous les ID de catégorie d’objet en 0.
La validation du modèle sur un jeu de données peut se faire comme suit :
from ultralytics import FastSAM

# Créer un modèle FastSAM
model = FastSAM("FastSAM-s.pt")  # ou FastSAM-x.pt

# Valider le modèle
results = model.val(data="coco8-seg.yaml")
Suivi d’utilisation#
Pour effectuer le suivi d’objets dans une image, utilise la méthode track comme indiqué ci-dessous :
from ultralytics import FastSAM

# Créer un modèle FastSAM
model = FastSAM("FastSAM-s.pt")  # ou FastSAM-x.pt

# Suivre avec un modèle FastSAM dans une vidéo
results = model.track(source="path/to/video.mp4", imgsz=640)
Utilisation officielle de FastSAM#
FastSAM est également disponible directement dans le dépôt CASIA-LMC-Lab/FastSAM. Voici un bref aperçu des étapes habituelles pour utiliser FastSAM :
Installation#
-
Clone le dépôt FastSAM :
git clone https://github.com/CASIA-LMC-Lab/FastSAM.git -
Crée et active un environnement Conda avec Python 3.9 :
conda create -n FastSAM python=3.9 conda activate FastSAM -
Accède au dépôt cloné et installe les paquets requis :
cd FastSAM pip install -r requirements.txt -
Installe le modèle CLIP :
pip install git+https://github.com/ultralytics/CLIP.git
Exemple d’utilisation#
-
Télécharge un checkpoint du modèle.
-
Utilise FastSAM pour l’inférence. Exemples de commandes :
-
Segmente tous les éléments d’une image :
python Inference.py --model_path ./weights/FastSAM.pt --img_path ./images/dogs.jpg -
Segmente des objets spécifiques à l’aide d’une invite textuelle :
python Inference.py --model_path ./weights/FastSAM.pt --img_path ./images/dogs.jpg --text_prompt "the yellow dog" -
Segmente les objets à l’intérieur d’une boîte englobante (fournis les coordonnées de la boîte au format xywh) :
python Inference.py --model_path ./weights/FastSAM.pt --img_path ./images/dogs.jpg --box_prompt "[570,200,230,400]" -
Segmente les objets à proximité de points spécifiques :
python Inference.py --model_path ./weights/FastSAM.pt --img_path ./images/dogs.jpg --point_prompt "[[520,360],[620,300]]" --point_label "[1,0]"
-
Tu peux également essayer FastSAM grâce à la démo Colab de CASIA-LMC-Lab.
Citations et remerciements#
Nous souhaitons remercier les auteurs de FastSAM pour leurs contributions importantes au domaine de la segmentation d’instances en temps réel :
@misc{zhao2023fast,
      title={Fast Segment Anything},
      author={Xu Zhao and Wenchao Ding and Yongqi An and Yinglong Du and Tao Yu and Min Li and Ming Tang and Jinqiao Wang},
      year={2023},
      eprint={2306.12156},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
L’article original sur FastSAM est disponible sur arXiv. Les auteurs ont rendu leurs travaux publics, et le code source est accessible sur GitHub. Nous saluons leurs efforts pour faire progresser le domaine et rendre leurs travaux accessibles à une communauté plus large.
FAQ#
FastSAM, abréviation de Fast Segment Anything Model, est une solution en temps réel basée sur un réseau neuronal convolutif (CNN), conçue pour réduire les besoins en calcul tout en conservant de hautes performances dans les tâches de segmentation d’objets. Contrairement au Segment Anything Model (SAM), qui utilise une architecture plus lourde fondée sur les Transformer, FastSAM s’appuie sur Ultralytics YOLOv8-seg pour effectuer efficacement la segmentation d’instances en deux étapes : la segmentation de toutes les instances, puis la sélection guidée par prompt.
FastSAM réalise une segmentation en temps réel en séparant la tâche en deux étapes : la segmentation de toutes les instances avec YOLOv8-seg, puis la sélection guidée par prompt. En tirant parti de l’efficacité de calcul des réseaux neuronaux convolutifs, FastSAM réduit considérablement les besoins en calcul et en ressources tout en conservant des performances compétitives. Cette approche en deux étapes permet à FastSAM d’effectuer une segmentation rapide et efficace, adaptée aux applications qui nécessitent des résultats rapides.
FastSAM est adapté à diverses tâches de vision par ordinateur qui exigent des performances de segmentation en temps réel. Ses applications comprennent :
- Automatisation industrielle pour le contrôle et l’assurance qualité
- Analyse vidéo en temps réel pour la sécurité et la surveillance
- Véhicules autonomes pour la détection et la segmentation d’objets
- Imagerie médicale pour les tâches de segmentation précises et rapides
Sa capacité à gérer diverses invites d’interaction utilisateur rend FastSAM adaptable et flexible dans de nombreux scénarios.
Pour utiliser FastSAM en inférence avec Python, tu peux suivre l’exemple ci-dessous :
from ultralytics import FastSAM

# Définir une source d’inférence
source = "path/to/bus.jpg"

# Créer un modèle FastSAM
model = FastSAM("FastSAM-s.pt")  # ou FastSAM-x.pt

# Effectuer une inférence sur une image
everything_results = model(source, device="cpu", retina_masks=True, imgsz=1024, conf=0.4, iou=0.9)

# Exécuter l’inférence avec des bboxes comme invite
results = model(source, bboxes=[439, 437, 524, 709])

# Lancer l’inférence avec des prompts de points
results = model(source, points=[[200, 200]], labels=[1])

# Lancer l’inférence avec des prompts textuels
results = model(source, texts="a photo of a dog")

# Lancer simultanément l’inférence avec des bboxes, des points et des prompts textuels
results = model(source, bboxes=[439, 437, 524, 709], points=[[200, 200]], labels=[1], texts="a photo of a dog")
Pour plus de détails sur les méthodes d’inférence, consulte la section Utilisation de Predict de la documentation.
FastSAM prend en charge plusieurs types d’invites pour guider les tâches de segmentation :
- Invite Everything : génère la segmentation de tous les objets visibles.
- Invite de boîte englobante (BBox) : segmente les objets dans une boîte englobante spécifiée. Une boîte qui ne chevauche aucun masque détecté ne sélectionne rien.
- Invite textuelle : utilise une description textuelle pour segmenter les objets correspondants.
- Invite par point : segmente les objets à proximité de points définis par l’utilisateur.
Cette flexibilité permet à FastSAM de s’adapter à un large éventail de scénarios d’interaction utilisateur et d’être utile dans différentes applications. Pour en savoir plus sur l’utilisation de ces invites, consulte la section Fonctionnalités clés.


Commentaires26
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
qinfendekaizhou
why is the postprocess times is so long
PrashantDixit0(modifié)
@qinfendekaizhou, can you share the reproducible code for it? Or the reference from where u noticed this.
In general, post-process time gets increased because of the post-processes involved to show the results, like
- NMS
- filtering by confidence score/ labels
- Scaling results to the original given inputs
- Number of objects to be annotated,
- Type of annotation, like BB or Segmentation
juliopchile
Will someone try to do a FastSAM for SAM2?
shahedmomenzadeh
Hi, I have a question Can I use the generated bbox cordinates by a yolo detection model like yolov11 as bboxes prompt for FastSAM ?
 Glenn JocherUltralytics
@shahedmomenzadeh yes, you can use YOLO detection model-generated bbox coordinates as prompts for FastSAM. The FastSAM documentation shows examples of passing bbox coordinates directly to the model using either the Python API or CLI. Just ensure your coordinates are in XYXY format as shown in the examples.
ismailwale
How can I make an inference of a video using frame by frame in loop using FastSam ?because I tried multiple times making inference directly with video predictor I constantly running out of memory despite setting stream =True since SAM is trying to keep the memory of 2000 frames of the video at ones . I will appreciate any ideal on how to predict and segment the video as a single frame image at every instance and put everything in a loop.
Similar question win MobileSam
- Glenn JocherUltralytics
@ismailwale to process a video frame by frame and avoid memory overload with FastSAM or MobileSAM, load the video as a frame sequence using a tool like OpenCV. Loop through each frame, run inference on it individually, and clear any cached results to free up memory between frames. For reference on frame-wise usage, consult OpenCV and FastSAM integration. Let me know if you need further clarifications!
Thanks so much for your guide .I appreciate it sir.
llu025
Thank you all for your great work! I am having troubles with prompting with a bounding box, it seems the FastSAM model ignores it and detects objects all over the video frames. This is how I obtain the results:
results = model(
    input_filename,
    device=device,
    imgsz=(736, 1280),
    verbose=False,
    stream=True,
    bboxes=[0, 0, 360, 640],
    retina_masks=True,
    conf=0.4,
    iou=0.9,
)
I also tried with
bboxes=[[0, 0, 360, 640]],without success. The model should detect objects in the top left quadrant of the video, instead it detects everywhere. Also, it oddly does not raise any error or warnings, both withbboxesas list of integers orbboxesas list of lists of integers.- Glenn JocherUltralytics
It seems the bounding box prompts aren't being applied as expected. Ensure the
bboxesformat is correct (e.g.,[[x1, y1, x2, y2]]as a list of lists). Additionally, try using theFastSAMPredictorapproach for more controlled prompt application, as shown in this example. Let me know if the issue persists! Thank you @glenn-jocher for the "prompt" response ;-)
I need to use
stream=Truesince I am working with large videos. I cannot use it coupled withFastSAMPredictor, because it does not support it. My only alternative is to grab frames on my own with OpenCV, is that correct?By the way, in your examples in here
bboxesis passed as a list of integers, I followed those in the beginning. I see in the examples withFastSAMPredictorthat a list of lists is used instead. In any case, I ensured that I was using a list of lists, and it did not work anyway.Here's a minimal example of what I am trying to do, i.e., detecting objects in the top left part of the video:
from ultralytics import FastSAM import os import ffmpeg input_filename = "test_video.mp4" base_name = os.path.splitext(os.path.basename(input_filename))[0] output_filename = os.path.join("output", f"{base_name}.avi") model = FastSAM("models/FastSAM-x.pt") process2 = ( ffmpeg.input( "pipe:", format="rawvideo", pix_fmt="rgb24", s="1280x720", loglevel="-8", ) .output( output_filename, pix_fmt="yuv420p", vcodec="libx264", loglevel="-8", crf=17, ) .overwrite_output() .run_async(pipe_stdin=True) ) results = model( input_filename, device="cuda", imgsz=(736, 1280), verbose=False, stream=True, bboxes=[[0, 0, 360, 640]], retina_masks=True, conf=0.4, iou=0.9, ) for result in results: frame = result.plot() # Save on disk with process2 process2.stdin.write(frame.tobytes()) process2.stdin.close() process2.wait()- Glenn JocherUltralytics
Thank you for the detailed explanation and example. Yes, you're correct—using OpenCV to manually grab frames is a valid and efficient approach, especially when working with
stream=Truefor large videos, as it avoids memory issues. Regardingbboxes, FastSAM expects a list of lists in the format[[x1, y1, x2, y2]]. If this still doesn't work as intended, please ensure your bounding box coordinates are correct and within the frame dimensions. Let us know if you encounter any further issues! I still encounter the same issue. I used
bboxes=[[20, 20, 500, 500]]just to be 100% sure the coordinates are within the the frame dimensions (1280x720), nothing changed. Since I have to grab frames with OpenCV anyway, I will just crop them myself, but I am quite sure this option is not working as intended.- Glenn JocherUltralytics
@llu025 thank you for the update. If you’re certain the
bboxesparameter is properly configured and still not working as intended, cropping frames manually with OpenCV before passing them to the model is indeed a reliable workaround. It may also be worth checking the latest FastSAM updates or reporting this as a potential issue to ensure the bounding box prompt functionality is reviewed. Let us know if you need further assistance!
chongkuiqi
Thanks for your great work! I'm using FastSAM-x with bboxes prompt, the original image shape is [720, 1280], and I set 'imgsz' 1024. However, the results mask shape is [576, 1024], but I remembered in ultralytics-8.2.10, I can get masks with the same shape as the original image. May I ask why this change happened ?
Sorry, I forgot to set 'Retina_masks', problem solved, thanks again.
feiwenxiong
how many boxes are supported in thsi api, it cound only segment 2 boxes at most.
- Glenn JocherUltralytics
@feiwenxiong fastSAM should support multiple boxes. If you're experiencing limitations, please ensure your input format is correct. For further assistance, you might want to check the latest updates or documentation.
YuechengLiu
Thanks the authors for the great work!
I'm using FastSAM-x for instance segmentation (bboxes as the prompt), but I find that the shape of the predicted masks mismatch with the bounding box number. (e.g. the model takes 18 bboxes as input, but the shape of the predicted mask is (17, H, W)) . I tried to set
conf=0.01andiou=0.999, but it doesn't work. How can I solve that? Thanks!- Glenn JocherUltralytics
@YuechengLiu thank you for your kind words! The issue you're experiencing might be due to a mismatch in the bounding box prompts and the segmentation results. Please ensure you're using the latest version of the FastSAM model. If the problem persists, consider checking the input format and the bounding box coordinates. For further assistance, you can refer to the FastSAM documentation: https://docs.ultralytics.com/models/fast-sam/.
Thanks for your kind reply! The bounding boxes I'm using are predicted by yolov10x (result.boxes.xyxy), so I think the input format might be right. I also tried the same bounding boxes for
mobile_sam, and the output dimension is as expected (same as the input dimension). The problem does not always occur. Do you have any idea about that? Thanks!And I'm using the latest version of ultralytics
- Glenn JocherUltralytics
Thanks for confirming you're using the latest version. Given that the issue is intermittent, it might be related to the specific bounding boxes or the image content. Please try running the model with a different set of bounding boxes or images to see if the issue persists. If it does, consider opening an issue on the GitHub repository with detailed information for further investigation.
nguyenvandang1998
Hi! I am using the FastSAM model and trying to obtain information about the bounding box and mask image of the object, but I don't know how to do it. I hope you can help me. Thank you very much!!
Currently, I can obtain information about the bounding box, but I still don't know how to get the mask image!!
- Glenn JocherUltralytics(modifié)
Hi there! 🙌 To extract both bounding boxes and mask images using the FastSAM model, you would typically work with the
resultsobject returned by the model's prediction method. For the bounding boxes, you can access them directly as shown in the documentation or examples provided. For the mask images, since FastSAM is designed for real-time segmentation, the results should also include segmentation masks corresponding to detected objects.Here's a simplified way to access both:
from ultralytics import FastSAM

# Define your image source
source = 'path/to/your/image.jpg'

# Load the FastSAM model (ensure you've chosen the correct model path)
model = FastSAM('FastSAM-s.pt')  # or another appropriate model

# Perform inference
results = model(source)

# Accessing bounding boxes (assuming XYXY format)
boxes = results[0].boxes.xyxy

# Accessing segmentation masks
# The masks are directly associated with detected objects in the results
masks = results[0].masks

# To visualize or further process masks and boxes, you would iterate through these objects
To visualize or save the masks, you'd typically iterate over the
masksobject, and each mask can be processed according to your requirements (e.g., overlaying on the original image or saving as separate mask images).Remember, the exact attribute names (
boxes,masks) and methods might vary based on the model output specification, so it's always good to refer to the specific documentation or example codes for guidance.Hope this helps! Let us know if you have more questions. 😊
2