SAM 2 : modèle Segment Anything 2

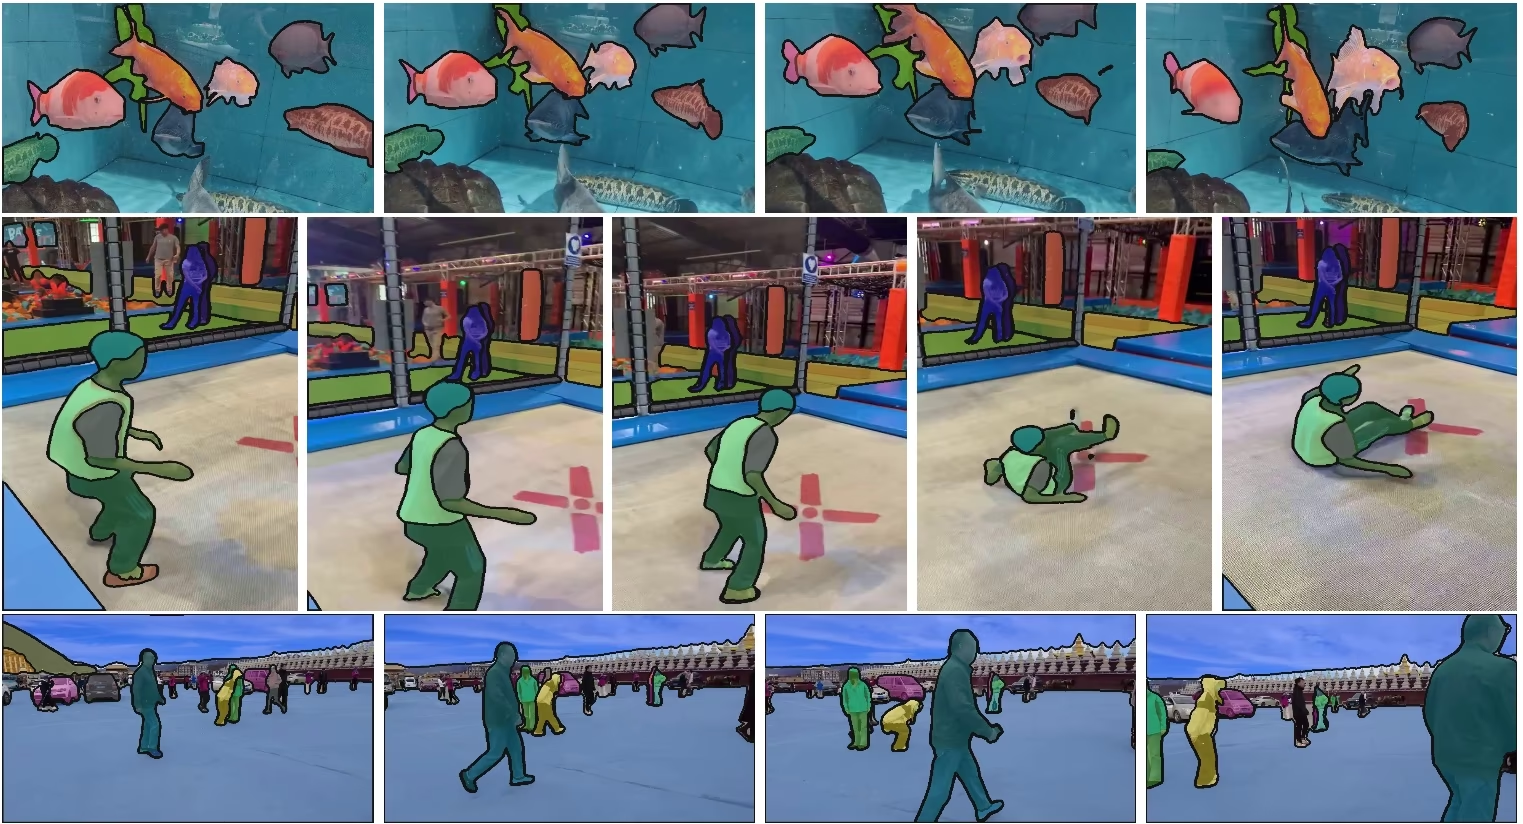
SAM 2, qui succède au modèle Segment Anything (SAM) de Meta, est un modèle unifié de segmentation d’objets guidée par invites, dans les images comme dans les vidéos. Son architecture unique, guidée par invites, prend en charge le traitement en temps réel et la généralisation zéro-shot.
Les modèles SAM 2.1 alimentent la fonction d’annotation intelligente de la plateforme Ultralytics, qui permet la segmentation par clic pour étiqueter rapidement les jeux de données. Consulte le guide d’annotation pour en savoir plus.
Fonctionnalités clés#
À voir : Comment lancer l’inférence avec SAM2 de Meta à l’aide d’Ultralytics | Guide étape par étape
Architecture de modèle unifiée#
SAM 2 regroupe dans un seul modèle les capacités de segmentation d’images et de vidéos. Cette unification simplifie le déploiement et garantit des performances cohérentes sur différents types de médias. Il utilise une interface flexible basée sur des invites, qui permet de spécifier les objets d’intérêt à l’aide de différents types d’invites, comme des points, des boîtes englobantes ou des masques.
Performances en temps réel#
Le modèle atteint des vitesses d’inférence en temps réel et traite environ 44 images par seconde. SAM 2 convient donc aux applications nécessitant un retour immédiat, comme le montage vidéo et la réalité augmentée.
Généralisation sans apprentissage préalable#
SAM 2 peut segmenter des objets qu’il n’a jamais rencontrés, ce qui démontre une forte capacité de généralisation en zero-shot. C’est particulièrement utile dans des domaines visuels variés ou évolutifs où les catégories prédéfinies ne couvrent pas nécessairement tous les objets possibles.
Affinement interactif#
Les utilisateurs peuvent affiner les résultats de segmentation de manière itérative en fournissant des invites supplémentaires, ce qui permet de contrôler précisément la sortie. Cette interactivité est essentielle pour affiner les résultats dans des applications comme l’annotation vidéo ou l’imagerie médicale.
Gestion avancée des défis visuels#
SAM 2 comprend des mécanismes permettant de gérer les problèmes courants de segmentation vidéo, comme l’occlusion et la réapparition des objets. Il utilise un mécanisme de mémoire pour suivre les objets d’une image à l’autre, assurant leur continuité même lorsqu’ils sont temporairement masqués, sortent de la scène ou y réapparaissent.
Pour mieux comprendre l’architecture et les capacités de SAM 2, consulte l’article de recherche sur SAM 2.
Performances et détails techniques#
Selon Meta, SAM 2 surpasse les modèles précédents sur plusieurs métriques :
| Mesure | SAM 2 | Meilleur résultat antérieur |
|---|---|---|
| Segmentation vidéo interactive | Meilleur | - |
| Interactions humaines requises | 3 fois moins | Référence |
| Précision de la segmentation d’images | Amélioré | SAM |
| Vitesse d’inférence | 6 fois plus rapide | SAM |
Architecture du modèle#
Composants principaux#
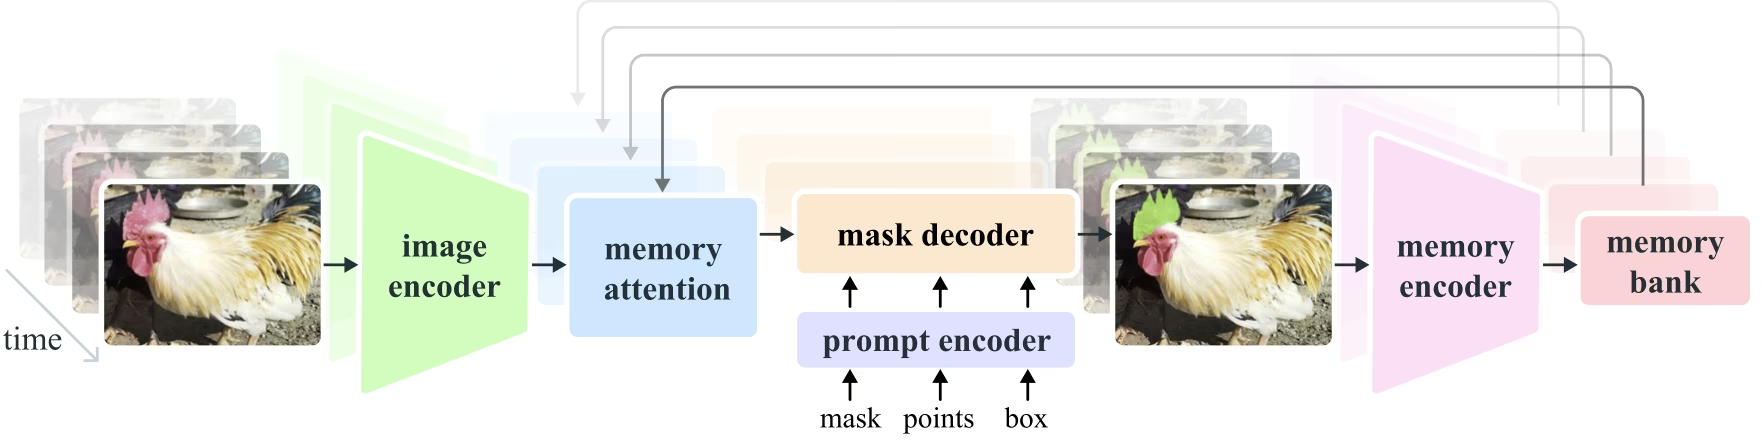
- Encodeur d’images et de vidéos : utilise une architecture fondée sur un transformeur pour extraire des caractéristiques de haut niveau des images et des images vidéo. Ce composant interprète le contenu visuel à chaque instant.
- Encodeur d’invites : traite les invites fournies par l’utilisateur (points, boîtes, masques) pour guider la tâche de segmentation. SAM 2 peut ainsi s’adapter aux entrées de l’utilisateur et cibler des objets spécifiques dans une scène.
- Mécanisme de mémoire : comprend un encodeur de mémoire, une banque de mémoire et un module d’attention mémoire. Ensemble, ces composants stockent et exploitent les informations des images précédentes, ce qui permet au modèle d’assurer un suivi d’objets cohérent au fil du temps.
- Décodeur de masques : génère les masques de segmentation finaux à partir des caractéristiques d’image encodées et des invites. En vidéo, il utilise également le contexte mémoire pour assurer un suivi précis d’une image à l’autre.
Mécanisme de mémoire et gestion des occultations#
Le mécanisme de mémoire permet à SAM 2 de gérer les dépendances temporelles et les occultations dans les données vidéo. À mesure que les objets se déplacent et interagissent, SAM 2 enregistre leurs caractéristiques dans une banque de mémoire. Lorsqu’un objet est occulté, le modèle peut s’appuyer sur cette mémoire pour prédire sa position et son apparence lorsqu’il réapparaît. La tête d’occultation gère spécifiquement les situations où les objets ne sont pas visibles et prédit la probabilité qu’un objet soit occulté.
Résolution de l’ambiguïté multi-masques#
En cas d’ambiguïté (par exemple, des objets qui se chevauchent), SAM 2 peut générer plusieurs prédictions de masques. Cela permet de représenter des scènes complexes dans lesquelles un masque unique ne suffirait pas à représenter l’objet visé.
Jeu de données SA-V#
Le jeu de données SA-V, créé pour l’entraînement de SAM 2, est l’un des jeux de données de segmentation vidéo les plus vastes et les plus diversifiés disponibles. Il comprend :
- Plus de 51 000 vidéos : capturées dans 47 pays, elles couvrent un large éventail de situations réelles.
- Plus de 600 000 annotations de masques : des annotations spatio-temporelles détaillées de masques, appelées « masklets », couvrant des objets entiers et des parties d’objets.
- Échelle du jeu de données : il contient 4,5 fois plus de vidéos et 53 fois plus d’annotations que les plus grands jeux de données de segmentation vidéo précédents.
Benchmarks#
Segmentation d’objets dans les vidéos#
SAM 2 présente les résultats suivants sur les principaux benchmarks de segmentation vidéo :
| Jeu de données | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
Segmentation interactive#
Pour les tâches de segmentation interactive, SAM 2 obtient les résultats suivants :
| Jeu de données | NoC@90 | AUC |
|---|---|---|
| DAVIS Interactive | 1.54 | 0.872 |
Installation#
SAM 2 est inclus dans le package ultralytics. Installe-le à l’aide de la commande suivante ; les poids de SAM 2 sont téléchargés automatiquement lors de la première utilisation.
pip install ultralyticsComment utiliser SAM 2 : polyvalence de la segmentation d’images et de vidéos#
Le tableau suivant détaille les modèles SAM 2 disponibles, leurs poids préentraînés, les tâches prises en charge et leur compatibilité avec différents modes de fonctionnement, comme Training, Validation, Inference et Export.
| Type de modèle | Poids préentraînés | Tâches prises en charge | Entraînement | Validation | Inférence | Export |
|---|---|---|---|---|---|---|
| SAM 2 tiny | sam2_t.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
| SAM 2 small | sam2_s.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
| SAM 2 base | sam2_b.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
| SAM 2 large | sam2_l.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 tiny | sam2.1_t.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 small | sam2.1_s.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 base | sam2.1_b.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 large | sam2.1_l.pt | Segmentation d'instances | ❌ | ❌ | ✅ | ❌ |
Exemples de prédictions de SAM 2#
SAM 2 peut être utilisé pour un large éventail de tâches, notamment le montage vidéo en temps réel, l’imagerie médicale et les systèmes autonomes. Sa capacité à segmenter des données visuelles statiques et dynamiques en fait un outil polyvalent pour les chercheurs et les développeurs.
Segmenter avec des invites#
Utilise des invites pour segmenter des objets spécifiques dans des images ou des vidéos.
from ultralytics import SAM

# Charger un modèle
model = SAM("sam2.1_b.pt")

# Afficher les informations du modèle (facultatif)
model.info()

# Exécuter l’inférence avec des bboxes comme invite
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Exécuter l’inférence avec un seul point
results = model(points=[900, 370], labels=[1])

# Exécuter l’inférence avec plusieurs points
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])

# Exécuter l’inférence avec une invite à plusieurs points par objet
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Exécuter l’inférence avec une invite de points négatifs
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Tout segmenter#
Segmente tout le contenu de l’image ou de la vidéo sans invites spécifiques.
from ultralytics import SAM

# Charger un modèle
model = SAM("sam2.1_b.pt")

# Afficher les informations du modèle (facultatif)
model.info()

# Exécuter l’inférence
model("path/to/video.mp4")- Cet exemple montre comment utiliser SAM 2 pour segmenter tout le contenu d’une image ou d’une vidéo si aucune invite (bboxes/points/masques) n’est fournie.
Segmenter une vidéo et suivre les objets#
Segmente tout le contenu de la vidéo à l’aide d’invites spécifiques et suis les objets.
from ultralytics.models.sam import SAM2VideoPredictor

# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)

# Exécuter l’inférence avec un seul point
results = predictor(source="test.mp4", points=[920, 470], labels=[1])

# Exécuter l’inférence avec plusieurs points
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])

# Exécuter l’inférence avec une invite à plusieurs points par objet
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])

# Exécuter l’inférence avec une invite de points négatifs
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])
Segmentation et suivi interactifs dynamiques#
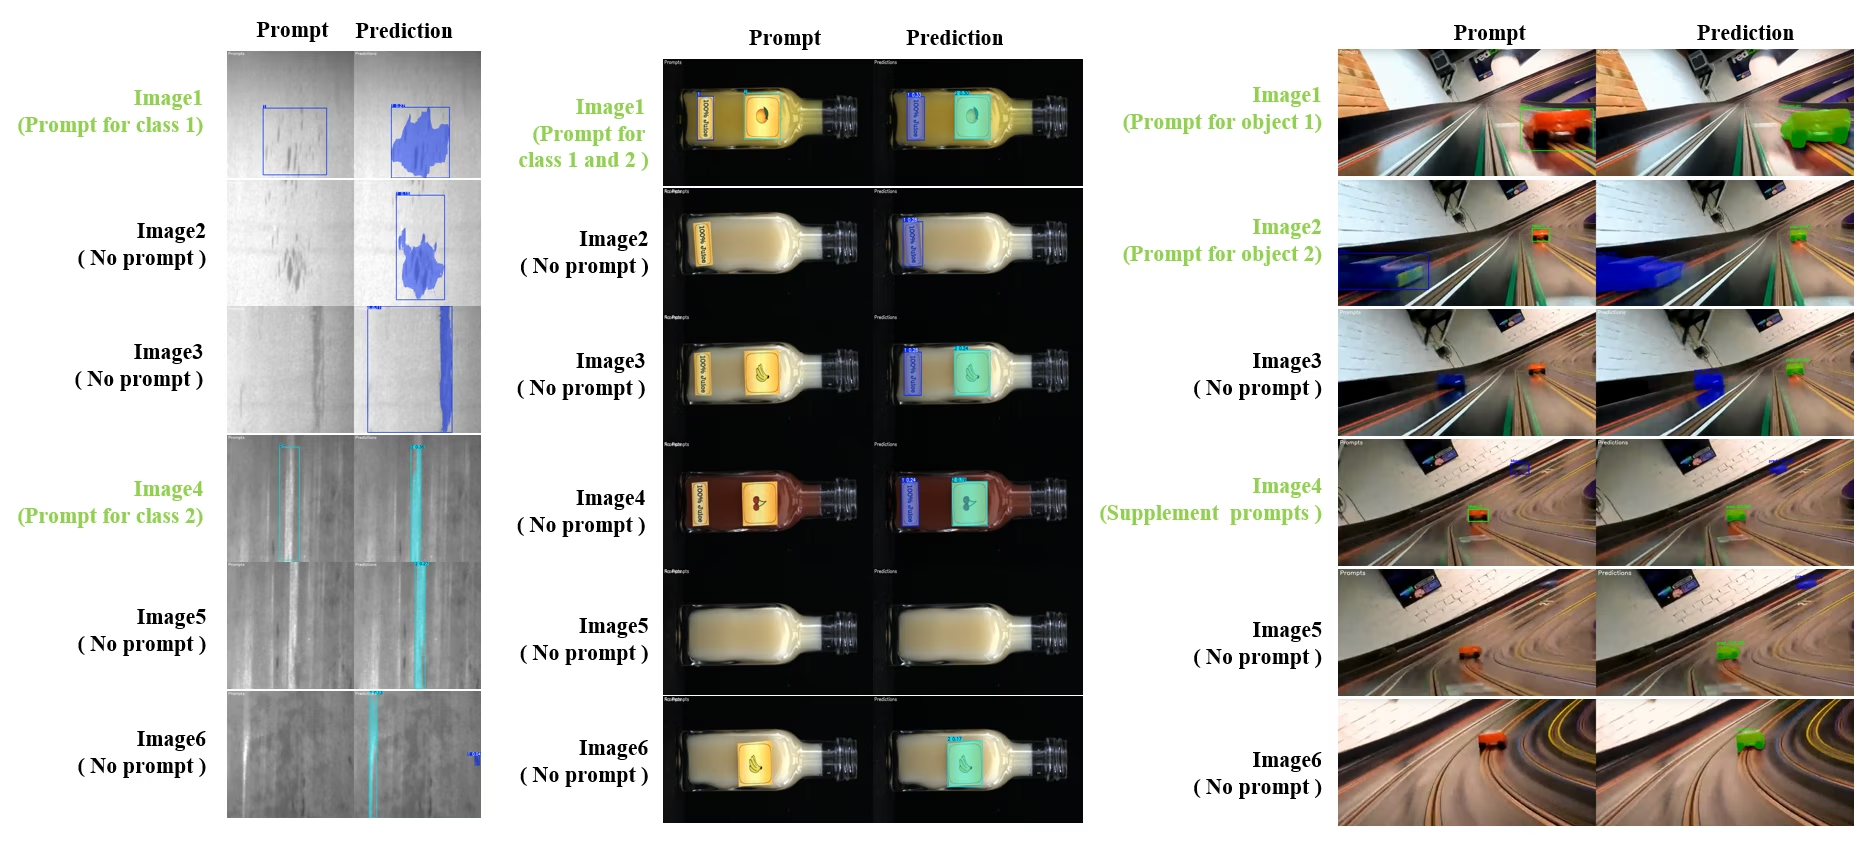
SAM2DynamicInteractivePredictor est une extension de SAM 2 qui ne nécessite aucun entraînement et permet une interaction dynamique avec plusieurs images ainsi que des capacités d’apprentissage continu. Ce prédicteur prend en charge la mise à jour des invites en temps réel et la gestion de la mémoire afin d’améliorer le suivi sur une séquence d’images. Par rapport à SAM 2 d’origine, SAM2DynamicInteractivePredictor reconstruit le flux d’inférence pour tirer le meilleur parti des modèles SAM 2 préentraînés sans nécessiter d’entraînement supplémentaire.
Fonctionnalités clés#
Il apporte trois améliorations :
- Interactif dynamique : ajouter à tout moment des invites pour de nouvelles instances non suivies dans les images ultérieures pendant le traitement vidéo
- Apprentissage continu : ajoute de nouvelles invites pour les instances existantes afin d’améliorer les performances du modèle au fil du temps.
- Prise en charge d’images indépendantes multiples : traite plusieurs images indépendantes (pas nécessairement issues d’une séquence vidéo) avec partage de mémoire et suivi des objets entre les images.
Fonctionnalités principales#
- Flexibilité des invites : accepte les boîtes englobantes, les points et les masques comme invites.
- Gestion de la banque de mémoire : maintient une banque de mémoire dynamique pour stocker l’état des objets d’une image à l’autre.
- Suivi multi-objets : permet de suivre simultanément plusieurs objets à l’aide d’identifiants individuels.
- Mises à jour en temps réel : permet d’ajouter de nouvelles invites pendant l’inférence sans retraiter les images précédentes.
- Traitement indépendant des images : traite des images autonomes avec un contexte mémoire partagé pour assurer la cohérence des objets entre les images.
from ultralytics.models.sam import SAM2DynamicInteractivePredictor

# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)

# Définir une catégorie à l’aide d’une boîte comme invite
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)

# Détecter cet objet précis dans une nouvelle image
results = predictor(source="image2.jpg")

# Ajouter une nouvelle catégorie avec un nouvel identifiant d’objet
results = predictor(
    source="image4.jpg",
    bboxes=[[300, 300, 400, 400]],  # Nouvel objet
    obj_ids=[1],  # Nouvel identifiant d’objet
    update_memory=True,  # Ajouter à la mémoire
)
# Effectuer l’inférence
results = predictor(source="image5.jpg")

# Ajouter des invites d’affinage à la même catégorie pour améliorer les performances
# C’est utile lorsque l’apparence des objets change considérablement
results = predictor(
    source="image6.jpg",
    points=[[150, 150]],  # Point d’affinage
    labels=[1],  # Point positif
    obj_ids=[1],  # Même ID d’objet
    update_memory=True,  # Mettre à jour la mémoire avec de nouvelles informations
)
# Effectuer l’inférence sur une nouvelle image
results = predictor(source="image7.jpg")SAM2DynamicInteractivePredictor est conçu pour fonctionner avec les modèles SAM 2 et permet d’ajouter et d’affiner des catégories à l’aide de toutes les invites de boîte, de point et de masque prises en charge nativement par SAM 2. Cette fonctionnalité est particulièrement utile dans les situations où des objets apparaissent ou changent au fil du temps, par exemple pour l’annotation vidéo ou les tâches d’édition interactive.
Arguments#
| Nom | Valeur par défaut | Type de données | Description |
|---|---|---|---|
max_obj_num | 3 | int | Nombre maximal de catégories prédéfini |
update_memory | False | bool | Indique s’il faut mettre à jour la mémoire avec de nouvelles invites |
obj_ids | None | List[int] | Liste des ID d’objets correspondant aux invites |
Cas d’utilisation#
SAM2DynamicInteractivePredictor est idéal pour :
- Les workflows d’annotation vidéo où de nouveaux objets apparaissent au cours de la séquence
- L’édition vidéo interactive nécessitant l’ajout et l’affinage d’objets en temps réel
- Les applications de surveillance nécessitant le suivi d’objets dynamiques
- L’imagerie médicale pour suivre des structures anatomiques au fil de séries temporelles
- Les systèmes autonomes nécessitant une détection et un suivi adaptatifs des objets
- Les jeux de données multi-images pour assurer une segmentation cohérente des objets sur des images indépendantes
- L’analyse de collections d’images où les objets doivent être suivis dans différentes scènes
- La segmentation inter-domaines tirant parti de la mémoire issue de contextes d’image variés
- L’annotation semi-automatique pour créer efficacement des jeux de données avec un minimum d’intervention manuelle
Comparaison de SAM et YOLO#
Nous comparons ici les modèles SAM 2 de Meta, y compris la plus petite variante SAM2-t, aux modèles de segmentation d’Ultralytics, notamment YOLO26 :
| Modèle | Taille (MB) | Paramètres (M) | Vitesse (CPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s avec le réseau de base YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (11.0x plus petit) | 3.4 (11.4x moins) | 24.8 (945x plus rapide) |
| Ultralytics YOLO11n-seg | 6.2 (12.6x plus petit) | 2.9 (13.4x moins) | 24.3 (964x plus rapide) |
| Ultralytics YOLO26n-seg | 6.7 (11.7x plus petit) | 2.7 (14.4x moins) | 25.2 (930x plus rapide) |
Cette comparaison met en évidence les différences considérables de taille et de vitesse entre les variantes de SAM et les modèles de segmentation YOLO. SAM offre des capacités uniques de segmentation automatique, mais les modèles YOLO, en particulier YOLOv8n-seg, YOLO11n-seg et YOLO26n-seg, sont nettement plus petits, plus rapides et plus efficaces sur le plan des calculs.
Les vitesses de SAM ont été mesurées avec PyTorch, et celles de YOLO avec ONNX Runtime. Les tests ont été réalisés sur un Apple M4 Air de 2025 doté de 16 Go de RAM, avec torch==2.10.0, ultralytics==8.4.31 et onnxruntime==1.24.4. Pour reproduire ce test :
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Profiler SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Profiler FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Profiler les modèles YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Tête sans NMS de YOLO26 ; sans effet pour YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Annotation automatique : création efficace de jeux de données#
L’annotation automatique associe SAM 2 à un modèle de détection préentraîné afin de générer rapidement des jeux de données de segmentation, sans étiquetage manuel intensif. Ultralytics Platform propose également l’annotation automatique dans le navigateur avec des modèles de vision hébergés ; compare leur précision de détection, leur coût et leur vitesse dans le classement VLM.
Comment effectuer une annotation automatique avec SAM 2#
Regarder : Annotation automatique avec Segment Anything 2 de Meta à l’aide d’Ultralytics | Étiquetage des données
Pour annoter automatiquement ton jeu de données avec un détecteur YOLO26x et SAM 2, suis cet exemple :
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
data | str | obligatoire | Chemin vers le répertoire contenant les images à annoter ou à segmenter. |
det_model | str | 'yolo26x.pt' | Chemin vers le modèle de détection YOLO pour la détection initiale des objets. |
sam_model | str | 'sam_b.pt' | Chemin vers le modèle SAM pour la segmentation (prend en charge les poids SAM, SAM 2, MobileSAM et SAM 3). |
device | str | '' | Périphérique de calcul (par exemple, 'cuda:0', 'cpu' ou '' pour la détection automatique du périphérique). |
conf | float | 0.25 | Seuil de confiance de détection YOLO pour filtrer les détections peu fiables. |
iou | float | 0.5 | Seuil IoU pour la suppression non maximale afin de filtrer les boîtes qui se chevauchent. |
imgsz | int | 640 | Taille d’entrée pour le redimensionnement des images (arrondie au multiple de 32 supérieur si nécessaire). |
max_det | int | 300 | Nombre maximal de détections par image pour limiter l’utilisation de la mémoire. |
classes | list[int] | None | Liste des indices de classes à détecter (par exemple, [0, 1] pour personne et vélo). |
output_dir | str | None | Répertoire d’enregistrement des annotations (par défaut : répertoire frère de <data>_auto_annotate_labels). |
Cette fonction transforme un dossier d’images non annotées en jeu de données de segmentation avec un minimum d’effort manuel.
Limites#
Malgré ses atouts, SAM 2 présente certaines limites :
- Stabilité du suivi : SAM 2 peut perdre la trace des objets au cours de séquences prolongées ou lors de changements importants de point de vue.
- Confusion entre objets : le modèle peut parfois confondre des objets d’apparence similaire, notamment dans les scènes encombrées.
- Efficacité avec plusieurs objets : l’efficacité de la segmentation diminue lorsque plusieurs objets sont traités simultanément, en raison de l’absence de communication entre eux.
- Précision des détails : le modèle peut manquer des détails fins, en particulier avec des objets en mouvement rapide. Des invites supplémentaires peuvent atténuer partiellement ce problème, mais la fluidité temporelle n’est pas garantie.
Citations et remerciements#
Si tu utilises SAM 2 dans tes travaux de recherche ou de développement, cite-le à l’aide de la référence suivante :
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
Nous remercions Meta AI d’avoir mis ce modèle et ce jeu de données à la disposition de la communauté de l’IA.
FAQ#
SAM 2, le successeur de Segment Anything Model (SAM) de Meta, est un modèle unifié guidé par des prompts pour segmenter des objets dans des images et des vidéos. SAM 2 offre plusieurs améliorations par rapport au SAM original, notamment :
- Architecture de modèle unifiée : combine les capacités de segmentation d’images et de vidéos dans un seul modèle.
- Performances en temps réel : traite environ 44 images par seconde, ce qui le rend adapté aux applications nécessitant un retour immédiat.
- Généralisation en zero-shot : segmente des objets qu’il n’a jamais rencontrés, ce qui est utile dans divers domaines visuels.
- Affinage interactif : permet aux utilisateurs d’affiner les résultats de segmentation de façon itérative en fournissant des invites supplémentaires.
- Gestion avancée des difficultés visuelles : gère les difficultés courantes de la segmentation vidéo, comme l’occultation et la réapparition des objets.
Pour en savoir plus sur l’architecture et les capacités de SAM 2, consulte l’article de recherche sur SAM 2.
SAM 2 prend en charge la segmentation vidéo en temps réel grâce à son interface guidée par des prompts et à son inférence rapide. Voici un exemple simple :
Segmenter avec des invitesUtilise des invites pour segmenter des objets spécifiques dans des images ou des vidéos.
from ultralytics import SAM

# Charger un modèle
model = SAM("sam2_b.pt")

# Afficher les informations du modèle (facultatif)
model.info()

# Segmenter à l’aide d’une invite de boîte englobante
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Segmenter à l’aide d’une invite de point
results = model("path/to/image.jpg", points=[150, 150], labels=[1])
Pour une présentation plus complète de son utilisation, consulte la section Comment utiliser SAM 2.
SAM 2 est entraîné sur le jeu de données SA-V, l’un des jeux de données de segmentation vidéo les plus vastes et diversifiés disponibles. Le jeu de données SA-V comprend :
- Plus de 51 000 vidéos : capturées dans 47 pays, elles couvrent un large éventail de situations réelles.
- Plus de 600 000 annotations de masques : des annotations spatio-temporelles détaillées de masques, appelées « masklets », couvrant des objets entiers et des parties d’objets.
- Échelle du jeu de données : il contient 4,5 fois plus de vidéos et 53 fois plus d’annotations que les plus grands jeux de données précédents, offrant une diversité et une complexité sans précédent.
Ce jeu de données permet à SAM 2 d’obtenir de solides résultats sur les principaux benchmarks de segmentation vidéo et améliore ses capacités de généralisation en zero-shot.
SAM 2 inclut un mécanisme de mémoire pour gérer les dépendances temporelles et les occultations dans les données vidéo. Ce mécanisme de mémoire comprend :
- Encodeur de mémoire et banque mémoire : stocke les caractéristiques des images précédentes.
- Module d’attention mémoire : utilise les informations stockées pour assurer un suivi cohérent des objets au fil du temps.
- Tête d’occultation : traite spécifiquement les situations où les objets ne sont pas visibles et prédit la probabilité qu’un objet soit occulté.
Ce mécanisme garantit la continuité même lorsque les objets sont temporairement masqués ou quittent la scène avant d’y réapparaître. Pour en savoir plus, consulte la section Mécanisme de mémoire et gestion des occultations.
Les modèles SAM 2, comme SAM2-t et SAM2-b de Meta, offrent de puissantes capacités de segmentation en zero-shot, mais sont nettement plus volumineux et plus lents que les modèles YOLO. Par exemple, YOLO26n-seg est environ 24 fois plus petit et plus de 1145 fois plus rapide que SAM2-b sur CPU. SAM 2 excelle dans les scénarios polyvalents de segmentation pilotée par invites et en zero-shot, tandis que YOLO26 est optimisé pour la vitesse, l’efficacité et les applications en temps réel grâce à une inférence de bout en bout sans NMS, ce qui le rend mieux adapté au déploiement dans des environnements aux ressources limitées.


Commentaires150
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(modifié)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(modifié)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(modifié)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(modifié)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.