Dataset Caltech-256#
Il dataset Caltech-256 è un benchmark classico di classificazione delle immagini composto da 30.607 immagini distribuite in 256 categorie di oggetti, più una classe di sfondo. Ogni categoria contiene almeno 80 immagini di oggetti del mondo reale — animali, veicoli, oggetti domestici e persone — rendendolo un successore più ampio e impegnativo di Caltech-101 per i modelli di riconoscimento degli oggetti.
Esplora Caltech-256 su Ultralytics Platform per visualizzare in anteprima i campioni, esaminare le statistiche del dataset e clonarlo per l'addestramento.
Caltech-256 viene fornito senza una suddivisione predefinita tra addestramento e convalida. I comandi di addestramento riportati di seguito lo suddividono automaticamente in 80% per l'addestramento e 20% per la convalida, quindi non è necessaria alcuna preparazione manuale.
Funzionalità principali#
- Caltech-256 contiene 30.607 immagini a colori distribuite in 256 categorie di oggetti, più una classe di sfondo
257.clutter(257 cartelle di classi in totale). - Le categorie comprendono un'ampia varietà di oggetti del mondo reale, tra cui animali, veicoli, oggetti domestici e persone.
- Ogni categoria contiene almeno 80 immagini, mentre quella più numerosa ne contiene fino a circa 800, quindi le dimensioni delle classi sono sbilanciate.
- Le immagini hanno dimensioni e risoluzioni variabili.
- Caltech-256 è ampiamente utilizzato per valutare le prestazioni degli algoritmi di classificazione delle immagini e riconoscimento degli oggetti.
Struttura del dataset#
Caltech-256 è distribuito in 257 cartelle — una per classe, con 256 categorie di oggetti più una classe di sfondo 257.clutter — senza una suddivisione predefinita tra addestramento e convalida. Quando avvii l'addestramento, Ultralytics suddivide automaticamente le immagini, consentendo ai modelli di eseguire l'addestramento su tutte le 257 classi senza alcuna configurazione manuale:
- Classi: 257 (256 categorie di oggetti + 1 sfondo)
- Immagini totali: 30.607
- Suddivisione addestramento/convalida: automatica 80% / 20% (≈24.385 per l'addestramento, ≈6.222 per la convalida)
- Immagini per classe: almeno 80 (sbilanciate, fino a circa 800)
Applicazioni#
Il dataset Caltech-256 è ampiamente utilizzato per addestrare e valutare modelli di classificazione delle immagini e riconoscimento degli oggetti, comprese le reti neurali convoluzionali (CNNs) e le macchine a vettori di supporto (SVMs). L'elevato numero di categorie e le immagini di alta qualità lo rendono un benchmark popolare per la ricerca e la prototipazione nell'ambito del machine learning e della visione artificiale.
Utilizzo#
Addestra un modello YOLO su Caltech-256 per 100 epoche con una dimensione delle immagini pari a 416. Per l'elenco completo degli argomenti disponibili, consulta la pagina Addestramento e la guida all'attività di classificazione delle immagini.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech256", epochs=100, imgsz=416)
Immagini ed esempi di annotazioni#
Il dataset Caltech-256 contiene immagini a colori di alta qualità raffiguranti vari oggetti e offre un dataset ben strutturato per le attività di classificazione delle immagini. Ecco alcuni esempi di immagini del dataset (attribuzione):
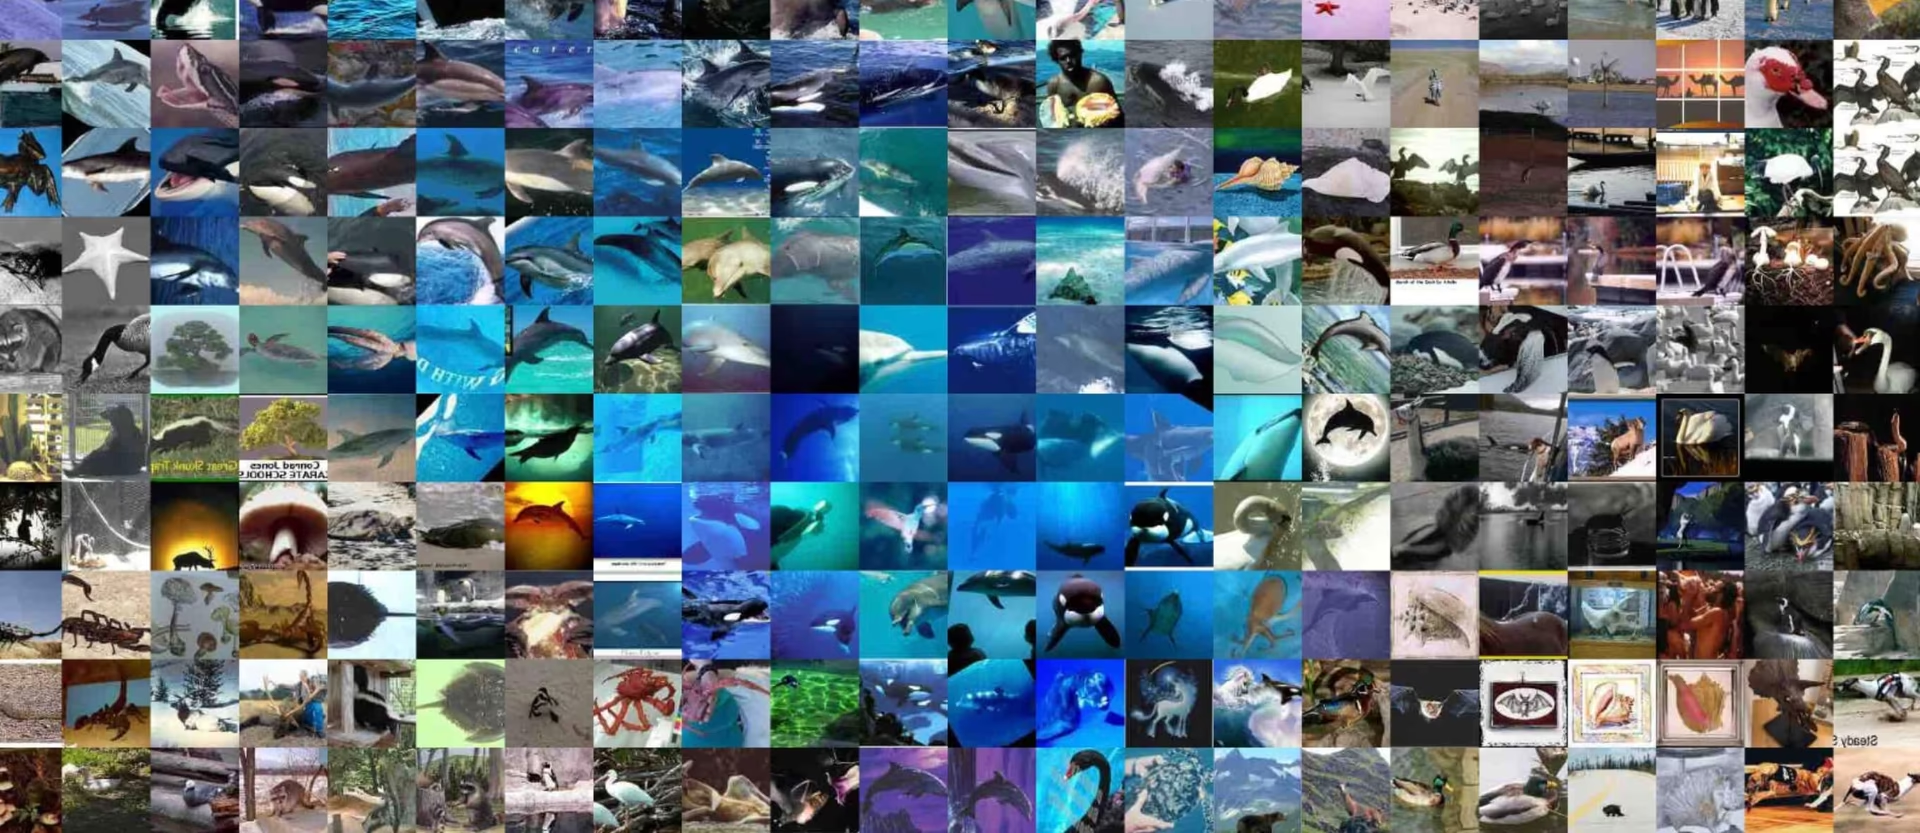
I campioni mostrano la diversità e la complessità degli oggetti nel dataset Caltech-256, evidenziando il valore di un dataset variegato per l'addestramento di modelli robusti di riconoscimento degli oggetti.
Citazioni e ringraziamenti#
Se utilizzi il dataset Caltech-256 nel tuo lavoro di ricerca o sviluppo, cita il seguente articolo:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Desideriamo ringraziare Gregory Griffin, Alex Holub e Pietro Perona per aver creato e mantenuto il dataset Caltech-256 come risorsa preziosa per la comunità di ricerca nel campo del machine learning e della visione artificiale. Per ulteriori informazioni sul dataset Caltech-256 e sui suoi creatori, visita il sito web del dataset Caltech-256.
FAQ#
Il dataset Caltech-256 è ampiamente utilizzato per addestrare e valutare come benchmark modelli di classificazione delle immagini e riconoscimento degli oggetti. Contiene 30.607 immagini distribuite in 256 categorie di oggetti, più una classe di sfondo, e offre un benchmark più ampio e impegnativo rispetto a Caltech-101 per algoritmi come le reti neurali convoluzionali (CNNs) e le macchine a vettori di supporto (SVMs).
Per addestrare un modello Ultralytics YOLO su Caltech-256, utilizza i frammenti di codice riportati di seguito. Il dataset viene scaricato automaticamente al primo utilizzo. Per l'elenco completo degli argomenti, consulta la pagina Addestramento del modello.
Esempio di addestramentofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256 contiene 256 categorie di oggetti più una classe di sfondo
257.clutter, per un totale di 257 cartelle di classi e 30.607 immagini. Quando esegui l'addestramento con Ultralytics, il modello apprende tutte le 257 classi. Ogni categoria contiene almeno 80 immagini, ma le dimensioni delle classi sono sbilanciate: quella più numerosa ne contiene fino a circa 800.Caltech-256 non dispone di una suddivisione predefinita. La prima volta che esegui l'addestramento, Ultralytics lo suddivide automaticamente in 80% per l'addestramento e 20% per la convalida — circa 24.385 immagini per l'addestramento e 6.222 per la convalida — quindi non devi creare manualmente le suddivisioni. Per controllare personalmente la suddivisione, organizza le immagini nelle cartelle
train/eval/prima dell'addestramento.Sì. Ultralytics Platform ti consente di gestire i dataset, addestrare modelli di classificazione delle immagini e distribuirli senza dover scrivere molto codice. È un modo pratico per eseguire esperimenti con Caltech-256 nel cloud e puoi esplorare altre opzioni nella nostra panoramica dei dataset di classificazione.