Dataset CIFAR-10#
Il dataset CIFAR-10 (Istituto canadese per la ricerca avanzata) è un classico benchmark di classificazione delle immagini, con 60.000 immagini a colori da 32x32 pixel suddivise equamente in 10 classi: aereo, automobile, uccello, gatto, cervo, cane, rana, cavallo, nave e camion. Include una suddivisione predefinita in 50.000 immagini di addestramento e 10.000 di test (6.000 per classe), che lo rende un punto di partenza leggero e ben bilanciato per addestrare e confrontare modelli di classificazione. Per una sfida più granulare, consulta il dataset CIFAR-100.
Esplora CIFAR-10 su Ultralytics Platform per visualizzare esempi, esaminare le statistiche del dataset e clonarlo per l’addestramento.
Guarda: Come addestrare un modello di Classificazione delle immagini con il dataset CIFAR-10 usando Ultralytics YOLO
Funzionalità principali#
- CIFAR-10 contiene 60.000 immagini a colori da 32x32 pixel, suddivise equamente in 10 classi.
- Ogni classe contiene esattamente 6.000 immagini — 5.000 per l’addestramento e 1.000 per il test — quindi il dataset è perfettamente bilanciato.
- Le 10 classi sono: aereo, automobile, uccello, gatto, cervo, cane, rana, cavallo, nave e camion.
- Il dataset include una suddivisione predefinita tra addestramento e test, quindi non è necessaria alcuna suddivisione manuale o automatica.
- CIFAR-10 è un benchmark standard per la ricerca sulla classificazione delle immagini e sul riconoscimento degli oggetti.
Struttura del dataset#
CIFAR-10 include una suddivisione ufficiale predefinita, quindi non è necessaria alcuna suddivisione automatica o manuale:
- Classi: 10 (aereo, automobile, uccello, gatto, cervo, cane, rana, cavallo, nave, camion)
- Immagini totali: 60.000 (a colori, 32x32)
- Set di addestramento: 50.000 immagini (5.000 per classe)
- Set di test: 10.000 immagini (1.000 per classe)
CIFAR-10 non ha una cartella di convalida separata, quindi per impostazione predefinita Ultralytics usa il set di test da 10.000 immagini come set di convalida durante l’addestramento.
Applicazioni#
CIFAR-10 è ampiamente utilizzato per addestrare e valutare modelli di classificazione delle immagini, dalle classiche reti neurali convoluzionali (CNNs) e macchine a vettori di supporto (SVMs) alle moderne architetture profonde. Le dimensioni ridotte delle immagini e le classi bilanciate lo rendono ideale per la sperimentazione rapida, il confronto di nuovi algoritmi e l’insegnamento dei fondamenti della visione artificiale.
Utilizzo#
Addestra un modello YOLO su CIFAR-10 per 100 epoche con una dimensione delle immagini di 32. Per l’elenco completo degli argomenti disponibili, consulta la pagina Training e la guida all’attività di classificazione delle immagini.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-cls.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="cifar10", epochs=100, imgsz=32)
Immagini di esempio e annotazioni#
Il dataset CIFAR-10 contiene immagini a colori di vari oggetti e offre un dataset ben strutturato per le attività di classificazione delle immagini. Ecco alcuni esempi di immagini del dataset:
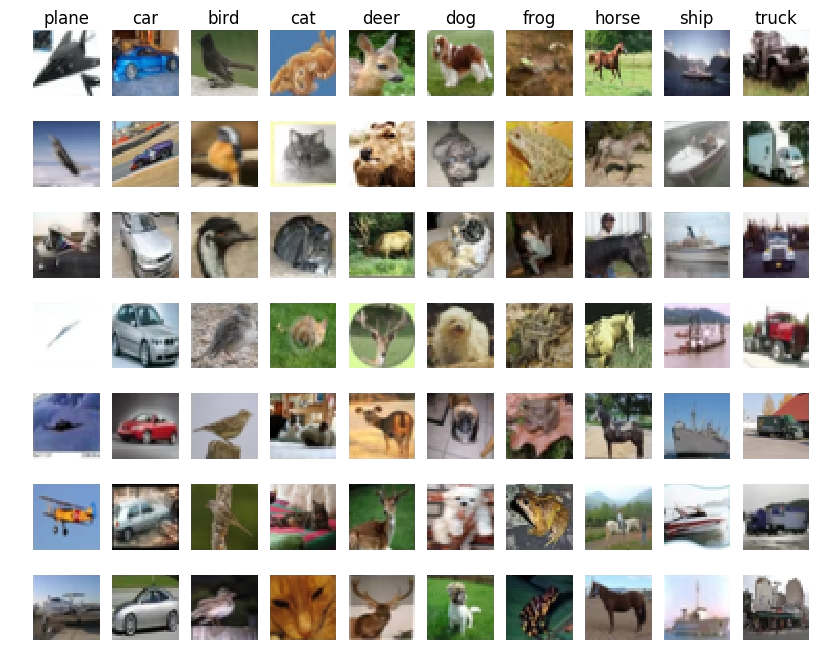
Gli esempi mostrano la varietà degli oggetti nel dataset CIFAR-10, evidenziando l’importanza di un dataset variegato per addestrare modelli robusti di classificazione delle immagini.
Citazioni e ringraziamenti#
Se utilizzi il dataset CIFAR-10 nelle tue attività di ricerca o sviluppo, cita il seguente articolo:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Desideriamo ringraziare Alex Krizhevsky per aver creato e mantenuto il dataset CIFAR-10, una risorsa preziosa per la comunità di ricerca nel campo del machine learning e della visione artificiale. Per ulteriori informazioni sul dataset CIFAR-10 e sul suo creatore, visita il sito web del dataset CIFAR-10.
Domande frequenti#
Il dataset CIFAR-10 è ampiamente utilizzato per addestrare e confrontare modelli di classificazione delle immagini e riconoscimento degli oggetti. Contiene 60.000 immagini a colori da 32x32 pixel distribuite equamente in 10 classi; le dimensioni ridotte e le classi bilanciate lo rendono un benchmark rapido e affidabile per algoritmi come le reti neurali convoluzionali (CNNs) e le macchine a vettori di supporto (SVMs).
Per addestrare un modello Ultralytics YOLO su CIFAR-10, usa gli snippet di codice qui sotto. Il dataset viene scaricato automaticamente al primo utilizzo. Per l’elenco completo degli argomenti, consulta la pagina Training del modello.
Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n-cls.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="cifar10", epochs=100, imgsz=32)CIFAR-10 ha 10 classi — aereo, automobile, uccello, gatto, cervo, cane, rana, cavallo, nave e camion — con esattamente 6.000 immagini ciascuna, per un totale di 60.000 immagini. Le classi sono mutuamente esclusive e perfettamente bilanciate, senza sovrapposizioni tra le categorie.
CIFAR-10 include una suddivisione predefinita in 50.000 immagini di addestramento e 10.000 immagini di test, con esattamente 5.000 immagini di addestramento e 1.000 immagini di test per classe. A differenza dei dataset di classificazione organizzati in cartelle, che Ultralytics suddivide automaticamente, la partizione ufficiale di CIFAR-10 viene mantenuta così com’è e, per impostazione predefinita, il set di test funge da set di convalida durante l’addestramento.
Sì. Ultralytics Platform ti permette di gestire i dataset, addestrare modelli di classificazione delle immagini e distribuirli senza scrivere molto codice. È un modo pratico per eseguire esperimenti con CIFAR-10 nel cloud; puoi scoprire altre opzioni nella nostra panoramica dei dataset di classificazione.