Dataset COCO128#
Introduzione#
Ultralytics COCO128 è un dataset piccolo ma versatile per il rilevamento di oggetti, composto dalle prime 128 immagini del set COCO train 2017. Questo dataset è ideale per testare ed eseguire il debug dei modelli di rilevamento di oggetti o per sperimentare nuovi approcci al rilevamento. Con 128 immagini, è abbastanza piccolo da essere facile da gestire, ma anche abbastanza vario da permettere di testare eventuali errori nelle pipeline di addestramento e fungere da controllo preliminare prima di addestrare su dataset più grandi.
Guarda: Panoramica del dataset COCO di Ultralytics
Questo dataset è pensato per essere utilizzato con Ultralytics Platform e YOLO26.
Struttura del dataset#
COCO128 contiene le prime 128 immagini del set COCO train 2017, etichettate con gli 80 nomi delle classi COCO (71 delle quali compaiono in queste immagini) nel formato di etichettatura YOLO. Le stesse 128 immagini costituiscono sia il set di addestramento sia quello di validazione, mantenendo il dataset leggero per rapidi controlli preliminari:
coco128/
├── images/
│   └── train2017/   # 128 images (used for both train and val)
└── labels/
    └── train2017/
YAML del dataset#
Un file YAML viene utilizzato per definire la configurazione del dataset. Contiene informazioni sui percorsi, le classi e altri dati pertinenti del dataset. Per il dataset COCO128, il file coco128.yaml è mantenuto in https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128 dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco128
# Example usage: yolo train data=coco128.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128 ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128 # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128.zipUtilizzo#
Il dataset COCO128 (7 MB) viene scaricato automaticamente al primo avvio dell'addestramento. Per addestrare un modello YOLO26n su COCO128 per 100 epoche con una dimensione dell'immagine di 640, puoi usare i seguenti frammenti di codice. Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="coco128.yaml", epochs=100, imgsz=640)
Immagini di esempio e annotazioni#
Ecco alcuni esempi di immagini del dataset COCO128 con le relative annotazioni:
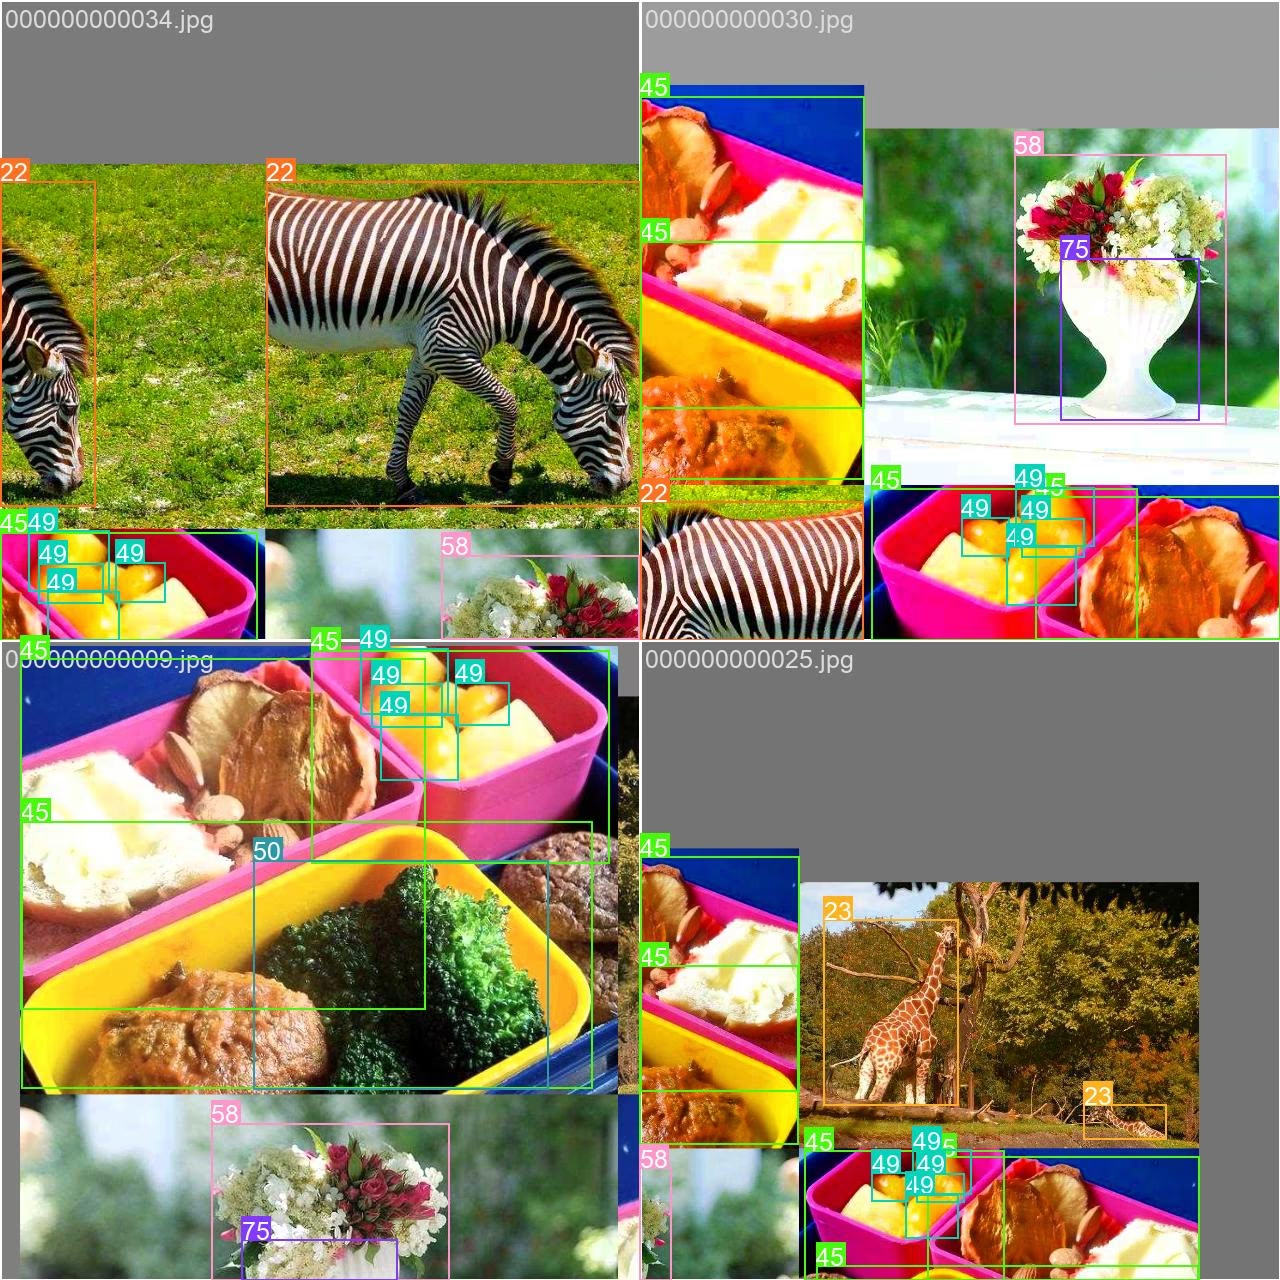
- Immagine a mosaico: questa immagine mostra un batch di addestramento composto da immagini del dataset unite in un mosaico. La creazione di mosaici è una tecnica utilizzata durante l'addestramento che combina più immagini in una sola per aumentare la varietà di oggetti e scene in ogni batch di addestramento. Questo aiuta a migliorare la capacità del modello di generalizzare a oggetti di dimensioni e proporzioni diverse e a contesti differenti.
L'esempio mostra la varietà e la complessità delle immagini nel dataset COCO128 e i vantaggi dell'uso del mosaico durante l'addestramento.
Citazioni e ringraziamenti#
Se utilizzi il dataset COCO nelle tue attività di ricerca o sviluppo, cita il seguente articolo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Desideriamo ringraziare il Consorzio COCO per aver creato e mantenuto questa preziosa risorsa per la comunità della visione artificiale. Per maggiori informazioni sul dataset COCO e sui suoi creatori, visita il sito web del dataset COCO.
Domande frequenti#
Il dataset Ultralytics COCO128 è un sottoinsieme compatto che contiene le prime 128 immagini del dataset COCO train 2017. Viene usato principalmente per testare ed eseguire il debug dei modelli di rilevamento di oggetti, sperimentare nuovi approcci al rilevamento e convalidare le pipeline di addestramento prima di passare a dataset più grandi. Le sue dimensioni gestibili lo rendono ideale per iterazioni rapide, offrendo comunque una diversità sufficiente per essere un caso di test significativo.
Per addestrare un modello YOLO26 sul dataset COCO128, puoi usare Python oppure i comandi CLI. Ecco come:
Esempio di addestramentofrom ultralytics import YOLO # Carica un modello preaddestrato model = YOLO("yolo26n.pt") # Addestra il modello results = model.train(data="coco128.yaml", epochs=100, imgsz=640)Per ulteriori opzioni e parametri di addestramento, consulta la documentazione Addestramento.
Come mostrato nelle immagini di esempio, l'aumento dati mosaico combina più immagini di addestramento in un'unica immagine composita. Questa tecnica offre diversi vantaggi quando si esegue l'addestramento con COCO128:
- Aumenta la varietà di oggetti e contesti in ogni batch di addestramento
- Migliora la generalizzazione del modello con oggetti di dimensioni e proporzioni diverse
- Migliora le prestazioni di rilevamento degli oggetti a scale diverse
- Massimizza l'utilità di un dataset piccolo creando campioni di addestramento più diversificati
Questa tecnica è particolarmente utile per i dataset più piccoli, come COCO128, perché aiuta i modelli ad apprendere caratteristiche più robuste da dati limitati.
Per dimensioni, COCO128 (128 immagini) si colloca tra COCO8 (8 immagini) e il dataset COCO completo (oltre 118.000 immagini):
- COCO8: contiene solo 8 immagini (4 per l'addestramento e 4 per la validazione), ideale per test rapidi ed eseguire il debug
- COCO128: contiene 128 immagini, con un buon equilibrio tra dimensioni e diversità
- COCO completo: contiene oltre 118.000 immagini di addestramento, è completo ma richiede molte risorse
COCO128 offre un buon compromesso: è più vario di COCO8, ma molto più gestibile del dataset COCO completo per la sperimentazione e lo sviluppo iniziale dei modelli.
Sebbene COCO128 sia progettato principalmente per il rilevamento di oggetti, le annotazioni del dataset possono essere adattate ad altre attività di visione artificiale:
- Segmentazione di istanze: usando le maschere di segmentazione fornite nelle annotazioni
- Rilevamento dei keypoint: per immagini che contengono persone con annotazioni dei keypoint
- Transfer learning: come punto di partenza per l'affinamento dei modelli su attività personalizzate
Per attività specializzate come la segmentazione, valuta l'uso di varianti create appositamente, come COCO8-seg, che includono le annotazioni appropriate.