Ottimizzazione dell'inferenza di YOLO con OpenVINO#
Introduzione#
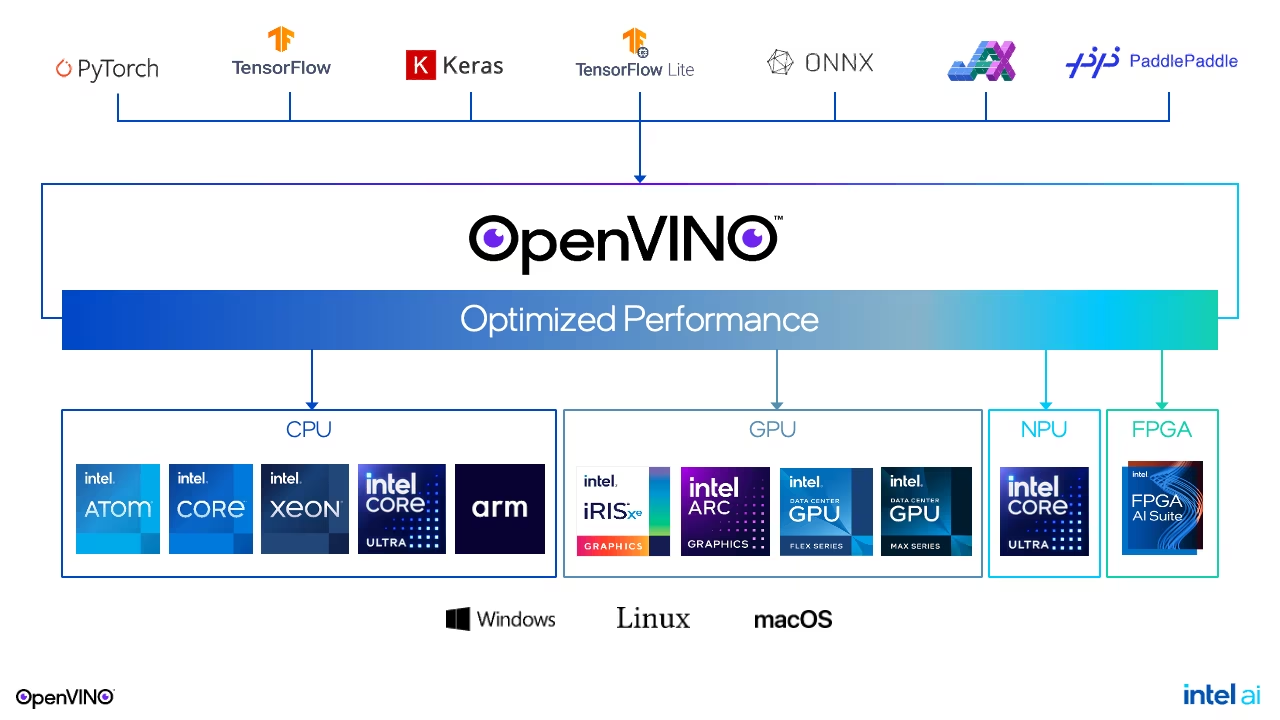
Quando distribuisci modelli di deep learning, in particolare quelli per il rilevamento degli oggetti, come i modelli Ultralytics YOLO, ottenere prestazioni ottimali è fondamentale. Questa guida approfondisce l'uso del toolkit OpenVINO di Intel per ottimizzare l'inferenza, concentrandosi su latenza e throughput. Che tu stia lavorando ad applicazioni consumer o a distribuzioni su larga scala, comprendere e applicare queste strategie di ottimizzazione garantirà l'esecuzione efficiente dei tuoi modelli su vari dispositivi.
Ottimizzazione della latenza#
L'ottimizzazione della latenza è fondamentale per le applicazioni che richiedono una risposta immediata da un singolo modello a fronte di un singolo input, come accade tipicamente negli scenari consumer. L'obiettivo è ridurre al minimo il ritardo tra l'input e il risultato dell'inferenza. Tuttavia, ottenere una latenza bassa richiede un'attenta valutazione, soprattutto quando si eseguono inferenze simultanee o si gestiscono più modelli.
Strategie chiave per ottimizzare la latenza#
- Una sola inferenza per dispositivo: il modo più semplice per ottenere una latenza bassa è limitarsi a una sola inferenza alla volta per dispositivo. Spesso, una maggiore concorrenza aumenta la latenza.
- Sfruttare i sottodispositivi: dispositivi come le CPU multi-socket o le GPU multi-tile possono eseguire più richieste con un aumento minimo della latenza, utilizzando i propri sottodispositivi interni.
- Suggerimenti sulle prestazioni di OpenVINO: usare
ov::LATENCYdi OpenVINO per la proprietàov::performance_modedurante la compilazione del modello semplifica la messa a punto delle prestazioni e offre un approccio indipendente dal dispositivo e a prova di futuro.
Gestione della latenza della prima inferenza#
- Memorizzazione nella cache del modello: per limitare l'impatto dei tempi di caricamento e compilazione del modello sulla latenza, usa la cache del modello quando possibile. Negli scenari in cui non è possibile ricorrere alla cache, in genere le CPU offrono i tempi di caricamento del modello più rapidi.
- Mappatura del modello e lettura: per ridurre i tempi di caricamento, OpenVINO ha sostituito la lettura del modello con la mappatura. Tuttavia, se il modello si trova su un'unità rimovibile o di rete, valuta l'uso di
ov::enable_mmap(false)per tornare alla lettura. - Selezione automatica del dispositivo: questa modalità avvia l'inferenza sulla CPU e passa a un acceleratore non appena è pronto, riducendo senza interruzioni la latenza della prima inferenza.
Ottimizzazione del throughput#
L'ottimizzazione del throughput è fondamentale negli scenari in cui vengono gestite simultaneamente numerose richieste di inferenza, massimizzando l'utilizzo delle risorse senza compromettere in modo significativo le prestazioni delle singole richieste.
Approcci per ottimizzare il throughput#
-
Suggerimenti sulle prestazioni di OpenVINO: un metodo di alto livello e a prova di futuro per migliorare il throughput su diversi dispositivi usando i suggerimenti sulle prestazioni.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Batch e stream espliciti: un approccio più granulare che prevede batch espliciti e l'uso di stream per una messa a punto avanzata delle prestazioni.
Progettazione di applicazioni orientate al throughput#
Per massimizzare il throughput, le applicazioni dovrebbero:
- Elaborare gli input in parallelo, sfruttando appieno le capacità del dispositivo.
- Scomporre il flusso di dati in richieste di inferenza simultanee, pianificate per l'esecuzione parallela.
- Usare l'API asincrona con callback per mantenere l'efficienza ed evitare che il dispositivo resti inattivo.
Esecuzione su più dispositivi#
La modalità multi-dispositivo di OpenVINO semplifica la scalabilità del throughput bilanciando automaticamente le richieste di inferenza tra i dispositivi, senza richiedere la gestione dei dispositivi a livello applicativo.
Miglioramenti delle prestazioni nel mondo reale#
L'implementazione delle ottimizzazioni di OpenVINO con i modelli Ultralytics YOLO può portare a significativi miglioramenti delle prestazioni. Come mostrano i benchmark, gli utenti possono ottenere inferenze fino a 3 volte più veloci sulle CPU Intel, con accelerazioni ancora maggiori possibili sull'intera gamma hardware Intel, comprese GPU integrate, GPU dedicate e NPU.
Ad esempio, quando esegui modelli YOLO26 su CPU Intel Xeon, le versioni ottimizzate con OpenVINO superano costantemente le controparti PyTorch in termini di tempo di inferenza per immagine, senza compromettere la precisione.
Implementazione pratica#
Per esportare e ottimizzare il tuo modello Ultralytics YOLO per OpenVINO, puoi usare la funzionalità export:
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")

# Esporta il modello nel formato OpenVINO
model.export(format="openvino", quantize=16)  # Esporta con precisione FP16
Dopo l'esportazione, puoi eseguire l'inferenza con il modello ottimizzato:
# Carica il modello OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")

# Esegui l'inferenza (Ultralytics compila i modelli OpenVINO con il suggerimento sulle prestazioni LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)Conclusione#
Ottimizzare con OpenVINO i modelli Ultralytics YOLO per latenza e throughput può migliorare significativamente le prestazioni della tua applicazione. Applicando con attenzione le strategie descritte in questa guida, gli sviluppatori possono assicurarsi che i propri modelli vengano eseguiti in modo efficiente e soddisfino i requisiti dei diversi scenari di distribuzione. Ricorda: la scelta tra ottimizzazione della latenza e del throughput dipende dalle esigenze specifiche della tua applicazione e dalle caratteristiche dell'ambiente di distribuzione.
Per informazioni tecniche più dettagliate e gli aggiornamenti più recenti, consulta la documentazione di OpenVINO e il repository Ultralytics YOLO. Queste risorse offrono guide approfondite, tutorial e supporto della community per aiutarti a sfruttare al meglio i tuoi modelli di deep learning.
Assicurarsi che i tuoi modelli raggiungano prestazioni ottimali non significa soltanto modificare le configurazioni: significa comprendere le esigenze della tua applicazione e prendere decisioni consapevoli. Che tu stia ottimizzando per ottenere risposte in tempo reale o per massimizzare il throughput nell'elaborazione su larga scala, la combinazione dei modelli Ultralytics YOLO e OpenVINO offre agli sviluppatori un potente toolkit per distribuire soluzioni di AI ad alte prestazioni.
Domande frequenti#
L'ottimizzazione dei modelli Ultralytics YOLO per una latenza bassa prevede alcune strategie chiave:
- Una sola inferenza per dispositivo: limita le inferenze a una alla volta per dispositivo per ridurre al minimo i ritardi.
- Sfruttare i sottodispositivi: usa dispositivi come le CPU multi-socket o le GPU multi-tile, in grado di gestire più richieste con un aumento minimo della latenza.
- Suggerimenti sulle prestazioni di OpenVINO: usa
ov::LATENCYdi OpenVINO durante la compilazione del modello per una messa a punto semplificata e indipendente dal dispositivo.
Per altri consigli pratici sull'ottimizzazione della latenza, consulta la sezione Ottimizzazione della latenza della nostra guida.
OpenVINO migliora il throughput dei modelli Ultralytics YOLO massimizzando l'utilizzo delle risorse del dispositivo senza sacrificare le prestazioni. Tra i principali vantaggi:
- Suggerimenti sulle prestazioni: messa a punto semplice e di alto livello delle prestazioni su diversi dispositivi.
- Batch e stream espliciti: messa a punto per prestazioni avanzate.
- Esecuzione su più dispositivi: bilanciamento automatico del carico di inferenza, per semplificare la gestione a livello applicativo.
Esempio di configurazione:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Scopri di più sull'ottimizzazione del throughput nella sezione Ottimizzazione del throughput della nostra guida dettagliata.
Per ridurre la latenza della prima inferenza, valuta queste pratiche:
- Memorizzazione nella cache del modello: usa la cache del modello per ridurre i tempi di caricamento e compilazione.
- Mappatura del modello e lettura: usa la mappatura (
ov::enable_mmap(true)) per impostazione predefinita, ma passa alla lettura (ov::enable_mmap(false)) se il modello si trova su un'unità rimovibile o di rete. - Selezione automatica del dispositivo: usa la modalità AUTO per avviare l'inferenza sulla CPU e passare senza interruzioni a un acceleratore.
Per strategie dettagliate sulla gestione della latenza della prima inferenza, consulta la sezione Gestione della latenza della prima inferenza.
Per bilanciare l'ottimizzazione della latenza e del throughput, devi comprendere le esigenze della tua applicazione:
- Ottimizzazione della latenza: ideale per le applicazioni in tempo reale che richiedono risposte immediate (ad esempio, le app consumer).
- Ottimizzazione del throughput: ideale per gli scenari con numerose inferenze simultanee, in cui si massimizza l'uso delle risorse (ad esempio, le distribuzioni su larga scala).
Usare i suggerimenti sulle prestazioni di alto livello e le modalità multi-dispositivo di OpenVINO può aiutarti a trovare il giusto equilibrio. Scegli i suggerimenti sulle prestazioni di OpenVINO più adatti ai tuoi requisiti specifici.
Sì, i modelli Ultralytics YOLO sono molto versatili e possono essere integrati con diversi framework di AI. Tra le opzioni disponibili:
- TensorRT: per ottimizzare le GPU NVIDIA, segui la guida all'integrazione di TensorRT.
- CoreML: per i dispositivi Apple, consulta le nostre istruzioni per l'esportazione in CoreML.
- LiteRT.js: per le app web e Node.js, consulta la guida all'integrazione di LiteRT e il runtime web di LiteRT.js.
Scopri altre integrazioni nella pagina delle integrazioni Ultralytics.