Distribuisci un modello YOLO pretrained con Ultralytics su Vertex AI per l'inferenza#
Questa guida ti mostrerà come containerizzare un modello YOLO26 pretrained con Ultralytics, creare un server di inferenza FastAPI e distribuire il modello con il server di inferenza su Google Cloud Vertex AI. L'implementazione di esempio illustra il caso d'uso del rilevamento degli oggetti per YOLO26, ma gli stessi principi si applicano anche all'uso di altre attività YOLO.
Prima di iniziare, dovrai creare un progetto Google Cloud Platform (GCP). Come nuovo utente, ricevi 300 $ di crediti GCP gratuiti, una somma sufficiente per testare una configurazione funzionante che potrai estendere in seguito a qualsiasi altro caso d'uso di YOLO26, incluso l'addestramento o l'inferenza in batch e in streaming.
Cosa imparerai#
- Creare un backend di inferenza per un modello Ultralytics YOLO26 usando FastAPI.
- Creare un repository GCP Artifact Registry per archiviare la tua immagine Docker.
- Creare e inviare l'immagine Docker con il modello ad Artifact Registry.
- Importare il modello in Vertex AI.
- Creare un endpoint Vertex AI e distribuire il modello.
- Controllo completo del modello con Ultralytics: puoi usare una logica di inferenza personalizzata, con il pieno controllo sulla preelaborazione, la postelaborazione e la formattazione delle risposte.
- Vertex AI gestisce il resto: esegue la scalabilità automatica e offre flessibilità nella configurazione delle risorse di calcolo, della memoria e delle GPU.
- Integrazioni native GCP e sicurezza: configurazione semplice con Cloud Storage, BigQuery, Cloud Functions, controlli VPC, criteri IAM e log di audit.
Prerequisiti#
- Installa Docker sul tuo computer.
- Installa Google Cloud SDK e autenticati per usare la CLI gcloud.
- Ti consigliamo vivamente di consultare la guida rapida a Docker per Ultralytics, perché durante questa guida dovrai estendere una delle immagini Docker ufficiali di Ultralytics.
1. Crea un backend di inferenza con FastAPI#
Per prima cosa, devi creare un'applicazione FastAPI che gestisca le richieste di inferenza del modello YOLO26. Questa applicazione si occuperà del caricamento del modello, della preelaborazione delle immagini e della logica di inferenza (predizione).
Fondamenti della conformità di Vertex AI#
Vertex AI richiede che il tuo container implementi due endpoint specifici:
-
Endpoint Health (
/health): deve restituire lo stato HTTP200 OKquando il servizio è pronto. -
Endpoint Predict (
/predict): accetta richieste di predizione strutturate con immagini codificate in base64 e parametri facoltativi. Si applicano limiti alle dimensioni del payload a seconda del tipo di endpoint.I payload delle richieste per l'endpoint
/predictdevono seguire questa struttura JSON:{ "instances": [{ "image": "base64_encoded_image" }], "parameters": { "confidence": 0.5 } }
Struttura delle cartelle del progetto#
La maggior parte del lavoro di compilazione avverrà all'interno del container Docker e Ultralytics caricherà anche un modello YOLO26 pretrained, quindi puoi mantenere semplice la struttura delle cartelle locali:
YOUR_PROJECT/
├── src/
│   ├── __init__.py
│   ├── app.py              # Core YOLO26 inference logic
│   └── main.py             # FastAPI inference server
├── tests/
├── .env                    # Environment variables for local development
├── Dockerfile              # Container configuration
├── LICENSE                 # AGPL-3.0 License
└── pyproject.toml # Python dependencies and project configI modelli e il framework Ultralytics YOLO26 sono distribuiti con licenza AGPL-3.0, che prevede importanti requisiti di conformità. Assicurati di leggere la documentazione di Ultralytics su come rispettare i termini della licenza.
Crea pyproject.toml con le dipendenze#
Per gestire comodamente il tuo progetto, crea un file pyproject.toml con le seguenti dipendenze:
[project]
name = "YOUR_PROJECT_NAME"
version = "0.0.1"
description = "YOUR_PROJECT_DESCRIPTION"
requires-python = ">=3.10,<3.13"
dependencies = [
   "ultralytics>=8.4.0",
   "fastapi[all]>=0.89.1",
   "uvicorn[standard]>=0.20.0",
   "pillow>=9.0.0",
   "loguru",
]

[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"uvicornverrà usato per eseguire il server FastAPI.loguruverrà usato per la registrazione dei log nel server FastAPI.pillowverrà usato per l'elaborazione delle immagini, ma non sei limitato alle sole immagini PIL: Ultralytics supporta molti altri formati.
Crea la logica di inferenza con Ultralytics YOLO26#
Ora che hai configurato la struttura del progetto e le dipendenze, puoi implementare la logica di inferenza principale di YOLO26. Crea un file src/app.py che gestisca il caricamento del modello, l'elaborazione delle immagini e la predizione, usando l'API Python di Ultralytics.
# src/app.py

from ultralytics import YOLO

# Model initialization and readiness state
model_yolo = None
_model_ready = False

def _initialize_model():
    """Initialize the YOLO model."""
    global model_yolo, _model_ready

    try:
        # Use pretrained YOLO26n model from Ultralytics base image
        model_yolo = YOLO("yolo26n.pt")
        _model_ready = True

    except Exception as e:
        print(f"Error initializing YOLO model: {e}")
        _model_ready = False
        model_yolo = None

# Initialize model on module import
_initialize_model()

def is_model_ready() -> bool:
    """Check if the model is ready for inference."""
    return _model_ready and model_yolo is not None
Il modello verrà caricato una sola volta all'avvio del container e sarà condiviso tra tutte le richieste. Se il modello deve gestire un carico di inferenza elevato, ti consigliamo di scegliere un tipo di macchina con più memoria quando importerai il modello in Vertex AI in un passaggio successivo.
Poi, crea due funzioni di utilità per elaborare le immagini in ingresso e in uscita con pillow. YOLO26 supporta nativamente le immagini PIL.
def get_image_from_bytes(binary_image: bytes) -> Image.Image:
    """Convert image from bytes to PIL RGB format."""
    input_image = Image.open(io.BytesIO(binary_image)).convert("RGB")
    return input_image
def get_bytes_from_image(image: Image.Image) -> bytes:
"""Convert PIL image to bytes."""
return_image = io.BytesIO()
image.save(return_image, format="JPEG", quality=85)
return_image.seek(0)
return return_image.getvalue()Infine, implementa la funzione run_inference che gestirà il rilevamento degli oggetti. In questo esempio, estrarremo i riquadri di delimitazione, i nomi delle classi e i punteggi di confidenza dalle predizioni del modello. La funzione restituirà un dizionario con i rilevamenti e i risultati grezzi, da elaborare o annotare ulteriormente.
def run_inference(input_image: Image.Image, confidence_threshold: float = 0.5) -> Dict[str, Any]:
    """Run inference on an image using YOLO26n model."""
    # Check if model is ready
    if not is_model_ready():
        print("Model not ready for inference")
        return {"detections": [], "results": None}

    try:
        # Make predictions and get raw results
        results = model_yolo.predict(
            imgsz=640, source=input_image, conf=confidence_threshold, save=False, augment=False, verbose=False
        )

        # Extract detections (bounding boxes, class names, and confidences)
        detections = []
        if results and len(results) > 0:
            result = results[0]
            if result.boxes is not None and len(result.boxes.xyxy) > 0:
                boxes = result.boxes

                # Convert tensors to numpy for processing
                xyxy = boxes.xyxy.cpu().numpy()
                conf = boxes.conf.cpu().numpy()
                cls = boxes.cls.cpu().numpy().astype(int)

                # Create detection dictionaries
                for i in range(len(xyxy)):
                    detection = {
                        "xmin": float(xyxy[i][0]),
                        "ymin": float(xyxy[i][1]),
                        "xmax": float(xyxy[i][2]),
                        "ymax": float(xyxy[i][3]),
                        "confidence": float(conf[i]),
                        "class": int(cls[i]),
                        "name": model_yolo.names.get(int(cls[i]), f"class_{int(cls[i])}"),
                    }
                    detections.append(detection)

        return {
            "detections": detections,
            "results": results,  # Keep raw results for annotation
        }
    except Exception as e:
        # If there's an error, return empty structure
        print(f"Error in YOLO detection: {e}")
        return {"detections": [], "results": None}
Facoltativamente, puoi aggiungere una funzione per annotare l'immagine con riquadri di delimitazione ed etichette usando il metodo di plotting integrato di Ultralytics. Sarà utile se vuoi restituire immagini annotate nella risposta alla predizione.
def get_annotated_image(results: list) -> Image.Image:
    """Get annotated image using Ultralytics built-in plot method."""
    if not results or len(results) == 0:
        raise ValueError("No results provided for annotation")

    result = results[0]
    # Usa il metodo plot integrato di Ultralytics con output PIL
    return result.plot(pil=True)
Crea un server HTTP di inferenza con FastAPI#
Ora che hai implementato la logica di inferenza principale di YOLO26, puoi creare un'applicazione FastAPI per renderla disponibile. L'applicazione includerà gli endpoint di controllo dello stato e di predizione richiesti da Vertex AI.
Per prima cosa, crea src/main.py, aggiungi le importazioni, crea l'app FastAPI e configura la registrazione dei log per Vertex AI. Poiché Vertex AI considera stderr come output di errore, è opportuno indirizzare i log a stdout.
# src/main.py

import sys

from fastapi import FastAPI
from loguru import logger

app = FastAPI()

# Configura il logger
logger.remove()
logger.add(
    sys.stdout,
    colorize=True,
    format="<green>{time:HH:mm:ss}</green> | <level>{message}</level>",
    level=10,
)
logger.add("log.log", rotation="1 MB", level="DEBUG", compression="zip")
Per garantire la piena conformità con Vertex AI, definisci gli endpoint richiesti nelle variabili d'ambiente e imposta il limite di dimensione delle richieste. Per le distribuzioni in produzione, è consigliabile usare endpoint Vertex AI privati. In questo modo avrai un limite maggiore per i payload delle richieste (10 MB invece di 1,5 MB per gli endpoint pubblici), oltre a una solida sicurezza e a un controllo degli accessi.
# Variabili d'ambiente di Vertex AI
AIP_HTTP_PORT = int(os.getenv("AIP_HTTP_PORT", "8080"))
AIP_HEALTH_ROUTE = os.getenv("AIP_HEALTH_ROUTE", "/health")
AIP_PREDICT_ROUTE = os.getenv("AIP_PREDICT_ROUTE", "/predict")

# Limite di dimensione delle richieste (10 MB per gli endpoint privati, 1,5 MB per quelli pubblici)
MAX_REQUEST_SIZE = 10 * 1024 * 1024  # 10 MB in byte
Aggiungi due modelli Pydantic per convalidare le richieste e le risposte:
# Modelli Pydantic per richiesta/risposta
class PredictionRequest(BaseModel):
    instances: list
    parameters: Optional[Dict[str, Any]] = None

class PredictionResponse(BaseModel):
    predictions: list
Aggiungi l'endpoint di controllo dello stato per verificare che il modello sia pronto. È importante per Vertex AI, perché senza un controllo dello stato dedicato il suo orchestratore invierà ping a socket casuali e non potrà determinare se il modello è pronto per l'inferenza. In caso di esito positivo, il controllo deve restituire 200 OK; in caso di esito negativo, 503 Service Unavailable:
# Endpoint di controllo dello stato
@app.get(AIP_HEALTH_ROUTE, status_code=status.HTTP_200_OK)
def health_check():
    """Health check endpoint for Vertex AI."""
    if not is_model_ready():
        raise HTTPException(status_code=503, detail="Model not ready")
    return {"status": "healthy"}
Ora hai tutto ciò che serve per implementare l'endpoint di predizione che gestirà le richieste di inferenza. Accetterà un file immagine, eseguirà l'inferenza e restituirà i risultati. Tieni presente che l'immagine deve essere codificata in base64, aumentando così la dimensione del payload fino al 33%.
@app.post(AIP_PREDICT_ROUTE, response_model=PredictionResponse)
async def predict(request: PredictionRequest):
    """Prediction endpoint for Vertex AI."""
    try:
        predictions = []

        for instance in request.instances:
            if isinstance(instance, dict):
                if "image" in instance:
                    image_data = base64.b64decode(instance["image"])
                    input_image = get_image_from_bytes(image_data)
                else:
                    raise HTTPException(status_code=400, detail="Instance must contain 'image' field")
            else:
                raise HTTPException(status_code=400, detail="Invalid instance format")

            # Extract YOLO26 parameters if provided
            parameters = request.parameters or {}
            confidence_threshold = parameters.get("confidence", 0.5)
            return_annotated_image = parameters.get("return_annotated_image", False)

            # Run inference with YOLO26n model
            result = run_inference(input_image, confidence_threshold=confidence_threshold)
            detections_list = result["detections"]

            # Format predictions for Vertex AI
            detections = []
            for detection in detections_list:
                formatted_detection = {
                    "class": detection["name"],
                    "confidence": detection["confidence"],
                    "bbox": {
                        "xmin": detection["xmin"],
                        "ymin": detection["ymin"],
                        "xmax": detection["xmax"],
                        "ymax": detection["ymax"],
                    },
                }
                detections.append(formatted_detection)

            # Build prediction response
            prediction = {"detections": detections, "detection_count": len(detections)}

            # Add annotated image if requested and detections exist
            if (
                return_annotated_image
                and result["results"]
                and result["results"][0].boxes is not None
                and len(result["results"][0].boxes) > 0
            ):
                annotated_image = get_annotated_image(result["results"])
                img_bytes = get_bytes_from_image(annotated_image)
                prediction["annotated_image"] = base64.b64encode(img_bytes).decode("utf-8")

            predictions.append(prediction)

        logger.info(
            f"Processed {len(request.instances)} instances, found {sum(len(p['detections']) for p in predictions)} total detections"
        )

        return PredictionResponse(predictions=predictions)

    except HTTPException:
        # Re-raise HTTPException as-is (don't catch and convert to 500)
        raise
    except Exception as e:
        logger.error(f"Prediction error: {e}")
        raise HTTPException(status_code=500, detail=f"Prediction failed: {e}")
Infine, aggiungi il punto di ingresso dell'applicazione per eseguire il server FastAPI.
if __name__ == "__main__":
    import uvicorn

    logger.info(f"Starting server on port {AIP_HTTP_PORT}")
    logger.info(f"Health check route: {AIP_HEALTH_ROUTE}")
    logger.info(f"Predict route: {AIP_PREDICT_ROUTE}")
    uvicorn.run(app, host="0.0.0.0", port=AIP_HTTP_PORT)
Ora hai un'applicazione FastAPI completa, in grado di gestire le richieste di inferenza di YOLO26. Puoi testarla localmente installando le dipendenze ed eseguendo il server, ad esempio con uv.
# Install dependencies
uv pip install -e .

# Run the FastAPI server directly
uv run src/main.py
Per testare il server, puoi interrogare entrambi gli endpoint /health e /predict con cURL. Inserisci un'immagine di test nella cartella tests. Poi, nel Terminale, esegui i seguenti comandi:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
Dovresti ricevere una risposta JSON con gli oggetti rilevati. La prima richiesta potrebbe richiedere qualche istante, perché Ultralytics deve scaricare e caricare il modello YOLO26.
2. Estendi l'immagine Docker di Ultralytics con la tua applicazione#
Ultralytics mette a disposizione diverse immagini Docker che puoi usare come base per l'immagine della tua applicazione. Includono Ultralytics e le librerie CUDA necessarie, quindi ti basta aggiungere la tua applicazione.
Per sfruttare tutte le funzionalità dei modelli Ultralytics YOLO, dovresti scegliere l'immagine ottimizzata per CUDA per l'inferenza su GPU. Tuttavia, se per la tua attività è sufficiente l'inferenza su CPU, puoi anche risparmiare risorse di calcolo scegliendo l'immagine solo CPU:
- Dockerfile: immagine ottimizzata per CUDA per l'addestramento e l'inferenza YOLO26 con una o più GPU.
- Dockerfile-cpu: immagine solo CPU per l'inferenza YOLO26.
Crea un'immagine Docker per la tua applicazione#
Crea un file Dockerfile nella directory principale del progetto con il seguente contenuto:
# Extends official Ultralytics Docker image for YOLO26
FROM ultralytics/ultralytics:latest

ENV PYTHONUNBUFFERED=1

# Install FastAPI and dependencies
RUN uv pip install --system fastapi[all] uvicorn[standard] loguru

WORKDIR /app
COPY src/ ./src/
COPY pyproject.toml ./

# Install the application package
RUN uv pip install --system -e .

RUN mkdir -p /app/logs
ENV PYTHONPATH=/app/src

# Port for Vertex AI
EXPOSE 8080

# Start the inference server
ENTRYPOINT ["python", "src/main.py"]
Nell'esempio, viene usata come base l'immagine Docker ufficiale di Ultralytics ultralytics:latest. Contiene già il modello YOLO26 e tutte le dipendenze necessarie. Il punto di ingresso del server è lo stesso usato per testare localmente l'applicazione FastAPI.
Crea e testa l'immagine Docker#
Ora puoi creare l'immagine Docker con il seguente comando:
docker build --platform linux/amd64 -t IMAGE_NAME:IMAGE_VERSION .Sostituisci IMAGE_NAME e IMAGE_VERSION con i valori che preferisci, ad esempio yolo26-fastapi:0.1. Tieni presente che, se distribuisci su Vertex AI, devi creare l'immagine per l'architettura linux/amd64. Se crei l'immagine su un Mac con Apple Silicon o su un'altra architettura diversa da x86, devi impostare esplicitamente il parametro --platform.
Una volta completata la creazione dell'immagine, puoi testarla localmente:
docker run --platform linux/amd64 -p 8080:8080 IMAGE_NAME:IMAGE_VERSIONIl tuo container Docker sta ora eseguendo un server FastAPI sulla porta 8080, pronto a ricevere richieste di inferenza. Puoi testare gli endpoint /health e /predict con gli stessi comandi cURL usati in precedenza:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
3. Carica l'immagine Docker in GCP Artifact Registry#
Per importare il modello containerizzato in Vertex AI, devi caricare l'immagine Docker in Google Cloud Artifact Registry. Se non hai ancora un repository Artifact Registry, dovrai prima crearne uno.
Crea un repository in Google Cloud Artifact Registry#
Apri la pagina Artifact Registry nella Google Cloud Console. Se usi Artifact Registry per la prima volta, potrebbe esserti chiesto di abilitare prima l'API Artifact Registry.

- Seleziona Crea repository.
- Inserisci il nome del repository. Seleziona la regione desiderata e mantieni le impostazioni predefinite per le altre opzioni, a meno che tu non debba modificarle.
La scelta della regione può influire sulla disponibilità delle macchine e su alcune limitazioni di calcolo per gli utenti che non dispongono di un piano Enterprise. Puoi trovare maggiori informazioni nella documentazione ufficiale di Vertex AI: Quote e limiti di Vertex AI
- Una volta creato il repository, salva il tuo PROJECT_ID, la Location (Region) e il Repository Name nel tuo archivio dei segreti o nel file
.env. Ti serviranno in seguito per assegnare un tag all'immagine Docker e inviarla ad Artifact Registry.
Autentica Docker con Artifact Registry#
Autentica il client Docker con il repository Artifact Registry appena creato. Esegui il seguente comando nel terminale:
gcloud auth configure-docker YOUR_REGION-docker.pkg.devAssegna un tag all'immagine e inviala ad Artifact Registry#
Assegna un tag all'immagine Docker e inviala a Google Artifact Registry.
Ti consigliamo di usare tag univoci ogni volta che aggiorni l'immagine. La maggior parte dei servizi GCP, incluso Vertex AI, si affida ai tag delle immagini per il controllo automatico delle versioni e la scalabilità; è quindi buona norma usare il versionamento semantico o tag basati sulla data.
Assegna all'immagine un tag con l'URL del repository Artifact Registry. Sostituisci i segnaposto con i valori salvati in precedenza.
docker tag IMAGE_NAME:IMAGE_VERSION YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONInvia l'immagine con tag al repository Artifact Registry.
docker push YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONAttendi il completamento del processo. Ora dovresti vedere l'immagine nel repository di Artifact Registry.
Per istruzioni più dettagliate su come lavorare con le immagini in Artifact Registry, consulta la documentazione di Artifact Registry: Caricare e scaricare immagini.
4. Importare il modello in Vertex AI#
Ora puoi importare il modello in Vertex AI utilizzando l'immagine Docker appena caricata.
-
Nel menu di navigazione di Google Cloud, vai su Vertex AI > Model Registry. In alternativa, cerca "Vertex AI" nella barra di ricerca nella parte superiore della Google Cloud Console.

-
Fai clic su Import.
-
Seleziona Import as a new model.
-
Seleziona la regione. Puoi scegliere la stessa regione del tuo repository Artifact Registry, ma la scelta dovrebbe dipendere dalla disponibilità di tipi di macchine e quote nella tua regione.
-
Seleziona Import an existing model container.

-
Nel campo Container image, cerca il repository Artifact Registry che hai creato in precedenza e seleziona l'immagine che hai appena caricato.
-
Scorri verso il basso fino alla sezione Environment variables e inserisci gli endpoint predict e health e la porta che hai definito nella tua applicazione FastAPI.

-
Fai clic su Import. Vertex AI impiegherà alcuni minuti per registrare il modello e prepararlo per la distribuzione. Riceverai una notifica via email al completamento dell'importazione.
5. Creare un endpoint Vertex AI e distribuire il modello#
Nella terminologia di Vertex AI, gli endpoint indicano i modelli distribuiti, poiché rappresentano gli endpoint HTTP a cui invii le richieste di inferenza, mentre i modelli sono gli artefatti ML addestrati archiviati in Model Registry.
Per distribuire un modello, devi creare un endpoint in Vertex AI.
-
Nel menu di navigazione di Vertex AI, vai su Endpoints. Seleziona la regione che hai utilizzato quando hai importato il modello. Fai clic su Create.

-
Inserisci il nome dell'endpoint.
-
Per Access, Vertex AI consiglia di usare endpoint Vertex AI privati. Oltre ai vantaggi in termini di sicurezza, se selezioni un endpoint privato avrai un limite di payload più elevato, ma dovrai configurare la rete VPC e le regole del firewall per consentire l'accesso all'endpoint. Consulta la documentazione di Vertex AI per ulteriori istruzioni sugli endpoint privati.
-
Fai clic su Continue.
-
Nella finestra di dialogo Model settings, seleziona il modello che hai importato in precedenza. Ora puoi configurare il tipo di macchina, la memoria e le impostazioni della GPU per il modello. Prevedi una quantità di memoria adeguata se ti aspetti carichi di inferenza elevati, per evitare colli di bottiglia I/O e garantire prestazioni ottimali di YOLO26.
-
In Accelerator type, seleziona il tipo di GPU da usare per l'inferenza. Se non sai quale GPU selezionare, puoi iniziare con NVIDIA T4, supportata da CUDA.
Ricorda che alcune regioni hanno quote di elaborazione molto limitate, quindi potresti non riuscire a selezionare determinati tipi di macchina o GPU nella tua regione. Se questo è un requisito fondamentale, cambia la regione di distribuzione scegliendone una con una quota maggiore. Per ulteriori informazioni, consulta la documentazione ufficiale di Vertex AI: Quote e limiti di Vertex AI.
- Dopo aver selezionato il tipo di macchina, puoi fare clic su Continue. A questo punto, puoi scegliere di attivare il monitoraggio del modello in Vertex AI: un servizio aggiuntivo che tiene traccia delle prestazioni del modello e fornisce informazioni sul suo comportamento. Questa opzione è facoltativa e comporta costi aggiuntivi, quindi selezionala in base alle tue esigenze. Fai clic su Create.
La distribuzione del modello da parte di Vertex AI richiederà alcuni minuti (fino a 30 minuti in alcune regioni). Al termine della distribuzione, riceverai una notifica via email.
6. Testare il modello distribuito#
Al termine della distribuzione, Vertex AI ti fornirà un'interfaccia API di esempio per testare il modello.
Per testare l'inferenza remota, puoi usare il comando cURL fornito oppure creare un'altra libreria client Python che invii richieste al modello distribuito. Ricorda che devi codificare l'immagine in base64 prima di inviarla all'endpoint /predict.
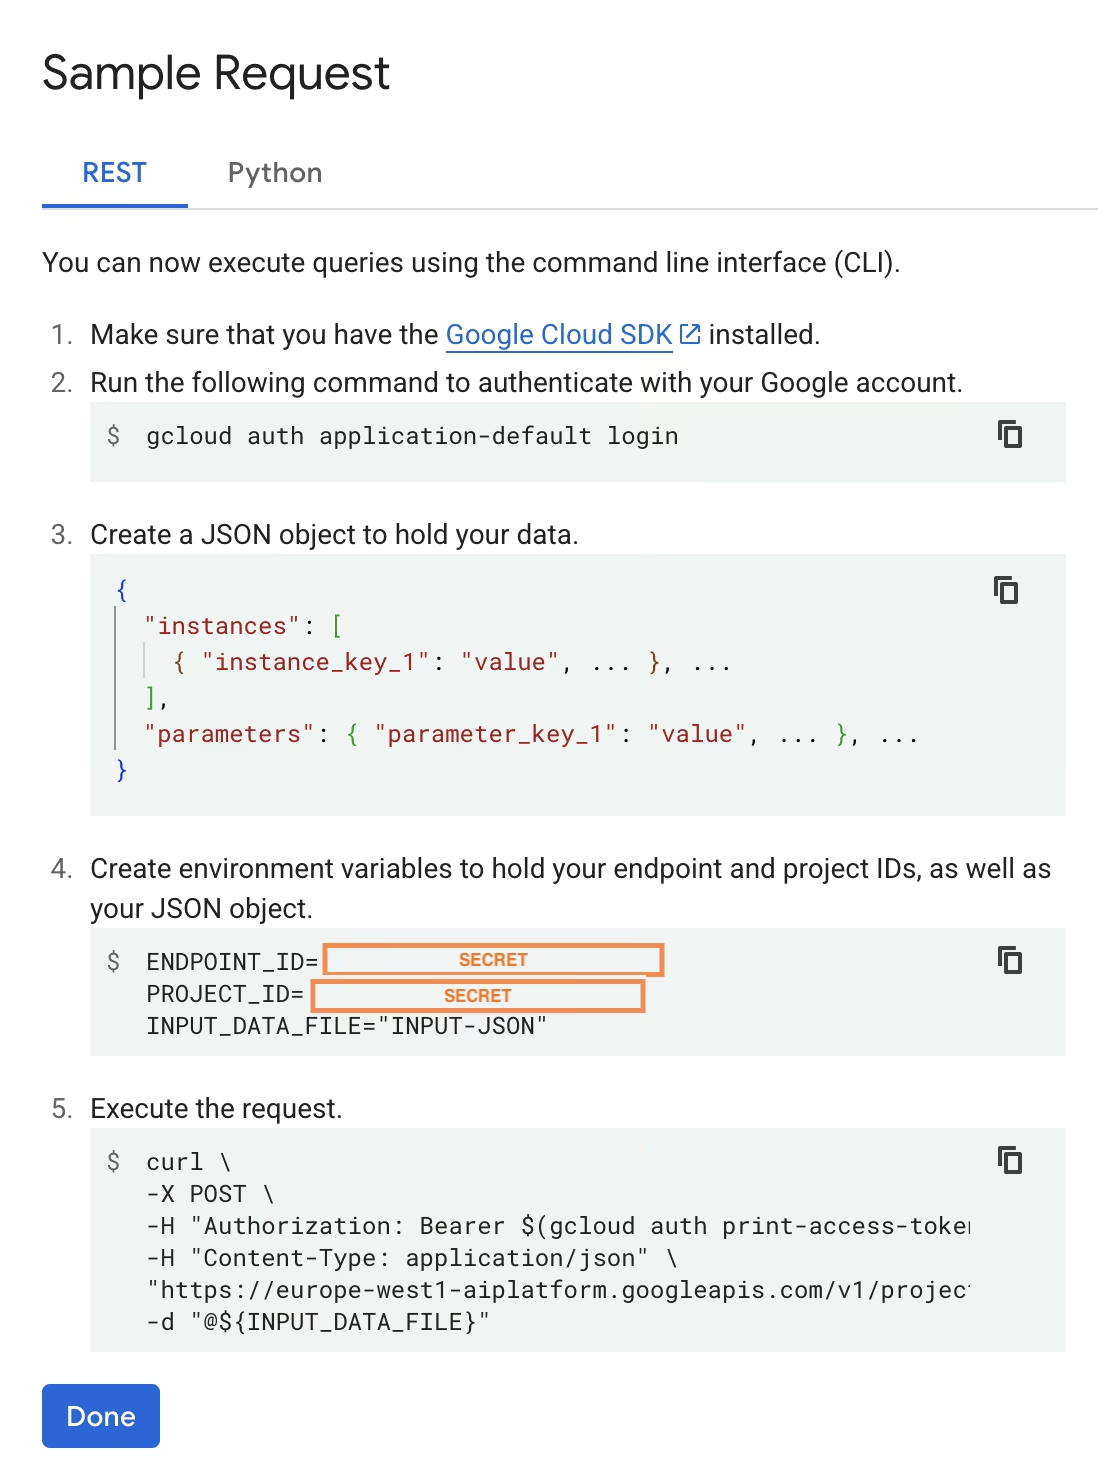
Come nei test locali, aspettati un breve ritardo alla prima richiesta, poiché Ultralytics dovrà scaricare e caricare il modello YOLO26 nel container in esecuzione.
Hai distribuito correttamente un modello YOLO26 pretrained con Ultralytics su Google Cloud Vertex AI.
Domande frequenti#
Sì; tuttavia, dovrai prima esportare il modello in un formato compatibile con Vertex AI, ad esempio TensorFlow, Scikit-learn o XGBoost. Google Cloud fornisce una guida sull'esecuzione dei modelli
.ptsu Vertex, con una panoramica completa del processo di conversione: Eseguire modelli PyTorch su Vertex AI.Tieni presente che la configurazione risultante si baserà solo sul livello di serving standard di Vertex AI e non supporterà le funzionalità avanzate del framework Ultralytics. Poiché Vertex AI supporta pienamente i modelli containerizzati e può ridimensionarli automaticamente in base alla configurazione di distribuzione, puoi sfruttare tutte le potenzialità dei modelli Ultralytics YOLO senza doverli convertire in un formato diverso.
FastAPI offre un throughput elevato per i carichi di lavoro di inferenza. Il supporto asincrono consente di gestire più richieste simultanee senza bloccare il thread principale, aspetto importante quando si servono modelli di computer vision.
La convalida automatica di richieste e risposte con FastAPI riduce gli errori di runtime nei servizi di inferenza in produzione. È particolarmente utile per le API di object detection, in cui la coerenza del formato di input è fondamentale.
FastAPI aggiunge un overhead computazionale minimo alla pipeline di inferenza, lasciando più risorse disponibili per l'esecuzione del modello e l'elaborazione delle immagini.
FastAPI supporta anche SSE (eventi inviati dal server), utile per gli scenari di inferenza in streaming.
È una funzionalità che offre flessibilità in Google Cloud Platform: devi selezionare una regione per ogni servizio che usi. Per distribuire un modello containerizzato su Vertex AI, la selezione della regione più importante è quella di Model Registry. Determina la disponibilità dei tipi di macchina e delle quote per la distribuzione del modello.
Inoltre, se vuoi ampliare la configurazione e archiviare dati o risultati delle predizioni in Cloud Storage o BigQuery, dovrai usare la stessa regione di Model Registry per ridurre al minimo la latenza e garantire un throughput elevato nell'accesso ai dati.