Guida all'uso di Kaggle per addestrare i tuoi modelli YOLO26
Se stai imparando a conoscere l'IA e lavorando a piccoli progetti, potresti non avere ancora accesso a risorse di calcolo potenti e l'hardware di fascia alta può essere costoso. Kaggle, una piattaforma di proprietà di Google, offre un ambiente cloud gratuito in cui puoi accedere alle risorse GPU, gestire grandi dataset e collaborare con una comunità eterogenea di data scientist e appassionati di machine learning.
Kaggle è una soluzione pratica per addestrare e sperimentare con i modelli Ultralytics YOLO26. I notebook Kaggle includono librerie e framework di machine learning molto diffusi, già installati. Questa guida illustra le funzionalità principali di Kaggle e mostra come addestrare modelli YOLO26 sulla piattaforma.
Che cos'è Kaggle?#
Kaggle è una piattaforma che riunisce data scientist di tutto il mondo per collaborare, imparare e competere nella risoluzione di problemi reali di data science. Lanciata nel 2010 da Anthony Goldbloom e Jeremy Howard e acquisita da Google nel 2017, Kaggle permette agli utenti di connettersi, scoprire e condividere dataset, usare notebook con GPU e partecipare a competizioni di data science. La piattaforma è pensata sia per professionisti esperti sia per chi sta imparando.
Con oltre 10 milioni di utenti nel 2022, Kaggle offre un ambiente ricco per sviluppare e sperimentare con modelli di machine learning. Non devi preoccuparti delle specifiche o della configurazione del computer locale: ti bastano un account Kaggle e un browser Web.
Installazione#
Prima di iniziare ad addestrare modelli YOLO26 su Kaggle, devi assicurarti che l'ambiente notebook sia configurato correttamente. Segui questi passaggi:
Abilita l'accesso a Internet#
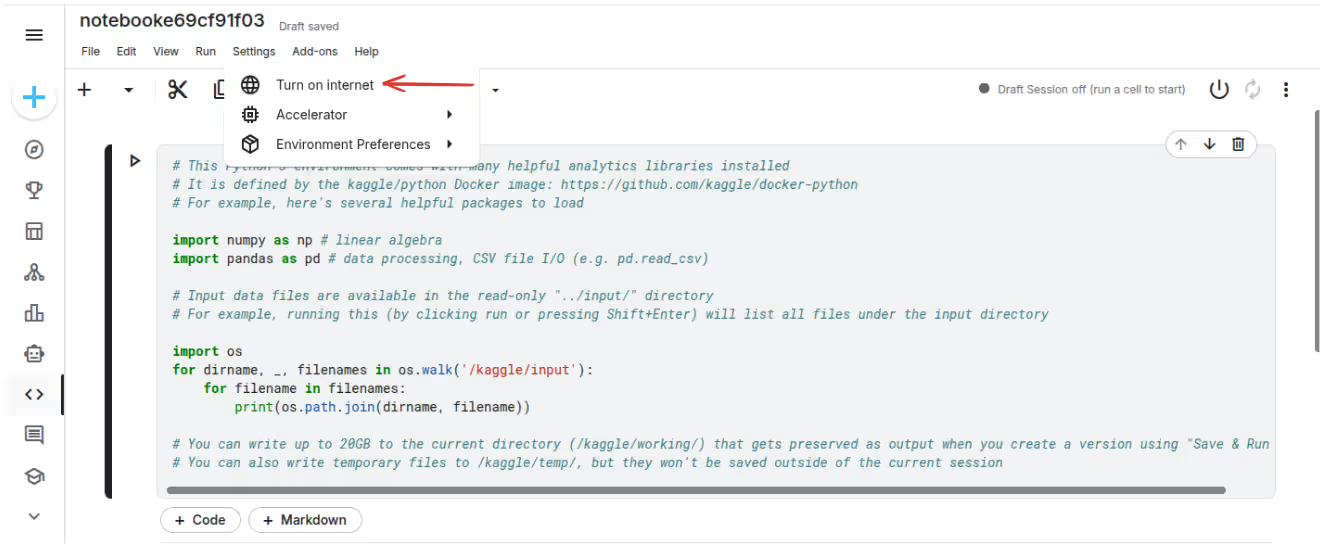
I notebook di Kaggle richiedono l'accesso a Internet per scaricare pacchetti e dipendenze. Per abilitare Internet nel tuo notebook Kaggle:
- Apri il tuo notebook Kaggle
- Fai clic sul pannello Impostazioni sul lato destro dell'interfaccia del notebook
- Scorri fino alla sezione Internet
- Imposta l'interruttore su ON per abilitare la connessione a Internet
Nota: per installare il pacchetto Ultralytics e scaricare modelli o dataset preaddestrati è necessario l'accesso a Internet. Se Internet non è abilitato, l'installazione dei pacchetti non andrà a buon fine.
Installazione di Ultralytics#
Dopo aver abilitato l'accesso a Internet, installa il pacchetto Ultralytics eseguendo il seguente comando in una cella del notebook:
!pip install ultralyticsPer installare la versione di sviluppo più recente, puoi installarla direttamente da GitHub:
!pip install git+https://github.com/ultralytics/ultralytics.gitRisoluzione dei conflitti tra dipendenze#
Durante l'installazione potresti incontrare conflitti tra dipendenze, soprattutto con pacchetti come opencv-python, numpy o torch. Ecco alcune soluzioni comuni:
Metodo 1: reinstallazione forzata con --upgrade#
Se riscontri conflitti con i pacchetti esistenti, forza l'aggiornamento:
!pip install --upgrade --force-reinstall ultralyticsMetodo 2: riavviare il kernel dopo l'installazione#
A volte è necessario riavviare il kernel dopo l'installazione per risolvere i problemi di importazione:
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu
Soluzioni agli errori comuni#
Errore: "No module named 'ultralytics'"
- Soluzione: assicurati che Internet sia abilitato e riesegui il comando di installazione
- Riavvia il kernel dopo l'installazione
Errore: "ERROR: pip's dependency resolver does not currently take into account..."
- Soluzione: di solito si tratta di un avviso che puoi ignorare senza rischi. L'installazione in genere va a buon fine nonostante il messaggio
Errore: "ModuleNotFoundError" dopo l'installazione
- Soluzione: riavvia il kernel usando il pulsante di riavvio nell'interfaccia del notebook
- Esegui nuovamente le istruzioni di importazione in una nuova cella
Verifica dell'installazione#
Dopo l'installazione, verifica che Ultralytics sia stato installato correttamente eseguendo:
import ultralytics

ultralytics.checks()
Questo mostrerà le informazioni di sistema e verificherà che tutte le dipendenze siano installate correttamente.
Addestrare YOLO26 con Kaggle#
Le GPU gratuite di Kaggle semplificano l'addestramento dei modelli YOLO26.
Per iniziare, apri il notebook del tutorial Ultralytics YOLO26 su Kaggle. L'ambiente Kaggle include librerie preinstallate come TensorFlow e PyTorch, semplificando la configurazione.
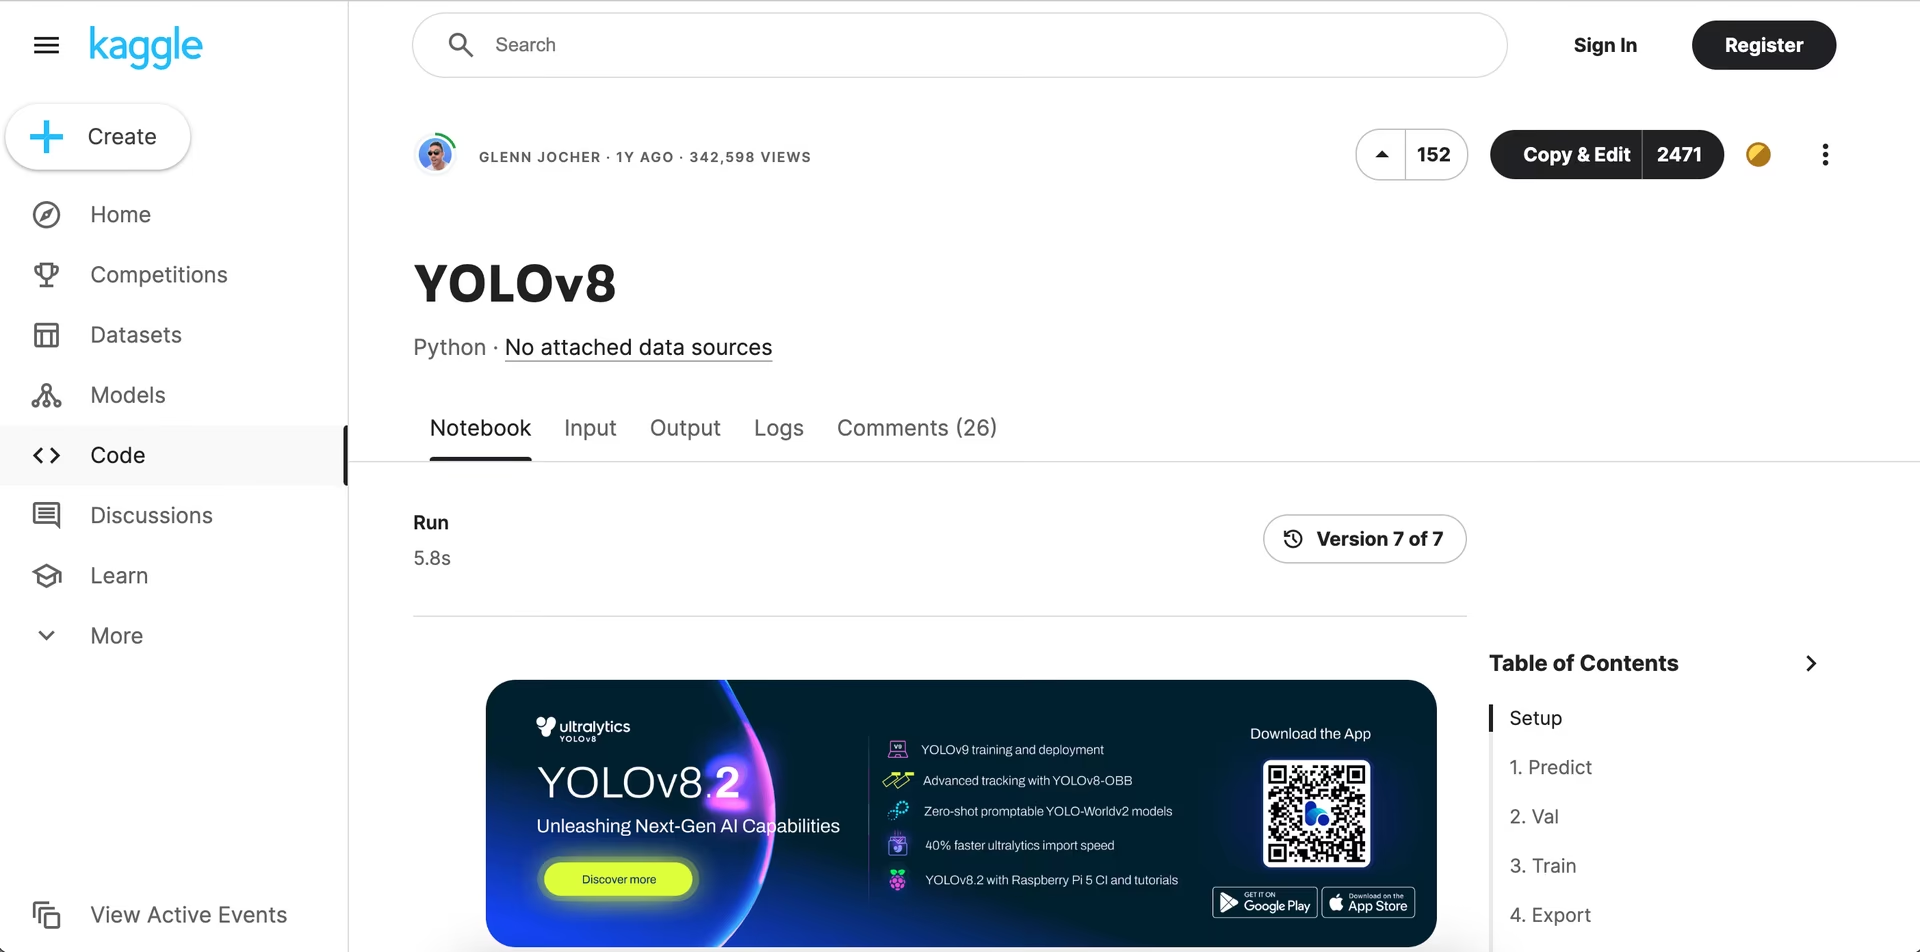
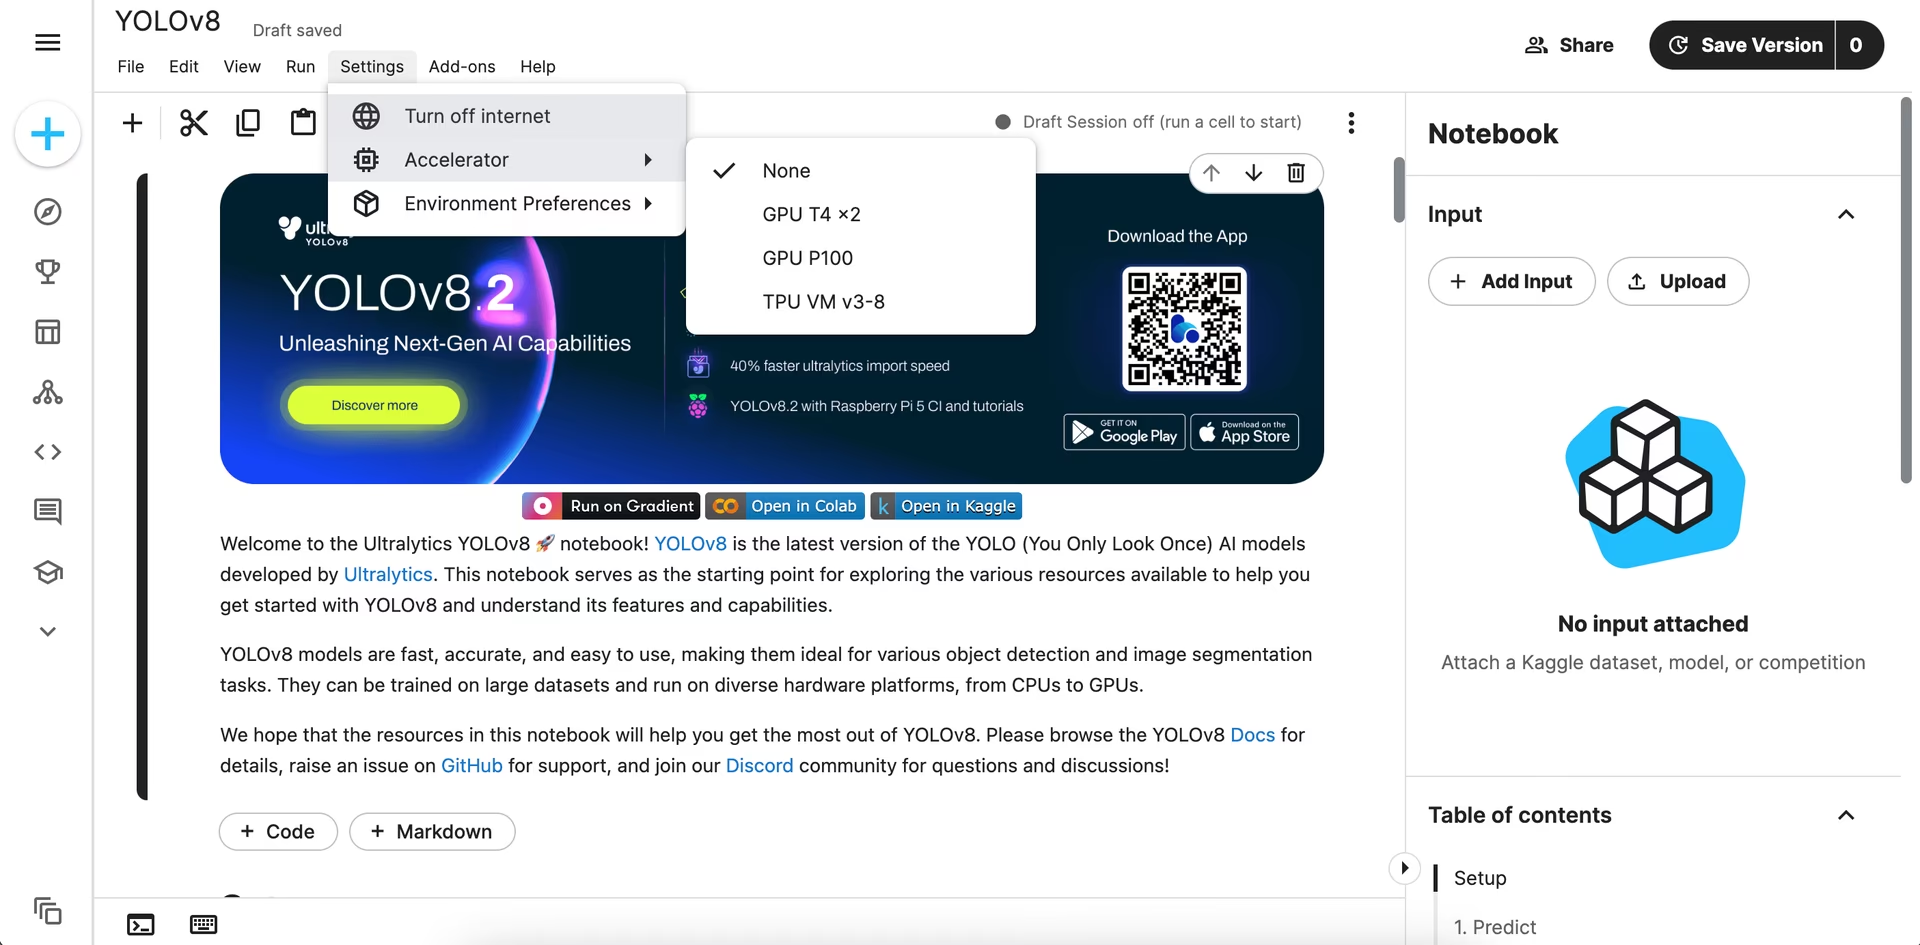
Dopo aver effettuato l'accesso al tuo account Kaggle, il notebook si apre come una tua copia modificabile: seleziona una GPU nelle impostazioni dell'acceleratore ed esegui le celle del notebook per iniziare ad addestrare il modello. Per comprendere nel dettaglio il processo di addestramento del modello e le relative best practice, consulta la nostra guida all'addestramento dei modelli YOLO26.
Problemi comuni durante l'utilizzo di Kaggle#
Quando usi Kaggle, potresti riscontrare alcuni problemi comuni. Ecco alcuni punti importanti per aiutarti a usare la piattaforma:
- Accesso alle GPU: nei notebook Kaggle puoi attivare una GPU in qualsiasi momento, con un limite di utilizzo di 30 ore alla settimana. Kaggle offre la GPU NVIDIA Tesla P100 con 16 GB di memoria e anche l'opzione NVIDIA T4 x2. L'accelerazione GPU rende l'addestramento e l'inferenza dei modelli molto più rapidi.
- Kaggle Kernels: Kaggle Kernels sono server gratuiti per notebook Jupyter che possono integrare GPU, consentendoti di eseguire operazioni di machine learning su computer cloud. Non devi affidarti alla CPU del tuo computer, evitando di sovraccaricarla e liberando le risorse locali.
- Dataset Kaggle: i dataset Kaggle sono scaricabili gratuitamente. Tuttavia, è importante controllare la licenza di ogni dataset per comprenderne le eventuali restrizioni d'uso. Alcuni dataset potrebbero prevedere limitazioni per le pubblicazioni accademiche o l'uso commerciale. Puoi scaricare i dataset direttamente nel tuo notebook Kaggle o in qualsiasi altra posizione tramite la Kaggle API.
- Salvataggio e commit dei notebook: per salvare e fare il commit di un notebook su Kaggle, fai clic su "Save Version". In questo modo salvi lo stato corrente del notebook. Quando il kernel in background ha terminato di generare i file di output, puoi accedervi dalla scheda Output nella pagina principale del notebook.
- Collaborazione: Kaggle supporta la collaborazione, ma più utenti non possono modificare un notebook contemporaneamente. La collaborazione su Kaggle è asincrona: gli utenti possono condividere e usare lo stesso notebook in momenti diversi.
- Ripristino di una versione precedente: se devi ripristinare una versione precedente del notebook, aprilo e fai clic sui tre puntini verticali nell'angolo in alto a destra, quindi seleziona "View Versions". Individua la versione da ripristinare, fai clic sul menu "..." accanto ad essa e seleziona "Revert to Version". Dopo il ripristino del notebook, fai clic su "Save Version" per registrare le modifiche.
Funzionalità principali di Kaggle#
Ecco alcune delle funzionalità principali offerte da Kaggle per la data science e il machine learning:
- Dataset: Kaggle ospita un'ampia raccolta di dataset su vari argomenti. Puoi cercare e usare questi dataset nei tuoi progetti, una soluzione particolarmente utile per addestrare e testare i tuoi modelli YOLO26.
- Competizioni: le competizioni Kaggle consentono a data scientist e professionisti del machine learning di risolvere problemi reali. Partecipare ti aiuta a migliorare le competenze, apprendere nuove tecniche e ottenere riconoscimento nella community.
- Accesso gratuito alle TPU: Kaggle offre accesso gratuito alle TPU per i framework che le supportano. L'addestramento di Ultralytics YOLO26 su Kaggle viene eseguito sulle GPU o sulla CPU, non sulle TPU.
- Integrazione con GitHub: Kaggle ti permette di collegare il tuo repository GitHub per caricare notebook e salvare il lavoro. Questa integrazione semplifica la gestione e l'accesso ai file.
- Community e discussioni: Kaggle vanta una vasta community di data scientist e professionisti del machine learning. I forum di discussione e i notebook condivisi sono risorse utili per imparare e risolvere problemi. Puoi trovare aiuto, condividere le tue conoscenze e collaborare con altre persone.
Perché usare Kaggle per i tuoi progetti YOLO26?#
Esistono diverse piattaforme per addestrare e valutare modelli di machine learning. Ecco alcuni vantaggi di Kaggle per i tuoi progetti di machine learning:
- Notebook pubblici: puoi rendere pubblici i tuoi notebook Kaggle, consentendo ad altri utenti di visualizzare, votare, creare fork e discutere il tuo lavoro. Kaggle promuove la collaborazione, il feedback e la condivisione di idee, aiutandoti a migliorare i tuoi modelli YOLO26.
- Cronologia completa dei commit del notebook: Kaggle crea una cronologia dettagliata dei commit del tuo notebook. Puoi così esaminare e monitorare le modifiche nel tempo, comprendere più facilmente l'evoluzione del progetto e ripristinare versioni precedenti, se necessario.
- Accesso alla console: Kaggle offre una console che ti dà un maggiore controllo sull'ambiente. Questa funzionalità ti permette di eseguire varie attività direttamente dalla riga di comando.
- Risorse disponibili: ogni sessione di modifica dei notebook su Kaggle offre risorse significative: 12 ore di esecuzione per le sessioni CPU e GPU, 9 ore per le sessioni TPU e 20 gigabyte di spazio su disco con salvataggio automatico.
- Pianificazione dei notebook: Kaggle ti consente di pianificare l'esecuzione dei notebook a orari specifici. Puoi automatizzare le attività ripetitive senza intervento manuale, ad esempio addestrando il modello a intervalli regolari.
Continua a imparare su Kaggle#
Se vuoi saperne di più su Kaggle, ecco alcune risorse utili:
- Kaggle Learn: scopri numerosi tutorial interattivi gratuiti su Kaggle Learn. Questi corsi trattano argomenti essenziali di data science con esercitazioni pratiche.
- Introduzione a Kaggle: questa guida illustra le nozioni di base per usare Kaggle, dalla partecipazione alle competizioni alla creazione del tuo primo notebook.
- Pagina Medium di Kaggle: scopri tutorial, aggiornamenti e contributi della community sulla pagina Medium di Kaggle.
- Addestra i modelli Ultralytics YOLO con l'integrazione Kaggle: questo post del blog mostra come usare Kaggle in particolare con i modelli Ultralytics YOLO.
Riepilogo#
Kaggle offre ai tuoi progetti YOLO26 accesso gratuito alle GPU per l'addestramento e la valutazione dei modelli, oltre a librerie preinstallate per iniziare rapidamente. Insieme, Ultralytics YOLO26 e Kaggle ti consentono di sviluppare, addestrare e distribuire modelli di visione artificiale senza hardware costoso.
Per ulteriori dettagli, visita la documentazione di Kaggle.
Domande frequenti#
Per installare Ultralytics YOLO26 su Kaggle:
- Attiva Internet: apri il pannello Settings e attiva l'opzione Internet
- Installa il pacchetto: esegui
!pip install ultralyticsin una cella del notebook - Verifica l'installazione: esegui
import ultralytics; ultralytics.checks()per confermare
Se riscontri conflitti tra dipendenze, prova
!pip install --upgrade --force-reinstall ultralyticsoppure riavvia il kernel dopo l'installazione. Per istruzioni dettagliate sulla risoluzione dei problemi, consulta la sezione Installazione qui sopra.Addestrare un modello YOLO26 su Kaggle è semplice. Per prima cosa, apri il notebook del tutorial Ultralytics YOLO26 su Kaggle. Accedi al tuo account Kaggle e seleziona una GPU nelle impostazioni dell'acceleratore. Esegui le celle del notebook per avviare l'addestramento. Per istruzioni più dettagliate, consulta la nostra guida all'addestramento dei modelli YOLO26.
Kaggle offre diversi vantaggi per l'addestramento dei modelli YOLO26:
- Accesso gratuito alle GPU: usa GPU come NVIDIA Tesla P100 o T4 x2 fino a 30 ore alla settimana.
- Librerie preinstallate: librerie come TensorFlow e PyTorch sono preinstallate, semplificando la configurazione.
- Collaborazione nella community: partecipa a una vasta community di data scientist e appassionati di machine learning.
- Controllo delle versioni: gestisci versioni diverse dei tuoi notebook e, se necessario, ripristina quelle precedenti.
I problemi comuni includono:
- Accesso alle GPU: assicurati di attivare una GPU nelle impostazioni del notebook. Kaggle consente fino a 30 ore di utilizzo della GPU alla settimana.
- Internet non attivo: assicurati di attivare Internet nel pannello Settings prima di installare i pacchetti.
- Conflitti tra dipendenze: usa
!pip install --upgrade --force-reinstall ultralytics. - Licenze dei dataset: controlla la licenza di ogni dataset per comprenderne le restrizioni d'uso.
- Salvataggio e commit dei notebook: fai clic su "Save Version" per salvare lo stato del notebook e accedere ai file di output dalla scheda Output.
- Collaborazione: Kaggle supporta la collaborazione asincrona; più utenti non possono modificare un notebook contemporaneamente.
Per altri suggerimenti sulla risoluzione dei problemi, consulta la sezione Installazione e la nostra guida ai problemi comuni.
Kaggle offre diverse funzionalità che lo distinguono da Google Colab:
- Notebook pubblici: condividi il tuo lavoro con la community per ricevere feedback e collaborare.
- Cronologia completa: monitora le modifiche nel tempo grazie alla cronologia dettagliata dei commit del notebook.
- Risorse disponibili: ogni sessione del notebook offre risorse significative, tra cui 12 ore di esecuzione per le sessioni CPU e GPU.
Per ripristinare una versione precedente:
- Apri il notebook e fai clic sui tre puntini verticali nell'angolo in alto a destra.
- Seleziona "View Versions".
- Individua la versione da ripristinare, fai clic sul menu "..." accanto ad essa e seleziona "Revert to Version".
- Fai clic su "Save Version" per registrare le modifiche.


Commenti3
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?