Esportazione nel formato di modello TF.js da un modello YOLO26#
A partire da Ultralytics 8.4.83, il formato di esportazione tfjs (TensorFlow.js) è stato rimosso e sostituito dal formato unificato Google LiteRT. LiteRT viene eseguito nel browser tramite LiteRT.js (con accelerazione WebGPU), supportando i casi d'uso nel browser e in Node.js gestiti da TF.js, oltre a quelli su dispositivi mobili, embedded ed edge, con un unico modello .tflite.
format="tfjs" continua a funzionare, ma genera un avviso di deprecazione ed esporta invece un modello LiteRT. Da ora in poi, usa format="litert"; per le istruzioni di esportazione aggiornate e il percorso di distribuzione nei browser, consulta la guida all'esportazione di LiteRT.
Distribuire modelli di machine learning direttamente nel browser o su Node.js può essere complicato. Devi assicurarti che il formato del modello sia ottimizzato per prestazioni più elevate, così da poterlo usare per eseguire applicazioni interattive in locale sul dispositivo dell'utente. Il formato di modello TensorFlow.js, o TF.js, è progettato per consumare poca energia e offrire prestazioni elevate.
La funzionalità «esporta nel formato di modello TF.js» ti consente di ottimizzare i tuoi modelli Ultralytics YOLO26 per eseguire inferenze ad alta velocità e in locale per il rilevamento di oggetti. In questa guida vedremo come convertire i tuoi modelli nel formato TF.js, in modo che funzionino al meglio con diversi browser locali e applicazioni Node.js.
Perché esportare nel formato TF.js?#
Esportare i tuoi modelli di machine learning in TensorFlow.js, sviluppato dal team TensorFlow come parte dell'ecosistema TensorFlow più ampio, offre numerosi vantaggi per la distribuzione di applicazioni di machine learning. Aiuta a migliorare la privacy e la sicurezza degli utenti, mantenendo i dati sensibili sul dispositivo. L'immagine seguente mostra l'architettura di TensorFlow.js e il modo in cui i modelli di machine learning vengono convertiti e distribuiti sia nei browser web sia su Node.js.
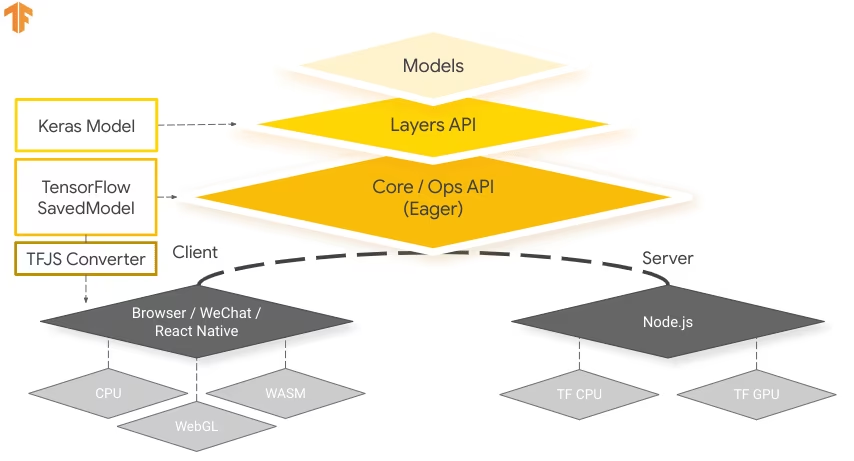
Eseguire i modelli in locale riduce anche la latenza e offre un'esperienza utente più reattiva. TensorFlow.js include inoltre funzionalità offline, che consentono agli utenti di usare la tua applicazione anche senza una connessione Internet. TF.js è progettato per eseguire in modo efficiente modelli complessi su dispositivi con risorse limitate ed è concepito per essere scalabile, con supporto per l'accelerazione GPU.
Caratteristiche principali di TF.js#
Ecco le caratteristiche principali che rendono TF.js uno strumento potente per gli sviluppatori:
-
Supporto multipiattaforma: TensorFlow.js può essere usato sia nei browser sia negli ambienti Node.js, offrendo flessibilità nella distribuzione su piattaforme diverse. Consente agli sviluppatori di creare e distribuire applicazioni con maggiore facilità.
-
Supporto per più backend: TensorFlow.js supporta diversi backend di calcolo, tra cui CPU, WebGL per l'accelerazione GPU, WebAssembly (WASM) per prestazioni vicine a quelle native e WebGPU per funzionalità avanzate di machine learning basate sul browser.
-
Funzionalità offline: con TensorFlow.js, i modelli possono essere eseguiti nel browser senza connessione Internet, consentendo di sviluppare applicazioni utilizzabili anche offline.
Opzioni di distribuzione con TensorFlow.js#
Prima di approfondire la procedura per esportare i modelli YOLO26 nel formato TF.js, esaminiamo alcuni scenari tipici di distribuzione in cui viene usato questo formato.
TF.js offre diverse opzioni per distribuire i tuoi modelli di machine learning:
-
Applicazioni di machine learning nel browser: puoi creare applicazioni web che eseguono i modelli di machine learning direttamente nel browser. In questo modo si elimina la necessità di calcoli lato server e si riduce il carico sul server.
-
Applicazioni Node.js: TensorFlow.js supporta anche la distribuzione negli ambienti Node.js, consentendo di sviluppare applicazioni di machine learning lato server. È particolarmente utile per le applicazioni che richiedono la potenza di calcolo di un server o l'accesso ai dati lato server.
-
Estensioni di Chrome: uno scenario di distribuzione interessante è la creazione di estensioni di Chrome con TensorFlow.js. Ad esempio, puoi sviluppare un'estensione che consenta agli utenti di fare clic con il tasto destro su un'immagine in qualsiasi pagina web e classificarla con un modello di ML preaddestrato. TensorFlow.js può essere integrato nelle attività di navigazione quotidiane per fornire informazioni o potenziamenti immediati basati sul machine learning.
Esportazione dei modelli YOLO26 in TensorFlow.js#
Puoi ampliare la compatibilità e la flessibilità di distribuzione convertendo i modelli YOLO26 in TF.js.
Installazione#
Per installare il pacchetto richiesto, esegui:
# Install the required package for YOLO26
pip install ultralytics
Per istruzioni dettagliate e best practice sulla procedura di installazione, consulta la nostra guida all'installazione di Ultralytics. Se durante l'installazione dei pacchetti necessari per YOLO26 riscontri difficoltà, consulta la nostra guida ai problemi comuni per trovare soluzioni e suggerimenti.
Utilizzo#
Tutti i modelli Ultralytics YOLO26 sono progettati per supportare l'esportazione senza configurazioni aggiuntive, semplificando l'integrazione nel workflow di distribuzione che preferisci. Puoi consultare l'elenco completo dei formati di esportazione supportati e delle opzioni di configurazione per scegliere la configurazione più adatta alla tua applicazione.
L'argomento tfjs ora esporta un modello LiteRT .tflite, che supporta le modalità Export, Predict e Validate in locale e viene eseguito nel browser tramite LiteRT.js. Consulta la guida all'esportazione di LiteRT per il percorso aggiornato di distribuzione nel browser e sul dispositivo.
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello nel formato LiteRT (sostituisce TF.js)
model.export(format="litert", imgsz=640) # usa imgsz=224 per la classificazioneIl modello LiteRT .tflite esportato si carica direttamente con yolo predict e yolo val e viene eseguito nel browser tramite LiteRT.js. Consulta la guida all'esportazione di LiteRT.
Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'litert' | Formato di destinazione del modello esportato; il valore deprecato 'tfjs' esporta in LiteRT. |
imgsz | int o tuple | 640 | Dimensione dell'immagine desiderata per l'input del modello. Può essere un intero per immagini quadrate o una tupla (height, width) per dimensioni specifiche. |
quantize | int o str | None | Precisione della quantizzazione: 8 (INT8 statica, pesi int8 + attivazioni int8; richiede la calibrazione data/fraction), 'w8a16' (statica, pesi int8 + attivazioni int16; richiede la calibrazione data/fraction), 'w8a32' (INT8 dinamica, pesi int8 + attivazioni FP32; non richiede calibrazione) oppure 32/non impostato (FP32). FP16 non viene esportato separatamente: un modello FP32 viene eseguito automaticamente in FP16 sui delegati GPU. Sostituisce i flag deprecati half/int8. |
batch | int | 1 | Specifica la dimensione batch per l'inferenza del modello esportato o il numero massimo di immagini che il modello esportato elaborerà contemporaneamente in modalità predict. |
data | str | None | Percorso YAML del dataset, essenziale per la quantizzazione; per la classificazione, invece, accetta una directory del dataset o il nome di un dataset integrato. Se omesso con quantize=8 o 'w8a16', Ultralytics seleziona il dataset di calibrazione predefinito per l'attività del modello. |
fraction | float, int o list | 1.0 | Sottoinsieme di calibrazione espresso come rapporto, numero di immagini o rapporti/conteggi [train, val, test]. Gli elenchi di due elementi lasciano completo test, mentre 0 lo esclude. |
device | str | None | Specifica il dispositivo per l'esportazione: CPU (device=cpu), MPS per Apple silicon (device=mps). |
Per ulteriori dettagli sul processo di esportazione, visita la pagina della documentazione Ultralytics dedicata all'esportazione.
Distribuzione dei modelli YOLO26 TensorFlow.js esportati#
Ora che hai esportato il tuo modello YOLO26, il passaggio successivo è distribuirlo. L'esportazione produce un modello LiteRT .tflite che viene eseguito sul dispositivo e nel browser tramite LiteRT.js: consulta la guida all'esportazione di LiteRT per il percorso aggiornato.
Per riferimento, di seguito trovi le risorse del runtime TensorFlow.js legacy:
-
Estensione di Chrome: ecco la documentazione per sviluppatori su come distribuire i modelli TF.js in un'estensione di Chrome.
-
Eseguire TensorFlow.js su Node.js: un post sul blog di TensorFlow sull'esecuzione diretta di TensorFlow.js su Node.js.
-
Distribuzione di un progetto TensorFlow.js su Node nel cloud: un post sul blog di TensorFlow sulla distribuzione di un modello TensorFlow.js su una piattaforma cloud.
Riepilogo#
In questa guida abbiamo imparato a esportare i modelli Ultralytics YOLO26 nel formato TensorFlow.js. Esportando in TF.js, puoi ottimizzare, distribuire e scalare i tuoi modelli YOLO26 su un'ampia gamma di piattaforme.
Per ulteriori dettagli sull'utilizzo, consulta la documentazione ufficiale di TensorFlow.js.
Per ulteriori informazioni sull'integrazione di Ultralytics YOLO26 con altre piattaforme e framework, non dimenticare di consultare la nostra pagina della guida all'integrazione. Troverai molte risorse utili per sfruttare al meglio YOLO26 nei tuoi progetti.
Domande frequenti#
Esportare i modelli Ultralytics YOLO26 nel formato TensorFlow.js (TF.js) è semplice. Puoi seguire questi passaggi:
Utilizzofrom ultralytics import YOLO # Carica un modello YOLO26 model = YOLO("yolo26n.pt") # Esporta il modello nel formato LiteRT (sostituisce TF.js) model.export(format="litert", imgsz=640) # usa imgsz=224 per la classificazione # Il modello '.tflite' esportato viene eseguito nel browser tramite LiteRT.js o in locale con yolo predict/val.Per ulteriori dettagli sulle opzioni di esportazione supportate, visita la pagina della documentazione di Ultralytics sulle opzioni di distribuzione.
Esportare i modelli YOLO26 in TensorFlow.js offre diversi vantaggi, tra cui:
- Esecuzione locale: i modelli possono essere eseguiti direttamente nel browser o su Node.js, riducendo la latenza e migliorando l'esperienza utente.
- Supporto multipiattaforma: TF.js supporta più ambienti, offrendo flessibilità nella distribuzione.
- Funzionalità offline: consente alle applicazioni di funzionare senza una connessione Internet, garantendo affidabilità e privacy.
- Accelerazione GPU: sfrutta WebGL per l'accelerazione GPU, ottimizzando le prestazioni sui dispositivi con risorse limitate.
TensorFlow.js è progettato specificamente per eseguire in modo efficiente modelli di ML nei browser e negli ambienti Node.js. Ecco come può essere utile per le applicazioni basate su browser:
- Riduce la latenza: esegue i modelli di machine learning in locale, fornendo risultati immediati senza dipendere dai calcoli lato server.
- Migliora la privacy: mantiene i dati sensibili sul dispositivo dell'utente, riducendo al minimo i rischi per la sicurezza.
- Consente l'utilizzo offline: i modelli possono funzionare senza una connessione Internet, garantendo un funzionamento costante.
- Supporta più backend: offre flessibilità con backend come CPU, WebGL, WebAssembly (WASM) e WebGPU per diverse esigenze di calcolo.
Vuoi saperne di più su TF.js? Consulta la guida ufficiale di TensorFlow.js.
Le caratteristiche principali di TensorFlow.js includono:
- Supporto multipiattaforma: TF.js può essere usato sia nei browser web sia su Node.js, offrendo ampia flessibilità di distribuzione.
- Più backend: supporta CPU, WebGL per l'accelerazione GPU, WebAssembly (WASM) e WebGPU per operazioni avanzate.
- Funzionalità offline: i modelli possono essere eseguiti direttamente nel browser senza connessione Internet, caratteristica ideale per sviluppare applicazioni web reattive.
Per conoscere gli scenari di distribuzione e approfondire l'argomento, consulta la sezione sulle opzioni di distribuzione con TensorFlow.js.
Sì, TensorFlow.js consente di distribuire modelli YOLO26 negli ambienti Node.js. Ciò permette di creare applicazioni di machine learning lato server che sfruttano la potenza di calcolo di un server e l'accesso ai dati lato server. Tra i casi d'uso tipici rientrano l'elaborazione dei dati in tempo reale e le pipeline di machine learning sui server backend.
Per iniziare a distribuire su Node.js, consulta la guida di TensorFlow Eseguire TensorFlow.js su Node.js.