SAM 2: Segment Anything Model 2

SAM 2, successore del Segment Anything Model (SAM) di Meta, è un modello unificato per la segmentazione di oggetti guidata da prompt in immagini e video. La sua singola architettura interattiva supporta l'elaborazione in tempo reale e la generalizzazione zero-shot.
I modelli SAM 2.1 alimentano la funzionalità di annotazione intelligente sulla piattaforma Ultralytics, consentendo la segmentazione basata sui clic per etichettare rapidamente i dataset. Per i dettagli, consulta la guida all'annotazione.
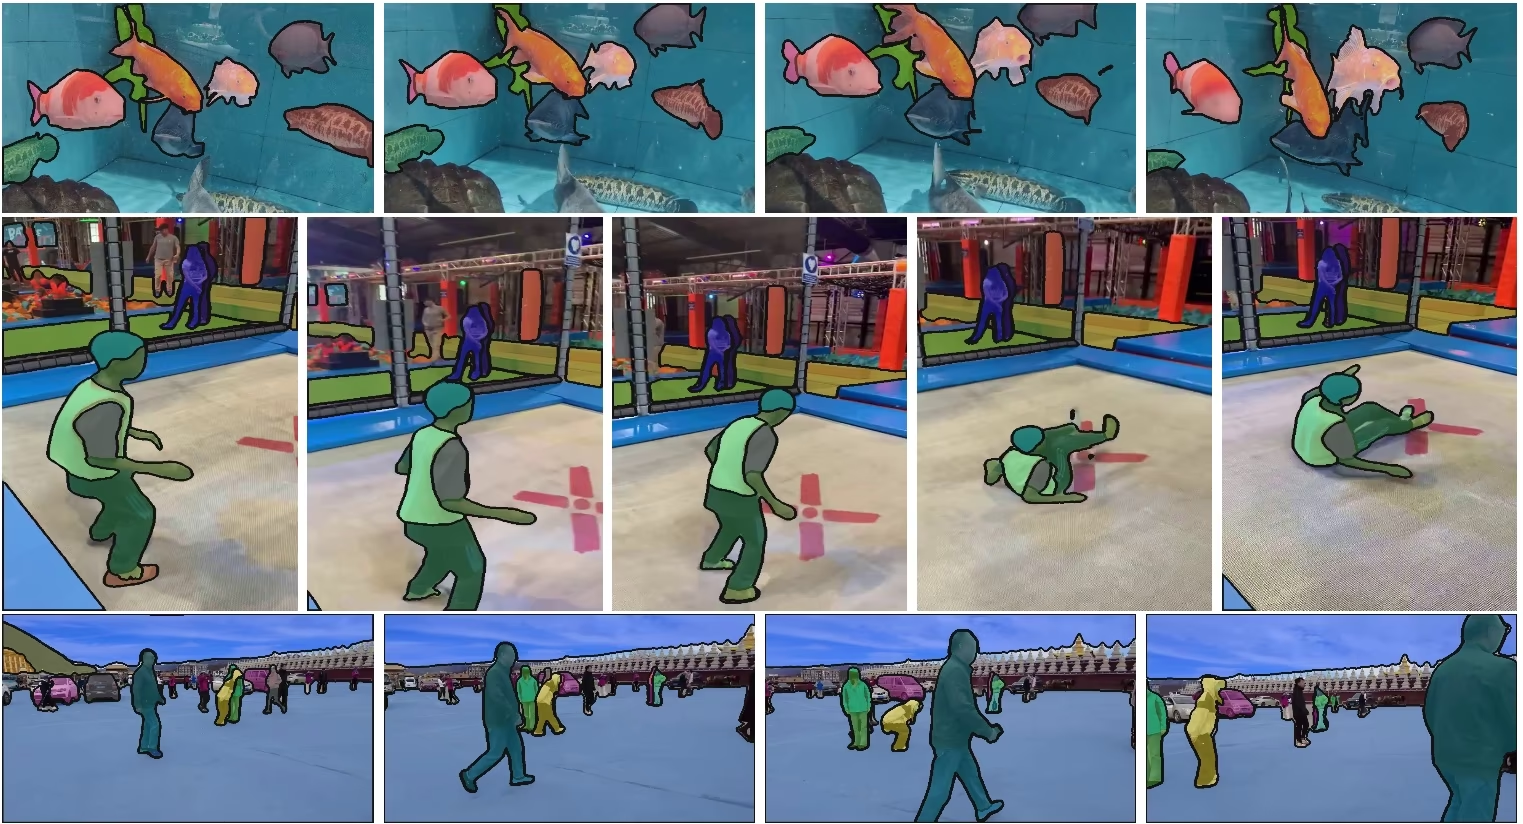
Funzionalità principali#
Guarda: Come eseguire l'inferenza con SAM2 di Meta usando Ultralytics | Guida passo passo
Architettura unificata del modello#
SAM 2 combina le funzionalità di segmentazione di immagini e video in un unico modello. Questa unificazione semplifica la distribuzione e garantisce prestazioni coerenti con diversi tipi di contenuti multimediali. Utilizza un'interfaccia flessibile basata su prompt, che consente agli utenti di specificare gli oggetti di interesse con vari tipi di prompt, come punti, riquadri di delimitazione o maschere.
Prestazioni in tempo reale#
Il modello raggiunge velocità di inferenza in tempo reale, elaborando circa 44 fotogrammi al secondo. Questo rende SAM 2 adatto alle applicazioni che richiedono un riscontro immediato, come il montaggio video e la realtà aumentata.
Generalizzazione zero-shot#
SAM 2 è in grado di segmentare oggetti che non ha mai incontrato prima, dimostrando una solida capacità di generalizzazione zero-shot. Questa caratteristica è particolarmente utile in domini visivi diversificati o in evoluzione, in cui le categorie predefinite potrebbero non includere tutti gli oggetti possibili.
Raffinamento interattivo#
Gli utenti possono perfezionare iterativamente i risultati della segmentazione fornendo prompt aggiuntivi, così da controllare con precisione l'output. Questa interattività è essenziale per perfezionare i risultati in applicazioni come l'annotazione video o la diagnostica per immagini.
Gestione avanzata delle sfide visive#
SAM 2 include meccanismi per gestire le sfide più comuni della segmentazione video, come l'occlusione e la ricomparsa degli oggetti. Utilizza un meccanismo di memoria per tenere traccia degli oggetti tra i fotogrammi, garantendo la continuità anche quando gli oggetti vengono temporaneamente nascosti o escono dalla scena per poi rientrarvi.
Per approfondire l'architettura e le capacità di SAM 2, esplora il paper di ricerca su SAM 2.
Prestazioni e dettagli tecnici#
Secondo Meta, SAM 2 supera i modelli precedenti in diverse metriche:
| Metrica | SAM 2 | SOTA precedente |
|---|---|---|
| Segmentazione video interattiva | Migliore | - |
| Interazioni umane richieste | 3 volte in meno | Baseline |
| Accuratezza della segmentazione delle immagini | Migliorata | SAM |
| Velocità di inferenza | 6 volte più veloce | SAM |
Architettura del modello#
Componenti principali#
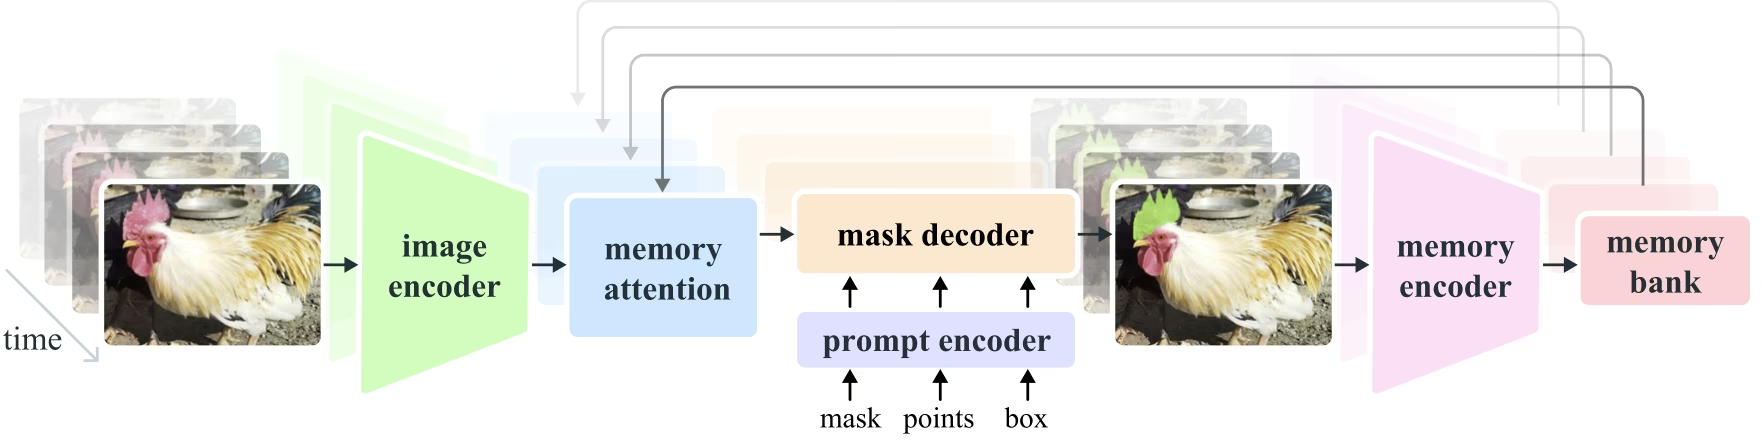
- Encoder di immagini e video: utilizza un'architettura basata su Transformer per estrarre caratteristiche di alto livello sia dalle immagini sia dai fotogrammi video. Questo componente ha il compito di comprendere il contenuto visivo a ogni istante temporale.
- Encoder dei prompt: elabora i prompt forniti dall'utente (punti, riquadri, maschere) per guidare l'attività di segmentazione. In questo modo SAM 2 può adattarsi agli input dell'utente e individuare oggetti specifici nella scena.
- Meccanismo di memoria: include un encoder di memoria, una banca di memoria e un modulo di attenzione alla memoria. Questi componenti memorizzano e utilizzano congiuntamente le informazioni dei fotogrammi precedenti, consentendo al modello di mantenere coerente nel tempo il tracciamento degli oggetti.
- Decoder delle maschere: genera le maschere di segmentazione finali in base alle caratteristiche dell'immagine e ai prompt codificati. Nei video utilizza anche il contesto della memoria per garantire un tracciamento accurato tra i fotogrammi.
Meccanismo di memoria e gestione delle occlusioni#
Il meccanismo di memoria consente a SAM 2 di gestire le dipendenze temporali e le occlusioni nei dati video. Quando gli oggetti si muovono e interagiscono, SAM 2 ne registra le caratteristiche in un archivio di memoria. Quando un oggetto viene occluso, il modello può fare affidamento su questa memoria per prevederne la posizione e l'aspetto al momento della ricomparsa. La testa di occlusione gestisce in modo specifico gli scenari in cui gli oggetti non sono visibili, prevedendo la probabilità che un oggetto sia occluso.
Risoluzione dell'ambiguità con maschere multiple#
In situazioni ambigue (ad es. con oggetti sovrapposti), SAM 2 può generare più previsioni di maschere. Questo aiuta a rappresentare scene complesse in cui una singola maschera potrebbe non catturare l'oggetto desiderato.
Dataset SA-V#
Il dataset SA-V, sviluppato per l'addestramento di SAM 2, è uno dei dataset di segmentazione video più grandi e diversificati disponibili. Include:
- Oltre 51.000 video: acquisiti in 47 paesi, offrono un'ampia varietà di scenari reali.
- Oltre 600.000 annotazioni di maschere: annotazioni spazio-temporali dettagliate delle maschere, denominate "masklet", che coprono oggetti interi e parti di oggetti.
- Dimensioni del dataset: include 4.5 volte più video e 53 volte più annotazioni rispetto ai precedenti dataset di segmentazione video più grandi.
Benchmark#
Segmentazione di oggetti nei video#
SAM 2 riporta i seguenti risultati nei principali benchmark di segmentazione video:
| Dataset | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
Segmentazione interattiva#
Nelle attività di segmentazione interattiva, SAM 2 raggiunge i seguenti risultati:
| Dataset | NoC@90 | AUC |
|---|---|---|
| DAVIS interattivo | 1.54 | 0.872 |
Installazione#
SAM 2 è incluso nel pacchetto ultralytics. Installalo con il comando seguente; i pesi di SAM 2 vengono scaricati automaticamente al primo utilizzo.
pip install ultralyticsCome usare SAM 2: versatilità nella segmentazione di immagini e video#
La tabella seguente descrive i modelli SAM 2 disponibili, i relativi pesi preaddestrati, le attività supportate e la compatibilità con diverse modalità operative, come Training, Validation, Inference ed Export.
| Tipo di modello | Pesi preaddestrati | Attività supportate | Addestramento | Validazione | Inferenza | Esporta |
|---|---|---|---|---|---|---|
| SAM 2 tiny | sam2_t.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
| SAM 2 small | sam2_s.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
| SAM 2 base | sam2_b.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
| SAM 2 large | sam2_l.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 tiny | sam2.1_t.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 small | sam2.1_s.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 base | sam2.1_b.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 large | sam2.1_l.pt | Segmentazione di istanze | ❌ | ❌ | ✅ | ❌ |
Esempi di predizioni di SAM 2#
SAM 2 può essere utilizzato in un'ampia gamma di attività, tra cui il montaggio video in tempo reale, la diagnostica per immagini e i sistemi autonomi. La capacità di segmentare sia dati visivi statici sia dinamici lo rende uno strumento versatile per ricercatori e sviluppatori.
Segmentazione con prompt#
Usa i prompt per segmentare oggetti specifici nelle immagini o nei video.
from ultralytics import SAM

# Carica un modello
model = SAM("sam2.1_b.pt")

# Visualizza le informazioni sul modello (facoltativo)
model.info()

# Esegui l'inferenza con il prompt dei riquadri di delimitazione
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Esegui l'inferenza con un singolo punto
results = model(points=[900, 370], labels=[1])

# Esegui l'inferenza con più punti
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])

# Esegui l'inferenza con il prompt a più punti per oggetto
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Esegui l'inferenza con il prompt dei punti negativi
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Segmenta tutto#
Segmenta l'intero contenuto dell'immagine o del video senza prompt specifici.
from ultralytics import SAM

# Carica un modello
model = SAM("sam2.1_b.pt")

# Visualizza le informazioni sul modello (facoltativo)
model.info()

# Esegui l'inferenza
model("path/to/video.mp4")- Questo esempio mostra come usare SAM 2 per segmentare l'intero contenuto di un'immagine o di un video quando non vengono forniti prompt (riquadri di delimitazione/punti/maschere).
Segmenta il video e traccia gli oggetti#
Segmenta l'intero contenuto del video con prompt specifici e traccia gli oggetti.
from ultralytics.models.sam import SAM2VideoPredictor

# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)

# Esegui l'inferenza con un singolo punto
results = predictor(source="test.mp4", points=[920, 470], labels=[1])

# Esegui l'inferenza con più punti
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])

# Esegui l'inferenza con il prompt a più punti per oggetto
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])

# Esegui l'inferenza con il prompt dei punti negativi
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])
Segmentazione e tracciamento interattivi dinamici#
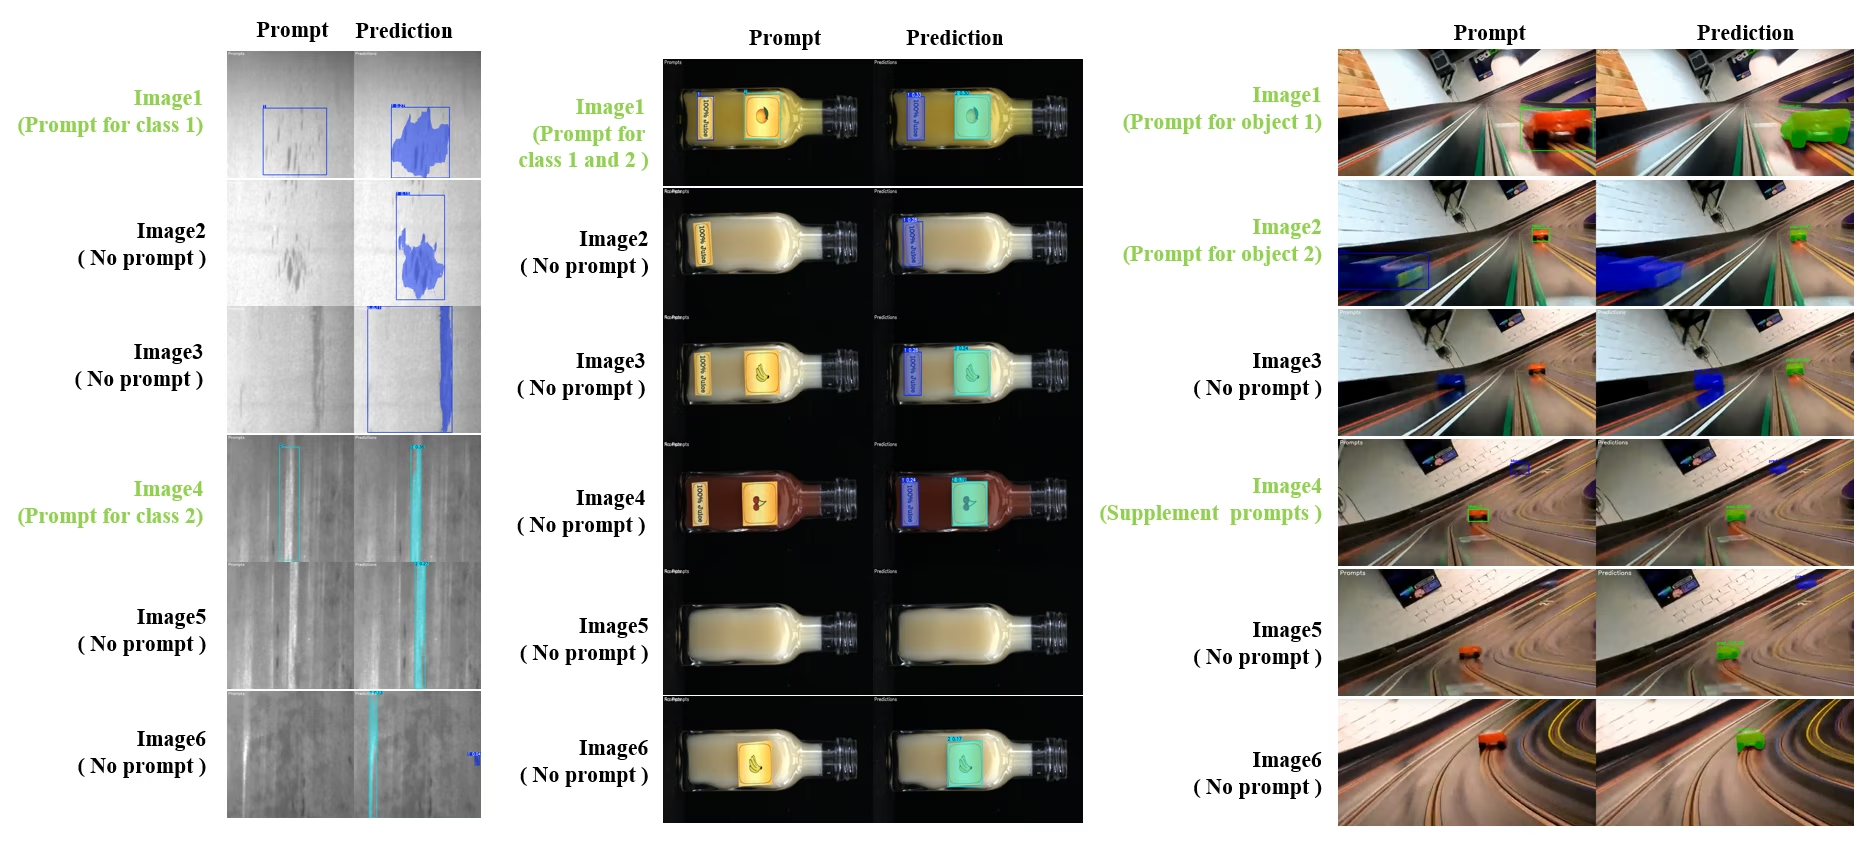
SAM2DynamicInteractivePredictor è un'estensione di SAM 2 che non richiede addestramento e consente l'interazione dinamica con più fotogrammi, oltre a funzionalità di apprendimento continuo. Questo predittore supporta aggiornamenti dei prompt in tempo reale e la gestione della memoria per migliorare il tracciamento lungo una sequenza di immagini. Rispetto a SAM 2 originale, SAM2DynamicInteractivePredictor ricostruisce il flusso di inferenza per sfruttare al meglio i modelli SAM 2 preaddestrati senza richiedere ulteriore addestramento.
Funzionalità principali#
Offre tre miglioramenti:
- Interattività dinamica: aggiungi in qualsiasi momento durante l'elaborazione video dei prompt per nuove istanze non tracciate nei fotogrammi successivi
- Apprendimento continuo: aggiungi nuovi prompt per le istanze esistenti per migliorare le prestazioni del modello nel tempo
- Supporto indipendente per più immagini: elabora più immagini indipendenti (non necessariamente appartenenti a una sequenza video) condividendo la memoria e tracciando gli oggetti tra le immagini
Funzionalità principali#
- Flessibilità dei prompt: accetta riquadri di delimitazione, punti e maschere come prompt
- Gestione dell'archivio di memoria: mantiene un archivio di memoria dinamico per memorizzare gli stati degli oggetti tra i fotogrammi
- Tracciamento di più oggetti: supporta il tracciamento simultaneo di più oggetti con ID individuali
- Aggiornamenti in tempo reale: consente di aggiungere nuovi prompt durante l'inferenza senza rielaborare i fotogrammi precedenti
- Elaborazione indipendente delle immagini: elabora immagini autonome con un contesto di memoria condiviso per mantenere la coerenza degli oggetti tra le immagini
from ultralytics.models.sam import SAM2DynamicInteractivePredictor

# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)

# Definisci una categoria con il prompt di un riquadro
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)

# Rileva questo oggetto specifico in una nuova immagine
results = predictor(source="image2.jpg")

# Aggiungi una nuova categoria con un nuovo ID oggetto
results = predictor(
    source="image4.jpg",
    bboxes=[[300, 300, 400, 400]],  # Nuovo oggetto
    obj_ids=[1],  # Nuovo ID oggetto
    update_memory=True,  # Aggiungi alla memoria
)
# Esegui l'inferenza
results = predictor(source="image5.jpg")

# Aggiungi prompt di perfezionamento alla stessa categoria per migliorare le prestazioni
# È utile quando l'aspetto degli oggetti cambia in modo significativo
results = predictor(
    source="image6.jpg",
    points=[[150, 150]],  # Punto di perfezionamento
    labels=[1],  # Punto positivo
    obj_ids=[1],  # Stesso ID oggetto
    update_memory=True,  # Aggiorna la memoria con nuove informazioni
)
# Esegui l'inferenza sulla nuova immagine
results = predictor(source="image7.jpg")SAM2DynamicInteractivePredictor è progettato per funzionare con i modelli SAM 2 e supporta l'aggiunta e il perfezionamento delle categorie con tutti i prompt con riquadro, punto e maschera supportati nativamente da SAM 2. È particolarmente utile in scenari in cui gli oggetti appaiono o cambiano nel tempo, ad esempio nell'annotazione di video o nelle attività di modifica interattiva.
Argomenti#
| Nome | Valore predefinito | Tipo di dati | Descrizione |
|---|---|---|---|
max_obj_num | 3 | int | Numero massimo preimpostato di categorie |
update_memory | False | bool | Indica se aggiornare la memoria con i nuovi prompt |
obj_ids | None | List[int] | Elenco degli ID oggetto corrispondenti ai prompt |
Casi d'uso#
SAM2DynamicInteractivePredictor è ideale per:
- Flussi di lavoro di annotazione video in cui compaiono nuovi oggetti durante la sequenza
- Modifica interattiva di video che richiede l'aggiunta e il perfezionamento degli oggetti in tempo reale
- Applicazioni di sorveglianza che richiedono il tracciamento dinamico degli oggetti
- Imaging medico per tracciare strutture anatomiche attraverso serie temporali
- Sistemi autonomi che richiedono il rilevamento e il tracciamento adattivi degli oggetti
- Dataset multi-immagine per una segmentazione coerente degli oggetti in immagini indipendenti
- Analisi di raccolte di immagini in cui occorre tracciare gli oggetti in scene diverse
- Segmentazione cross-domain che sfrutta la memoria derivata da contesti visivi diversi
- Annotazione semiautomatica per creare dataset in modo efficiente, con un intervento manuale minimo
Confronto tra SAM e YOLO#
Qui confrontiamo i modelli SAM 2 di Meta, inclusa la variante più piccola SAM2-t, con i modelli di segmentazione di Ultralytics, incluso YOLO26:
| Modello | Dimensione (MB) | Parametri (M) | Velocità (CPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s con backbone YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (11.0x più piccolo) | 3.4 (11.4x in meno) | 24.8 (945x più veloce) |
| Ultralytics YOLO11n-seg | 6.2 (12.6x più piccolo) | 2.9 (13.4x in meno) | 24.3 (964x più veloce) |
| Ultralytics YOLO26n-seg | 6.7 (11.7x più piccolo) | 2.7 (14.4x in meno) | 25.2 (930x più veloce) |
Questo confronto evidenzia le notevoli differenze nelle dimensioni e nella velocità dei modelli tra le varianti SAM e i modelli di segmentazione YOLO. Sebbene SAM offra capacità uniche di segmentazione automatica, i modelli YOLO, in particolare YOLOv8n-seg, YOLO11n-seg e YOLO26n-seg, sono significativamente più piccoli, più veloci e più efficienti dal punto di vista computazionale.
Le velocità di SAM sono state misurate con PyTorch, quelle di YOLO con ONNX Runtime. I test sono stati eseguiti su un Apple M4 Air del 2025 con 16 GB di RAM usando torch==2.10.0, ultralytics==8.4.31 e onnxruntime==1.24.4. Per riprodurre questo test:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Profila SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Profilo FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Profila i modelli YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Head senza NMS di YOLO26; non fa nulla per YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Annotazione automatica: creazione efficiente di dataset#
L'annotazione automatica abbina SAM 2 a un modello di rilevamento preaddestrato per generare rapidamente dataset di segmentazione, senza un'ampia etichettatura manuale. Ultralytics Platform offre anche l'annotazione automatica tramite browser con modelli visivi ospitati; confronta la loro accuratezza di rilevamento, i costi e la velocità nella classifica VLM.
Come eseguire l'annotazione automatica con SAM 2#
Guarda: Annotazione automatica con Segment Anything 2 di Meta usando Ultralytics | Etichettatura dei dati
Per annotare automaticamente il tuo dataset con un rilevatore YOLO26x e SAM 2, segui questo esempio:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
data | str | obbligatorio | Percorso della directory contenente le immagini di destinazione da annotare o segmentare. |
det_model | str | 'yolo26x.pt' | Percorso del modello di rilevamento YOLO per il rilevamento iniziale degli oggetti. |
sam_model | str | 'sam_b.pt' | Percorso del modello SAM per la segmentazione (supporta i pesi di SAM, SAM 2, MobileSAM e SAM 3). |
device | str | '' | Dispositivo di calcolo (ad es. 'cuda:0', 'cpu' o '' per il rilevamento automatico del dispositivo). |
conf | float | 0.25 | Soglia di confidenza del rilevamento YOLO per filtrare i rilevamenti deboli. |
iou | float | 0.5 | Soglia IoU per la soppressione non massima, usata per filtrare i riquadri sovrapposti. |
imgsz | int | 640 | Dimensione di input per ridimensionare le immagini (arrotondata al multiplo di 32 più vicino per eccesso, se necessario). |
max_det | int | 300 | Numero massimo di rilevamenti per immagine per ottimizzare l'uso della memoria. |
classes | list[int] | None | Elenco degli indici delle classi da rilevare (ad es. [0, 1] per persona e bicicletta). |
output_dir | str | None | Directory in cui salvare le annotazioni (per impostazione predefinita: directory sorella di <data>_auto_annotate_labels). |
Questa funzione trasforma una cartella di immagini senza etichette in un dataset di segmentazione, con un intervento manuale minimo.
Limitazioni#
Nonostante i suoi punti di forza, SAM 2 presenta alcune limitazioni:
- Stabilità del tracciamento: SAM 2 può perdere di vista gli oggetti durante sequenze prolungate o in caso di cambiamenti significativi del punto di vista.
- Confusione tra oggetti: a volte il modello può confondere oggetti dall'aspetto simile, soprattutto nelle scene affollate.
- Efficienza con più oggetti: l'efficienza della segmentazione diminuisce quando si elaborano più oggetti contemporaneamente, a causa della mancanza di comunicazione tra gli oggetti.
- Accuratezza dei dettagli: Accuratezza Può non rilevare i dettagli più fini, soprattutto con oggetti in rapido movimento. Prompt aggiuntivi possono risolvere parzialmente il problema, ma non garantiscono la fluidità temporale.
Citazioni e ringraziamenti#
Se usi SAM 2 nelle tue attività di ricerca o sviluppo, citale usando il riferimento seguente:
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
Ringraziamo Meta AI per aver rilasciato questo modello e dataset alla comunità dell'intelligenza artificiale.
Domande frequenti#
SAM 2, successore di Segment Anything Model (SAM) di Meta, è un modello unificato e utilizzabile con prompt per segmentare oggetti sia nelle immagini sia nei video. SAM 2 offre diversi miglioramenti rispetto al SAM originale, tra cui:
- Architettura unificata del modello: combina le funzionalità di segmentazione di immagini e video in un unico modello.
- Prestazioni in tempo reale: elabora circa 44 fotogrammi al secondo, risultando adatto ad applicazioni che richiedono un riscontro immediato.
- Generalizzazione zero-shot: segmenta oggetti mai incontrati prima, caratteristica utile in domini visivi diversi.
- Perfezionamento interattivo: consente agli utenti di perfezionare iterativamente i risultati della segmentazione fornendo prompt aggiuntivi.
- Gestione avanzata delle sfide visive: gestisce le sfide comuni della segmentazione video, come l'occlusione e la ricomparsa degli oggetti.
Per maggiori dettagli sull'architettura e sulle funzionalità di SAM 2, consulta il documento di ricerca su SAM 2.
SAM 2 supporta la segmentazione video in tempo reale grazie alla sua interfaccia utilizzabile con prompt e all'inferenza rapida. Ecco un esempio di base:
Segmentazione con promptUsa i prompt per segmentare oggetti specifici nelle immagini o nei video.
from ultralytics import SAM

# Carica un modello
model = SAM("sam2_b.pt")

# Visualizza le informazioni sul modello (facoltativo)
model.info()

# Segmenta con un prompt di riquadro di delimitazione
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Segmenta con un prompt puntuale
results = model("path/to/image.jpg", points=[150, 150], labels=[1])
Per informazioni più complete sull'utilizzo, consulta la sezione Come usare SAM 2.
SAM 2 viene addestrato sul dataset SA-V, uno dei dataset di segmentazione video più grandi e diversificati disponibili. Il dataset SA-V include:
- Oltre 51.000 video: acquisiti in 47 paesi, offrono un'ampia varietà di scenari reali.
- Oltre 600.000 annotazioni di maschere: annotazioni spazio-temporali dettagliate delle maschere, denominate "masklet", che coprono oggetti interi e parti di oggetti.
- Dimensioni del dataset: include 4,5 volte più video e 53 volte più annotazioni rispetto ai precedenti dataset più grandi, offrendo una diversità e una complessità senza precedenti.
Questo dataset consente a SAM 2 di ottenere risultati eccellenti nei principali benchmark di segmentazione video e migliora le sue capacità di generalizzazione zero-shot.
SAM 2 include un meccanismo di memoria per gestire le dipendenze temporali e le occlusioni nei dati video. Il meccanismo di memoria è composto da:
- Codificatore della memoria e banca della memoria: memorizzano le caratteristiche dei fotogrammi precedenti.
- Modulo di attenzione alla memoria: usa le informazioni memorizzate per mantenere coerente il tracciamento degli oggetti nel tempo.
- Testa di occlusione: gestisce specificamente gli scenari in cui gli oggetti non sono visibili, prevedendo la probabilità che un oggetto sia occluso.
Questo meccanismo garantisce la continuità anche quando gli oggetti vengono temporaneamente oscurati o escono dalla scena per poi rientrarvi. Per maggiori dettagli, consulta la sezione Meccanismo di memoria e gestione delle occlusioni.
I modelli SAM 2, come SAM2-t e SAM2-b di Meta, offrono potenti funzionalità di segmentazione zero-shot, ma sono significativamente più grandi e lenti rispetto ai modelli YOLO. Ad esempio, YOLO26n-seg è circa 24 volte più piccolo e oltre 1145 volte più veloce di SAM2-b su CPU. SAM 2 eccelle negli scenari di segmentazione versatili, basati su prompt e zero-shot, mentre YOLO26 è ottimizzato per velocità, efficienza e applicazioni in tempo reale grazie all'inferenza end-to-end senza NMS, il che lo rende più adatto alla distribuzione in ambienti con risorse limitate.


Commenti150
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(modificato)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(modificato)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(modificato)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(modificato)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.