Padroneggiare la distribuzione di YOLOv5 sulla VM Deep Learning di Google Cloud Platform (GCP)#
Google Cloud Platform (GCP) è una piattaforma di cloud computing la cui Deep Learning VM è preconfigurata per attività di data science e machine learning (ML). Questo tutorial illustra la configurazione di Ultralytics YOLOv5 su una Deep Learning VM di GCP. Che tu sia agli inizi con ML o abbia già esperienza, offre un percorso chiaro per addestrare ed eseguire modelli di rilevamento degli oggetti con YOLOv5.
Anche i nuovi utenti GCP possono richiedere un'offerta di 300 $ in crediti gratuiti per iniziare.
Altre opzioni di avvio rapido per YOLOv5 includono il nostro notebook Google Colab  per lavorare nel browser, oppure la scalabilità di Amazon AWS. Puoi anche usare la nostra immagine Docker ufficiale disponibile su Docker Hub

Passaggio 1: crea e configura la tua VM Deep Learning#
Inizia creando una macchina virtuale ottimizzata per il deep learning:
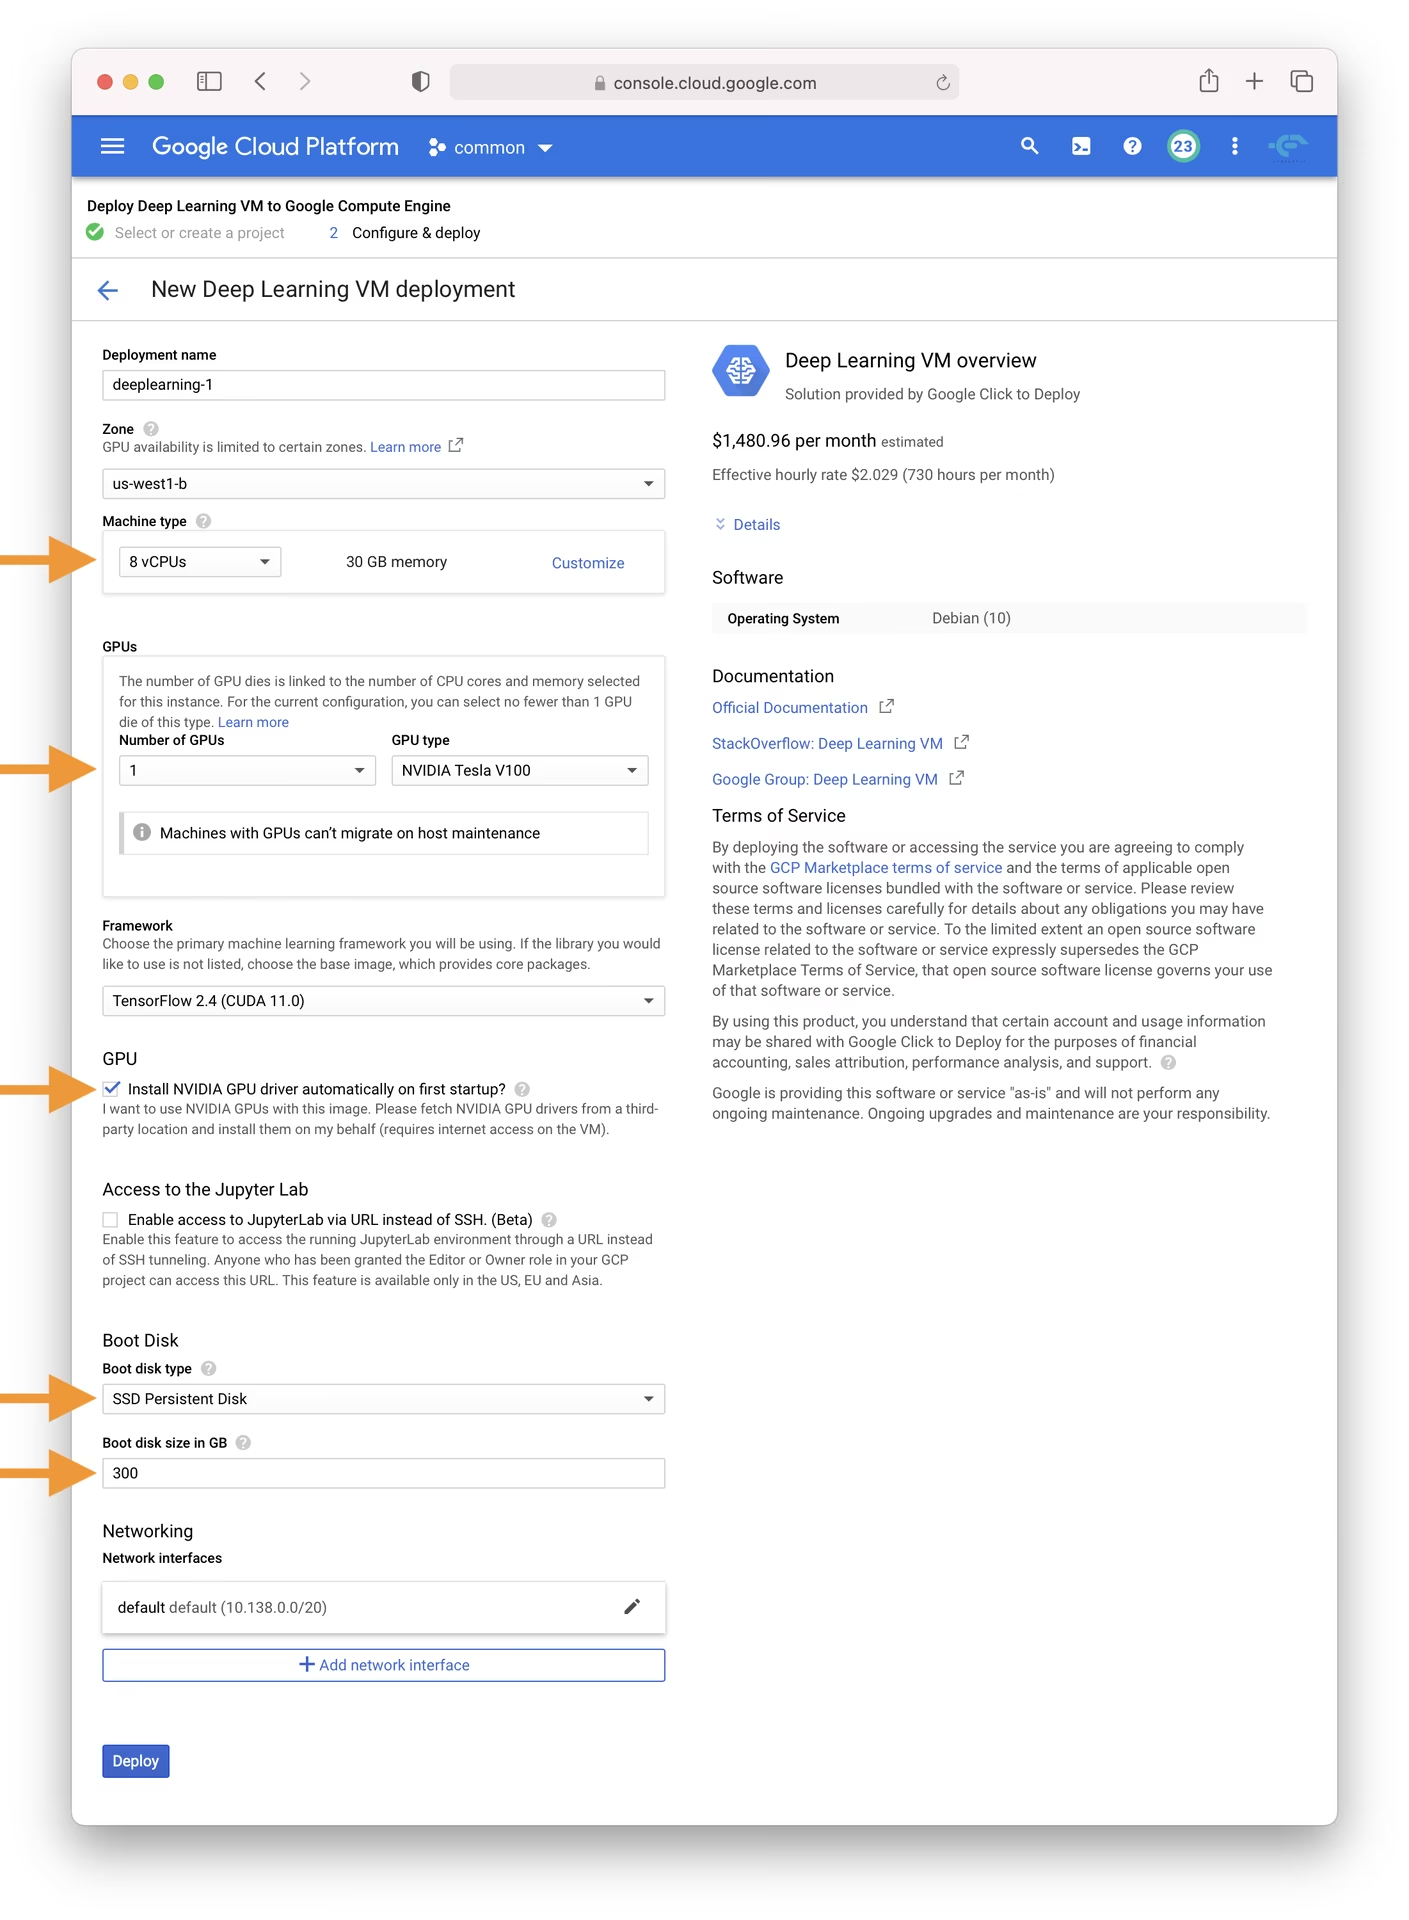
- Vai al marketplace GCP e seleziona Deep Learning VM.
- Scegli un'istanza n1-standard-8: offre un buon equilibrio con 8 vCPU e 30 GB di memoria, adatto a molte attività di ML.
- Seleziona una GPU. La scelta dipende dal tuo carico di lavoro; anche una GPU T4 di base accelererà notevolmente il training del modello.
- Seleziona la casella «Installare automaticamente il driver della GPU NVIDIA al primo avvio?».
- Assegna un disco SSD persistente da 300 GB per evitare colli di bottiglia nell'I/O.
- Fai clic su 'Deploy' e attendi che GCP configuri la tua VM Deep Learning personalizzata.
Questa VM include già strumenti e framework essenziali, tra cui la distribuzione Python Anaconda, che comprende comodamente molte dipendenze necessarie per YOLOv5.
Passaggio 2: prepara la VM per YOLOv5#
Quindi installa YOLOv5 e le relative dipendenze:
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install dependencies
pip install -r requirements.txt
YOLOv5 richiede Python 3.8.0 o versioni successive e PyTorch 1.8 o versioni successive. Gli script scaricano automaticamente modelli e dataset dall'ultima release di YOLOv5, semplificando l'avvio dell'addestramento del modello.
Passaggio 3: addestra e distribuisci i tuoi modelli YOLOv5#
Completata la configurazione, puoi addestrare, convalidare, eseguire previsioni ed esportare con YOLOv5 sulla tua VM GCP:
# Train a YOLOv5 model on your dataset (e.g., yolov5s)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the trained model to check Precision, Recall, and mAP
python val.py --weights yolov5s.pt --data coco128.yaml

# Run inference using the trained model on images or videos
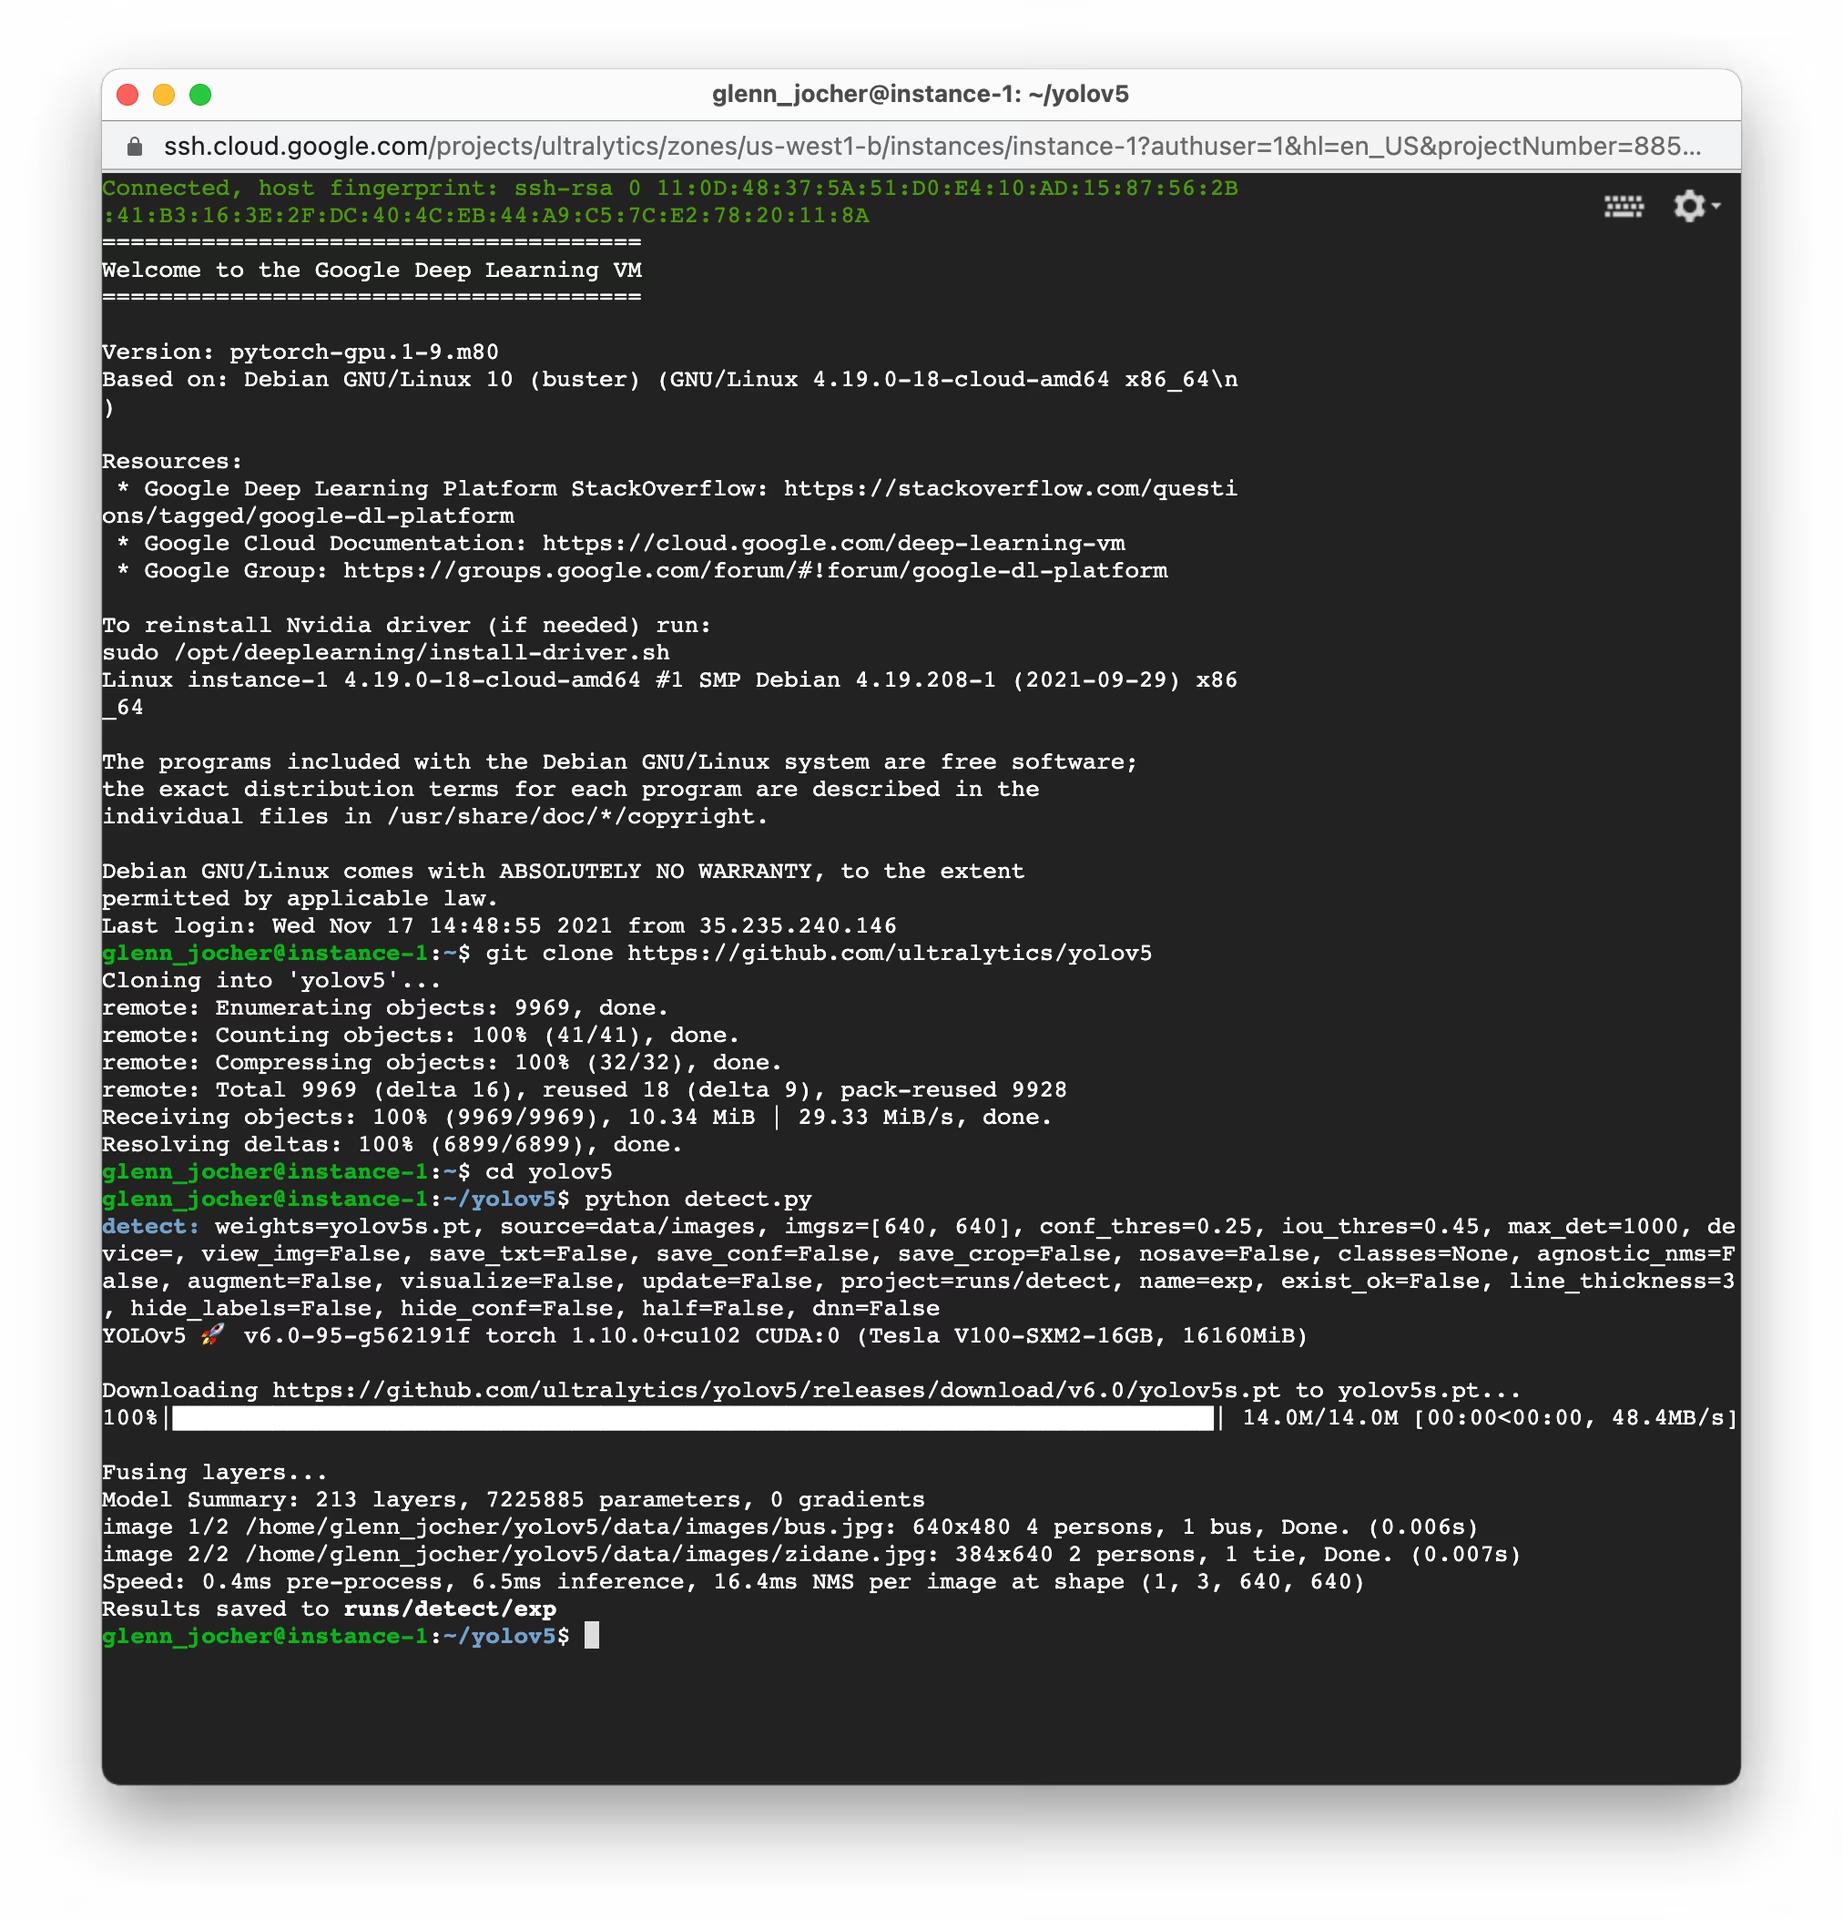
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite
Con pochi comandi puoi addestrare modelli personalizzati di rilevamento degli oggetti su misura per le tue esigenze oppure partire da pesi preaddestrati per ottenere risultati rapidamente.
Assegnare spazio di swap (facoltativo)#
Se lavori con dataset particolarmente grandi, che potrebbero superare la RAM della VM, valuta l'aggiunta di spazio di swap per evitare errori di memoria:
# Allocate a 64GB swap file
sudo fallocate -l 64G /swapfile

# Set the correct permissions for the swap file
sudo chmod 600 /swapfile

# Set up the Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap space allocation (should show increased swap memory)
free -h
Addestramento di dataset personalizzati#
Per addestrare YOLOv5 sul tuo dataset personalizzato in GCP, segui questi passaggi generali:
-
Prepara il dataset nel formato YOLO (immagini e relativi file di etichette). Consulta la nostra panoramica sui dataset per indicazioni.
-
Carica il dataset sulla tua VM GCP usando
gcloud compute scpo la funzionalità SSH della console web. -
Crea un file YAML di configurazione del dataset (
custom_dataset.yaml) che specifichi i percorsi dei dati di training e convalida, il numero di classi e i nomi delle classi. -
Avvia il processo di training usando il file YAML del tuo dataset personalizzato e, se vuoi, partendo da pesi preaddestrati:
# Example: Train YOLOv5s on a custom dataset for 100 epochs
python train.py --img 640 --batch 16 --epochs 100 --data custom_dataset.yaml --weights yolov5s.pt
Per istruzioni complete sulla preparazione dei dati e sul training con dataset personalizzati, consulta il tutorial Addestramento con dati personalizzati.
Sfruttare lo spazio di archiviazione cloud#
Per gestire i dati in modo efficiente, soprattutto con dataset grandi o numerosi esperimenti, integra il flusso di lavoro YOLOv5 con Google Cloud Storage:
# Ensure Google Cloud SDK is installed and initialized
# If not installed: curl https://sdk.cloud.google.com/ | bash
# Then initialize: gcloud init

# Example: Copy your dataset from a GCS bucket to your VM
gsutil cp -r gs://your-data-bucket/my_dataset ./datasets/

# Example: Copy trained model weights from your VM to a GCS bucket
gsutil cp -r ./runs/train/exp/weights gs://your-models-bucket/yolov5_custom_weights/
Questo approccio ti permette di archiviare nel cloud dataset di grandi dimensioni e modelli addestrati in modo sicuro e conveniente, riducendo al minimo lo spazio di archiviazione richiesto sulla tua istanza VM.
Considerazioni finali#
Ora Ultralytics YOLOv5 è in esecuzione su una Deep Learning VM di Google Cloud Platform, pronta per progetti di rilevamento degli oggetti che spaziano dagli esperimenti personali e dalla ricerca accademica alle soluzioni industriali.
Puoi usare Ultralytics Platform per addestrare e gestire i tuoi modelli senza scrivere codice.
Per domande e collaborazioni, partecipa alle discussioni su GitHub.
Domande frequenti#
Una macchina
n1-standard-8con una sola GPU T4 è sufficiente per la maggior parte delle attività di training e inferenza con YOLOv5. Passa a una L4 o A100 per dataset di grandi dimensioni o modelli più grandi e seleziona sempre l'opzione per installare automaticamente il driver NVIDIA al primo avvio.Arresta la VM dalla console di Compute Engine quando è inattiva. Continuerai a pagare il disco collegato, quindi elimina la VM e il disco una volta terminato il progetto e dopo aver copiato in sicurezza i pesi su Cloud Storage.
Per i dataset di piccole dimensioni, usa
gcloud compute scp. Per dataset più grandi, caricali in un bucket di Cloud Storage e scaricali congsutil cp -r gs://your-bucket/dataset ./datasets/, che è molto più veloce all'interno della rete di Google.Sì. La Deep Learning VM include già PyTorch, quindi
pip install ultralyticsaggiunge l'addestramento e l'esportazione di YOLO26 tramite la CLIyolo.
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.