Soluzioni Ultralytics: usa YOLO26 per risolvere problemi del mondo reale
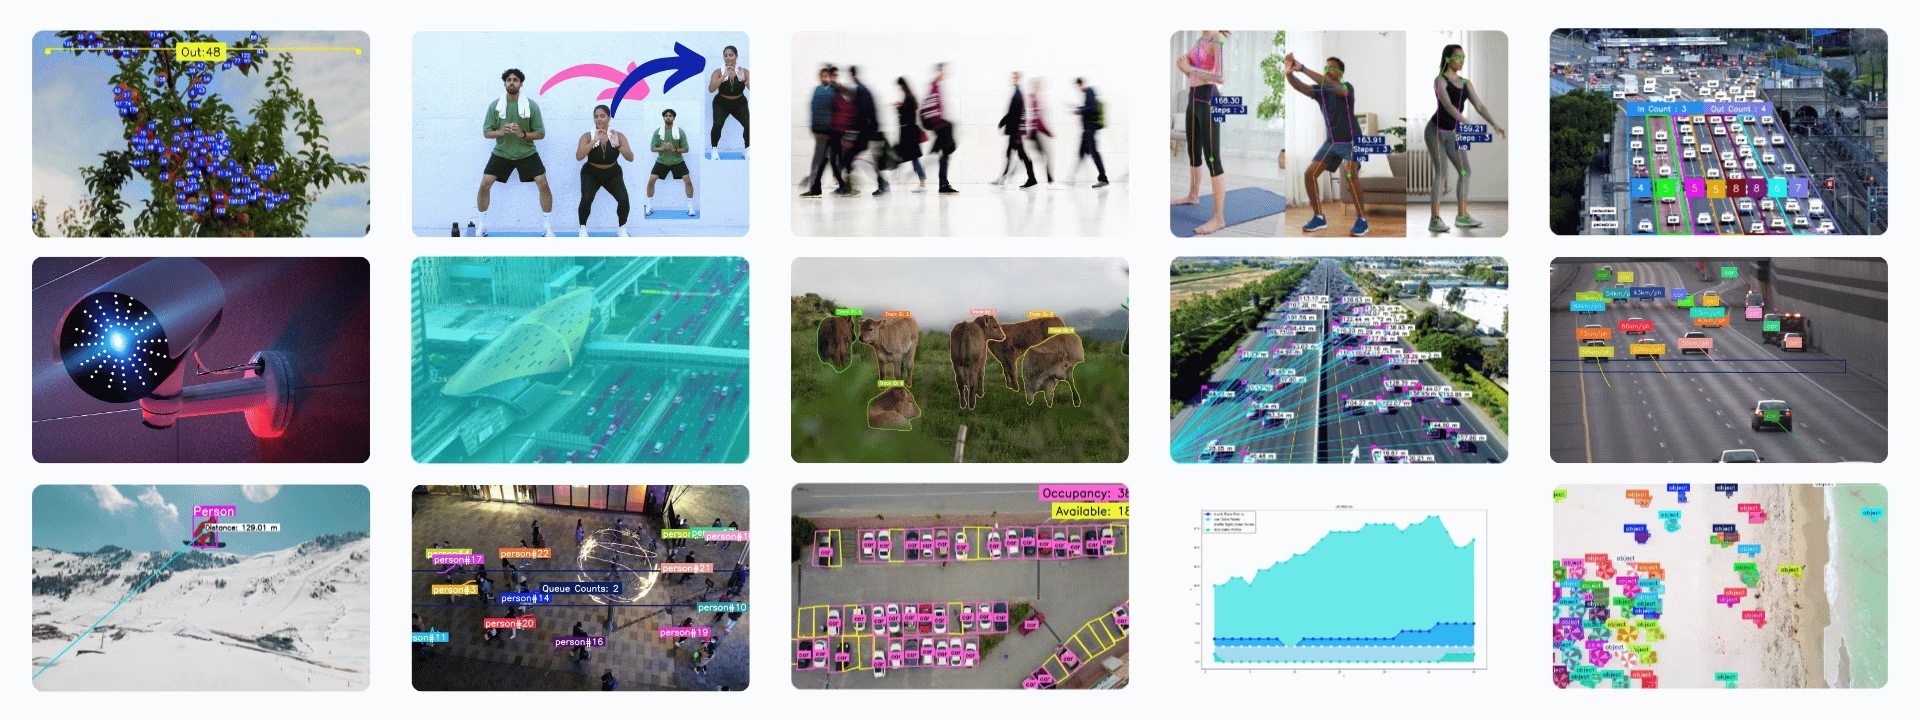
Le soluzioni Ultralytics sono applicazioni pronte all'uso dei modelli Ultralytics YOLO per problemi comuni di visione artificiale, come il conteggio degli oggetti, le mappe di calore e la stima della velocità, la gestione delle code e la sfocatura degli oggetti. La maggior parte delle soluzioni racchiude il rilevamento, il tracciamento o la stima della posa in una classe configurabile, eseguibile da Python o dalla CLI yolo solutions.
Guarda: Come eseguire le soluzioni Ultralytics dalla riga di comando (CLI) | Ultralytics YOLO26 🚀
Soluzioni#
Ogni soluzione qui sotto ha una guida dedicata:
- Analisi: genera grafici a linee, a barre, a torta e ad area dai rilevamenti YOLO26 per analizzare le tendenze nel tempo.
- Calcolo della distanza: calcola le distanze tra gli oggetti usando i centroidi delle bounding box in YOLO26 per l'analisi spaziale.
- Mappe di calore: accumula i rilevamenti YOLO26 in una mappa di calore sovrapposta che mostra dove gli oggetti compaiono o si spostano più spesso.
- Segmentazione di istanze con tracciamento degli oggetti: combina la segmentazione di istanze e il tracciamento degli oggetti con YOLO26 per seguire i contorni degli oggetti nei fotogrammi video.
- Inferenza in tempo reale con Streamlit: esegui il rilevamento di oggetti in tempo reale con YOLO26 nel browser tramite un'interfaccia Streamlit.
- Sfocatura degli oggetti: applica la sfocatura agli oggetti con YOLO26 per proteggere la privacy nell'elaborazione di immagini e video.
- Conteggio degli oggetti: conta con YOLO26 gli oggetti che oltrepassano una linea o entrano in una regione nei video e nei flussi in diretta.
- Conteggio degli oggetti nelle regioni: conta gli oggetti all'interno di più regioni definite dall'utente con YOLO26.
- Ritaglio degli oggetti: ritaglia gli oggetti rilevati da immagini e video con YOLO26 e salva ciascuno come immagine separata.
- OCR: rileva, riconosci e ordina il testo presente in scene e documenti con qualsiasi rotazione usando i rilevatori YOLO26-Text e il riconoscimento PP-OCRv6, oppure leggi il coreano, il cirillico, l'arabo e altri sistemi di scrittura con i modelli linguistici PP-OCRv5.
- Gestione dei parcheggi: monitora i posti auto occupati e disponibili con YOLO26.
- Gestione delle code: usa YOLO26 per contare le persone in attesa in un'area di coda e monitorarne la lunghezza.
- Sistema di allarme di sicurezza: crea con YOLO26 un sistema di allarme di sicurezza che invia un avviso via email quando il numero di oggetti rilevati raggiunge una soglia.
- Ricerca per similarità: recupera immagini con query in linguaggio naturale, come "persona con una borsa" o "veicoli in movimento", combinando gli embedding di OpenAI CLIP con la ricerca per similarità del coseno.
- Stima della velocità: stima la velocità degli oggetti con YOLO26 e il tracciamento degli oggetti per applicazioni come il monitoraggio del traffico.
- Tracciamento degli oggetti in una zona: traccia gli oggetti solo all'interno di una zona definita del fotogramma video con YOLO26.
- Mappatura degli oggetti con VisionEye: collega gli oggetti rilevati a un punto di osservazione fisso, imitando il modo in cui l'occhio umano si concentra su oggetti specifici.
- Monitoraggio degli allenamenti: conta le ripetizioni degli esercizi e traccia le fasi dell'allenamento in tempo reale con la stima della posa di YOLO26.
Argomenti delle soluzioni#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
model | str | None | Percorso a un file modello Ultralytics YOLO. |
region | list o dict | None | Punti che definiscono la regione di interesse: un elenco di tuple (x, y) oppure un dizionario che associa i nomi delle regioni agli elenchi di punti per più regioni (solo RegionCounter). Quando None, le soluzioni che richiedono una regione usano un valore predefinito predefinito. |
show_in | bool | True | Flag che controlla se visualizzare i conteggi in entrata nello stream video. |
show_out | bool | True | Flag che controlla se visualizzare i conteggi in uscita nello stream video. |
analytics_type | str | 'line' | Tipo di grafico, ad es. line, bar, area o pie. |
colormap | int | cv2.COLORMAP_DEEPGREEN | Mappa dei colori da usare per la mappa di calore. |
line_width | int | 2 | Spessore delle linee dei riquadri, dei punti chiave e dei conteggi disegnati dalla soluzione. |
verbose | bool | True | Abilita il log per frame della soluzione, con forma dell'input, conteggi per classe e velocità di elaborazione. La chiamata di tracking è sempre silenziosa. |
json_file | str | None | Percorso al file JSON che contiene tutti i dati sulle coordinate dei parcheggi. |
up_angle | float | 145.0 | Soglia angolare per la posa «verso l'alto». |
kpts | list[int] | [6, 8, 10] | Elenco di tre indici di punti chiave usati per monitorare gli allenamenti. Questi punti chiave corrispondono alle articolazioni o alle parti del corpo, come spalle, gomiti e polsi, per esercizi come flessioni, trazioni, squat ed esercizi per gli addominali. |
down_angle | float | 90.0 | Soglia angolare per la posa «verso il basso». |
blur_ratio | float | 0.5 | Regola la percentuale di intensità della sfocatura, con valori nell'intervallo 0.1 - 1.0. |
crop_dir | str | 'cropped-detections' | Nome della directory in cui archiviare le rilevazioni ritagliate. |
records | int | 5 | Numero totale di rilevazioni necessario per attivare un'email con l'allarme di sicurezza. |
vision_point | tuple[int, int] | (20, 20) | Punto in cui VisionEye Solution traccia gli oggetti e disegna i percorsi. |
source | str | None | Percorso della sorgente di input (video, RTSP ecc.). Utilizzabile solo con l'interfaccia a riga di comando (CLI) di Solutions. |
figsize | tuple[float, float] | (12.8, 7.2) | Dimensioni della figura in pollici per i grafici Analytics; (12.8, 7.2) genera un fotogramma da 1280×720. |
fps | float | 30.0 | Fotogrammi al secondo utilizzati per calcolare la velocità. |
max_hist | int | 5 | Numero massimo di punti storici da tracciare per oggetto per calcolare velocità e direzione. |
meter_per_pixel | float | 0.05 | Fattore di scala utilizzato per convertire la distanza in pixel in unità del mondo reale. |
max_speed | int | 120 | Velocità massima in km/h; le velocità stimate superiori vengono limitate a questo valore. |
data | str | 'images' | Percorso della directory di immagini utilizzata per la ricerca di somiglianze. |
imgsz | int | 640 | Dimensioni dell'immagine di input per l'inferenza del modello. |
recognizer | str o Callable | 'paddleocr' | Backend di riconoscimento del testo: 'paddleocr' (PP-OCRv6 su ONNX Runtime), 'tensorrt' (PP-OCRv6 come motore TensorRT FP16 su GPU NVIDIA), un nome di modello linguistico PaddleOCR come 'korean_PP-OCRv5_mobile_rec' oppure una funzione richiamabile che accetta un ritaglio BGR e restituisce (text, confidence). |
Le soluzioni passano gli argomenti di inferenza e tracciamento indicati di seguito a model.track().
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
tracker | str | 'tracktrack.yaml' | Specifica l'algoritmo di tracciamento da usare. Opzioni integrate: botsort.yaml, bytetrack.yaml, ocsort.yaml, deepocsort.yaml, fasttrack.yaml, tracktrack.yaml. |
conf | float | 0.25 | Imposta la soglia di confidenza per le rilevazioni; valori più bassi consentono di tracciare più oggetti, ma possono includere falsi positivi. |
iou | float | 0.5 | Imposta la soglia di Intersezione sull'unione (IoU) per filtrare le rilevazioni sovrapposte. |
classes | list | None | Filtra i risultati in base all'indice della classe. Ad esempio, classes=[0, 2, 3] traccia solo le classi specificate. |
device | str | None | Specifica il dispositivo per l'inferenza (ad es. cpu, cuda:0 o 0). Consente di scegliere tra CPU, una GPU specifica o altri dispositivi di calcolo per l'esecuzione del modello. |
imgsz | int or tuple | 640 | Dimensione dell'immagine di destinazione per l'inferenza: un intero per un'immagine quadrata o una coppia (height, width). Le forme vengono adattate allo stride del modello. |
max_det | int | 300 | Numero massimo di rilevazioni da mantenere per fotogramma prima del tracciamento, che limita gli oggetti elaborati da una soluzione nelle scene dense. |
quantize | int or str | None | Precisione dell’inferenza: 16 (FP16) oppure 32/unset (FP32) per i modelli PyTorch e TorchScript quando non si usa la CPU; gli altri formati usano la precisione selezionata dal rispettivo artefatto e ambiente di esecuzione. Sostituisce l’argomento deprecato half. |
Puoi usare show_conf, show_labels e gli altri argomenti menzionati per personalizzare la visualizzazione.
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
show | bool | False | Se True, mostra le immagini o i video annotati in una finestra. Utile per ottenere un riscontro visivo immediato durante lo sviluppo o i test. |
show_conf | bool | True | Mostra il punteggio di confidenza di ogni rilevamento accanto all'etichetta. Fornisce indicazioni sul grado di certezza del modello per ciascun rilevamento. |
show_labels | bool | True | Mostra le etichette di ogni rilevamento nell'output visivo. Permette di identificare immediatamente gli oggetti rilevati. |
Uso di SolutionAnnotator#
Tutte le soluzioni Ultralytics usano la classe SolutionAnnotator, che estende la classe principale Annotator e fornisce i seguenti metodi:
| Metodo | Tipo restituito | Descrizione |
|---|---|---|
draw_region() | None | Disegna una regione usando punti, colori e spessore specificati. |
queue_counts_display() | None | Visualizza il conteggio delle code nella regione specificata. |
display_analytics() | None | Visualizza le statistiche complessive sulla gestione dei parcheggi. |
estimate_pose_angle() | float | Calcola l'angolo tra tre punti nella posa di un oggetto. |
draw_specific_kpts() | np.ndarray | Disegna punti chiave specifici sull'immagine. |
plot_workout_information() | int | Disegna sull'immagine un riquadro di testo con etichetta. |
plot_angle_and_count_and_stage() | None | Visualizza l'angolo, il conteggio dei passi e la fase per il monitoraggio degli allenamenti. |
plot_distance_and_line() | None | Visualizza la distanza tra i centroidi e li collega con una linea. |
display_objects_labels() | None | Aggiunge etichette delle classi degli oggetti alle bounding box. |
sweep_annotator() | None | Visualizza una linea verticale di passaggio e un'etichetta facoltativa. |
visioneye() | None | Mappa i centroidi degli oggetti e li collega a un punto visivo simile a un "occhio". |
adaptive_label() | None | Disegna un'etichetta con sfondo circolare o rettangolare al centro di una bounding box. |
Lavorare con SolutionResults#
Quando viene chiamata, ogni soluzione tranne Ricerca per similarità restituisce un oggetto SolutionResults.
- Per il conteggio degli oggetti, i risultati includono
in_count,out_counteclasswise_count.
import cv2

from ultralytics import solutions

im0 = cv2.imread("path/to/img")

region_points = [(20, 400), (1080, 400), (1080, 360), (20, 360)]

counter = solutions.ObjectCounter(
    show=True,  # visualizza l'output
    region=region_points,  # passa i punti della regione
    model="yolo26n.pt",  # model="yolo26n-obb.pt" per il conteggio degli oggetti con il modello OBB.
    # classes=[0, 2],  # conta classi specifiche, ad es. persona e auto con il modello COCO preaddestrato.
    # tracker="botsort.yaml"  # Scegli i tracker, ad es. "bytetrack.yaml"
)
results = counter(im0)
print(results.in_count)  # display in_counts
print(results.out_count)  # display out_counts
print(results.classwise_count)  # display classwise_count
Gli oggetti SolutionResults hanno i seguenti attributi:
| Attributo | Tipo | Descrizione |
|---|---|---|
plot_im | np.ndarray | Immagine con sovrapposizioni visive come conteggi, effetti di sfocatura o miglioramenti specifici della soluzione. |
in_count | int | Numero totale di oggetti rilevati che entrano nella zona definita nel flusso video. |
out_count | int | Numero totale di oggetti rilevati che escono dalla zona definita nel flusso video. |
classwise_count | dict[str, dict[str, int] | int] | Conteggi per classe: {"IN": int, "OUT": int} per ObjectCounter e Heatmap oppure un int per Analytics. |
queue_count | int | Numero di oggetti attualmente presenti in una coda o area di attesa predefinita (adatto alla gestione delle code). |
workout_count | list[int] | Conteggio delle ripetizioni degli allenamenti per ogni traccia di AI Gym (una voce per ogni individuo tracciato al momento). |
workout_angle | list[float] | Angoli degli esercizi per ogni traccia di AI Gym (una voce per ogni individuo tracciato al momento). |
workout_stage | list[str] | Fase corrente dell'allenamento per ogni traccia di AI Gym (una voce per ogni individuo tracciato al momento). |
pixels_distance | float | Distanza in pixel tra due oggetti o punti, come le bounding box (adatta al calcolo della distanza). |
available_slots | int | Numero di posti liberi in un'area monitorata (adatto alla gestione dei parcheggi). |
filled_slots | int | Numero di posti occupati in un'area monitorata (adatto alla gestione dei parcheggi). |
email_sent | bool | Indica se un'email di notifica o di avviso è stata inviata correttamente (adatto agli allarmi di sicurezza). |
total_tracks | int | Numero totale di tracce univoche di oggetti osservate durante l'analisi video. |
region_counts | dict[str, int] | Conteggi degli oggetti all'interno di regioni o zone definite dall'utente. |
speed_dict | dict[int, int] | Dizionario delle velocità stimate degli oggetti, organizzate per traccia, in km/h, ottenute da SpeedEstimator e utili per l'analisi della velocità. |
total_crop_objects | int | Numero totale di immagini ritagliate degli oggetti generate dalla soluzione ObjectCropper. |
speed | dict[str, float] | Dizionario contenente metriche di prestazione per il tracciamento e l'elaborazione della soluzione. |
Per ulteriori dettagli, consulta la documentazione della classe SolutionResults.
Uso delle soluzioni tramite CLI#
La maggior parte delle soluzioni può essere eseguita direttamente dall'interfaccia a riga di comando.
Sintassi
yolo SOLUTIONS SOLUTION_NAME ARGS
- SOLUTIONS è una parola chiave obbligatoria.
- SOLUTION_NAME è uno tra:
['count', 'crop', 'blur', 'workout', 'heatmap', 'isegment', 'queue', 'speed', 'analytics', 'trackzone', 'inference', 'visioneye', 'region', 'security', 'parking']. - ARGS (opzionali) sono coppie personalizzate
arg=value, comeshow_in=True, per sostituire le impostazioni predefinite.
yolo solutions count show=True # for object counting

yolo solutions count source="path/to/video.mp4" # specify video file path
Contribuisci alle nostre soluzioni#
I contributi della community sono benvenuti. Se hai creato con Ultralytics YOLO una soluzione non descritta qui, valuta di condividerla come guida per aiutare gli altri utenti.
Domande frequenti#
Ultralytics YOLO26 conta gli oggetti in tempo reale combinando rilevamento e tracciamento, così ogni oggetto viene contato una sola volta quando oltrepassa una linea o entra in una regione. Per configurare YOLO26 per l'analisi dei flussi video in diretta, installa
ultralytics, carica un modello e passa i fotogrammi video asolutions.ObjectCounter.Ultralytics YOLO26 aggiunge il rilevamento degli oggetti e gli avvisi in tempo reale ai sistemi di sicurezza basati su telecamere. Con la soluzione Sistema di allarme di sicurezza, YOLO26 invia un avviso via email quando il numero di oggetti rilevati nell'area di sorveglianza raggiunge una soglia.
Ultralytics YOLO26 conta e traccia le persone all'interno di un'area di coda, fornendoti la lunghezza della coda in tempo reale per ridurre i tempi di attesa e pianificare il personale.
Sì. I modelli di stima della posa Ultralytics YOLO26 tracciano in tempo reale i punti chiave del corpo, quindi la soluzione di monitoraggio degli allenamenti può misurare gli angoli delle articolazioni, contare le ripetizioni e indicare la fase corrente dell'esercizio.
Ultralytics YOLO26 può generare mappe di calore che mostrano dove gli oggetti compaiono o si spostano più spesso in una scena, evidenziando le aree con maggiore attività. Queste visualizzazioni dei dati ti aiutano a comprendere i modelli di traffico e le tendenze nel tempo.


Commenti23
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
ZHIYUAN816(modificato)
But acturally I don't konw how to set plots_max
 Glenn JocherUltralytics(modificato)
@ZHIYUAN816 you don't need to set anything: the warning has no effect on training or metrics, only on how many items are drawn on the plotted validation images (optional, for visual review). In current versions that limit follows the
max_detargument (default 300).
WARNING ⚠️ Limiting validation plots to first 50 items per image for speed... WARNING ⚠️ Limiting validation plots to first 50 items per image for speed... how to solve this problem bro?
- Glenn JocherUltralytics(modificato)
@ZHIYUAN816 this is not an error but a warning that the plotted prediction images are limited to a maximum number of items per image. It does not affect training. In current versions the limit follows
max_det(default 300).
smc0927
If I want a target to be detected only once, is it possible? If so, how can I do it?
RizwanMunawar
@smc0927 Hi! I’m not entirely sure I understand your question. Could you please clarify a bit?
Generally, the counting process is designed to occur only once for each track ID. Once an object is counted, it won't be counted again, even if it crosses the same
regionorlinemultiple times.ok,I want to print out the coordinates of the target, but that's not what I want because it's going to be printed multiple times over a period of time. I want it to be output only once, is there a way to achieve this?
@smc0927 Yes it's possible. You can simply iterate over the detection results. BTW, this discussion is more related to Ultralytics solutions, while your question is related to prediction :)
Sample Code
from ultralytics import YOLO
model = YOLO("yolo11n.pt")
results = model.predict("path/to/im0")

if results[0].boxes.id is not None:
      boxes = results[0].boxes.xyxy.cpu()
      track_ids = results[0].boxes.id.int().cpu().tolist()
      clss = results[0].boxes.cls.cpu().tolist()

      for box, cls in enumerate(boxes, clss):
          # Here you can add the logic to display single-time details of the object
Thanks :)
sorry
hodat2608
Hi everyone, hi @glenn-jocher, I want to install pycuda on my windows 10 using python 3.12, but I still can't do it. It's hard to find any documentation or tutorials like that, @glenn-jocher or anyone can send me a link or tutorial to install pycuda? Please help me. Thanks first
MuhammedEnesGurkan
hey how can ı find yolo v8 solutions source codes.
- Glenn JocherUltralytics
@MuhammedEnesGurkan you can find the source codes for YOLOv8 solutions on the Ultralytics GitHub repository. For more detailed guides and examples, please visit the Ultralytics Solutions page at https://docs.ultralytics.com/solutions/.
maxexplorer
Hi there,
After updating Ultralytics and using YOLO11, will the YOLOv8 models still work in this virtual environment?
Thank you in advance for your help and the great work you’re doing!
- Glenn JocherUltralytics
@maxexplorer yes, YOLOv8 models will continue to work in your virtual environment after updating to YOLO11. If you have further questions, feel free to ask!
yosifsaab
hi i have error during using the google colab for classification two classes images by yolov8n
results = model.train(data=DATA_DIR, epochs=1, imgsz=64)- Glenn JocherUltralytics
@yosifsaab it seems you're encountering an error with YOLOv8n in Google Colab. Please ensure your
DATA_DIRis correctly set and that your dataset is properly formatted. If the issue persists, check the Colab notebook for any specific error messages that might provide more details. For further assistance, you can refer to the Ultralytics documentation.
Nkosiyazimelani
Hi guys, how do i update the nc that my model can detect without having to train with old and new objects. i have updated my .YAML file but the model is still detecting the old number of objects(20 instead of 46). i have been told to look on the model itself and change the output number of class to the new updated on but there is nothing of that sort in the model file( best.pt). please help.
- Glenn JocherUltralytics(modificato)
@Nkosiyazimelani the number of classes (
nc) is part of the trained model's detection head, so editing the.yamlfile after training doesn't change whatbest.ptpredicts. You need to train again with a dataset YAML that has all 46 classes. You don't have to start from scratch, you can fine-tune from your existing weights, and the layers whose shapes depend on the class count are reinitialized automatically:from ultralytics import YOLO model = YOLO("best.pt") model.train(data="your_46_class_dataset.yaml", epochs=100)Make sure your dataset contains labeled examples of both the old and the new classes, otherwise the model will forget the old ones.
nounotabe
How to specify the device to be used (e.g. cuda:1)?
- Glenn JocherUltralytics
@nounotabe to specify the device for running YOLOv8, you can use the
deviceargument. For example, to use the second GPU (cuda:1), you can setdevice='cuda:1'. This can be done in both the CLI and Python API. If you encounter any issues, please ensure you are using the latest version of the package. For more detailed guidance, you can refer to our documentation at https://docs.ultralytics.com. cobaltautomationdev
lasted version of ultralytics. solutions not works in Windows10, but works in Google Colab. What's wrong with it? How to settle it? from ultralytics import solutions,YOLO , Couldn't import solutions in my windows10.
- Glenn JocherUltralytics
It seems like there might be an issue with the
solutionsmodule on Windows 10. Please ensure you are using the latest version of the Ultralytics package. If the issue persists, try reinstalling the package or running the code in a different environment. For further assistance, you can refer to our documentation at https://docs.ultralytics.com/solutions/. Just updated to v8.2.78 today ,uninstall and reinstall the latest version. and now it works on Windows10 . it seems there something changed in solutions init.py . this file caused import error in previous version. I noticed that in version 8.2.0, file init.py is blank. now add some code in it.