Addestra YOLOv5 con dati personalizzati
Questa guida spiega come addestrare un dataset personalizzato con il modello YOLOv5. L'addestramento di modelli personalizzati è un passaggio fondamentale per adattare le soluzioni di computer vision ad applicazioni concrete specifiche, oltre il generico rilevamento degli oggetti.
Prima di iniziare#
Per prima cosa, assicurati di aver configurato l'ambiente necessario. Clona il repository di YOLOv5 e installa le dipendenze richieste da requirements.txt. È essenziale disporre di un ambiente Python>=3.8.0 con PyTorch>=1.8. Se non vengono trovati localmente, i modelli e i dataset vengono scaricati automaticamente dalla versione più recente di YOLOv5.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
Addestra con dati personalizzati#
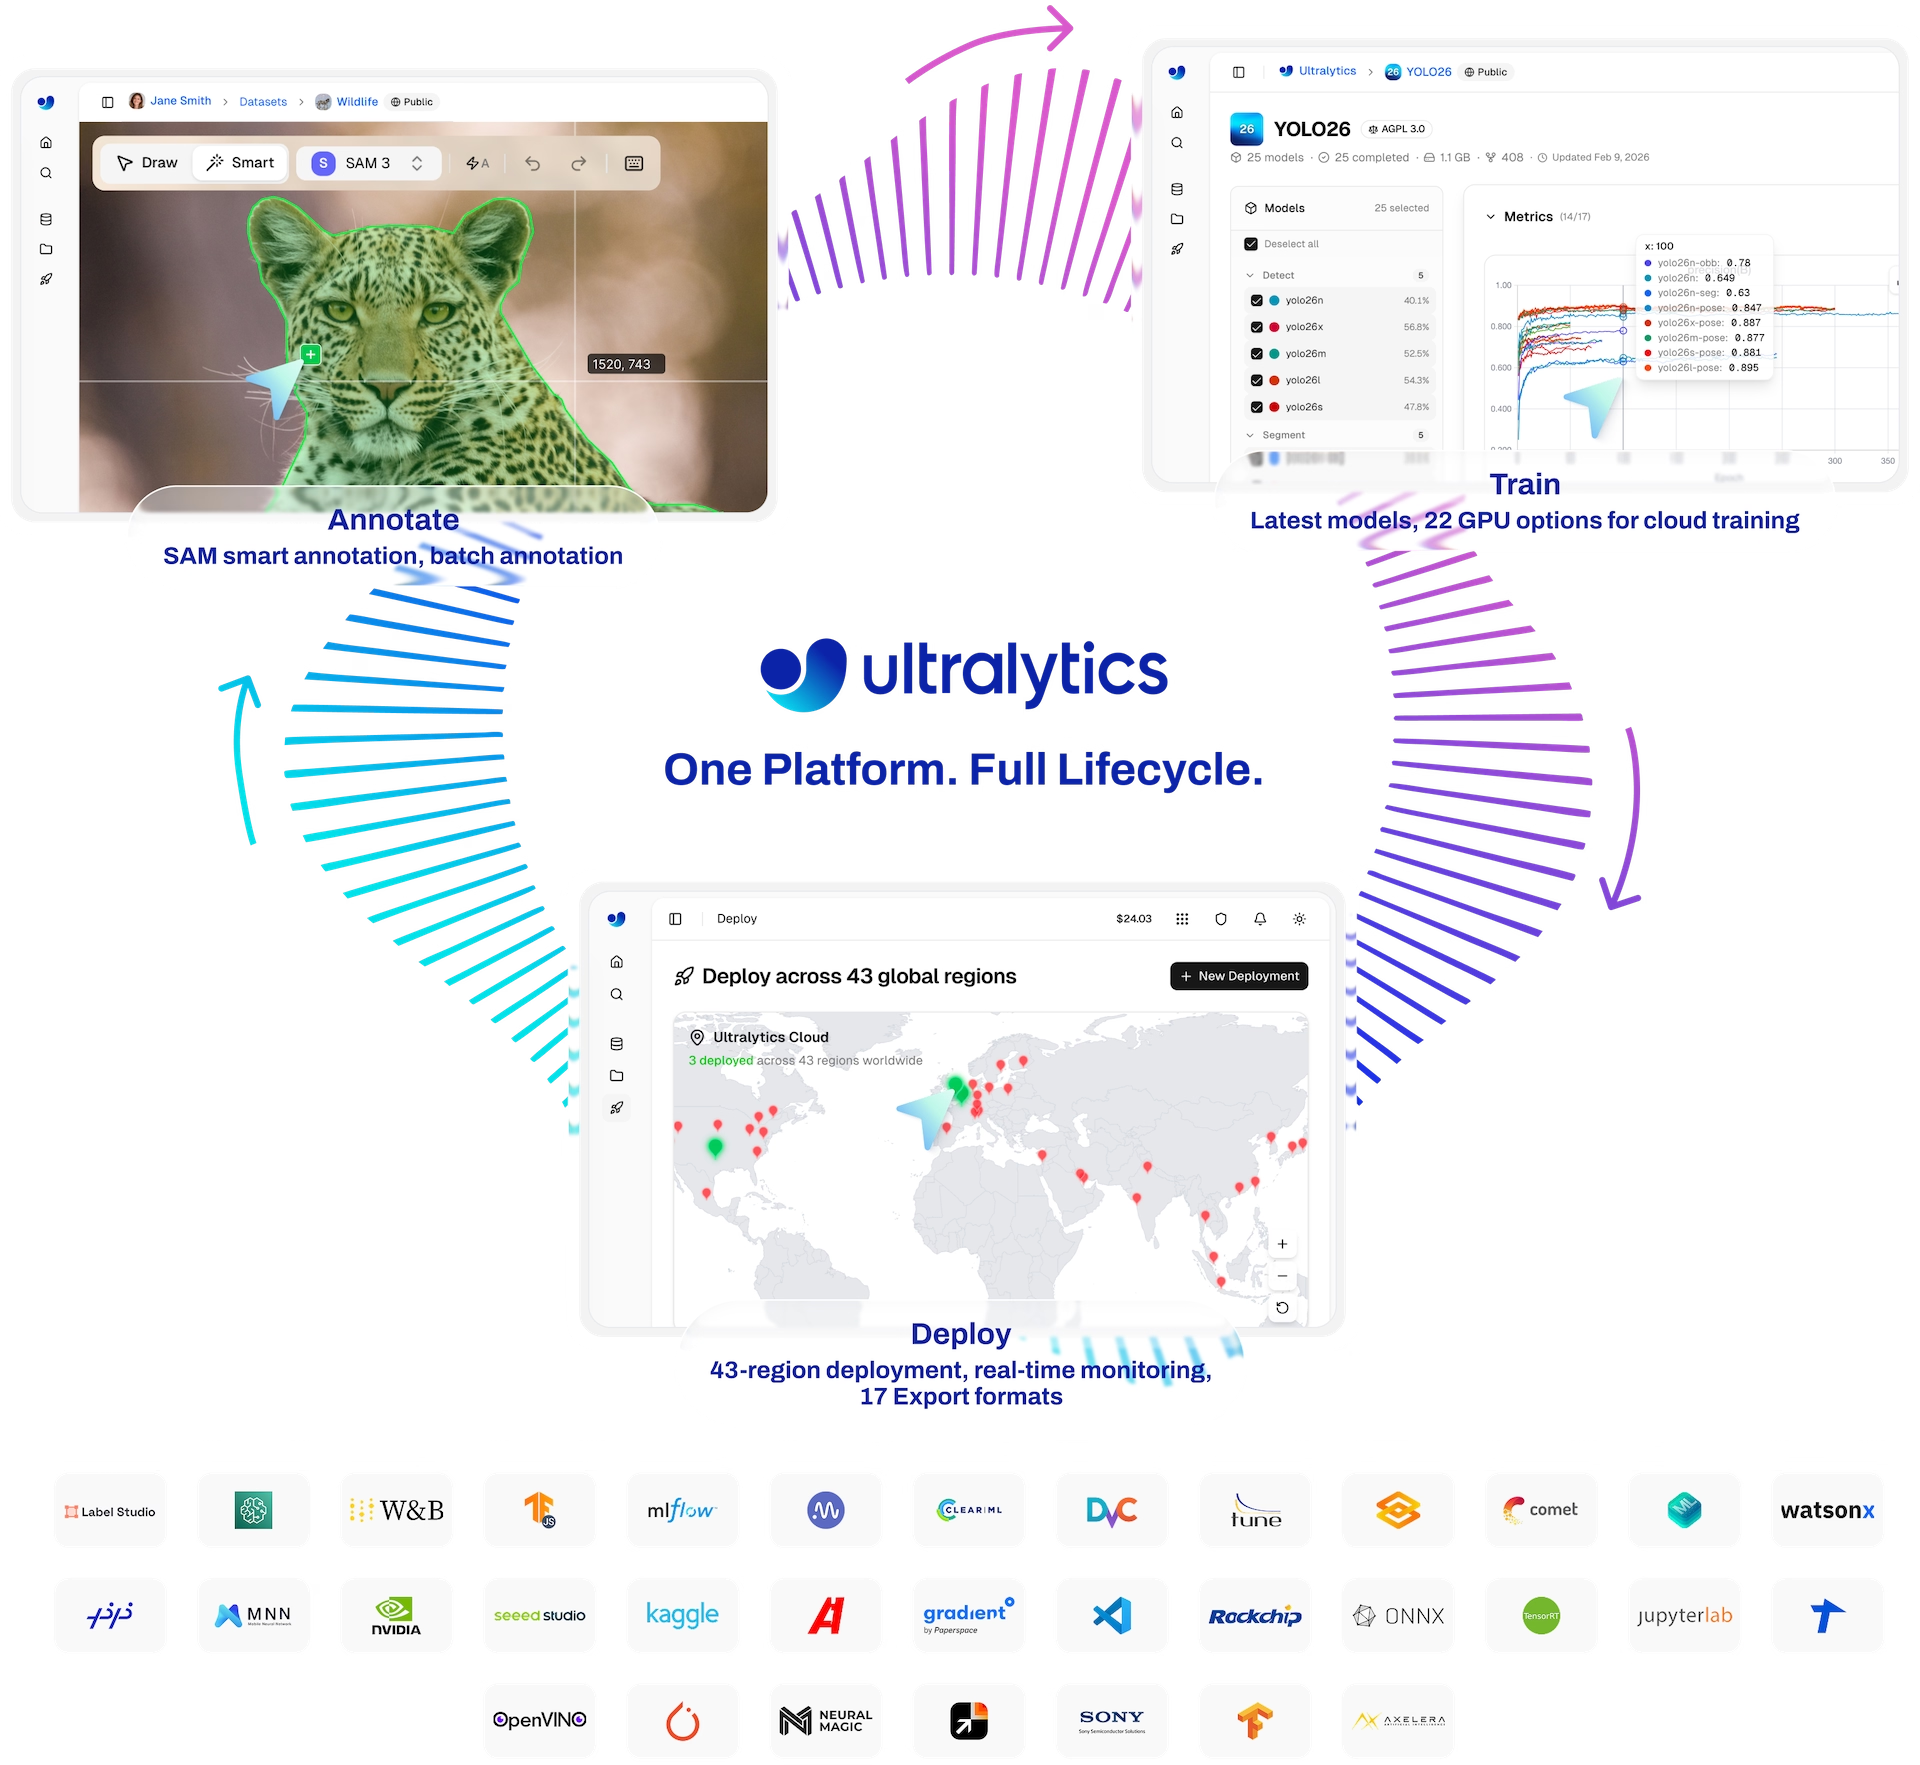
Lo sviluppo di un modello personalizzato di rilevamento degli oggetti è un processo iterativo:
- Raccogli e organizza le immagini: raccogli immagini pertinenti alla tua attività specifica. Dati di alta qualità e diversificati sono fondamentali. Consulta la nostra guida alla raccolta e annotazione dei dati.
- Etichetta gli oggetti: annota con precisione gli oggetti di interesse nelle immagini.
- Addestra un modello: usa i dati etichettati per addestrare il tuo modello YOLOv5. Sfrutta il transfer learning iniziando da pesi preaddestrati.
- Distribuzione e previsione: usa il modello addestrato per eseguire l'inferenza su nuovi dati mai visti.
- Raccogli i casi limite: individua gli scenari in cui il modello ha prestazioni scarse (casi limite) e aggiungi dati simili al dataset per migliorarne la robustezza. Ripeti il ciclo.
Ultralytics Platform offre una soluzione senza codice per l'intero ciclo di operazioni di machine learning (MLOps), inclusi la gestione dei dataset, l'addestramento dei modelli e la distribuzione.
Ultralytics offre due opzioni di licenza per soddisfare diversi scenari d'uso:
- Licenza AGPL-3.0: questa licenza open source approvata dall'OSI è ideale per studenti, ricercatori e appassionati che credono nella collaborazione aperta e nella condivisione delle conoscenze. Richiede che le opere derivate siano distribuite con la stessa licenza. Consulta il file LICENSE per tutti i dettagli.
- Licenza Enterprise: per lo sviluppo e l'uso in produzione, questa licenza consente di integrare il software Ultralytics e i modelli di IA in prodotti e servizi aziendali, inclusi strumenti interni, flussi di lavoro automatizzati e distribuzioni in produzione, senza essere soggetti ai requisiti open source di AGPL-3.0. Per iniziare, contattaci tramite Licenze Ultralytics.
Scopri più a fondo le nostre opzioni di licenza nella pagina Licenze Ultralytics.
Prima di avviare l'addestramento, è essenziale preparare il dataset.
1. Crea un dataset#
I modelli YOLOv5 richiedono dati etichettati per apprendere le caratteristiche visive delle classi di oggetti. Organizzare correttamente il dataset è fondamentale.
1.1 Crea dataset.yaml#
Il file di configurazione del dataset (ad es. coco128.yaml) descrive la struttura del dataset, i nomi delle classi e i percorsi delle directory delle immagini. COCO128 è un piccolo dataset di esempio composto dalle prime 128 immagini del vasto dataset COCO. È utile per testare rapidamente la pipeline di addestramento e diagnosticare potenziali problemi come l'overfitting.
La struttura del file dataset.yaml include:
path: la directory principale contenente il dataset.train,val,test: percorsi relativi dapathalle directory contenenti immagini o file di testo con gli elenchi dei percorsi delle immagini per i set di addestramento, convalida e test.names: un dizionario che associa gli indici delle classi (a partire da 0) ai nomi delle rispettive classi.
Puoi impostare path su una directory assoluta (ad es. /home/user/datasets/coco128) o su un percorso relativo come ../datasets/coco128 quando avvii l'addestramento dalla directory principale del repository YOLOv5.
Di seguito è riportata la struttura di coco128.yaml (visualizza su GitHub):
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 Sfrutta i modelli per l'etichettatura automatizzata#
L'etichettatura manuale è l'approccio più comune, ma richiede molto tempo. I modelli di base possono automatizzare o semiautomatizzare le annotazioni e velocizzare la creazione del dataset. Ecco alcuni modelli che possono aiutarti a generare etichette:
- Google Gemini: i modelli multimodali di grandi dimensioni come Gemini hanno ottime capacità di comprensione delle immagini. Puoi chiedere loro di identificare e localizzare oggetti nelle immagini, generando riquadri di delimitazione o descrizioni convertibili in etichette nel formato YOLO, come illustrato nel notebook del tutorial collegato. La classifica VLM di Ultralytics confronta la precisione con cui Gemini e altri modelli di visione e linguaggio annotano automaticamente dataset di rilevamento del mondo reale.
- SAM2 (Modello Segment Anything 2): i modelli di base dedicati alla segmentazione, come SAM2, possono identificare e delineare gli oggetti con grande precisione. Sebbene siano pensati principalmente per la segmentazione, le maschere risultanti possono spesso essere convertite in annotazioni con riquadri di delimitazione adatte alle attività di rilevamento degli oggetti.
- YOLO-World: questo modello offre funzionalità di rilevamento a vocabolario aperto. Puoi fornire descrizioni testuali degli oggetti che ti interessano e YOLO-World può individuarli nelle immagini senza essere stato addestrato in precedenza su quelle specifiche classi. Puoi usarlo come punto di partenza per generare etichette iniziali, che potrai poi perfezionare.
L'uso di questi modelli può fornire una fase di «pre-annotazione», riducendo il lavoro manuale necessario. Annotazione intelligente di Ultralytics Platform offre nel browser, senza codice, la pre-annotazione con SAM, YOLO e modelli di visione e linguaggio. È però fondamentale verificare e perfezionare le etichette generate automaticamente per garantirne l'accuratezza e la coerenza, poiché la qualità influisce direttamente sulle prestazioni del modello YOLOv5 addestrato. Dopo aver generato (ed eventualmente perfezionato) le etichette, assicurati che rispettino il formato YOLO: un file *.txt per immagine, con ogni riga che rappresenta un oggetto come class_index x_center y_center width height (coordinate normalizzate, classe indicizzata a partire da zero). Se un'immagine non contiene oggetti di interesse, non è necessario creare il file *.txt corrispondente.
Le specifiche dei file *.txt nel formato YOLO sono precise:
- Una riga per ogni riquadro di delimitazione.
- Ogni riga deve contenere:
class_index x_center y_center width height. - Le coordinate devono essere normalizzate in un intervallo compreso tra 0 e 1. Per farlo, dividi i valori in pixel di
x_centerewidthper la larghezza totale dell'immagine e dividiy_centereheightper l'altezza totale dell'immagine. - Gli indici delle classi partono da zero (ovvero, la prima classe è rappresentata da
0, la seconda da1e così via).
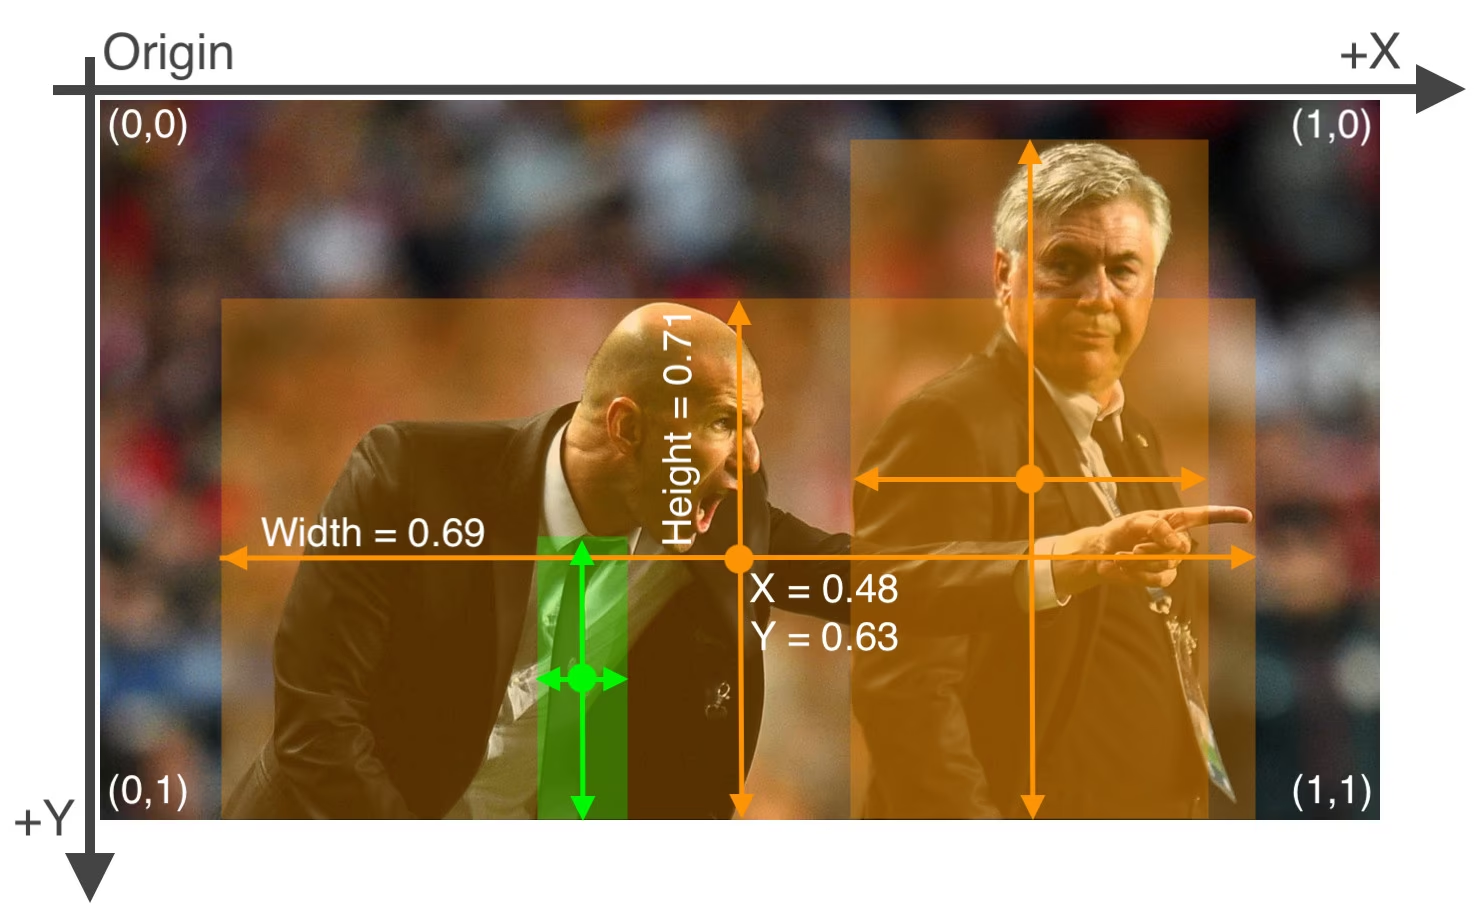
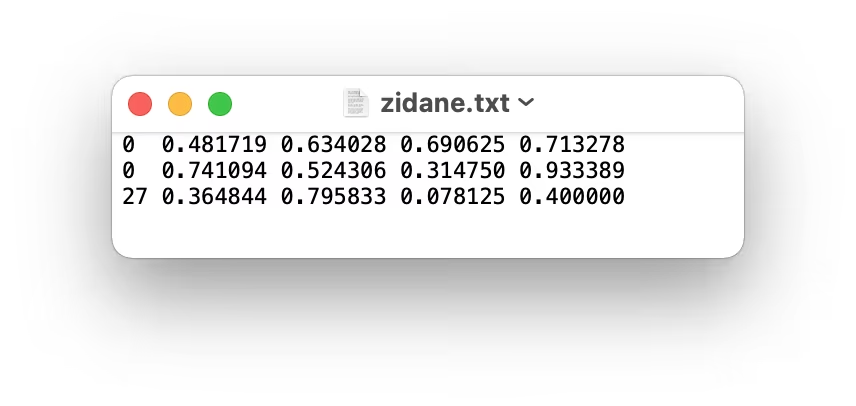
Il file di etichette corrispondente all'immagine sopra, contenente due oggetti «person» (indice di classe 0) e un oggetto «tie» (indice di classe 27), sarebbe così:
1.3 Organizza le directory#
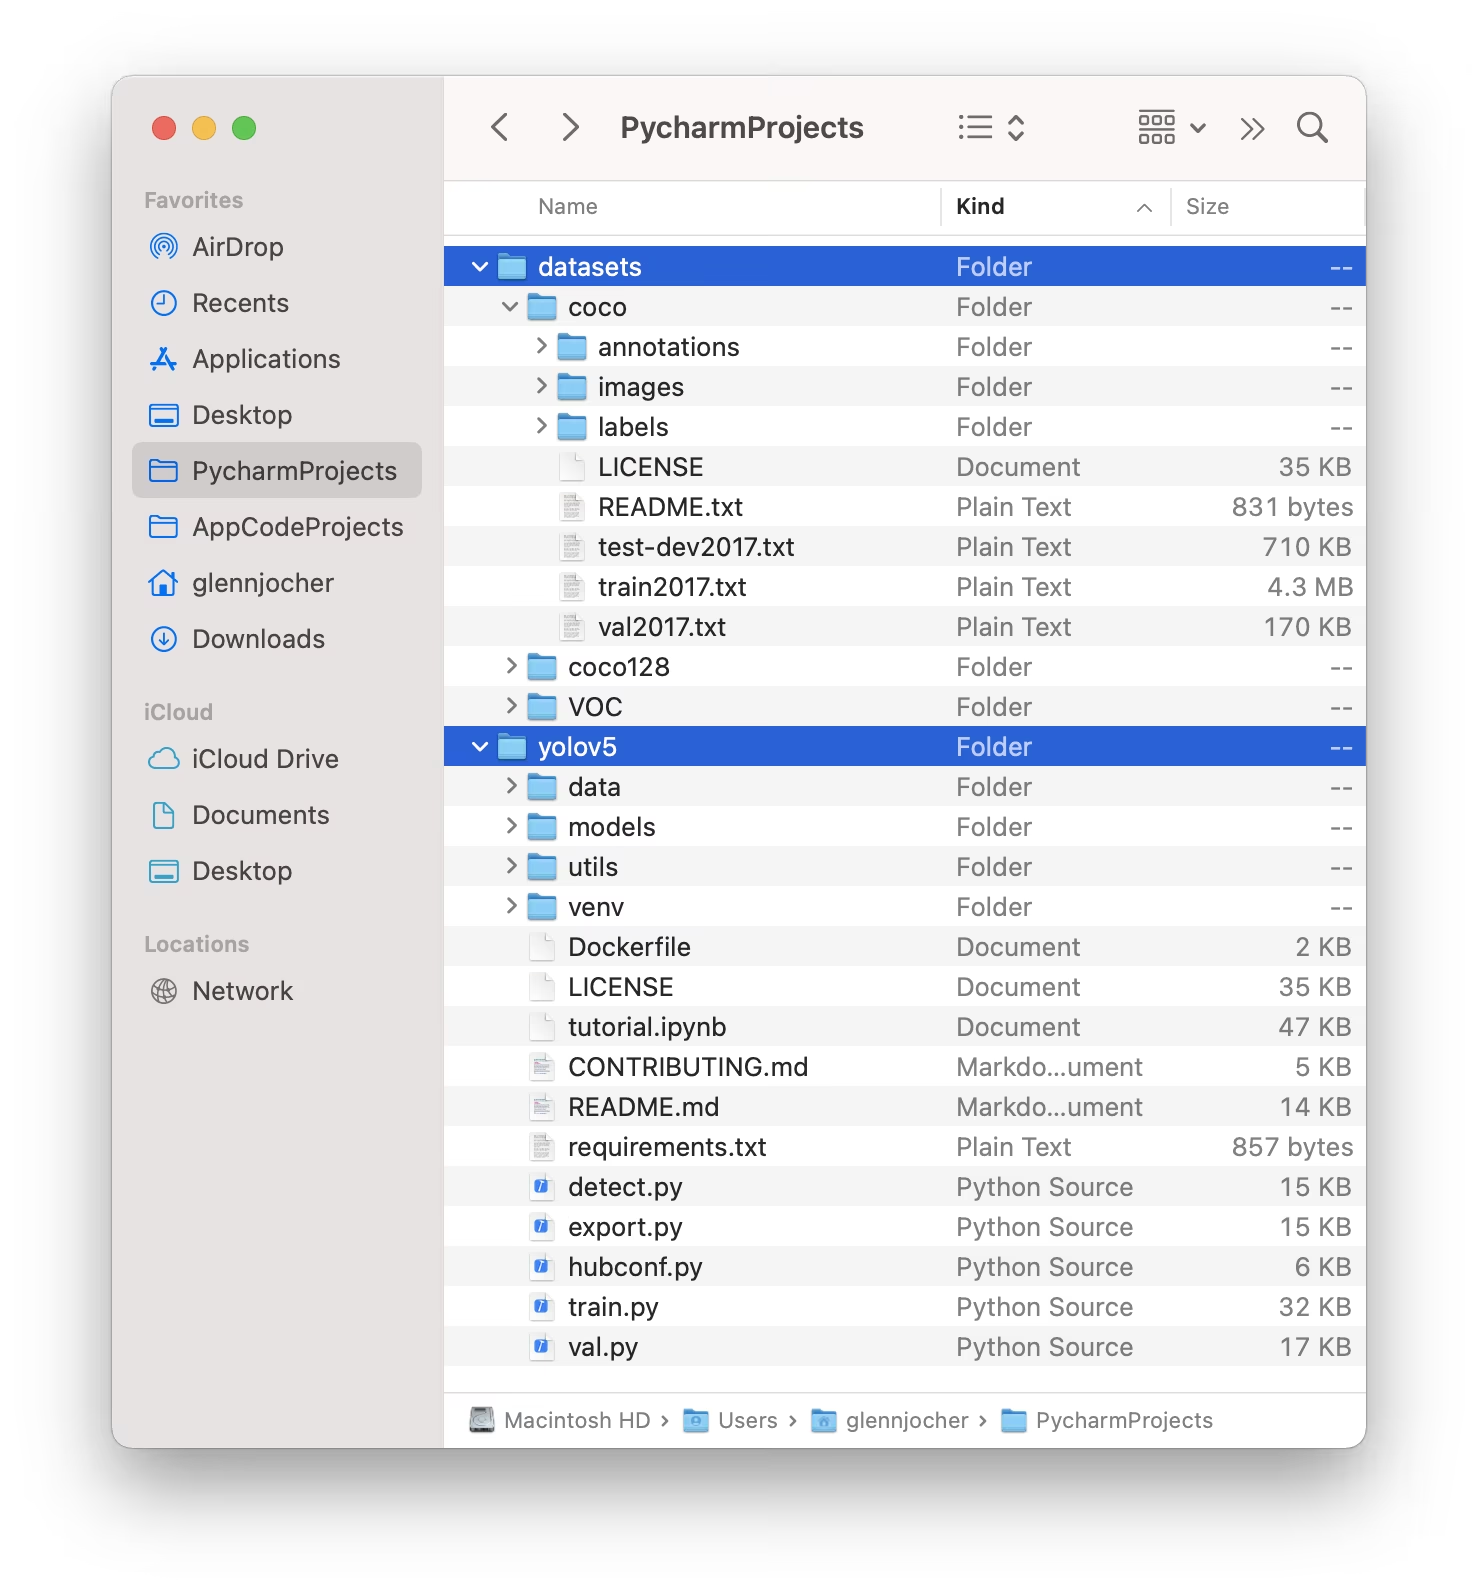
Organizza la directory dei dataset come illustrato di seguito. Per impostazione predefinita, YOLOv5 si aspetta che la directory del dataset (ad es. /coco128) si trovi in una cartella /datasets collocata accanto alla directory del repository /yolov5.
YOLOv5 individua automaticamente le etichette di ogni immagine sostituendo l'ultima occorrenza di /images/ nel percorso dell'immagine con /labels/. Ad esempio:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
La struttura di directory consigliata è:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. Seleziona un modello#
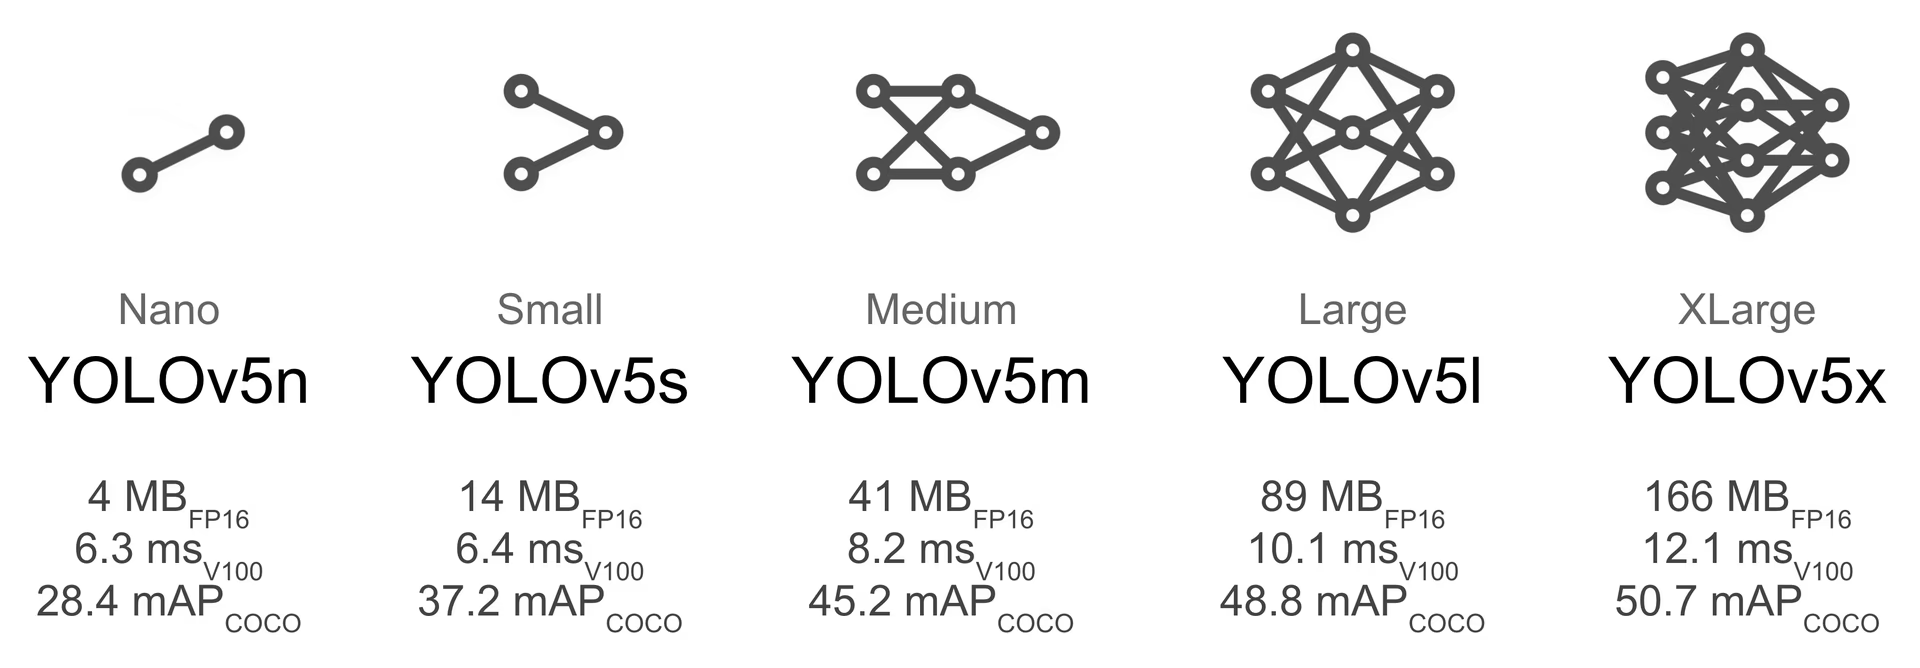
Scegli un modello preaddestrato per avviare l'addestramento. Partire da pesi preaddestrati accelera notevolmente l'apprendimento e migliora le prestazioni rispetto all'addestramento da zero. YOLOv5 offre modelli di diverse dimensioni, ciascuno con un diverso compromesso tra velocità e accuratezza. Ad esempio, YOLOv5s è il secondo modello più piccolo e il secondo più veloce, adatto agli ambienti con risorse limitate.
3. Addestra#
Avvia l'addestramento del modello usando lo script train.py. Gli argomenti essenziali includono:
--img: definisce la dimensione dell'immagine di input (ad es.--img 640). In genere, dimensioni maggiori offrono una migliore accuratezza, ma richiedono più memoria GPU.--batch: determina la dimensione del batch (ad es.--batch 16). Scegli la dimensione massima gestibile dalla tua GPU.--epochs: specifica il numero totale di epoche di addestramento (ad es.--epochs 100). Un'epoca rappresenta un passaggio completo sull'intero dataset di addestramento.--data: percorso del tuo filedataset.yaml(ad es.--data coco128.yaml).--weights: percorso del file dei pesi iniziali. Per convergere più rapidamente e ottenere risultati migliori, è consigliato usare pesi preaddestrati (ad es.--weights yolov5s.pt). Per addestrare da zero (sconsigliato, a meno che tu non disponga di un dataset molto ampio e di esigenze specifiche), usa--weights '' --cfg yolov5s.yaml.
Se non sono presenti localmente, i pesi preaddestrati vengono scaricati automaticamente dalla release più recente di YOLOv5.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.ptUsa --cache ram o --cache disk per memorizzare nella cache le immagini del dataset rispettivamente in RAM o sul disco locale. Questo può accelerare notevolmente l'addestramento, soprattutto quando le operazioni I/O (input/output) del dataset sono un collo di bottiglia. Tieni presente che questa operazione richiede molta RAM o spazio su disco.
Addestra sempre usando dataset archiviati localmente. Accedere ai dati da unità di rete (come Google Drive) o da archivi remoti può essere molto più lento e compromettere le prestazioni dell'addestramento. Copiare il dataset su un SSD locale è spesso la soluzione migliore.
Tutti gli output dell'addestramento, inclusi pesi e log, vengono salvati nella directory runs/train/. Ogni sessione di addestramento crea una nuova sottodirectory (ad es. runs/train/exp, runs/train/exp2 e così via). Per un'esperienza pratica e interattiva, consulta la sezione sull'addestramento nei notebook tutorial ufficiali: 

4. Visualizza#
YOLOv5 si integra con diversi strumenti per visualizzare l'avanzamento dell'addestramento, valutare i risultati e monitorare le prestazioni in tempo reale.
Registrazione e visualizzazione con Comet#
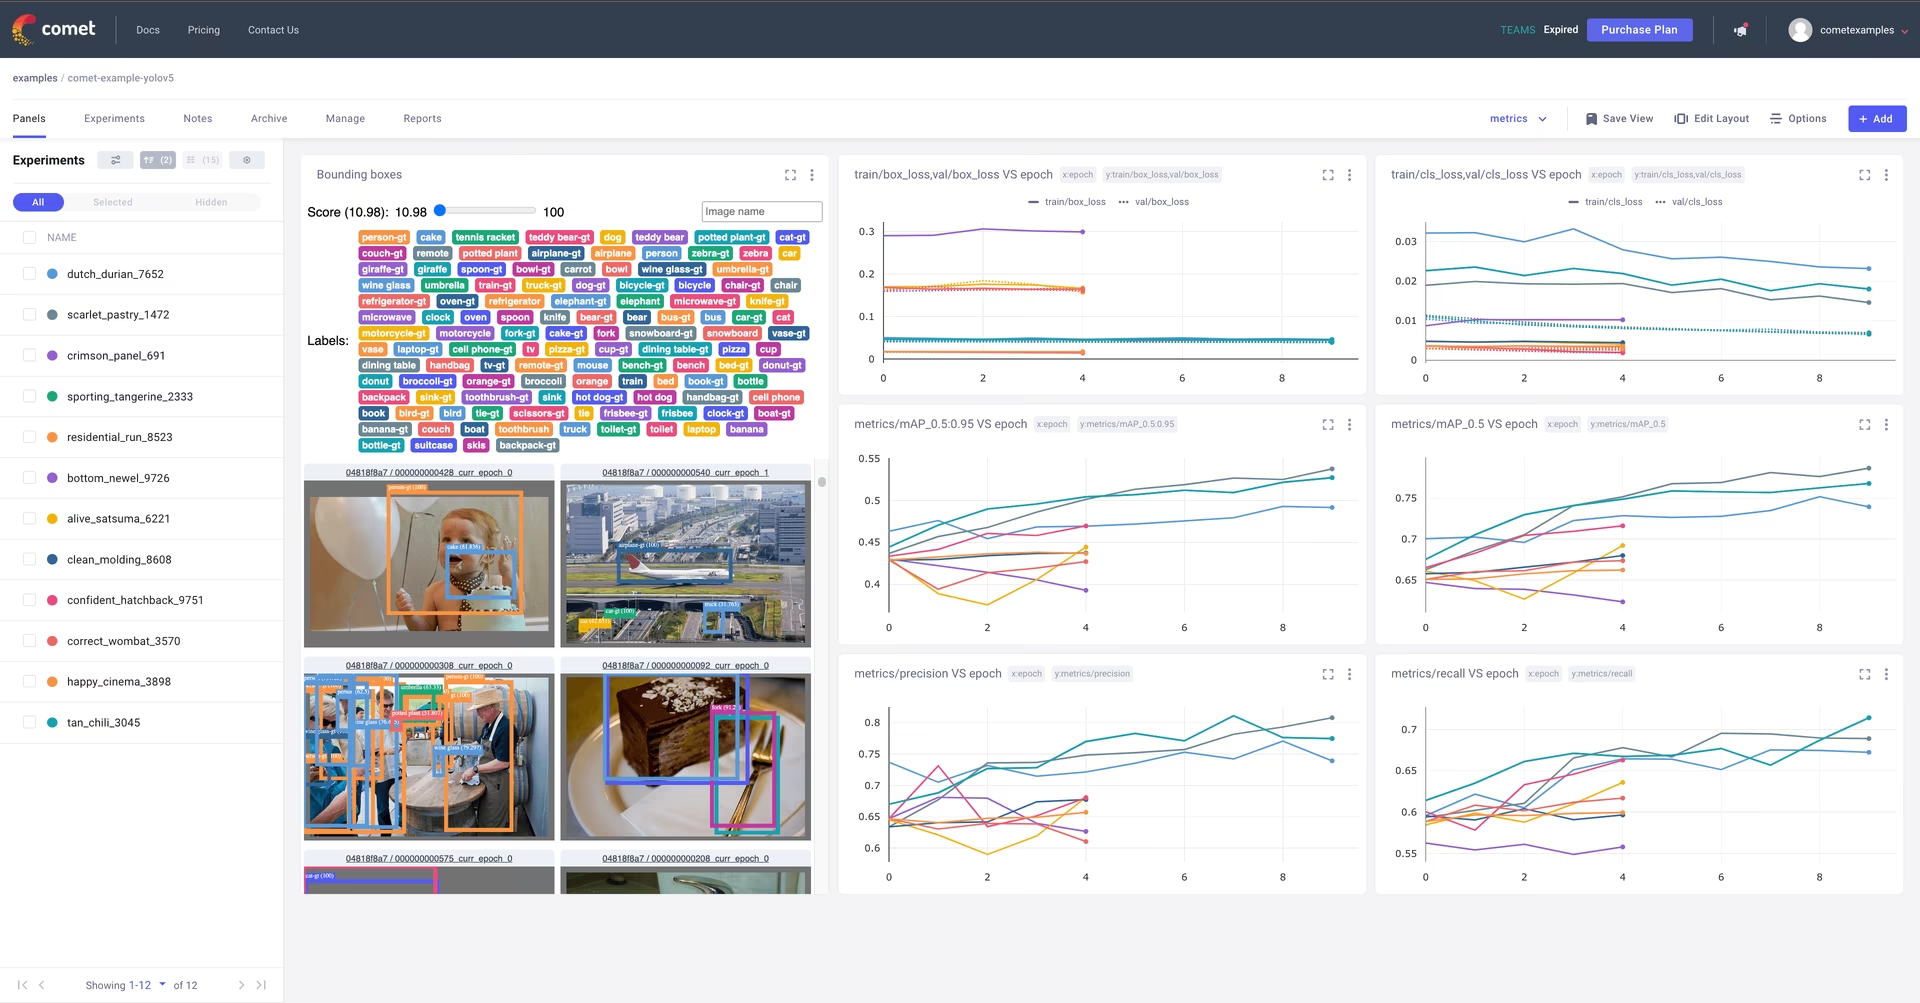
Comet è integrato per il monitoraggio completo degli esperimenti. Visualizza le metriche in tempo reale, salva gli iperparametri, gestisci dataset e checkpoint dei modelli e analizza le previsioni dei modelli con i pannelli personalizzati di Comet, interattivi.
Iniziare è semplice:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
Prova il notebook Comet Colab per una demo interattiva:
Registrazione e automazione con ClearML#
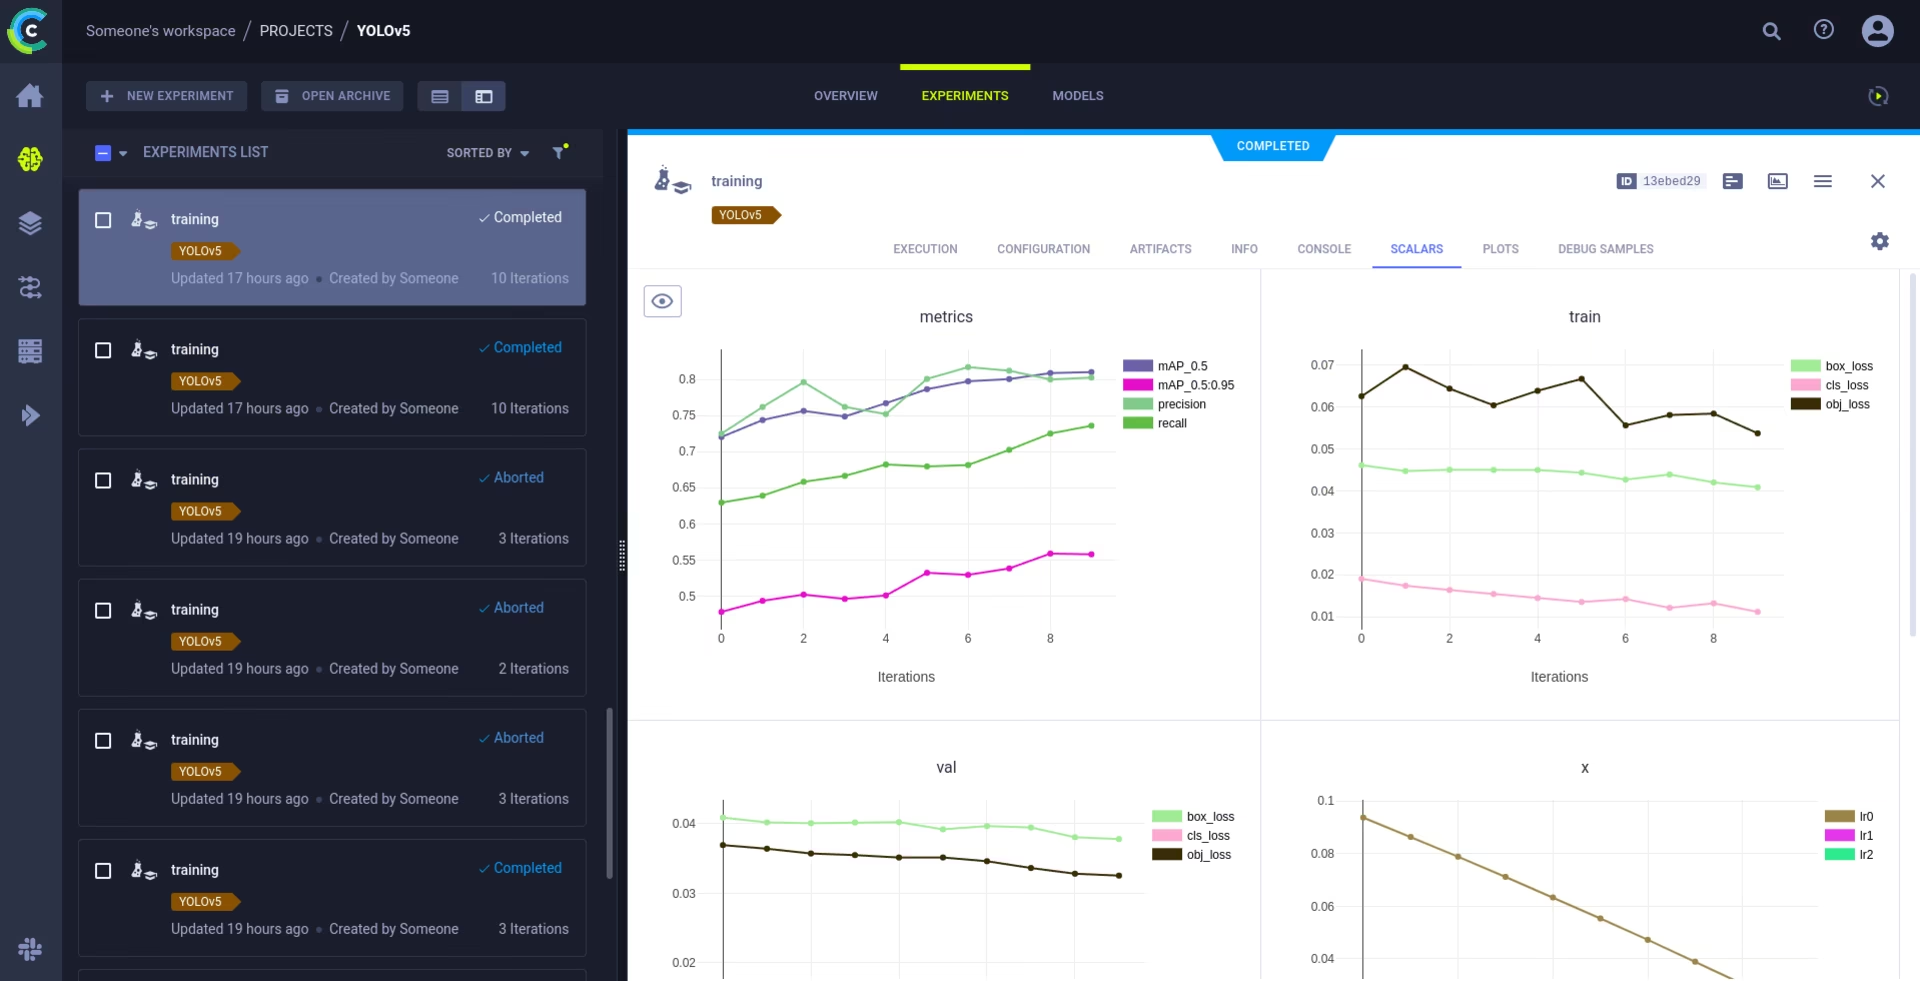
L'integrazione con ClearML consente di monitorare dettagliatamente gli esperimenti, gestire le versioni dei dataset e persino eseguire da remoto le sessioni di addestramento. Attiva ClearML seguendo questi passaggi:
- Installa il pacchetto:
pip install clearml - Inizializza ClearML: esegui
clearml-inituna volta per connetterti al tuo server ClearML (ospitato autonomamente o con il piano gratuito).
ClearML acquisisce automaticamente i dettagli degli esperimenti, i caricamenti dei modelli, i confronti, le modifiche al codice non sottoposte a commit e i pacchetti installati, garantendo la piena riproducibilità. Puoi pianificare attività di addestramento su agenti remoti e gestire le versioni dei dataset con ClearML Data.
Registrazione locale#
I risultati dell'addestramento vengono registrati automaticamente con TensorBoard e salvati come file CSV nella directory dell'esperimento specifico (ad es. runs/train/exp). I dati registrati includono:
- Perdita e metriche delle prestazioni dell'addestramento e della convalida.
- Immagini di esempio che mostrano le trasformazioni applicate (come i mosaici).
- Etichette di ground truth insieme alle previsioni del modello per l'ispezione visiva.
- Metriche di valutazione chiave, come le curve Precisione-Recall (PR).
- Matrici di confusione per un'analisi dettagliata delle prestazioni per classe.
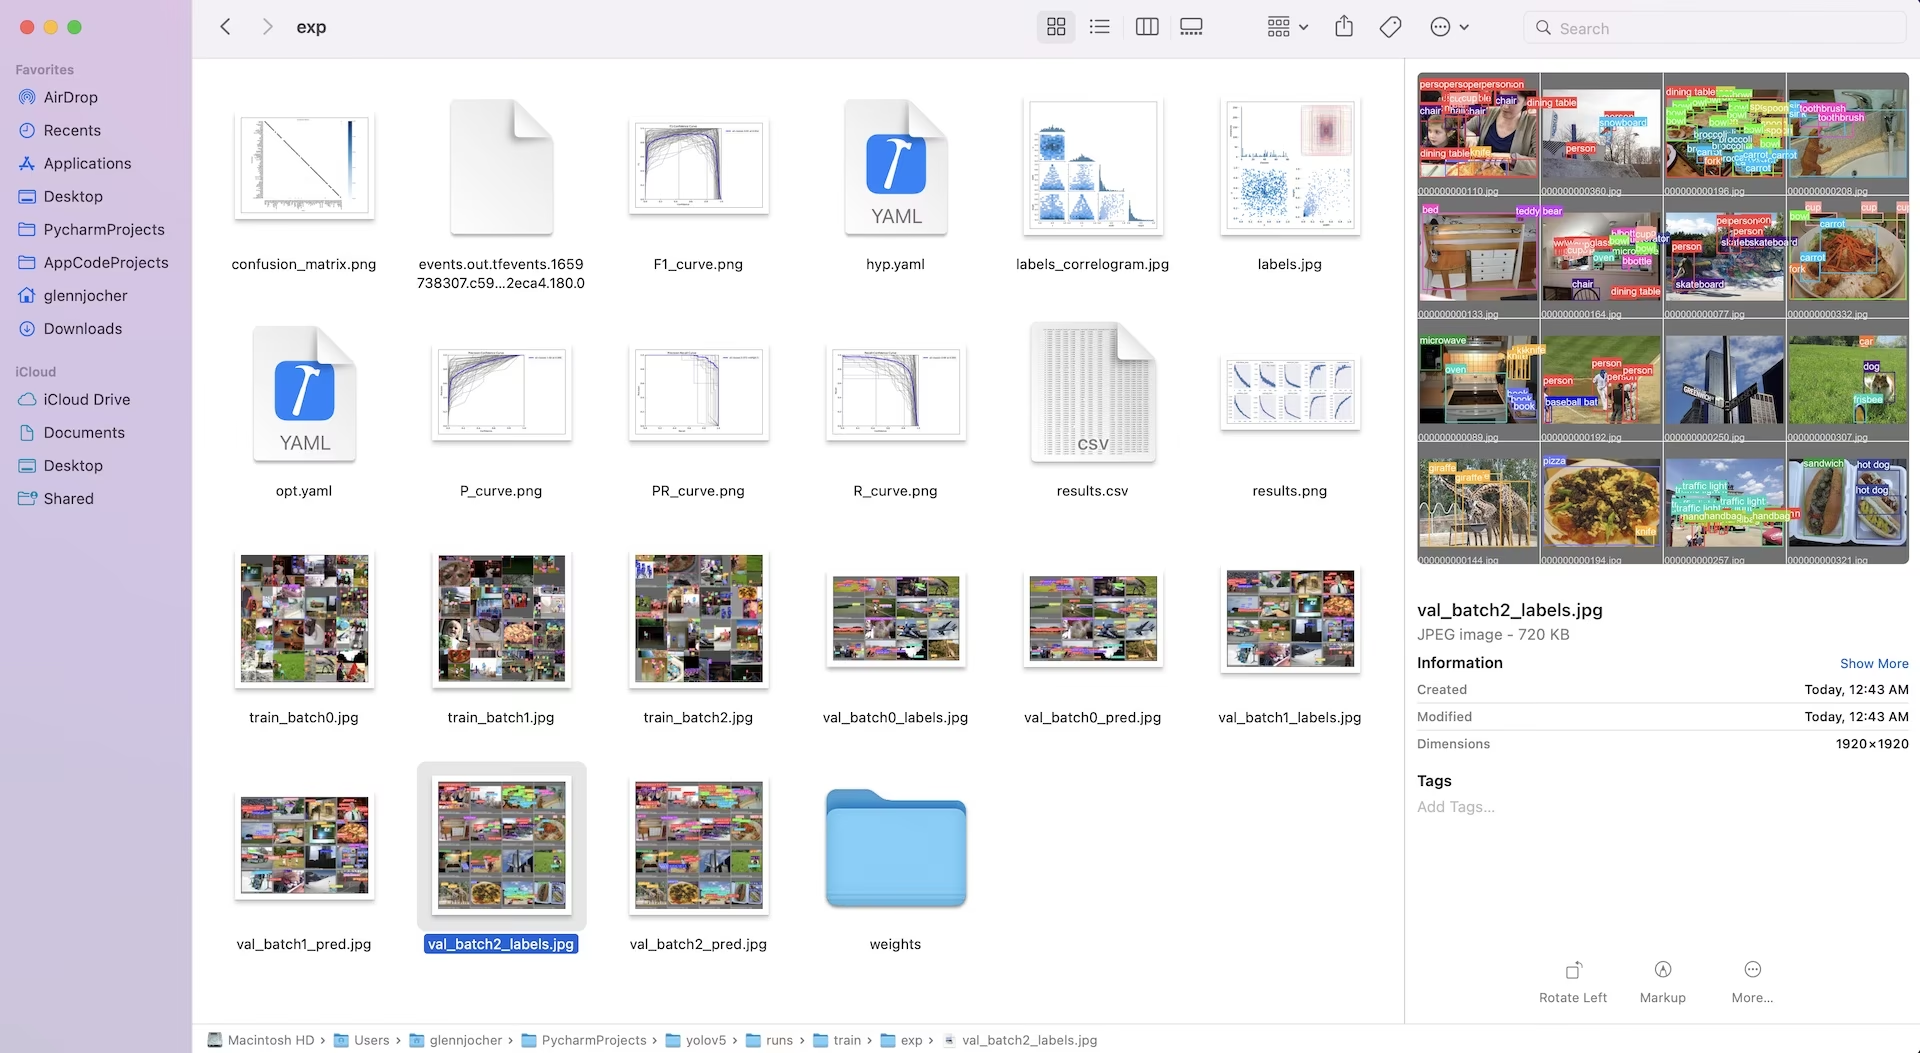
Il file results.csv viene aggiornato dopo ogni epoca e, al termine dell'addestramento, viene generato il grafico results.png. Puoi anche creare manualmente il grafico di qualsiasi file results.csv usando la funzione di utilità fornita:
from utils.plots import plot_results

# Traccia i risultati di una directory di esecuzione di addestramento specifica
plot_results("runs/train/exp/results.csv")  # Verrà generato 'results.png' nella stessa directory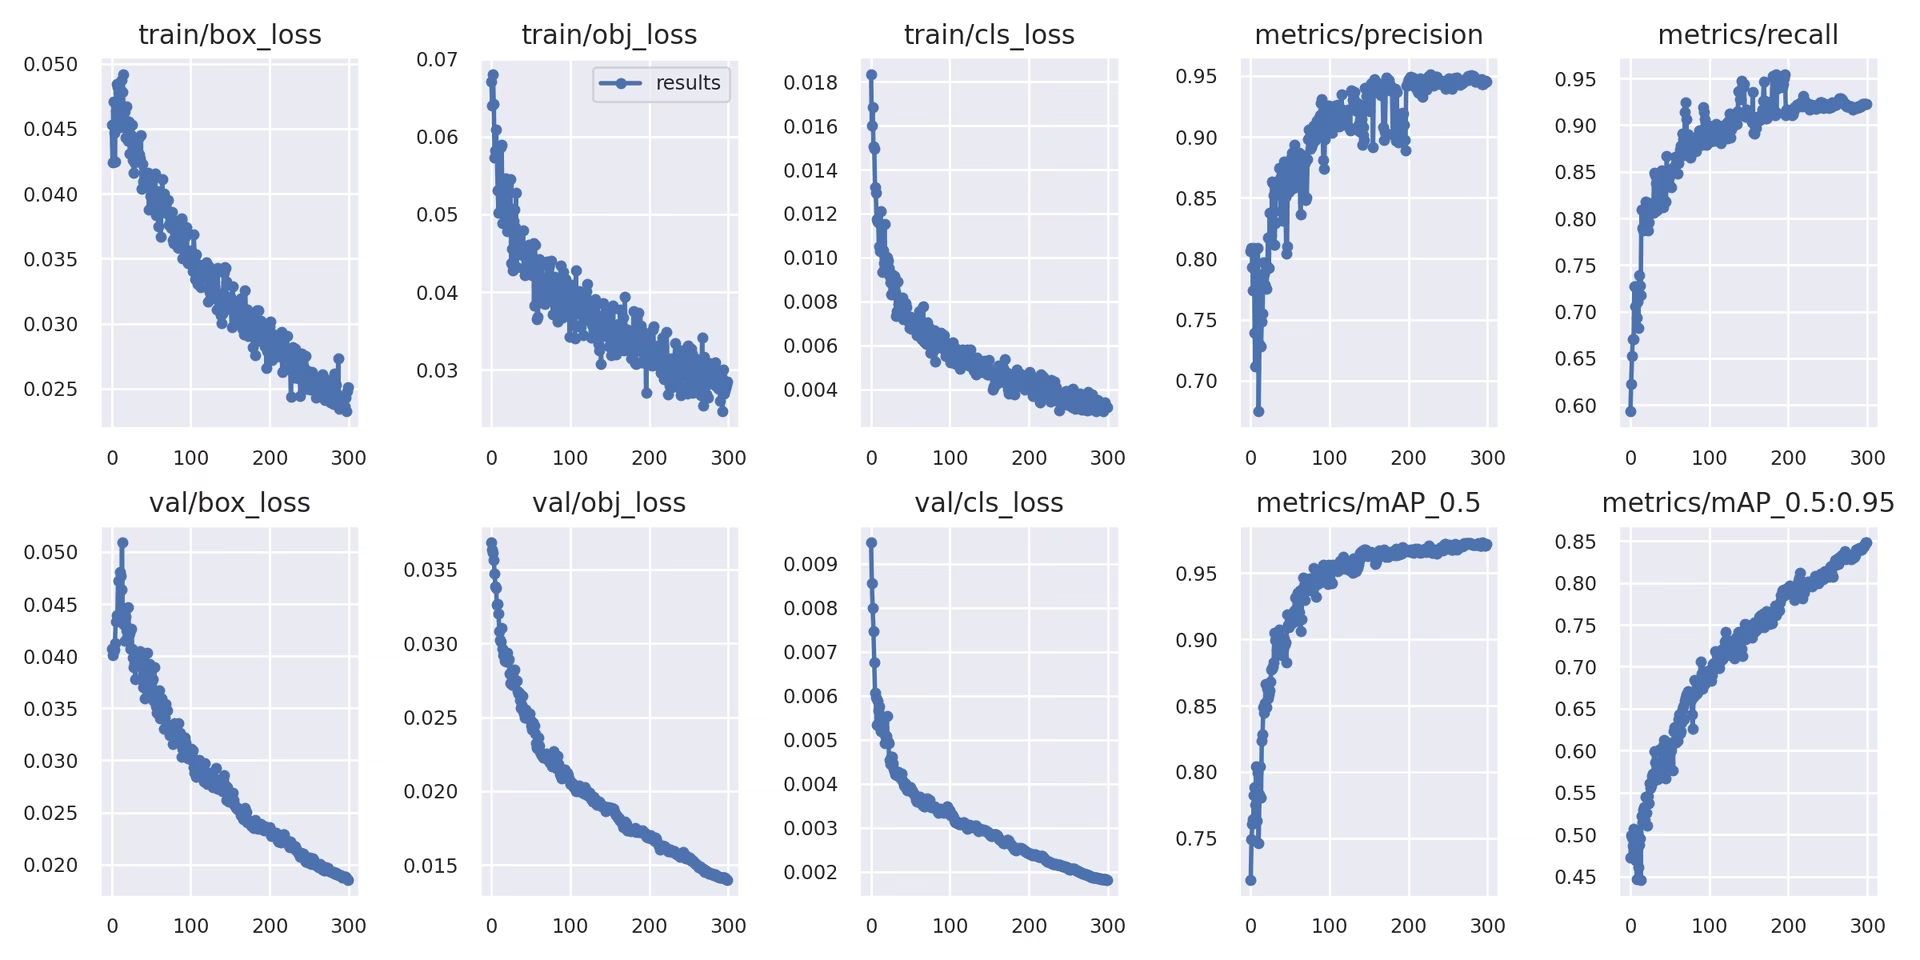
5. Passaggi successivi#
Al termine dell'addestramento, il checkpoint del modello con le migliori prestazioni (best.pt) viene salvato ed è pronto per la distribuzione o per ulteriori perfezionamenti. I possibili passaggi successivi includono:
- Esegui inferenze su nuove immagini o video con il modello addestrato tramite la CLI o Python.
- Esegui
val.pyper valutare l'accuratezza del modello e la sua capacità di generalizzazione su diverse suddivisioni dei dati (ad es. un set di test tenuto da parte). - Esporta il modello in diversi formati di distribuzione, come ONNX, TensorFlow SavedModel o TensorRT, per un'inferenza ottimizzata su piattaforme diverse.
- Usa l'evoluzione degli iperparametri per provare a ottenere ulteriori miglioramenti delle prestazioni.
- Continua a migliorare il tuo modello seguendo i nostri consigli per ottenere i migliori risultati di addestramento e aggiungendo iterativamente dati più diversificati e impegnativi sulla base dell'analisi delle prestazioni.
Ambienti supportati#
Ultralytics offre ambienti pronti all'uso dotati delle dipendenze essenziali, come CUDA, cuDNN, Python e PyTorch, per consentirti di iniziare senza difficoltà.
- Notebook GPU gratuiti:
- Piattaforme cloud:
- Google Cloud: Guida rapida a GCP
- Amazon AWS: Guida rapida ad AWS
- Microsoft Azure: Guida rapida ad AzureML
- Configurazione locale:
- Docker: Guida rapida a Docker
- Docker: Guida rapida a Docker


Stato del progetto#

Questo badge indica che tutti i test delle GitHub Actions di YOLOv5 relativi all'integrazione continua (CI) sono superati. Questi test CI coprono le funzionalità principali, tra cui addestramento, convalida, inferenza, esportazione e benchmark, su macOS, Windows e Ubuntu. I test vengono eseguiti automaticamente ogni 24 ore e a ogni commit del codice.
Domande frequenti#
L'addestramento di YOLOv5 su un dataset personalizzato prevede diversi passaggi chiave:
- Prepara il dataset: raccogli immagini e annotale. Assicurati che le annotazioni siano nel formato YOLO richiesto. Organizza immagini ed etichette nelle directory
train/eval/(e, facoltativamente,test/). Puoi usare modelli come Google Gemini, SAM2 o YOLO-World per supportare o automatizzare il processo di etichettatura (vedi la sezione 1.2). - Configura l'ambiente: clona il repository YOLOv5 e installa le dipendenze usando
pip install -r requirements.txt.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - Crea la configurazione del dataset: definisci i percorsi del dataset, il numero di classi e i nomi delle classi in un file
dataset.yaml. - Avvia l'addestramento: esegui lo script
train.py, specificando i percorsi del tuodataset.yaml, i pesi pretrained desiderati (ad es.yolov5s.pt), la dimensione delle immagini, la dimensione del batch e il numero di epoche.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- Prepara il dataset: raccogli immagini e annotale. Assicurati che le annotazioni siano nel formato YOLO richiesto. Organizza immagini ed etichette nelle directory
Ultralytics Platform copre l'intero ciclo di vita dello sviluppo dei modelli YOLO, spesso senza dover scrivere codice. Tra i principali vantaggi:
- Addestramento semplificato: addestra i modelli in ambienti cloud preconfigurati tramite un'interfaccia web.
- Gestione integrata dei dati: carica, crea versioni e gestisci i tuoi dataset sulla piattaforma.
- Monitoraggio in tempo reale: segui i progressi dell'addestramento e visualizza le metriche di prestazione man mano che arrivano.
- Funzionalità di collaborazione: facilita il lavoro di squadra grazie a risorse condivise, strumenti di gestione dei progetti e una facile condivisione dei modelli.
- Distribuzione senza codice: distribuisci i modelli addestrati direttamente su varie destinazioni.
Per una guida pratica, leggi il nostro post sul blog: Come addestrare i tuoi modelli personalizzati con Ultralytics Platform.
Che tu annoti manualmente o usi strumenti automatizzati (come quelli menzionati nella Sezione 1.2), le etichette finali devono rispettare lo specifico formato YOLO richiesto da YOLOv5:
- Crea un file
.txtper ogni immagine. Il nome del file deve corrispondere a quello dell'immagine (ad es.image1.jpgcorrisponde aimage1.txt). Inserisci questi file in una directorylabels/parallela alla directoryimages/(ad es.../datasets/mydataset/labels/train/). - Ogni riga di un file
.txtrappresenta l'annotazione di un oggetto e segue il formato:class_index center_x center_y width height. - Le coordinate (
center_x,center_y,width,height) devono essere normalizzate (valori compresi tra 0.0 e 1.0) rispetto alle dimensioni dell'immagine. - Gli indici delle classi partono da zero (la prima classe è
0, la seconda è1e così via).
Molti strumenti di annotazione manuale offrono l'esportazione diretta nel formato YOLO. Se usi modelli automatizzati, dovrai ricorrere a script o processi per convertire i loro risultati (ad es. coordinate dei riquadri delimitatori, maschere di segmentazione) in questo specifico formato testuale normalizzato. Assicurati che la struttura finale del tuo dataset sia conforme all'esempio fornito nella guida. Per maggiori dettagli, consulta la nostra Guida alla raccolta e all'annotazione dei dati.
- Crea un file
Ultralytics offre licenze flessibili, pensate per esigenze diverse:
- Licenza AGPL-3.0: questa licenza open source è adatta alla ricerca accademica, ai progetti personali e ai casi in cui è accettabile rispettare gli obblighi dell'open source. Impone che anche le modifiche e le opere derivate siano rilasciate con licenza AGPL-3.0. Consulta i dettagli della licenza AGPL-3.0.
- Licenza Enterprise: una licenza commerciale pensata per le aziende che integrano YOLOv5 in prodotti o servizi proprietari. Questa licenza elimina gli obblighi open source di AGPL-3.0 e consente la distribuzione di software closed source. Visita la nostra pagina delle licenze per maggiori dettagli o per richiedere una Licenza Enterprise.
Scegli la licenza più adatta ai requisiti del tuo progetto e al tuo modello di distribuzione.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.