Evoluzione degli iperparametri per YOLOv5#
📚 Questa guida spiega l'evoluzione degli iperparametri per YOLOv5 🚀. L'evoluzione degli iperparametri è un metodo di ottimizzazione degli iperparametri che utilizza un algoritmo genetico (GA) per l'ottimizzazione.
Gli iperparametri nel machine learning controllano vari aspetti dell'addestramento e trovare i valori ottimali può essere difficile. I metodi tradizionali, come la ricerca a griglia, possono diventare rapidamente impraticabili a causa di:
- L'elevata dimensionalità dello spazio di ricerca
- Le correlazioni sconosciute tra le dimensioni
- Il costo elevato della valutazione della fitness in ogni punto
Per questo gli algoritmi genetici sono adatti alla ricerca degli iperparametri.
Prima di iniziare#
Clona il repository e installa requirements.txt in un ambiente Python>=3.8.0, che includa PyTorch>=1.8. Modelli e dataset vengono scaricati automaticamente dalla versione più recente di YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Inizializza gli iperparametri#
YOLOv5 ha circa 30 iperparametri usati per varie impostazioni di addestramento. Sono definiti nei file *.yaml nella directory /data/hyps. Valori iniziali più accurati portano a risultati finali migliori, quindi è importante inizializzare correttamente questi valori prima di avviare l'evoluzione. Se hai dubbi, usa semplicemente i valori predefiniti, ottimizzati per l'addestramento di YOLOv5 su COCO da zero.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Definisci la fitness#
La fitness è il valore che vogliamo massimizzare. In YOLOv5 definiamo una funzione di fitness predefinita come combinazione ponderata di metriche: mAP@0.5 contribuisce per il 10% del peso e mAP@0.5:0.95 per il restante 90%, mentre precisione (P) e richiamo (R) sono esclusi. Puoi modificarli come preferisci oppure usare la definizione di fitness predefinita in utils/metrics.py (consigliato). Questa fitness determina quale risultato viene salvato in hyp_evolve.yaml; l'algoritmo genetico stesso classifica i genitori e gli individui migliori basandosi solo su mAP@0.5, quindi modificare questi pesi non cambia la selezione dei genitori.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # pesi per [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Evoluzione#
L’evoluzione viene eseguita a partire da uno scenario di base che cerchiamo di migliorare. In questo esempio, lo scenario di base consiste nel fine-tuning di COCO128 per 10 epoche usando YOLOv5s preaddestrato. Il comando di addestramento dello scenario di base è:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cachePer far evolvere gli iperparametri specifici di questo scenario, partendo dai valori iniziali definiti nella Sezione 1. e massimizzando la funzione di fitness definita nella Sezione 2., aggiungi --evolve:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
Le impostazioni predefinite dell’evoluzione prevedono 300 generazioni e ogni generazione addestra lo scenario di base una volta per ciascuno dei 50 individui della popolazione. Puoi modificare il numero di generazioni con l’argomento --evolve, ad esempio python train.py --evolve 1000.
I principali operatori genetici sono crossover e mutazione. A ogni generazione, ogni individuo viene addestrato e valutato in base a mAP@0.5; i genitori vengono selezionati tramite selezione a torneo, aggiungendo alla popolazione dei genitori gli individui élite con la fitness più alta, e la generazione successiva viene creata tramite crossover e mutazione, con tassi che si adattano con il progredire dell’evoluzione. I risultati vengono registrati in runs/evolve/exp/evolve.csv e, a ogni generazione, la prole con la fitness più alta viene salvata come runs/evolve/exp/hyp_evolve.yaml:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
Per ottenere i migliori risultati, consigliamo almeno 300 generazioni di evoluzione. Tieni presente che l’evoluzione è generalmente costosa e richiede molto tempo, poiché lo scenario di base viene addestrato migliaia di volte e può richiedere centinaia o migliaia di ore GPU.
Al termine dell’evoluzione, riutilizza le impostazioni individuate indirizzando l’addestramento al file salvato, ad esempio python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. Visualizza#
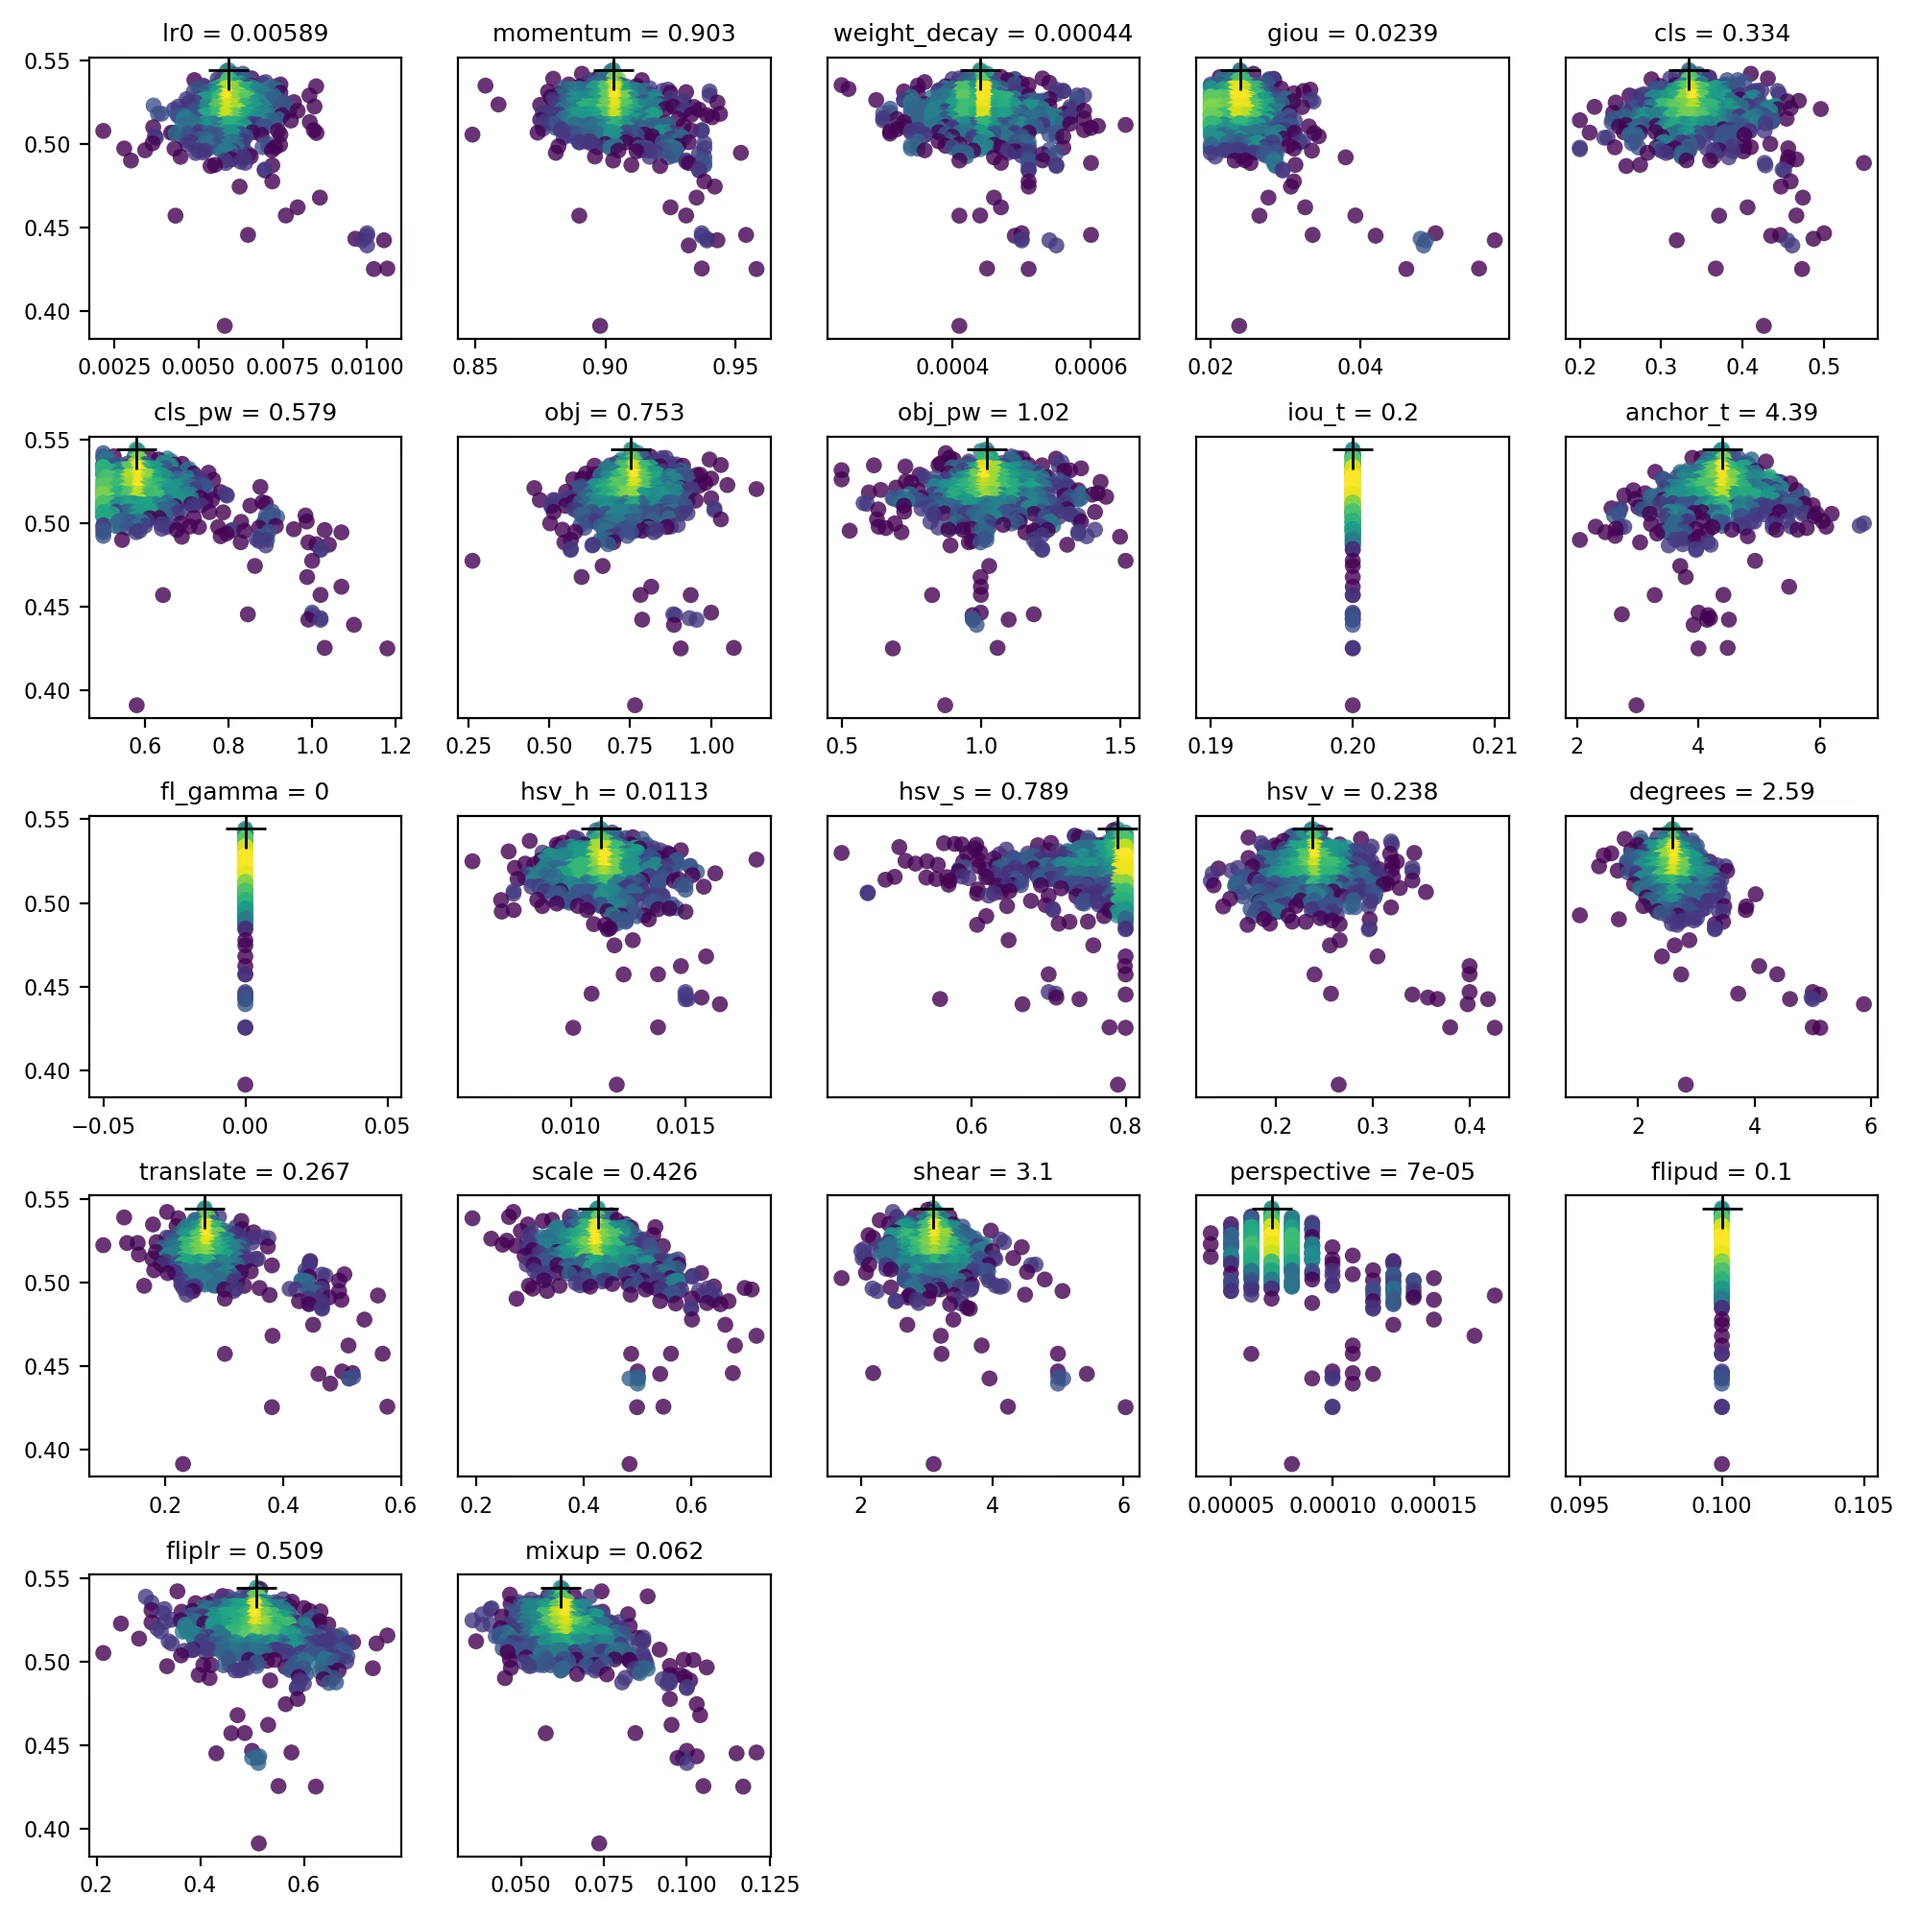
Al termine dell’evoluzione, evolve.csv viene rappresentato da evolve.png tramite utils.plots.plot_evolve(), con un grafico per ogni iperparametro che mostra la fitness (asse y) rispetto ai valori dell’iperparametro (asse x). Il giallo indica le concentrazioni più elevate. Le distribuzioni verticali indicano che un parametro è stato disabilitato e non subisce mutazioni. Questa opzione è selezionabile dall’utente nel dizionario meta in train.py ed è utile per bloccare i parametri e impedirne l’evoluzione.
Ambienti supportati#
Ultralytics offre una gamma di ambienti pronti all'uso, ciascuno con le dipendenze essenziali già installate, come CUDA, CUDNN, Python e PyTorch, per dare il via ai tuoi progetti.
- Notebook GPU gratuiti:


- Google Cloud: Guida rapida a GCP
- Amazon: Guida rapida ad AWS
- Azure: Guida rapida ad AzureML
- Docker: Guida rapida a Docker

Stato del progetto#

Questo badge indica che tutti i test di integrazione continua (CI) di YOLOv5 GitHub Actions sono superati correttamente. Questi test CI verificano rigorosamente la funzionalità e le prestazioni di YOLOv5 in diversi ambiti chiave: addestramento, validazione, inferenza, esportazione e benchmark. Garantiscono un funzionamento coerente e affidabile su macOS, Windows e Ubuntu, con test eseguiti ogni 24 ore e a ogni nuovo commit.
Domande frequenti#
Ogni generazione addestra lo scenario di base una volta per ciascun individuo della popolazione di 50 elementi; pertanto, 300 generazioni di un’esecuzione di COCO128 per 10 epoche equivalgono all’incirca a 15.000 volte il costo di una singola esecuzione di questo tipo. Mantieni lo scenario di base breve e rappresentativo. Il ciclo multi-GPU qui sopra avvia una ricerca indipendente su ogni GPU, anziché condividere un’unica ricerca; se lavori con un budget fisso, riduci
--evolveper ogni processo.Sì.
--evolveè impostato per impostazione predefinita su 300 generazioni; passa un numero, ad esempio--evolve 1000, per eseguirne di più.Imposta il primo valore della relativa voce nel dizionario
metaintrain.pysuFalse. I parametri esclusi mantengono il valore iniziale e appaiono come linee verticali inevolve.png.Passa il file salvato a una normale esecuzione di addestramento:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.