Distribuisci YOLOv5 con DeepSparse di Neural Magic#
Neural Magic è stata acquisita da Red Hat a gennaio 2025 e il 2 giugno 2025 ha dichiarato obsolete le versioni per la community di DeepSparse, SparseML, SparseZoo e Sparsify. Gli strumenti continuano a funzionare, ma non ricevono più aggiornamenti né supporto. Per un'accelerazione CPU mantenuta, consulta le integrazioni OpenVINO e ONNX.
Benvenuto nell'IA fornita tramite software.
Questa guida spiega come distribuire YOLOv5 con DeepSparse di Neural Magic.
DeepSparse è un runtime di inferenza dalle prestazioni eccezionali sulle CPU. Per esempio, rispetto alla baseline di ONNX Runtime, DeepSparse offre un'accelerazione di 5.8x con YOLOv5s, sulla stessa macchina!
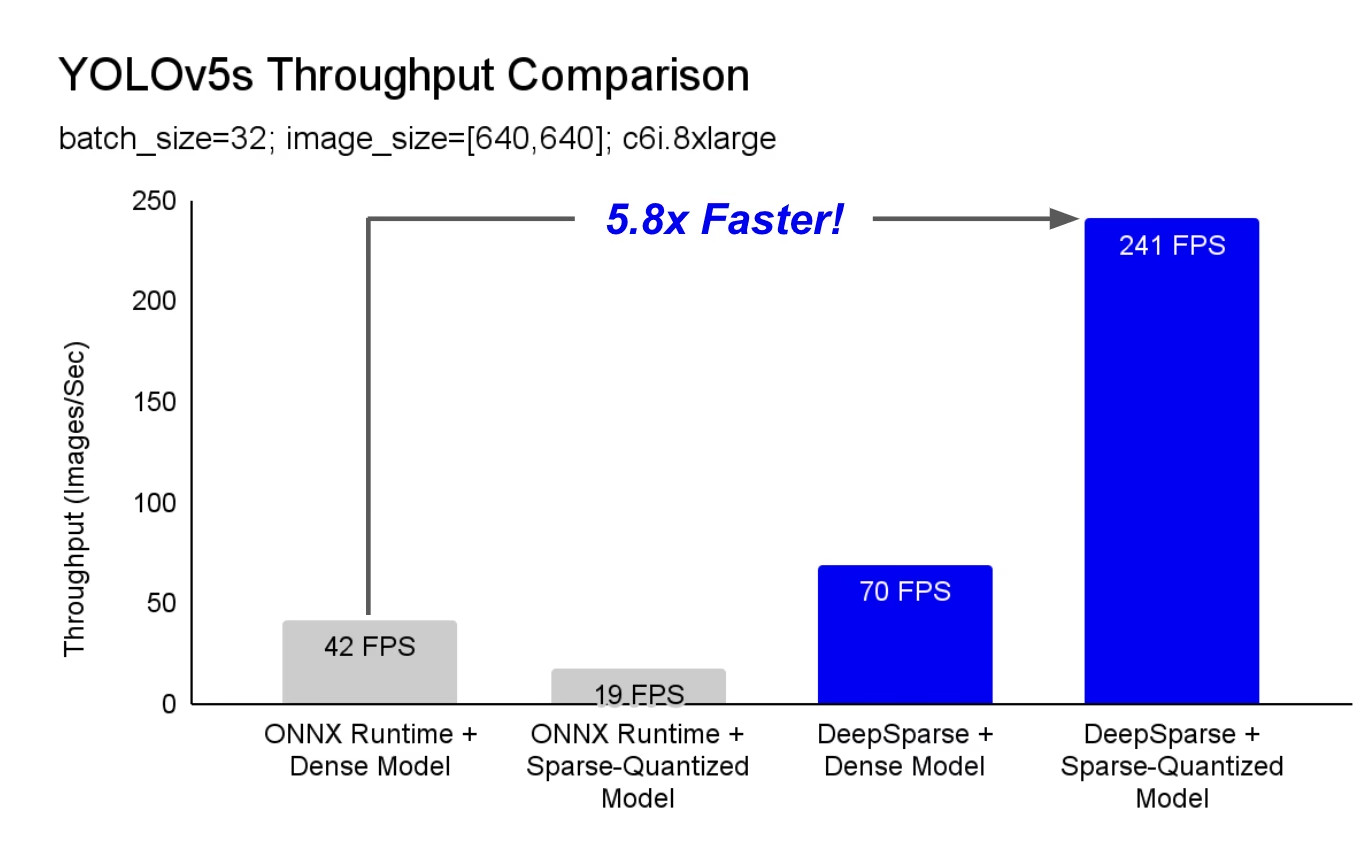
Per la prima volta, i tuoi carichi di lavoro di deep learning possono soddisfare i requisiti prestazionali della produzione senza la complessità e i costi degli acceleratori hardware. In poche parole, DeepSparse ti offre le prestazioni delle GPU e la semplicità del software:
- Distribuzioni flessibili: esecuzione coerente su cloud, data center ed edge con hardware di qualsiasi fornitore, da Intel ad AMD ad ARM
- Scalabilità illimitata: scala verticalmente fino a centinaia di core, orizzontalmente con Kubernetes standard o con astrazione completa tramite serverless
- Integrazione semplice: API pulite per integrare il tuo modello in un'applicazione e monitorarlo in produzione
In che modo DeepSparse raggiunge prestazioni paragonabili a quelle delle GPU?#
DeepSparse sfrutta la sparsità del modello per ottenere prestazioni più elevate.
La sparsificazione tramite pruning e quantizzazione è una tecnica ampiamente studiata che consente di ridurre di ordini di grandezza le dimensioni e i calcoli necessari per eseguire una rete, mantenendo un'elevata accuratezza. DeepSparse è consapevole della sparsità, ovvero salta i parametri azzerati, riducendo la quantità di calcoli in un passaggio forward. Poiché i calcoli sparsi sono ora limitati dalla memoria, DeepSparse esegue la rete in profondità, suddividendo il problema in colonne tensoriali, strisce verticali di calcolo che entrano nella cache.
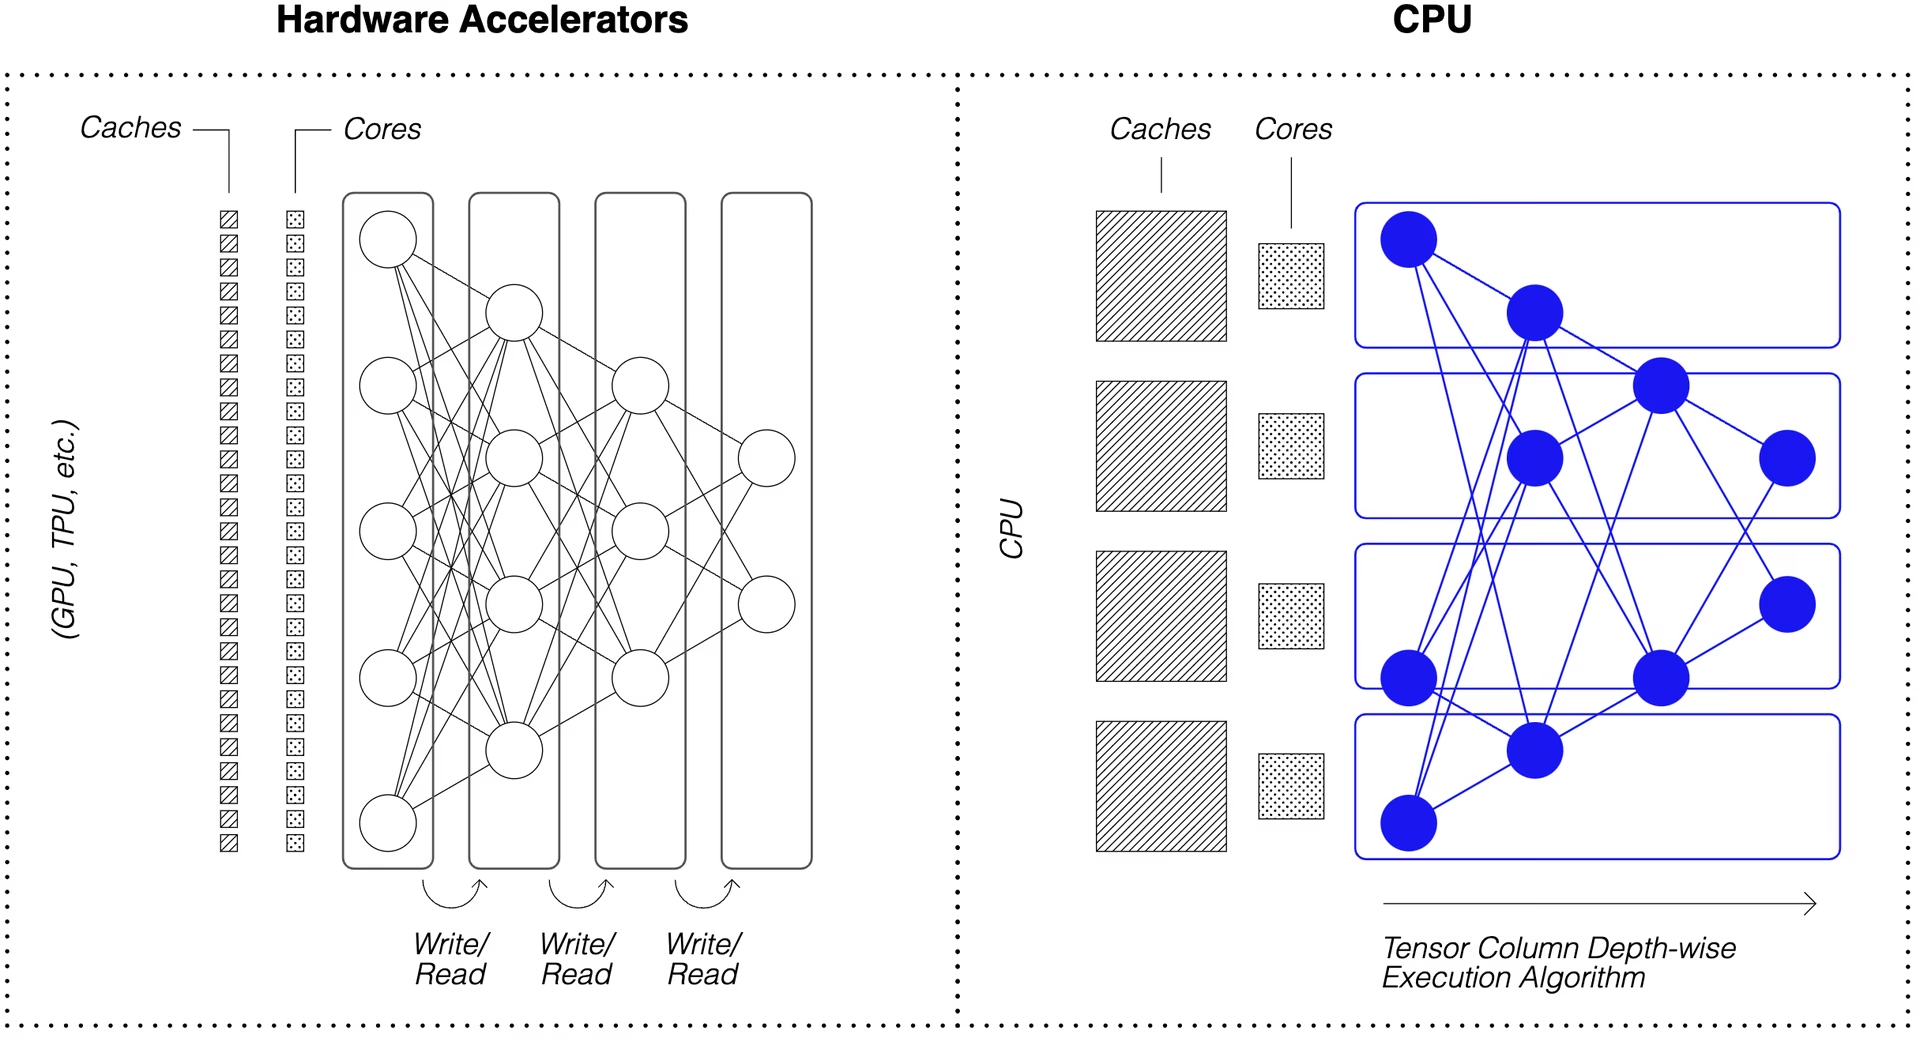
Grazie alle reti sparse con calcoli compressi, eseguiti in profondità nella cache, DeepSparse offre prestazioni paragonabili a quelle delle GPU sulle CPU!
Come posso creare una versione sparsa di YOLOv5 addestrata sui miei dati?#
Il repository open source di modelli di Neural Magic, SparseZoo, contiene checkpoint già sparsificati per ogni modello YOLOv5. Con SparseML, integrato con Ultralytics, puoi ottimizzare un checkpoint sparso sui tuoi dati con un singolo comando CLI.
Per ulteriori dettagli, consulta l'integrazione di SparseML con YOLOv5.
Utilizzo di DeepSparse#
Vedremo un esempio di benchmarking e distribuzione di una versione sparsa di YOLOv5s con DeepSparse.
Installa DeepSparse#
Esegui il comando seguente per installare DeepSparse. Ti consigliamo di usare un ambiente virtuale con Python.
pip install "deepsparse[server,yolo,onnxruntime]"Recupera un file ONNX#
DeepSparse accetta un modello in formato ONNX, fornito in uno dei seguenti modi:
- Uno stub di SparseZoo che identifica un file ONNX in SparseZoo
- Un percorso locale nel file system a un modello ONNX
Gli esempi seguenti usano i checkpoint standard e potati-quantizzati di YOLOv5s, identificati dai seguenti stub di SparseZoo:
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Distribuisci un modello#
DeepSparse offre API pratiche per integrare il tuo modello in un'applicazione.
Per provare gli esempi di distribuzione qui sotto, scarica un'immagine campione e salvala come basilica.jpg con il comando seguente:
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgAPI Python#
Pipelines racchiude il pre-processing e il post-processing dell'output attorno al runtime, offrendo un'interfaccia pulita per aggiungere DeepSparse a un'applicazione. L'integrazione DeepSparse-Ultralytics include un Pipeline pronto all'uso che accetta immagini grezze e restituisce i riquadri di delimitazione.
Crea un Pipeline ed esegui l'inferenza:
from deepsparse import Pipeline

# elenco di immagini nel file system locale
images = ["basilica.jpg"]

# crea Pipeline
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# esegui l'inferenza sulle immagini e ricevi riquadri di delimitazione e classi
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
Se esegui il programma nel cloud, potresti ricevere un errore perché OpenCV non riesce a trovare libGL.so.1. Puoi installare la libreria mancante:
apt-get install libgl1In alternativa, usa la build headless di OpenCV, che evita del tutto le dipendenze dalla GUI:
pip install opencv-python-headlessServer HTTP#
DeepSparse Server si basa sul popolare framework web FastAPI e sul server web Uvicorn. Con un solo comando CLI puoi configurare facilmente un endpoint di servizio per un modello con DeepSparse. Server supporta qualsiasi Pipeline di DeepSparse, incluso il rilevamento di oggetti con YOLOv5, così puoi inviare immagini grezze all'endpoint e ricevere i riquadri di delimitazione.
Avvia Server con YOLOv5s potato e quantizzato:
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Esempio di richiesta che usa il pacchetto requests di Python:
import json
from contextlib import ExitStack

import requests

# elenco di immagini per l'inferenza (file locali sul lato client)
path = ["basilica.jpg"]

# invia la richiesta tramite HTTP all'endpoint /predict/from_files
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# la risposta viene restituita in JSON
annotations = json.loads(resp.text)  # dizionario dei risultati delle annotazioni
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]
CLI di annotazione#
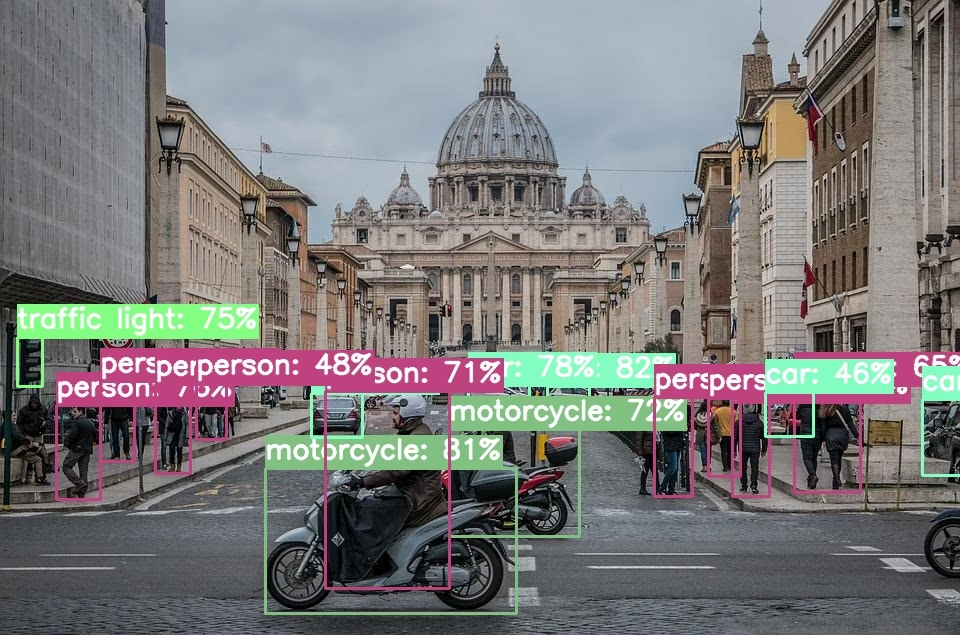
Puoi anche usare il comando annotate per fare in modo che il motore salvi su disco una foto annotata. Prova --source 0 per annotare il flusso della webcam in tempo reale!
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpgL'esecuzione del comando precedente creerà una cartella annotation-results e vi salverà l'immagine annotata.
Prestazioni nei benchmark#
Confronteremo il throughput di DeepSparse con quello di ONNX Runtime su YOLOv5s, usando lo script di benchmarking di DeepSparse.
I benchmark sono stati eseguiti su un'istanza AWS c6i.8xlarge (16 core).
Confronto delle prestazioni con batch 32#
Baseline di ONNX Runtime#
Con un batch di 32, ONNX Runtime raggiunge 42 immagini/sec con YOLOv5s standard denso:
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
Prestazioni di DeepSparse su modelli densi#
DeepSparse offre le prestazioni migliori con modelli sparsi ottimizzati, ma funziona bene anche con YOLOv5s standard denso.
Con un batch di 32, DeepSparse raggiunge 70 immagini/sec con YOLOv5s standard denso, un miglioramento delle prestazioni di 1.7x rispetto a ORT!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
Prestazioni di DeepSparse su modelli sparsi#
Quando si applica la sparsità al modello, i miglioramenti prestazionali di DeepSparse rispetto a ONNX Runtime sono ancora più marcati.
Con un batch di 32, DeepSparse raggiunge 241 immagini/sec con YOLOv5s potato e quantizzato, un miglioramento delle prestazioni di 5.8x rispetto a ORT!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
Confronto delle prestazioni con batch 1#
DeepSparse riesce a offrire prestazioni superiori a ONNX Runtime anche nello scenario con batch 1, sensibile alla latenza.
Baseline di ONNX Runtime#
Con un batch di 1, ONNX Runtime raggiunge 48 immagini/sec con YOLOv5s standard denso.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
Prestazioni di DeepSparse su modelli sparsi#
Con un batch di 1, DeepSparse raggiunge 135 elementi/sec con YOLOv5s potato e quantizzato, con un miglioramento delle prestazioni di 2.8x rispetto a ONNX Runtime!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
Poiché le istanze c6i.8xlarge dispongono di istruzioni VNNI, è possibile aumentare ulteriormente il throughput di DeepSparse potando i pesi in blocchi di 4.
Con un batch di 1, DeepSparse raggiunge 180 elementi/sec con YOLOv5s potato e quantizzato a blocchi di 4, un miglioramento delle prestazioni di 3.7x rispetto a ONNX Runtime!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
Inizia a usare DeepSparse#
Ricerca o test? DeepSparse Community è gratuito per la ricerca e i test. Inizia con il README di DeepSparse.
Per ulteriori informazioni sulla distribuzione di YOLOv5 con DeepSparse, consulta gli esempi di DeepSparse per YOLOv5 e il post del blog di Ultralytics sull'integrazione di DeepSparse.
Domande frequenti#
No. DeepSparse è un runtime per CPU e i benchmark sopra sono stati misurati su un'istanza AWS
c6i.8xlargea 16 core, senza acceleratori.Esportalo in ONNX con
python export.py --weights best.pt --include onnxe passa il percorso del file comemodel_pathanziché uno stub di SparseZoo. Anche i modelli densi traggono vantaggio dal runtime, ma quelli potati e quantizzati ne traggono il massimo.Esegui il fine-tuning di uno dei checkpoint SparseZoo pre-sparsificati sui tuoi dati con SparseML, che mantiene la struttura di sparsità durante l'addestramento, quindi esporta il modello in ONNX.
No. Le versioni Community sono state deprecate il 2 giugno 2025 e i pacchetti su PyPI sono congelati. Le pipeline esistenti continuano a funzionare, ma per le nuove distribuzioni è consigliabile valutare le soluzioni OpenVINO o ONNX Runtime, che sono attivamente mantenute.