Attività di visione artificiale supportate da Ultralytics YOLO26
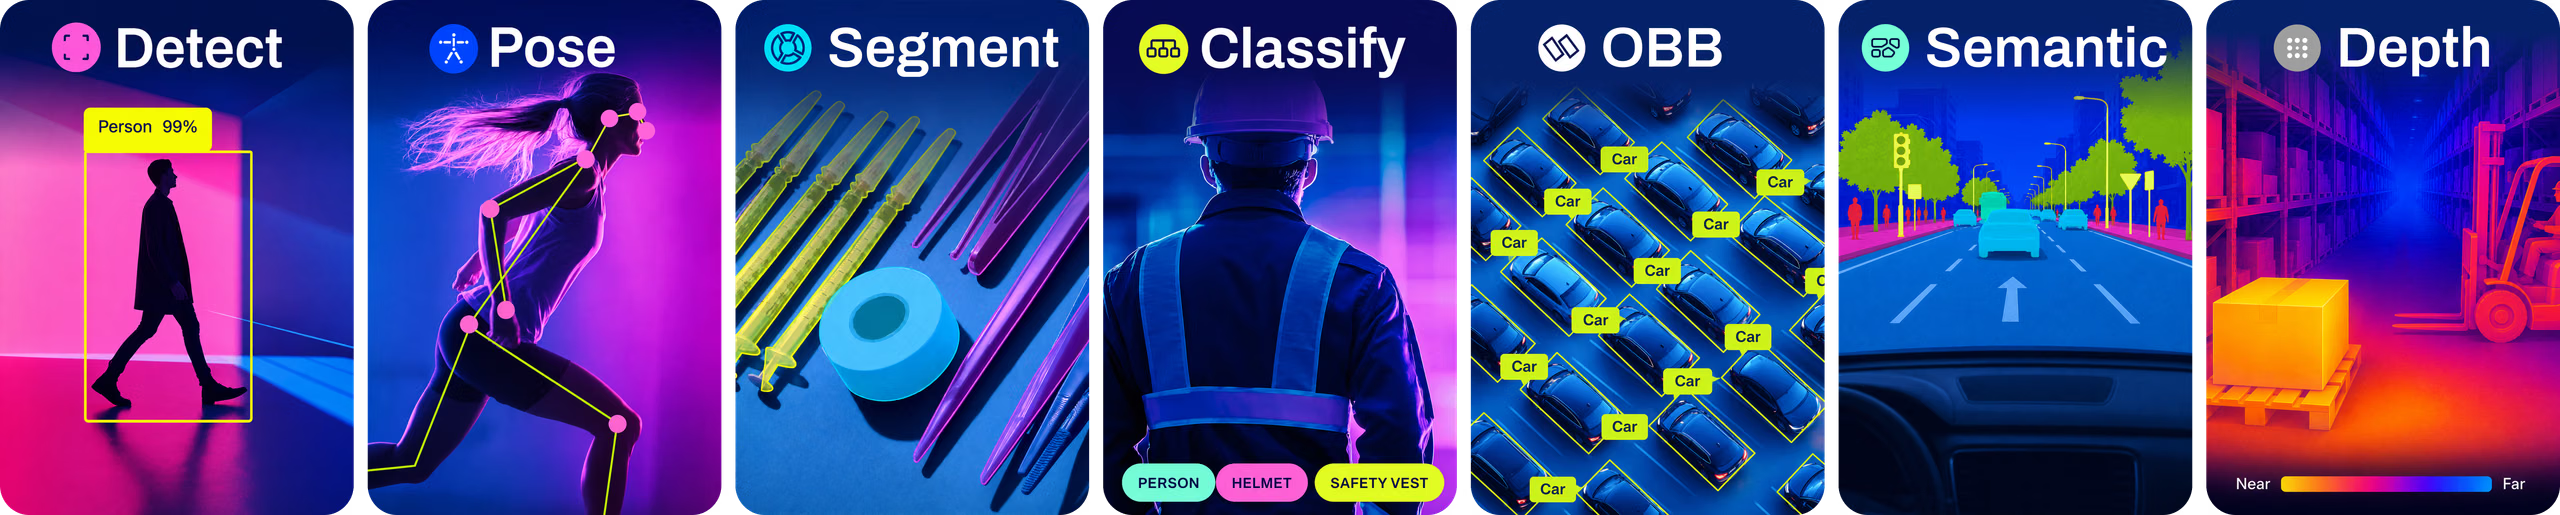
Ultralytics YOLO26 supporta diverse attività di visione artificiale: rilevamento, segmentazione, segmentazione semantica, stima della profondità, classificazione, stima della posa e OBB. Ogni attività ha un obiettivo e un caso d'uso diversi, così puoi affrontare una vasta gamma di problemi di visione artificiale con un unico framework.
Per informazioni sul supporto previsto per YOLO27, consulta l'anteprima di YOLO27. YOLO27 arriverà a breve e non è ancora disponibile; questa guida usa i modelli YOLO26 rilasciati.
Guarda: Esplora le attività di Ultralytics YOLO26: rilevamento degli oggetti, segmentazione di istanze, segmentazione semantica, stima della profondità, classificazione, stima della posa e OBB.
Rilevamento#
Il rilevamento degli oggetti è l'attività principale supportata da YOLO26. Consiste nell'identificare gli oggetti in un'immagine o in un fotogramma video e nel disegnare riquadri di delimitazione attorno a essi. Gli oggetti rilevati vengono classificati in categorie diverse in base alle loro caratteristiche. YOLO26 rileva rapidamente più oggetti in una singola immagine o in un singolo fotogramma video, abbastanza da supportare applicazioni in tempo reale come i sistemi di sorveglianza e i veicoli autonomi.
Segmentazione di istanze#
La segmentazione di istanze porta il rilevamento degli oggetti oltre, producendo maschere a livello di pixel per ciascun oggetto. Questa precisione è utile in applicazioni come l'imaging medico, l'analisi agricola e il controllo qualità nella produzione.
Segmentazione semantica#
La segmentazione semantica assegna un'etichetta di classe a ogni pixel di un'immagine, producendo una mappa di classi densa dell'intera scena. A differenza della segmentazione di istanze, non distingue tra singoli oggetti della stessa classe. Per questo è particolarmente adatta alla guida autonoma, all'analisi delle scene e alla mappatura della copertura del suolo, dove comprendere l'intera disposizione spaziale è più importante che identificare i singoli oggetti.
Esempi di segmentazione semantica
Stima della profondità#
La stima monoculare della profondità predice una mappa della profondità per pixel, espressa in metri, a partire da una singola immagine RGB. L'output è una mappa densa di valori float allineata all'immagine di input, adatta alla ricostruzione di scene 3D, alla navigazione robotica e alle applicazioni AR/VR in cui la disposizione spaziale deve essere dedotta da una singola fotocamera.
Esempi di stima della profondità
Classificazione#
La classificazione delle immagini consiste nel categorizzare immagini intere in base al loro contenuto. Questa attività è utile in applicazioni come la categorizzazione dei prodotti nell'e-commerce, la moderazione dei contenuti e il monitoraggio della fauna selvatica.
Stima della posa#
La stima della posa rileva specifici punti chiave nelle immagini o nei fotogrammi video per tracciare i movimenti o stimare le pose. Questi punti chiave possono rappresentare articolazioni umane, tratti del viso o altri punti di interesse significativi. I modelli di stima della posa di YOLO26 rilevano i punti chiave in tempo reale, risultando utili per le applicazioni di fitness, l'analisi sportiva e l'interazione uomo-computer.
OBB#
Il rilevamento con riquadri di delimitazione orientati (OBB) migliora il rilevamento tradizionale degli oggetti aggiungendo un angolo di orientamento che permette di localizzare meglio gli oggetti ruotati. Questa capacità è particolarmente utile per l'analisi di immagini aeree, l'elaborazione di documenti e le applicazioni industriali, in cui gli oggetti possono apparire con orientamenti diversi. I modelli OBB di YOLO26 sono preaddestrati sul dataset di immagini aeree DOTAv1.
E adesso?#
Hai scelto un’attività? Formatta i dati seguendo la guida ai dataset, quindi addestra il modello sulle tue immagini.
Domande frequenti#
Ultralytics YOLO26 supporta le seguenti attività di visione artificiale:
- Rilevamento degli oggetti: identificare e localizzare gli oggetti nelle immagini o nei fotogrammi video disegnando attorno a essi dei riquadri delimitatori.
- Segmentazione delle istanze: produrre una maschera a livello di pixel per ogni oggetto rilevato, utile in applicazioni come l’imaging medico.
- Segmentazione semantica: assegnare un’etichetta di classe a ogni pixel di un’immagine per ottenere una comprensione dettagliata della scena.
- Stima della profondità: prevedere una mappa di profondità in metri per ogni pixel a partire da una singola immagine RGB.
- Classificazione: classificare immagini intere in base al loro contenuto.
- Stima della posa: rilevare punti chiave specifici in un’immagine o in un fotogramma video per tracciare movimenti o pose.
- Rilevamento di oggetti orientati (OBB): rilevare oggetti ruotati con un angolo di orientamento aggiuntivo per una maggiore accuratezza.
Per usare Ultralytics YOLO26 per il rilevamento degli oggetti, segui questi passaggi:
- Prepara il dataset nel formato appropriato.
- Addestra il modello YOLO26 con l’attività di rilevamento.
- Usa il modello per fare previsioni fornendogli nuove immagini o fotogrammi video.
Esempiofrom ultralytics import YOLO # Carica un modello YOLO preaddestrato (modifica il tipo di modello secondo necessità) model = YOLO("yolo26n.pt") # Sono disponibili le versioni n, s, m, l, x # Esegui il rilevamento degli oggetti su un'immagine results = model.predict(source="image.jpg") # Puoi usare anche un video, una directory, un URL, ecc. # Visualizza i risultati results[0].show() # Mostra i risultati della prima immaginePer istruzioni più dettagliate, consulta i nostri esempi di rilevamento.
Usare YOLO26 per le attività di segmentazione offre diversi vantaggi:
- Elevata accuratezza: l’attività di segmentazione fornisce maschere precise a livello di pixel.
- Velocità: YOLO26 è ottimizzato per le applicazioni in tempo reale e offre un’elaborazione rapida anche per immagini ad alta risoluzione.
- Molteplici applicazioni: è ideale per l’imaging medico, la guida autonoma e altre applicazioni che richiedono una segmentazione dettagliata delle immagini.
Scopri di più sui vantaggi e sui casi d’uso di YOLO26 per la segmentazione nella sezione sulla segmentazione delle immagini.
Sì. I modelli di stima della posa di YOLO26 rilevano i punti chiave, come le articolazioni umane, nelle immagini e nei fotogrammi video e li collegano per formare pose. Questa funzionalità è utile per tracciare i movimenti nell'analisi sportiva, nell'assistenza sanitaria e nelle applicazioni di interazione uomo-computer.
Per ulteriori dettagli e suggerimenti sull’implementazione, visita i nostri esempi di stima della posa.
Il rilevamento degli oggetti orientati (OBB) con YOLO26 predice un parametro angolare aggiuntivo per ogni riquadro, localizzando gli oggetti ruotati con maggiore precisione rispetto ai riquadri allineati agli assi. È utile nelle applicazioni che richiedono una localizzazione precisa degli oggetti ruotati, come l'analisi di immagini aeree e l'automazione dei magazzini.
- Riquadri più precisi: i riquadri ruotati includono meno sfondo, facilitando la separazione degli oggetti ravvicinati o inclinati.
- Applicazioni versatili: utile per attività di analisi geospaziale, robotica ecc.
Consulta la sezione sul rilevamento di oggetti orientati per ulteriori dettagli ed esempi.


Commenti15
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(modificato)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(modificato)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(modificato)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1