Architettura Ultralytics YOLOv5#
YOLOv5 (v6.0/6.1) è un potente algoritmo di rilevamento degli oggetti sviluppato da Ultralytics. Questo articolo approfondisce l’architettura di YOLOv5, le strategie di aumento dei dati, le metodologie di addestramento e le tecniche di calcolo della loss. Questa panoramica completa ti aiuterà a migliorare l’applicazione pratica del rilevamento degli oggetti in vari ambiti, tra cui la videosorveglianza, i veicoli autonomi e il riconoscimento delle immagini.
1. Struttura del modello#
L’architettura di YOLOv5 è composta da tre parti principali:
- Backbone: è il corpo principale della rete. In YOLOv5, il backbone è progettato usando la struttura
CSPDarknet53, una modifica dell’architettura Darknet utilizzata nelle versioni precedenti. - Neck: questa parte collega il backbone alla head. YOLOv5 utilizza le strutture
SPPF(Spatial Pyramid Pooling - Fast) ePANet(Path Aggregation Network). - Head: questa parte genera l’output finale. A questo scopo, YOLOv5 usa
YOLOv3 Head.
La struttura del modello è illustrata nell’immagine seguente. I dettagli sulla struttura del modello sono disponibili in models/yolov5l.yaml.
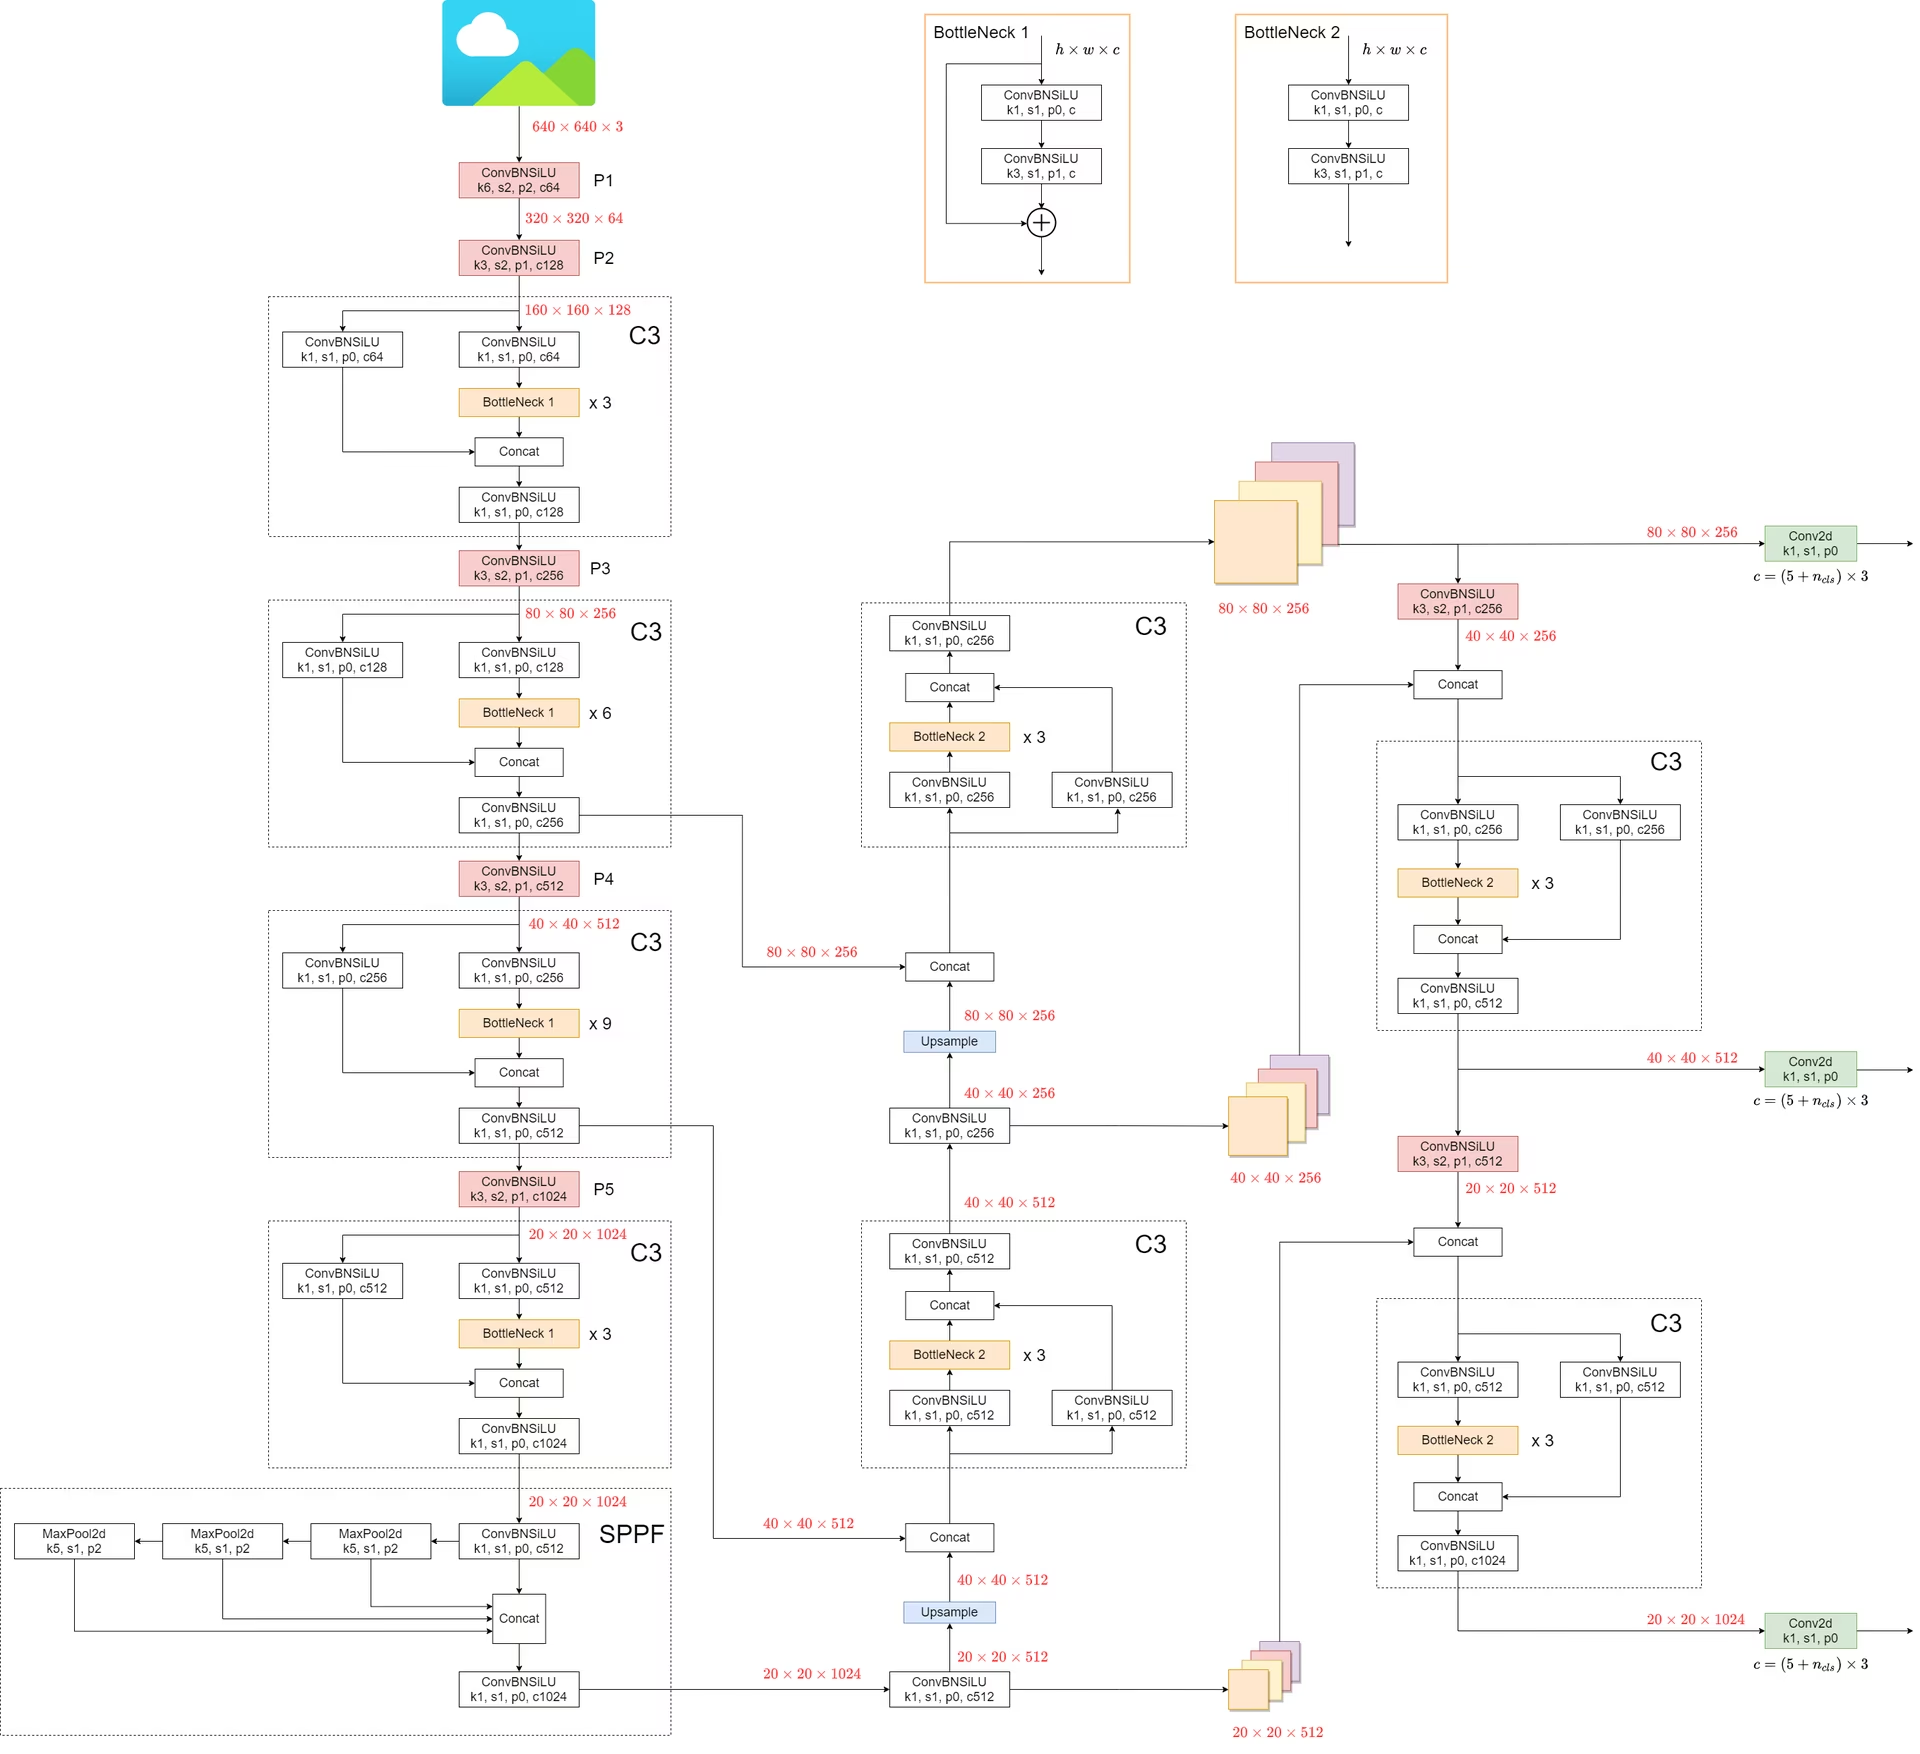
YOLOv5 introduce alcuni miglioramenti significativi rispetto alle versioni precedenti:
- La struttura
Focus, presente nelle versioni precedenti, viene sostituita dalla struttura6x6 Conv2d. Questa modifica migliora l’efficienza #4825. - La struttura
SPPviene sostituita daSPPF. Questa modifica più che raddoppia la velocità di elaborazione mantenendo lo stesso output.
Per confrontare la velocità di SPP e SPPF, puoi usare il seguente codice:
Esempio di profilazione della velocità di SPP rispetto a SPPF (fai clic per aprire)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
risultato:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Tecniche di aumento dei dati#
YOLOv5 utilizza diverse tecniche di aumento dei dati per migliorare la capacità del modello di generalizzare e ridurre l’overfitting. Tra queste tecniche figurano:
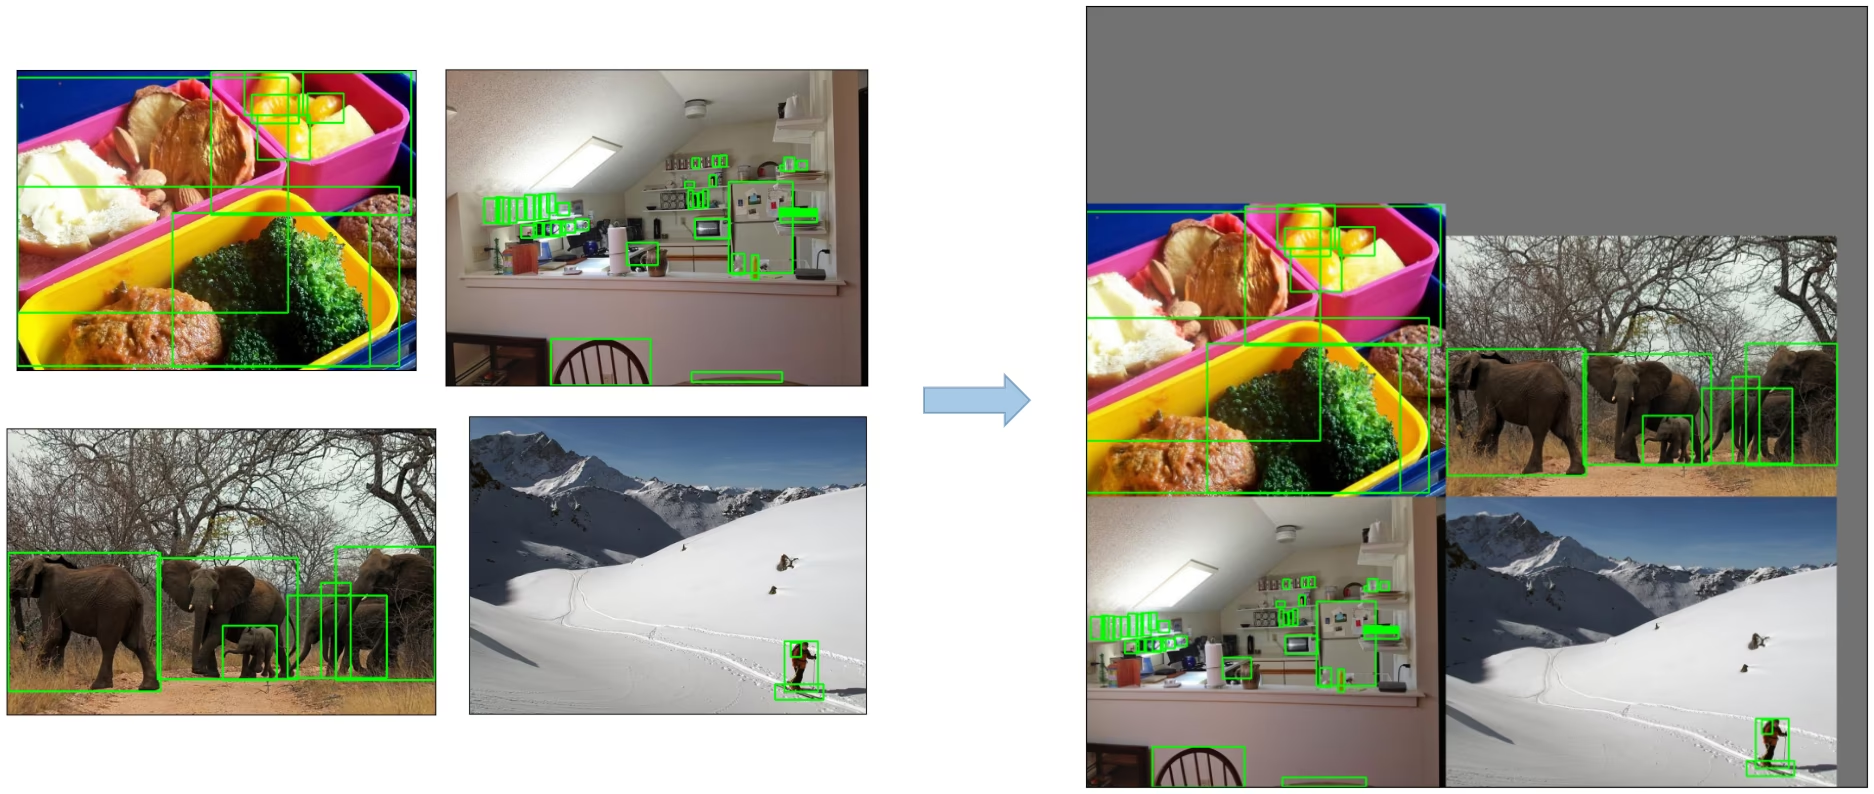
-
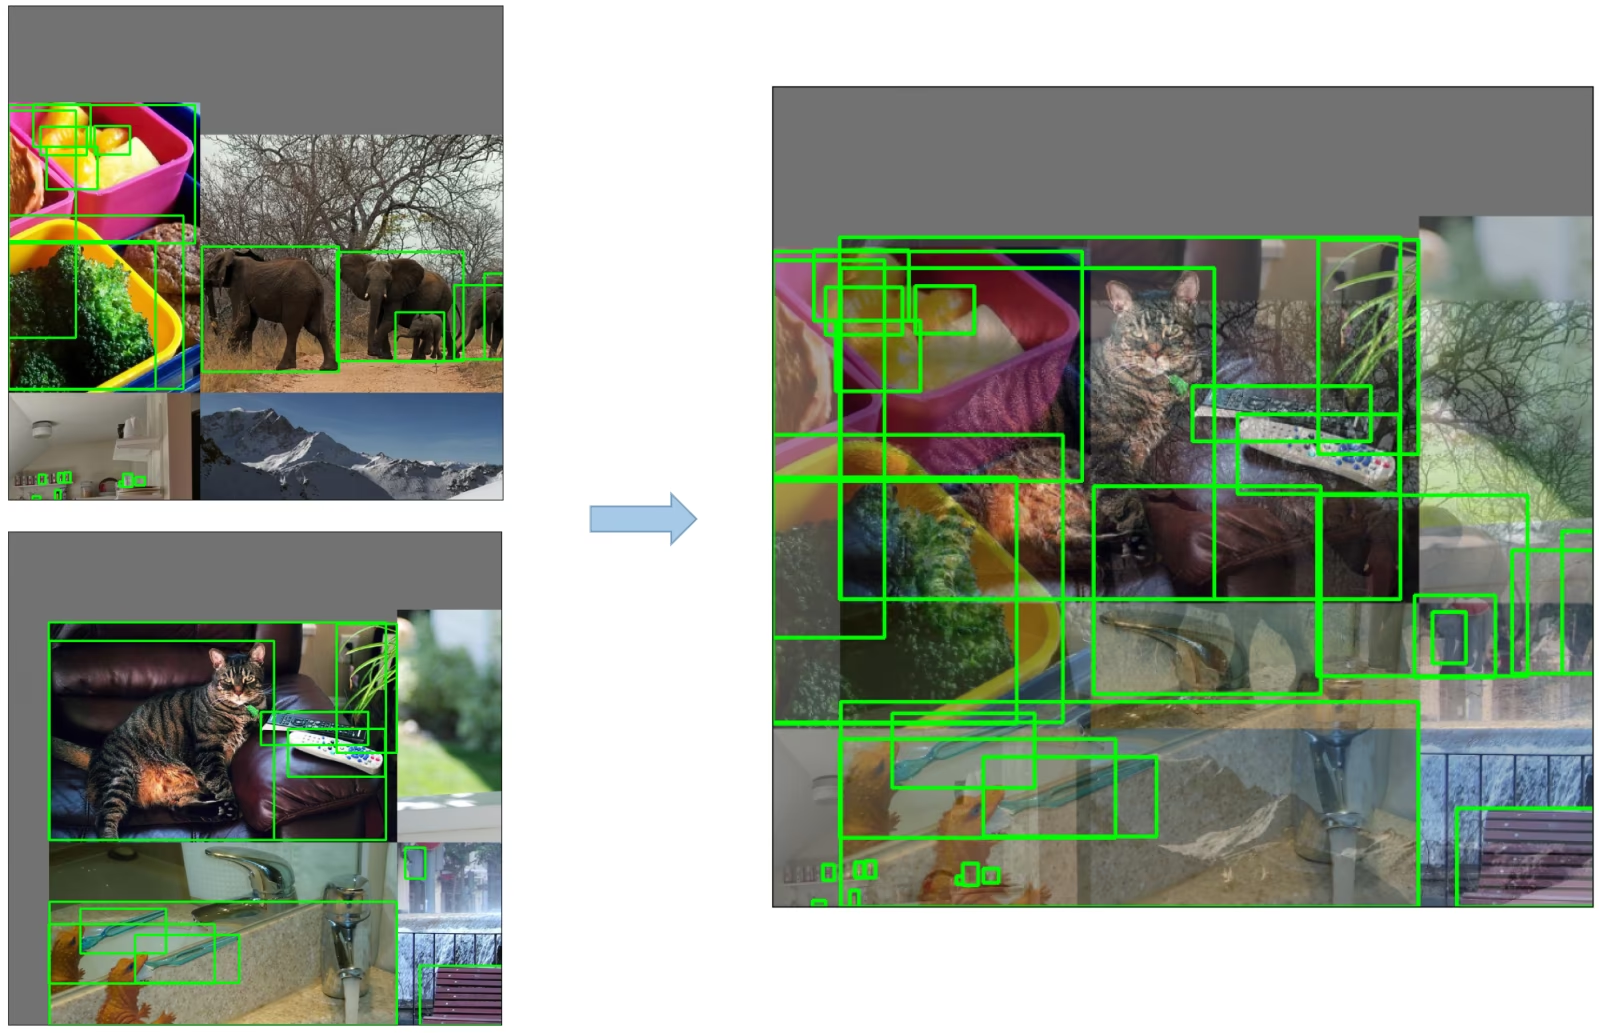
Aumento Mosaic: una tecnica di elaborazione delle immagini che combina quattro immagini di addestramento in una, così da aiutare i modelli di rilevamento degli oggetti a gestire meglio oggetti di scale e traslazioni diverse.
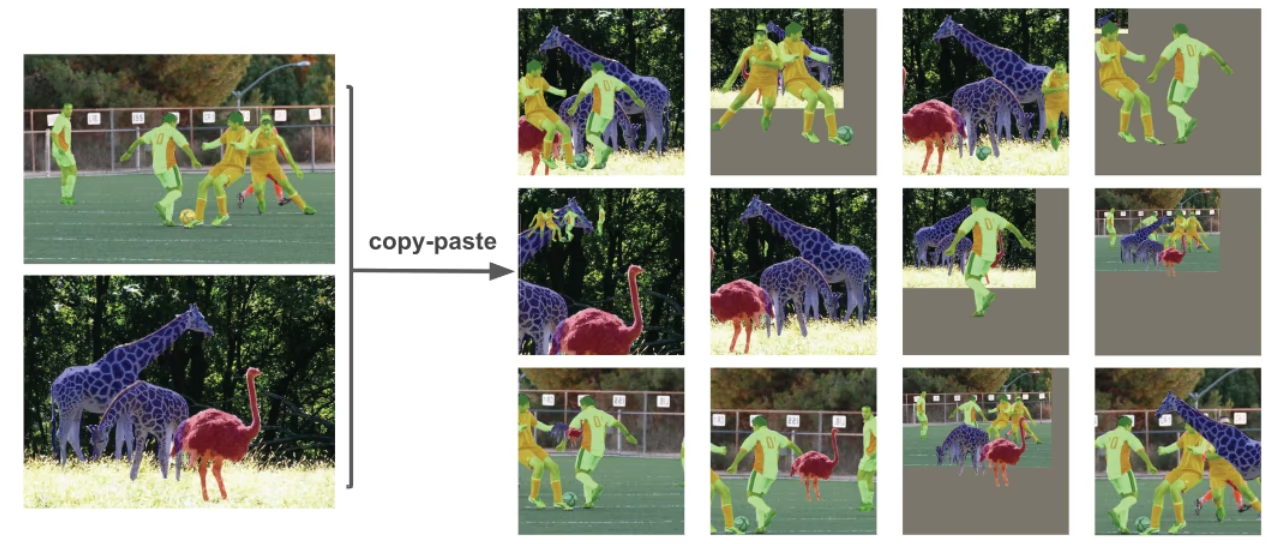
-
Aumento Copy-Paste: un metodo innovativo di aumento dei dati che copia porzioni casuali di un’immagine e le incolla su un’altra immagine scelta casualmente, generando così un nuovo campione di addestramento.
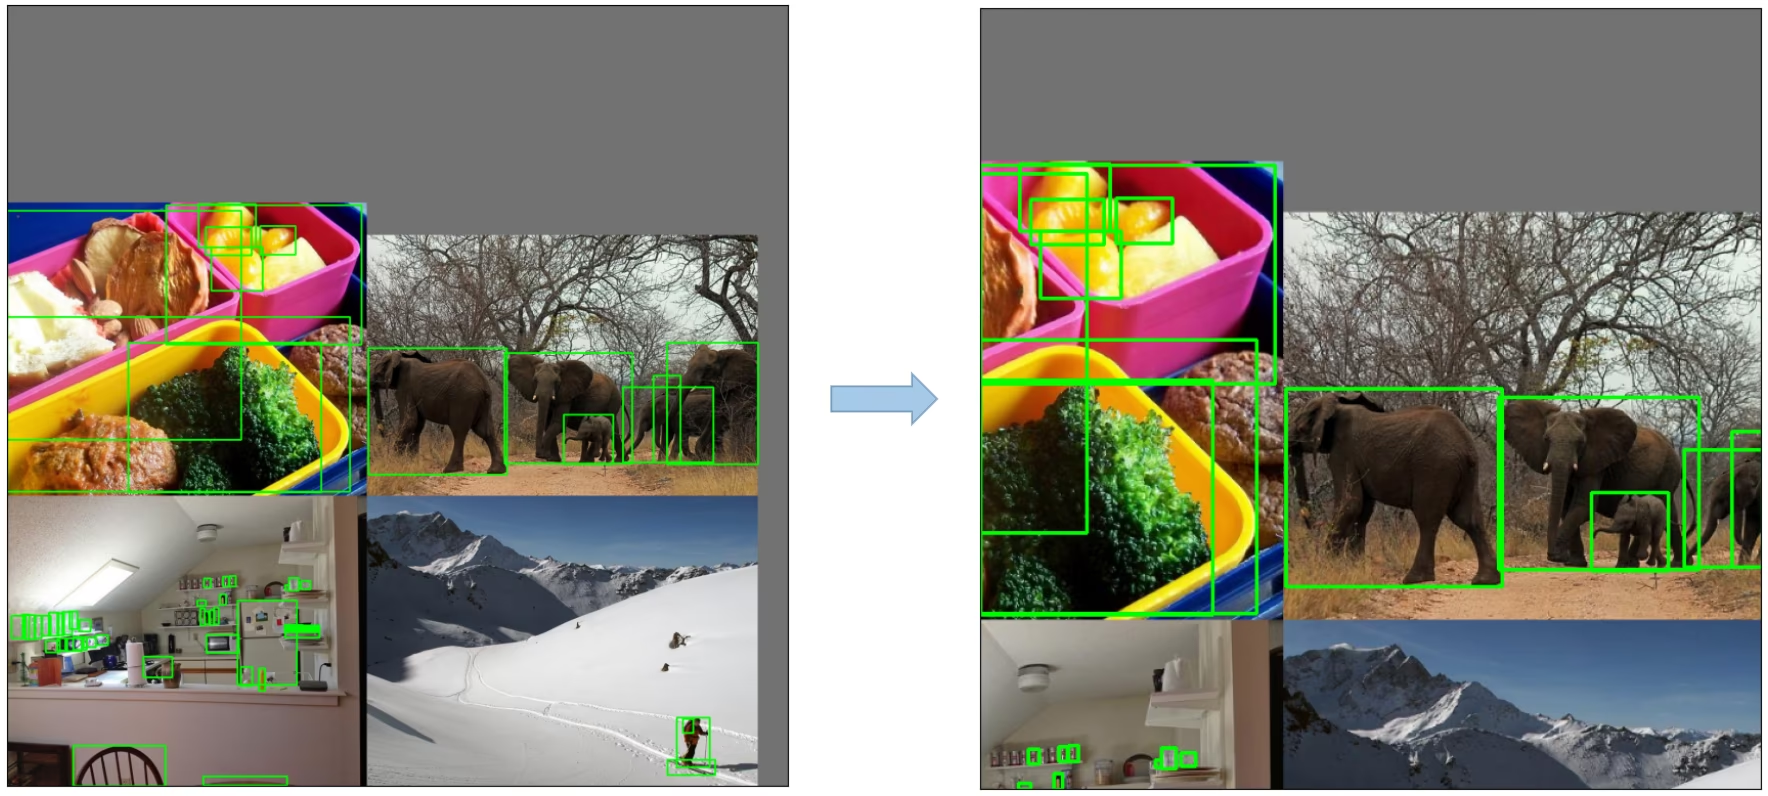
-
Trasformazioni affini casuali: includono rotazione, ridimensionamento, traslazione e taglio casuali delle immagini.
-
Aumento MixUp: un metodo che crea immagini composite combinando linearmente due immagini e le relative etichette.
-
Albumentations: una potente libreria per l’aumento delle immagini che supporta un’ampia varietà di tecniche di aumento. Scopri di più su come usare gli aumenti di Albumentations.
-
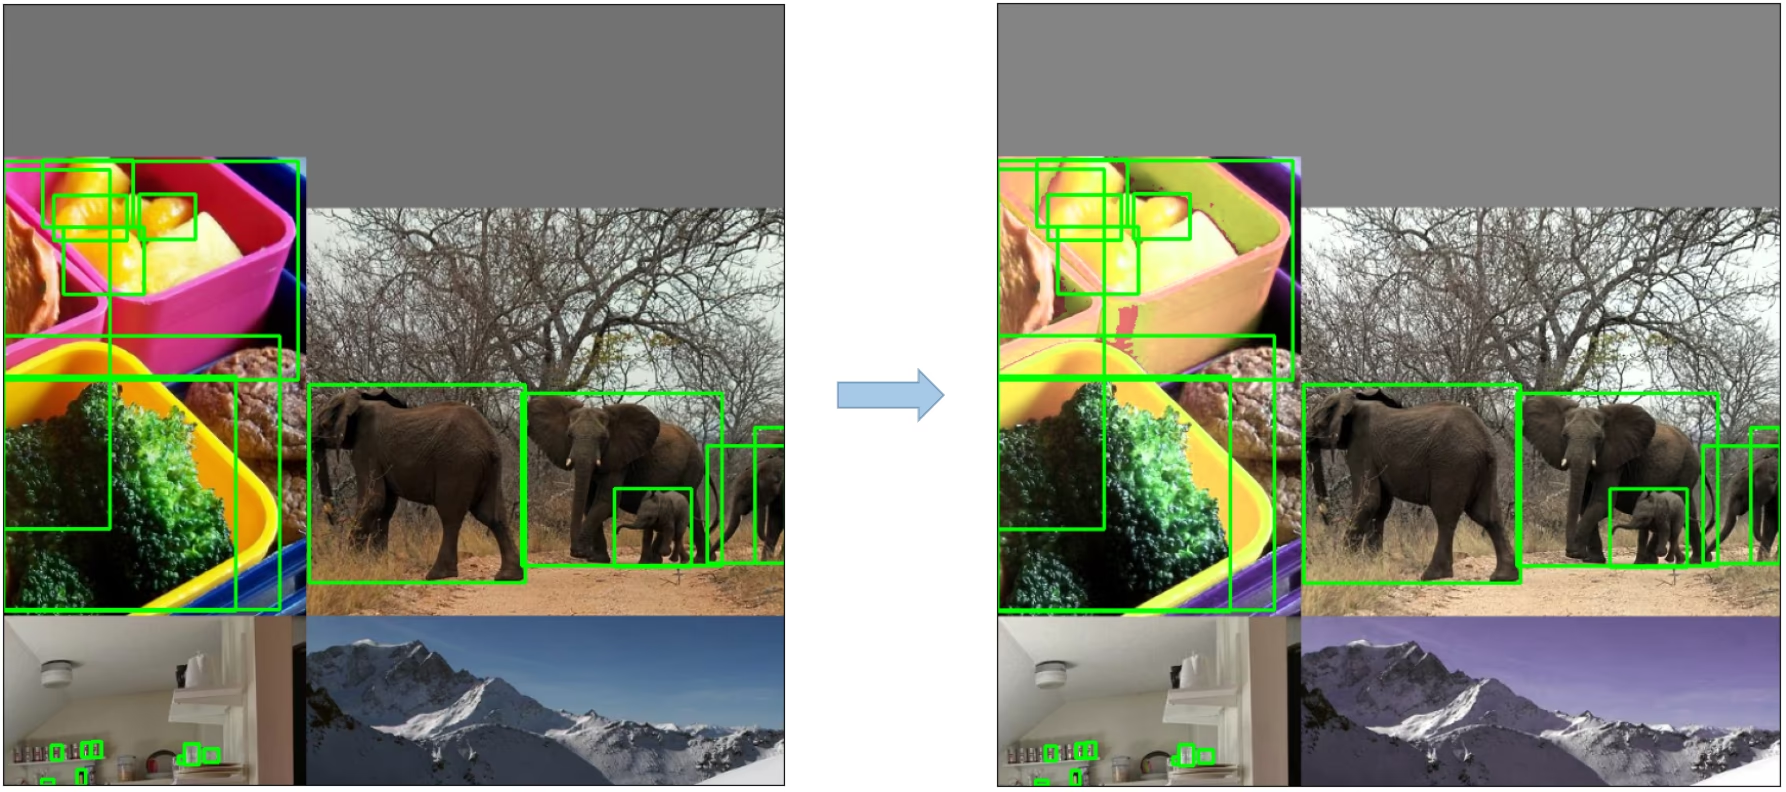
Aumento HSV: modifiche casuali a tonalità, saturazione e valore delle immagini.
-
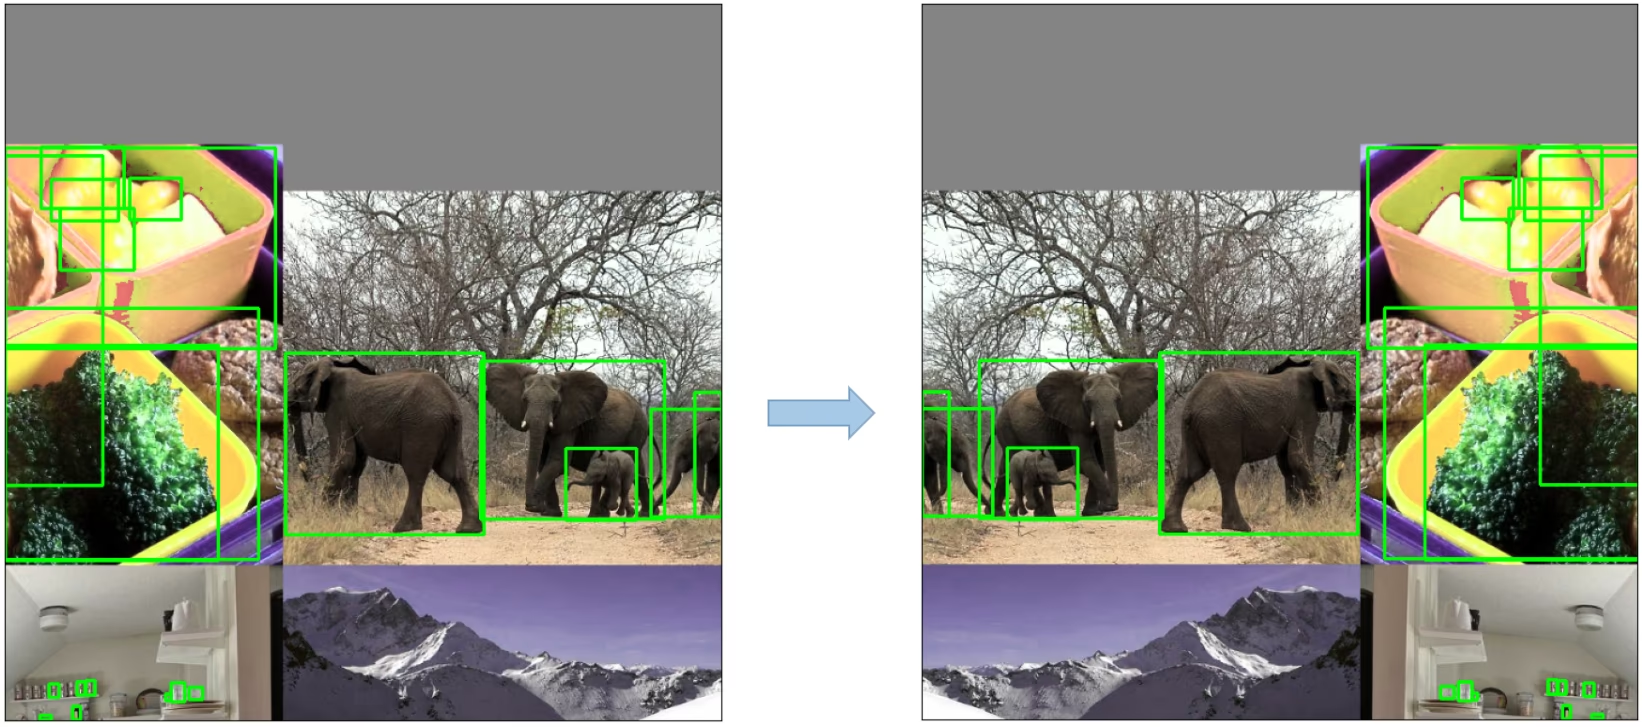
Riflessione orizzontale casuale: un metodo di aumento che capovolge casualmente le immagini in orizzontale.
3. Strategie di addestramento#
YOLOv5 applica diverse strategie di addestramento sofisticate per migliorare le prestazioni del modello. Tra queste:
- Addestramento multiscala: durante l’addestramento, le immagini di input vengono ridimensionate casualmente entro un intervallo compreso tra 0,5 e 1,5 volte la dimensione originale.
- AutoAnchor: questa strategia ottimizza le anchor box iniziali per adattarle alle caratteristiche statistiche delle box di ground truth nei tuoi dati personalizzati.
- Warmup e scheduler coseno del LR: un metodo per regolare il tasso di apprendimento e migliorare le prestazioni del modello.
- Media mobile esponenziale (EMA): una strategia che usa la media dei parametri delle iterazioni precedenti per stabilizzare il processo di addestramento e ridurre l'errore di generalizzazione.
- Addestramento a precisione mista: un metodo per eseguire operazioni in formato a mezza precisione, riducendo l'uso della memoria e aumentando la velocità di calcolo.
- Evoluzione degli iperparametri: una strategia per regolare automaticamente gli iperparametri e ottenere prestazioni ottimali. Consulta il tutorial sull'evoluzione degli iperparametri.
4. Funzionalità aggiuntive#
4.1 Calcolo delle loss#
In YOLOv5, la loss è calcolata combinando tre singole componenti:
- Loss delle classi (loss BCE): la loss di entropia incrociata binaria misura l'errore del task di classificazione.
- Loss di objectness (loss BCE): un'altra loss di entropia incrociata binaria, che calcola l'errore nel rilevare la presenza o meno di un oggetto in una determinata cella della griglia.
- Loss di localizzazione (loss CIoU): la loss di IoU completa misura l'errore nel localizzare l'oggetto all'interno della cella della griglia.
La funzione di loss complessiva è rappresentata da:
4.2 Bilanciamento delle loss#
Le loss di objectness dei tre livelli di predizione (P3, P4, P5) hanno pesi diversi. I rispettivi pesi di bilanciamento sono [4.0, 1.0, 0.4]. Questo approccio assicura che le predizioni a scale diverse contribuiscano in modo adeguato alla loss totale.
4.3 Eliminazione della sensibilità alla griglia#
Rispetto alle versioni precedenti di YOLO, l'architettura di YOLOv5 introduce importanti modifiche alla strategia di predizione delle box. In YOLOv2 e YOLOv3, le coordinate delle box venivano predette direttamente usando l'attivazione dell'ultimo livello.

In YOLOv5, tuttavia, la formula per predire le coordinate delle box è stata aggiornata per ridurre la sensibilità alla griglia e impedire al modello di predire dimensioni delle box illimitate.
Le formule aggiornate per calcolare il riquadro di delimitazione predetto sono le seguenti:
Confronta lo scostamento del punto centrale prima e dopo il ridimensionamento. L'intervallo dello scostamento del punto centrale viene modificato da (0, 1) a (-0.5, 1.5). Di conseguenza, lo scostamento può raggiungere facilmente 0 o 1.

Confronta il rapporto di ridimensionamento dell'altezza e della larghezza (rispetto all'anchor) prima e dopo la modifica. Le equazioni originali delle box di yolo/darknet presentano un grave difetto. Larghezza e altezza sono completamente illimitate, perché sono semplicemente out=exp(in): questo è pericoloso, poiché può causare gradienti incontrollati, instabilità, loss NaN e, infine, la completa interruzione dell'addestramento. Consulta questo issue per ulteriori dettagli.

4.4 Creazione dei target#
Il processo di creazione dei target in YOLOv5 è fondamentale per l'efficienza dell'addestramento e l'accuratezza del modello. Consiste nell'assegnare le box di ground truth alle celle appropriate della griglia nella mappa di output e nell'abbinarle alle anchor box appropriate.
Il processo segue questi passaggi:
- Calcola il rapporto tra le dimensioni della box di ground truth e quelle di ciascun template di anchor.

- Se il rapporto calcolato rientra nella soglia, abbina la box di ground truth all'anchor corrispondente.

- Assegna l'anchor abbinato alle celle appropriate. Tieni presente che, a causa della modifica dello scostamento del punto centrale, una box di ground truth può essere assegnata a più di un anchor: l'intervallo dello scostamento del punto centrale passa infatti da (0, 1) a (-0.5, 1.5), consentendo ulteriori corrispondenze.

In questo modo, il processo di creazione dei target assicura che ogni oggetto di ground truth venga assegnato e abbinato correttamente durante l'addestramento, permettendo a YOLOv5 di apprendere il task di rilevamento degli oggetti in modo più efficace.
Conclusione#
YOLOv5 rappresenta un passo importante nell'evoluzione del rilevamento di oggetti in tempo reale. Le sue scelte architetturali, le strategie di addestramento e i perfezionamenti ingegneristici offrono prestazioni ed efficienza elevate rispetto alle versioni precedenti di YOLO.
I principali miglioramenti di YOLOv5 includono l'uso di un'architettura dinamica, un'ampia gamma di tecniche di data augmentation, strategie di addestramento innovative, nonché importanti modifiche al calcolo delle loss e al processo di creazione dei target. Tutte queste innovazioni migliorano notevolmente l'accuratezza e l'efficienza del rilevamento degli oggetti, mantenendo al contempo un'elevata velocità, tratto distintivo dei modelli YOLO.
Domande frequenti#
Un backbone CSPDarknet53 estrae le feature, un neck SPPF e PANet le fonde a diverse scale e una head in stile YOLOv3 predice box, objectness e classi con stride 8, 16 e 32. L'elenco completo dei livelli è disponibile in
models/yolov5l.yaml.SPPF concatena tre operazioni di max pooling 5x5 anziché eseguire in parallelo pooling 5x5, 9x9 e 13x13. L'output è matematicamente identico, ma l'esecuzione è più di due volte più veloce, come mostra lo snippet di profilazione qui sopra.
L'offset originale di YOLO non poteva mai raggiungere esattamente 0 o 1, perciò era difficile predire gli oggetti centrati sui bordi della griglia. Ridimensionare la sigmoide all'intervallo (-0.5, 1.5) elimina questa sensibilità alla griglia, mentre elevare al quadrato
2σper larghezza e altezza limita le predizioni a 4x la dimensione dell'anchor, evitando i gradienti incontrollati causati dall'esponenziale illimitata.Corrisponde qualsiasi anchor i cui rapporti di larghezza e altezza rispetto alla box rientrino in
anchor_t(4.0 per impostazione predefinita); inoltre, l'intervallo di offset esteso consente di assegnare la box anche alle due celle della griglia adiacenti. Un singolo oggetto può quindi generare diversi target positivi, accelerando la convergenza.