Transfer learning con livelli congelati in YOLOv5#
📚 Questa guida spiega come congelare i livelli di YOLOv5 🚀 quando si implementa il transfer learning. Il transfer learning è una potente tecnica di apprendimento automatico (ML) che consente di riaddestrare rapidamente un modello su nuovi dati senza riaddestrare l’intera rete da zero. Congelando i pesi dei livelli iniziali e aggiornando solo i parametri dei livelli successivi, puoi ridurre significativamente le risorse di calcolo necessarie e i tempi di addestramento. Tuttavia, questo approccio potrebbe influire leggermente sull’accuratezza finale del modello.
Prima di iniziare#
Per prima cosa, clona il repository YOLOv5 e installa le dipendenze necessarie elencate in requirements.txt. Assicurati di avere un ambiente Python>=3.8.0 con PyTorch>=1.8 installato. I modelli preaddestrati e i dataset necessari verranno scaricati automaticamente dall’ultima release di YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
Come funziona il congelamento dei livelli#
Quando congeli i livelli di una rete neurale, impedisci che i relativi parametri (pesi e bias) vengano aggiornati durante l’addestramento. In PyTorch, questo si ottiene impostando l’attributo requires_grad dei tensori del livello su False. Di conseguenza, per questi livelli non vengono calcolati gradienti durante la retropropagazione, con un risparmio di calcolo e memoria.
Ecco come YOLOv5 implementa il congelamento dei livelli nel suo script di addestramento:
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
        v.requires_grad = False  # Disable gradient calculation for frozen layers
Esplorare l’architettura del modello#
Comprendere la struttura del modello YOLOv5 è fondamentale per decidere quali livelli congelare. Puoi esaminare i nomi di tutti i moduli e i relativi parametri usando il seguente frammento di codice Python:
# Supponendo che 'model' sia l'istanza del modello YOLOv5 caricata
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""
L’architettura YOLOv5 comprende in genere un backbone (livelli da 0 a 9 nelle configurazioni standard come YOLOv5s/m/l/x), responsabile dell’estrazione delle caratteristiche, e una head (i livelli restanti) che esegue il rilevamento degli oggetti.
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
    # ... subsequent head layers for feature fusion and detection
Opzioni di congelamento#
Puoi controllare quali livelli congelare usando l’argomento --freeze nel comando di addestramento. Questo argomento specifica l’indice del primo modulo non congelato; tutti i moduli precedenti a questo indice avranno i pesi congelati. In alternativa, passando diversi indici (ad esempio --freeze 0 1 2), congeli esattamente quei moduli. Usa model.model (un nn.Sequential) per esaminare l’ordine dei moduli, se devi verificare quali indici corrispondono a un determinato blocco.
Congelare solo il backbone#
Per congelare l’intero backbone (livelli da 0 a 9), una scelta comune quando si adatta il modello a nuove classi di oggetti mantenendo le capacità generali di estrazione delle caratteristiche apprese da un dataset di grandi dimensioni come COCO:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10Questa strategia è efficace quando il dataset di destinazione condivide caratteristiche visive di basso livello (bordi, texture) con i dati di addestramento originali (ad esempio, COCO), ma contiene categorie di oggetti diverse.
Congelare tutto tranne i livelli finali di rilevamento#
Per congelare quasi tutta la rete, lasciando addestrabili solo i livelli convoluzionali di output finali (parte del modulo Detect, in genere l’ultimo, ad esempio il modulo 24 in YOLOv5s):
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24Questo approccio è utile quando devi principalmente adattare il modello a un numero diverso di classi di output, mantenendo intatte la maggior parte delle caratteristiche apprese. Richiede meno risorse di calcolo per il fine-tuning.
Confronto delle prestazioni#
Per illustrare gli effetti del congelamento dei livelli, abbiamo addestrato YOLOv5m sul dataset Pascal VOC per 50 epoche, partendo dai pesi ufficiali di COCO preaddestrati (yolov5m.pt). Abbiamo confrontato tre scenari: addestramento di tutti i livelli (--freeze 0), congelamento del backbone (--freeze 10) e congelamento di tutti i livelli tranne quelli finali di rilevamento (--freeze 24).
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10
Risultati di accuratezza#
I risultati mostrano che congelare i livelli può accelerare notevolmente l’addestramento, ma può comportare una lieve riduzione della mAP (precisione media) finale. In genere, l’addestramento di tutti i livelli garantisce l’accuratezza migliore, mentre congelarne di più rende l’addestramento più rapido, a potenziale discapito delle prestazioni.
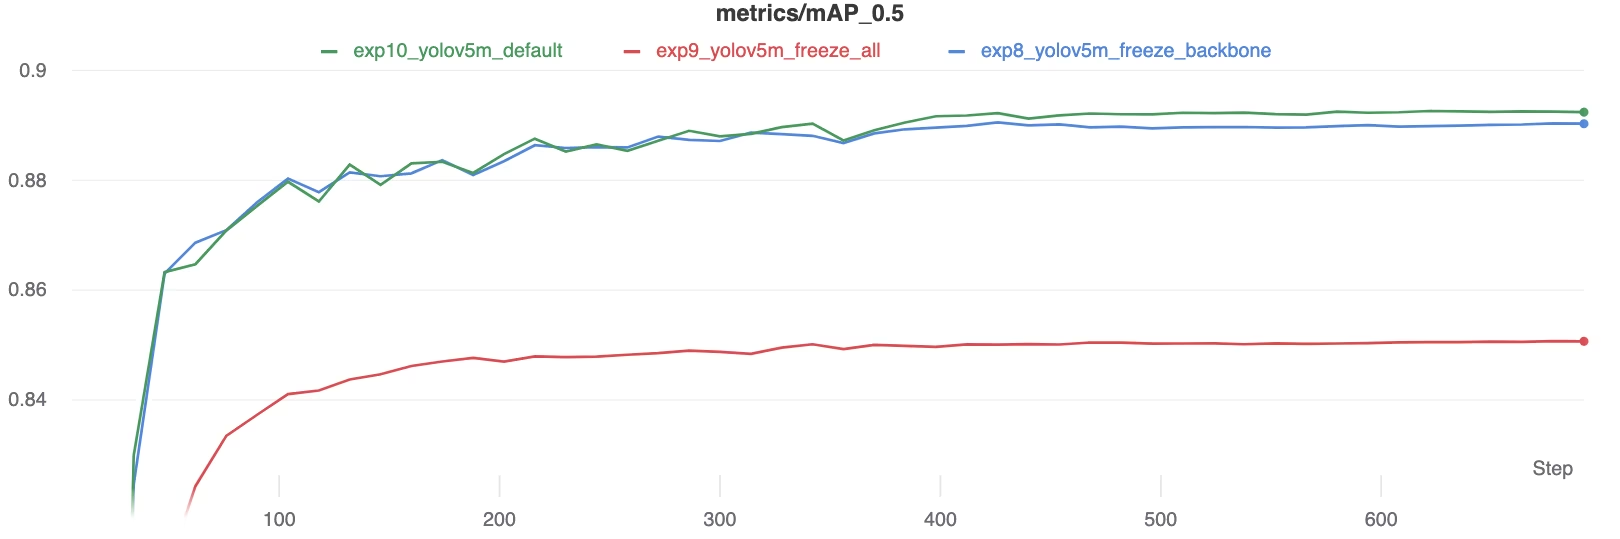 Confronto mAP50 durante l’addestramento
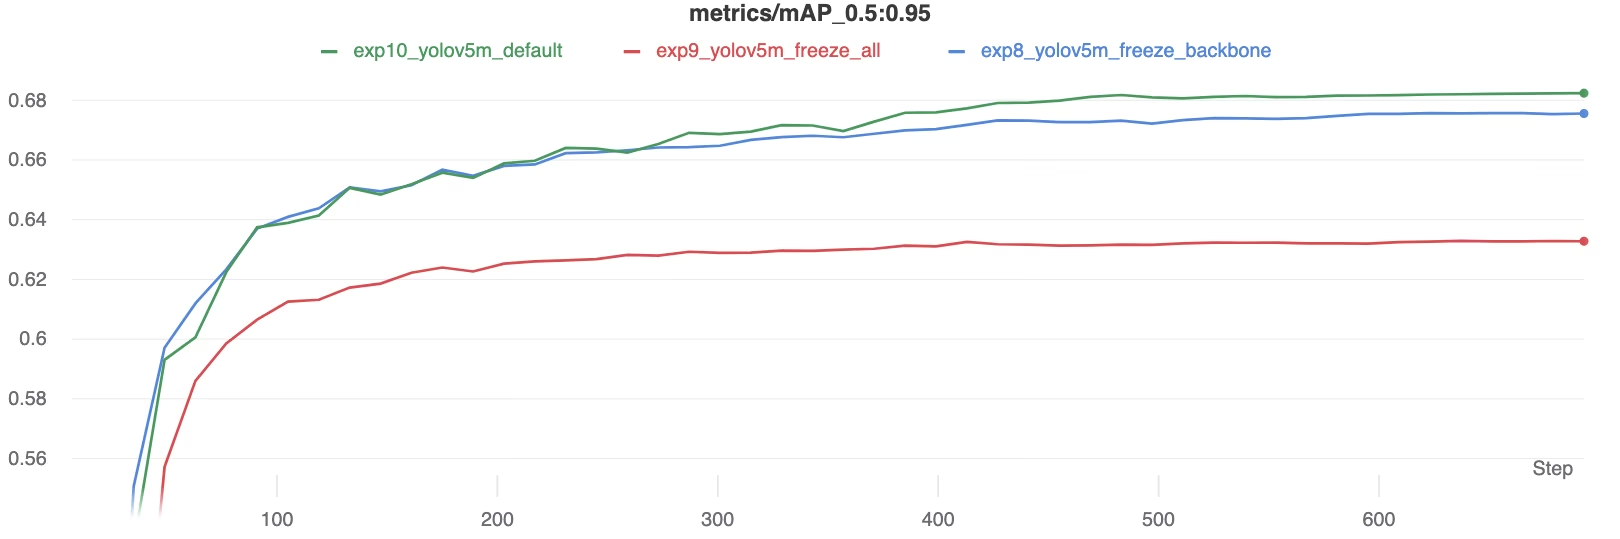 Confronto mAP50-95 durante l’addestramento
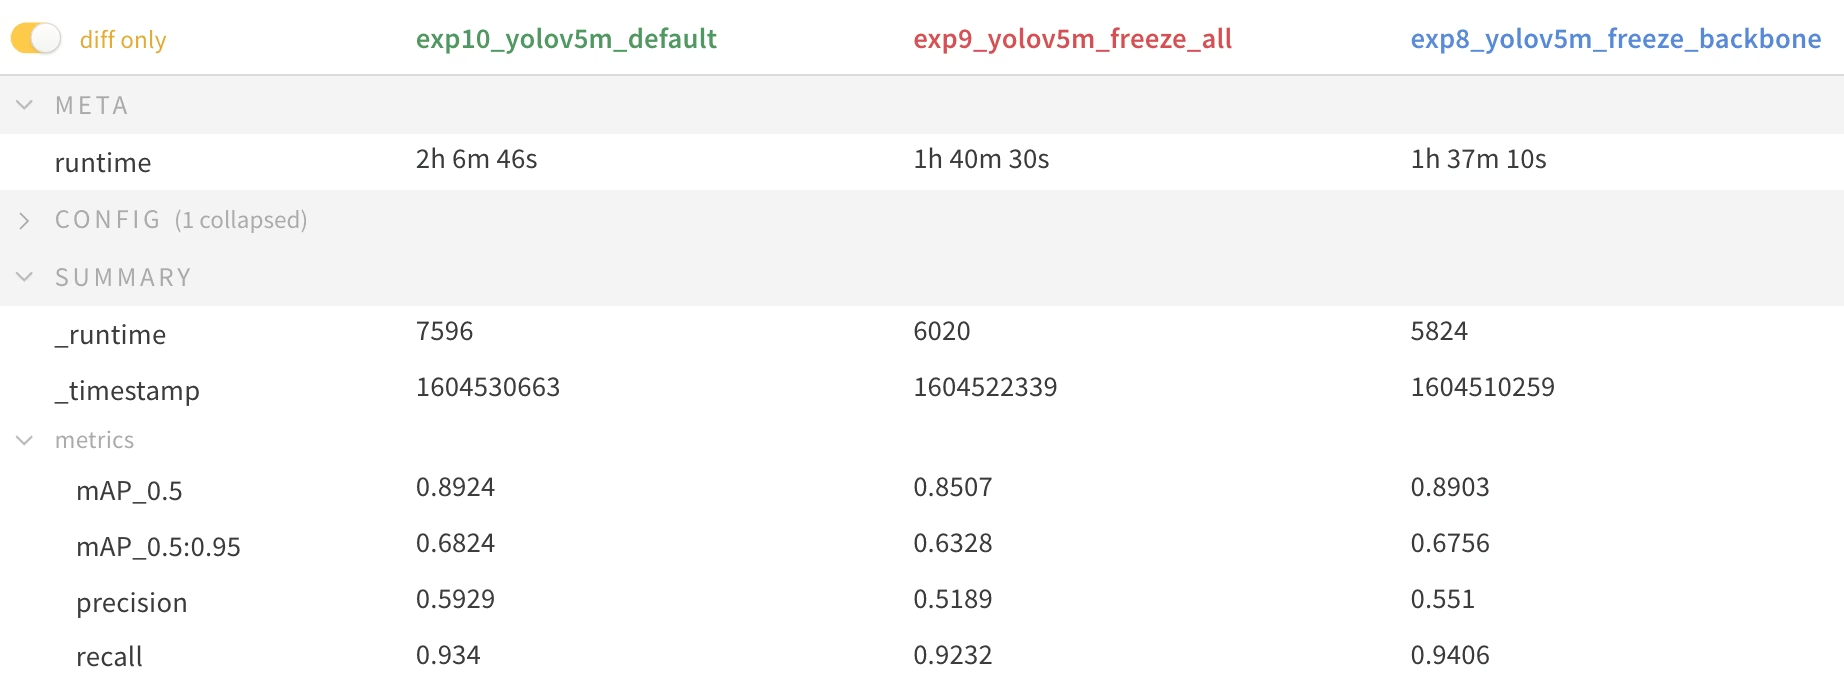 *Tabella riepilogativa delle metriche di prestazione*
Utilizzo delle risorse#
Congelare più livelli riduce notevolmente i requisiti di memoria della GPU e l’utilizzo complessivo. Questo rende il transfer learning con livelli congelati un’opzione interessante quando si lavora con risorse hardware limitate, poiché consente di addestrare modelli più grandi o di usare immagini di dimensioni maggiori rispetto a quanto sarebbe altrimenti possibile.
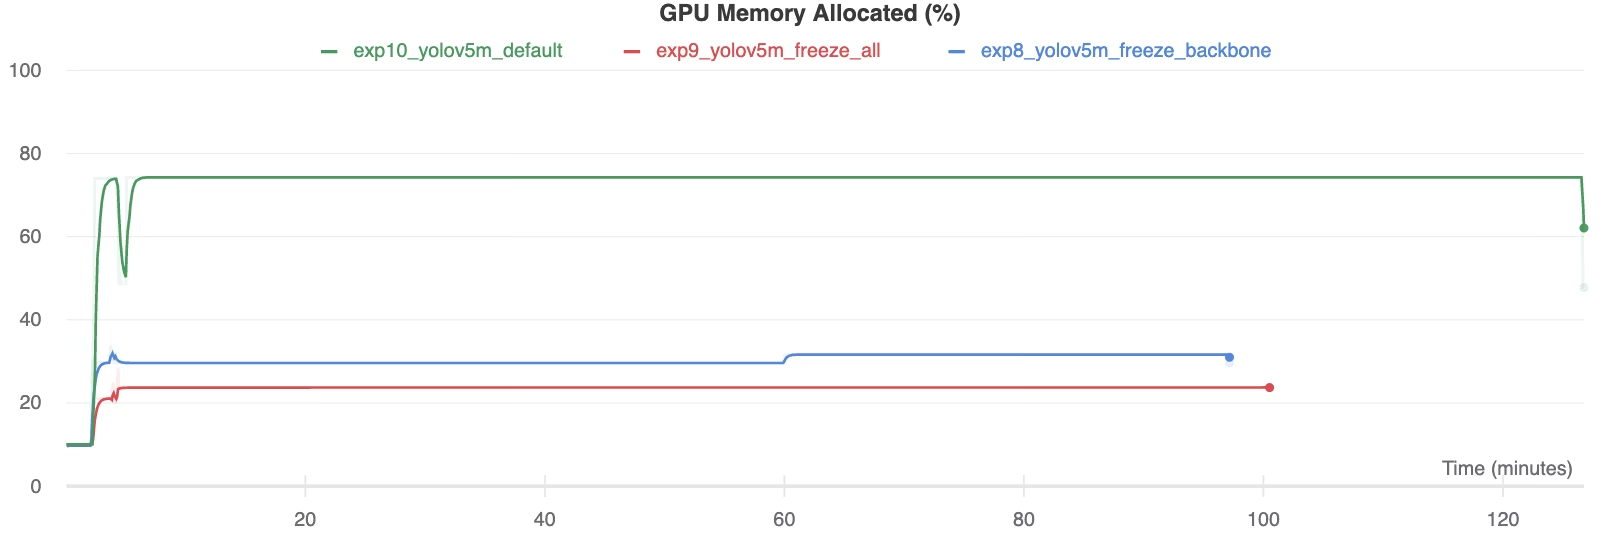 Memoria GPU allocata (%)
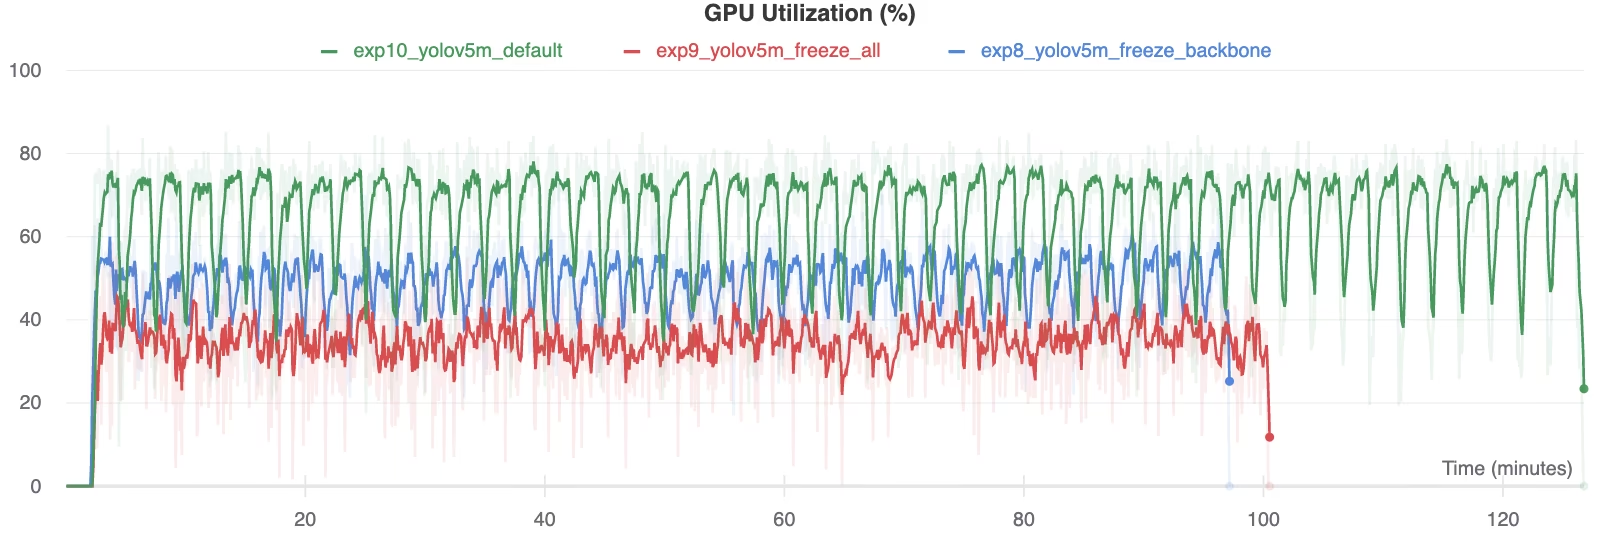 Utilizzo GPU (%)
Quando usare il congelamento dei livelli#
Il congelamento dei livelli durante il transfer learning è particolarmente vantaggioso in diverse situazioni:
- Risorse di calcolo limitate: se hai vincoli di memoria GPU o potenza di elaborazione.
- Dataset di piccole dimensioni: se il dataset di destinazione è molto più piccolo di quello originale usato per il preaddestramento, congelare i livelli aiuta a prevenire l’overfitting.
- Prototipazione rapida: quando devi adattare rapidamente un modello esistente a un nuovo compito o ambito per una valutazione iniziale.
- Ambiti con caratteristiche simili: se le caratteristiche di basso livello del nuovo dataset sono molto simili a quelle del dataset su cui il modello è stato preaddestrato.
Approfondisci le sfumature del transfer learning nella nostra voce del glossario e valuta l’evoluzione degli iperparametri per ottimizzare le prestazioni.
Ambienti supportati#
Ultralytics offre vari ambienti pronti all’uso con dipendenze essenziali come CUDA, CuDNN, Python e PyTorch già installate.
- Notebook GPU gratuiti:


- Google Cloud: Guida rapida a GCP
- Amazon: Guida rapida ad AWS
- Azure: Guida rapida ad AzureML
- Docker: Guida rapida a Docker

Stato del progetto#

Questo badge conferma che tutti i test di integrazione continua (CI) delle GitHub Actions di YOLOv5 vengono superati correttamente. Questi test CI valutano rigorosamente la funzionalità e le prestazioni di YOLOv5 nelle operazioni principali: addestramento, validazione, inferenza, esportazione e benchmark. Garantiscono un funzionamento coerente e affidabile su macOS, Windows e Ubuntu, e vengono eseguiti automaticamente ogni 24 ore e a ogni nuovo commit di codice.
Domande frequenti#
Congela i primi
Nmoduli dimodel.model, in modo che i relativi pesi restino fissi e non ricevano gradienti.--freeze 10congela il backbone, mentre--freeze 24congela tutto tranne il modulo finaleDetect.Nell’esperimento VOC descritto sopra, l’addestramento di tutti i livelli ha prodotto la mAP migliore; congelare il backbone ha comportato una lieve perdita di accuratezza, mentre congelare tutto tranne la head di rilevamento ha avuto l’impatto maggiore. In compenso, le esecuzioni con livelli congelati sono più rapide e usano molta meno memoria GPU.
Quando le immagini condividono caratteristiche di basso livello con i dati di preaddestramento, il dataset è piccolo o ti serve una baseline rapida su hardware limitato. Addestra tutti i livelli quando il dataset cresce o quando vuoi ottenere gli ultimi punti di mAP.
Sì. Avvia una nuova esecuzione a partire da
best.ptdel modello congelato, senza--freeze, per eseguire il fine-tuning dell’intera rete, in genere con un learning rate inferiore.