Integrazione con ClearML#

Informazioni su ClearML#
ClearML è una piattaforma MLOps open source progettata per semplificare i workflow di machine learning e risparmiare tempo di progettazione.
- 🔨 Monitora ogni esecuzione di addestramento YOLOv5 con il gestore degli esperimenti.
- 🔧 Gestisci le versioni e accedi ai tuoi dati di addestramento personalizzati con lo strumento di controllo delle versioni dei dati integrato di ClearML.
- 🔦 Addestra e monitora da remoto le esecuzioni di YOLOv5 usando ClearML Agent.
- 🔬 Trova il valore mAP migliore con l'ottimizzazione degli iperparametri di ClearML.
- 🔭 Trasforma il tuo modello YOLOv5 in un'API con pochi comandi usando ClearML Serving.
Usa questi strumenti in base alle tue esigenze: puoi iniziare solo con il gestore degli esperimenti oppure combinarli tutti in una pipeline completa.
🦾 Configurazione#
ClearML deve comunicare con un server per monitorare gli esperimenti e i dati. Hai due possibilità:
- Registrati al servizio ClearML Hosted gratuito, oppure
- Distribuisci il tuo server ClearML: è open source, quindi rimane un'opzione valida anche per i dati sensibili.
Quindi installa il pacchetto Python clearml e connetti l'SDK al tuo server:
pip install clearmlGenera le credenziali in Settings → Workspace → Create new credentials (in alto a destra nell'interfaccia utente di ClearML), quindi esegui:
clearml-initSegui le istruzioni. Fatto: la configurazione è completa.
🚀 Addestrare YOLOv5 con ClearML#
Per abilitare il monitoraggio degli esperimenti, installa il pacchetto pip ClearML, se non l'hai già fatto:
pip install clearmlIn questo modo abiliti l'integrazione con lo script di addestramento di YOLOv5. Da questo momento, ogni esecuzione di addestramento verrà acquisita e archiviata dal gestore degli esperimenti di ClearML.
Per personalizzare i nomi del progetto e dell'attività, passa --project e --name a train.py. I valori predefiniti sono YOLOv5 e Training. ClearML usa / come delimitatore dei sottoprogetti, quindi evita / nei nomi personalizzati dei progetti.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheOppure usa nomi personalizzati:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheOgni esecuzione acquisisce:
- Il codice sorgente e le modifiche non sottoposte a commit
- I pacchetti installati
- Gli iperparametri
- I checkpoint del modello (usa
--save-period nper salvare ogninepoche) - L'output della console
- Gli scalari (mAP_0.5, mAP_0.5:0.95, precisione, richiamo, perdite, tassi di apprendimento)
- I dettagli della macchina, il tempo di esecuzione e la data di creazione
- Grafici generati, come il correlogramma delle etichette e la matrice di confusione
- Immagini con riquadri di delimitazione per epoca
- Visualizzazioni dei mosaici per epoca
- Immagini di validazione per epoca
Tutto viene visualizzato nell'interfaccia utente di ClearML, così puoi monitorare l'addestramento da un unico posto. Aggiungi colonne personalizzate (ad esempio, mAP_0.5) per ordinare i modelli in base alle prestazioni, oppure seleziona più esperimenti per confrontarli fianco a fianco.
Continua a leggere per scoprire l'ottimizzazione degli iperparametri e l'esecuzione remota.
🔗 Gestione delle versioni dei dataset#
Gestire le versioni dei dati separatamente dal codice semplifica il recupero della versione più recente e garantisce la piena riproducibilità. Questo repository accetta l'ID di una versione del dataset, recupera automaticamente i dati se mancanti e registra l'ID come parametro dell'attività, così sai sempre quali dati sono stati usati in ogni esperimento.
Preparare il dataset#
Il repository YOLOv5 supporta molti dataset tramite file di configurazione YAML. Per impostazione predefinita, i dataset vengono scaricati nella cartella ../datasets, relativa alla radice del repository. Dopo aver scaricato coco128, la struttura delle cartelle è la seguente:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
Puoi usare qualsiasi dataset, purché mantenga questa struttura.
Poi, copia il file YAML del dataset nella cartella radice del dataset: ClearML legge questo file per usare correttamente il dataset. Puoi scrivere il tuo YAML seguendo la struttura dell'esempio e assicurandoti che definisca path, train, test, val, nc e names.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
Caricare il dataset#
Per registrare il dataset come dataset ClearML con versioni, spostati nella relativa cartella radice ed esegui:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync è una forma abbreviata della sequenza seguente, che puoi anche eseguire esplicitamente:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
Addestrare con un dataset ClearML#
Dopo aver registrato il dataset, indirizza l'addestramento a esso tramite l'ID:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 Ottimizzazione degli iperparametri#
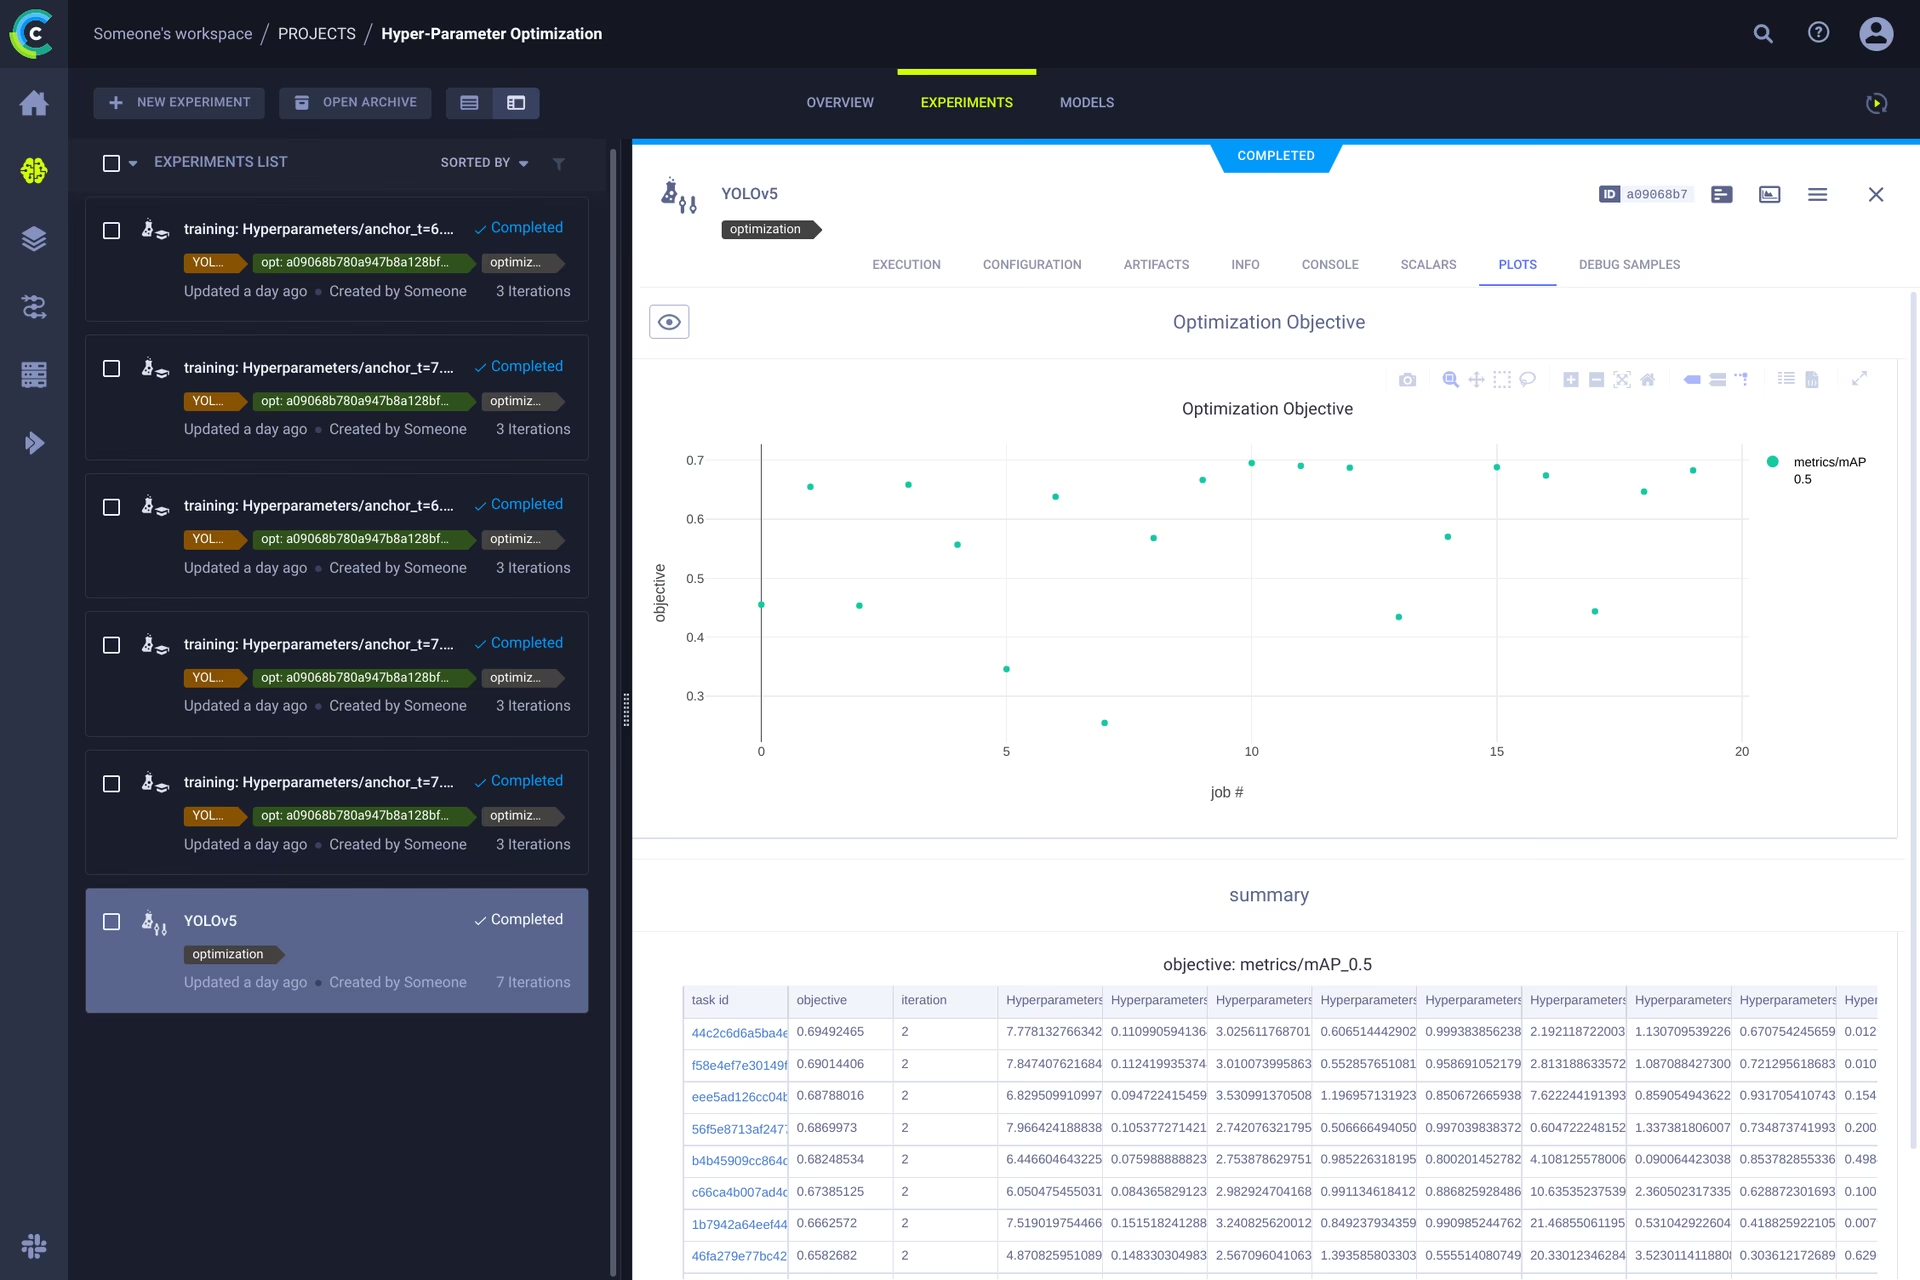
Dopo aver definito le versioni di esperimenti e dati, puoi basarti su di essi. Poiché ogni esperimento monitorato acquisisce l'intero ambiente — codice, pacchetti installati e configurazione — le esecuzioni sono completamente riproducibili. ClearML ti consente di clonare un esperimento, modificarne i parametri e rieseguirlo automaticamente: è la base dell'ottimizzazione degli iperparametri (HPO).
Per eseguire HPO in locale, usa lo script incluso. Prima assicurati che esista un'attività di addestramento nel gestore degli esperimenti: lo script la clona e modifica i relativi iperparametri.
Inserisci l'ID dell'attività modello in utils/loggers/clearml/hpo.py, quindi esegui:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
Per eseguire le prove su agenti remoti, sostituisci optimizer.start_locally() con optimizer.start() e imposta execution_queue nella chiamata HyperParameterOptimizer sulla coda a cui sono collegati gli agenti.
🤯 Esecuzione remota (avanzata)#
Eseguire HPO in locale è pratico, ma spesso vorrai eseguire gli esperimenti su hardware più potente, ad esempio una macchina GPU on-premise o un'istanza cloud. A questo serve ClearML Agent:
Ogni esperimento monitorato contiene tutto il necessario per riprodurlo su un'altra macchina (pacchetti installati, modifiche non sottoposte a commit e configurazione). Un agente ClearML ascolta una coda, acquisisce le attività in arrivo, ricrea l'ambiente, esegue il processo e invia scalari e grafici al gestore degli esperimenti.
Trasforma qualsiasi macchina — una VM cloud, una macchina locale con GPU o un laptop — in un agente ClearML con:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]Clonare, modificare e accodare#
Con un agente in esecuzione, puoi assegnargli attività direttamente dall'interfaccia utente:
- 🪄 Fai clic con il pulsante destro del mouse su un esperimento e clonalo.
- 🎯 Modifica i suoi iperparametri.
- ⏳ Fai clic con il pulsante destro del mouse sull'attività clonata e inseriscila nella coda di destinazione.
Eseguire un'attività da remoto#
Puoi anche contrassegnare a livello di codice uno script in esecuzione per l'esecuzione remota aggiungendo task.execute_remotely() dopo l'inizializzazione del logger ClearML. Aggiungi la riga evidenziata a train.py:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ AGGIUNGI QUESTA RIGA
    # ...
    # Elabora il collegamento all'artifact del dataset personalizzato
    data_dict = loggers.remote_dataset
# ...
Dopo questa modifica, lo script di addestramento viene eseguito fino a quella riga, impacchetta il codice e lo invia alla coda.
Worker con scalabilità automatica#
ClearML include autoscaler che avviano macchine remote in AWS, GCP o Azure quando una coda contiene esperimenti in attesa, le convertono in agenti ClearML e le arrestano al termine delle attività: paghi così solo le risorse di calcolo effettivamente in uso.
Guarda il video introduttivo qui sotto:
Scopri di più#
Per maggiori informazioni sull'integrazione di ClearML con i modelli Ultralytics, consulta la guida all'integrazione di ClearML e scopri come migliorare il tuo workflow MLOps con altri strumenti di monitoraggio degli esperimenti.
Domande frequenti#
No. Il servizio gratuito ospitato su app.clear.ml funziona subito dopo
clearml-init. L'hosting autonomo è facoltativo ed è la scelta abituale quando i dati non possono uscire dalla tua rete.YOLOv5 attiva l'integrazione ogni volta che il pacchetto
clearmlè importabile; per disattivare il monitoraggio durante un'esecuzione, disinstallalo conpip uninstall clearml.Registra il dataset con
clearml-data sync, poi passa il suo ID come argomento data:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. L'ID viene registrato nell'attività, così ogni esperimento sa esattamente quali dati ha utilizzato.Sì. Avvia un
clearml-agent daemonsu ogni macchina, quindi accoda esperimenti clonati dall'interfaccia utente oppure modificautils/loggers/clearml/hpo.pyin modo che chiamioptimizer.start()conexecution_queueimpostato, così l'ottimizzatore invia le prove alla coda.