Ensemble di modelli YOLOv5
Questa guida spiega come usare l'ensemble di modelli Ultralytics YOLOv5 durante i test e l'inferenza per migliorare la mAP e il recall.
Dall'apprendimento d'insieme:
La modellazione d'insieme è un processo in cui vengono creati più modelli eterogenei per prevedere un risultato, utilizzando diversi algoritmi di modellazione oppure diversi insiemi di dati di addestramento. Il modello d'insieme aggrega quindi le previsioni di ciascun modello di base e produce un'unica previsione finale per i dati mai visti. L'obiettivo dell'uso di modelli d'insieme è ridurre l'errore di generalizzazione delle previsioni. A condizione che i modelli di base siano eterogenei e indipendenti, l'errore di previsione del modello diminuisce quando si utilizza l'approccio d'insieme. Questo approccio sfrutta la saggezza della folla per formulare una previsione. Anche se il modello d'insieme comprende più modelli di base, agisce e opera come un unico modello.
Prima di iniziare#
Clona il repository e installa requirements.txt in un ambiente Python>=3.8.0, includendo PyTorch>=1.8. Modelli e dataset vengono scaricati automaticamente dall'ultima release di YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Test normale#
Prima di creare un ensemble, definisci le prestazioni di riferimento di un singolo modello. Questo comando testa YOLOv5x su COCO val2017 con immagini da 640 pixel. yolov5x.pt è il modello P5 più grande e accurato. Tra le altre opzioni ci sono i checkpoint pretrained più piccoli yolov5n.pt, yolov5s.pt, yolov5m.pt e yolov5l.pt, oppure un tuo checkpoint ottenuto addestrando il modello su un dataset personalizzato, ad esempio runs/train/exp/weights/best.pt.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfOutput:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Test dell'ensemble#
Puoi combinare più modelli pretrained in un ensemble durante i test e l'inferenza aggiungendo altri modelli all'argomento --weights in qualsiasi comando val.py o detect.py esistente. Questo esempio testa insieme un ensemble di 2 modelli:
- YOLOv5x
- YOLOv5l6
python val.py --weights yolov5x.pt yolov5l6.pt --data coco.yaml --img 640 --halfPuoi elencare tutti i checkpoint che vuoi, inclusi pesi personalizzati come runs/train/exp5/weights/best.pt. YOLOv5 eseguirà automaticamente ciascun modello e concatenerà le rispettive predizioni per ogni immagine prima di applicare NMS.
Output:
val: data=./data/coco.yaml, weights=['yolov5x.pt', 'yolov5l6.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients  # Model 1
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients  # Model 2
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']  # Ensemble notice

val: Scanning '../datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:00<00:00, 49695545.02it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [03:58<00:00,  1.52s/it]
                 all       5000      36335      0.747      0.637      0.692      0.502
Speed: 0.1ms pre-process, 39.5ms inference, 2.0ms NMS per image at shape (32, 3, 640, 640)  # <--- ensemble speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.515  # <--- ensemble mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.699
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.557
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.356
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.563
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.668
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.387
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.638
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.689  # <--- ensemble mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.743
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.844
Inferenza con ensemble#
Aggiungi altri modelli all'argomento --weights per eseguire l'inferenza con un ensemble:
python detect.py --weights yolov5x.pt yolov5l6.pt --img 640 --source data/imagesOutput:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']

image 1/2 /content/yolov5/data/images/bus.jpg: 640x512 4 persons, 1 bus, 1 tie, Done. (0.063s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 384x640 3 persons, 2 ties, Done. (0.056s)
Results saved to runs/detect/exp2
Done. (0.223s)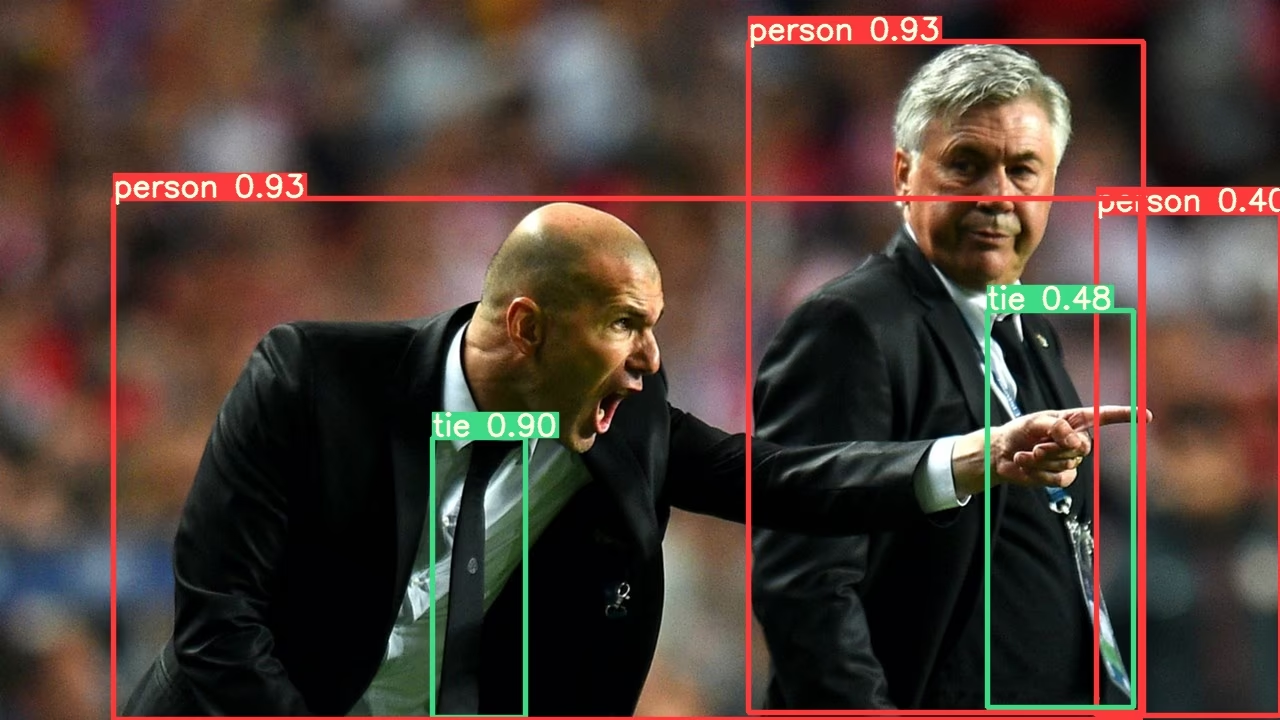
Vantaggi degli ensemble di modelli#
Gli ensemble di modelli con YOLOv5 offrono diversi vantaggi:
- Maggiore accuratezza: come mostrano gli esempi precedenti, combinare più modelli aumenta mAP da 0.504 a 0.515 e mAR da 0.681 a 0.689.
- Migliore generalizzazione: combinare modelli diversi aiuta a ridurre l'overfitting e migliora le prestazioni su dati eterogenei.
- Maggiore robustezza: in genere, gli ensemble sono più robusti al rumore e ai valori anomali nei dati.
- Punti di forza complementari: modelli diversi possono eccellere nel rilevamento di tipi diversi di oggetti o in condizioni ambientali differenti.
Il principale compromesso è l'aumento del tempo di inferenza, come mostrano le metriche di velocità (22.4 ms per il singolo modello contro 39.5 ms per l'ensemble).
Quando usare un ensemble di modelli#
Valuta l'uso di un ensemble di modelli nei seguenti casi:
- Quando l'accuratezza è più importante della velocità di inferenza
- Per applicazioni critiche in cui è necessario ridurre al minimo i falsi negativi
- Quando elabori immagini complesse con illuminazione variabile, occlusioni o scale diverse
- Durante competizioni o benchmark in cui sono necessarie le massime prestazioni
Per applicazioni in tempo reale con requisiti di latenza rigorosi, può essere più adatta l'inferenza con un singolo modello.
Ambienti supportati#
Ultralytics offre una gamma di ambienti pronti all'uso, ciascuno con dipendenze essenziali preinstallate, come CUDA, cuDNN, Python e PyTorch, per dare slancio ai tuoi progetti.
- Notebook GPU gratuiti:


- Google Cloud: Guida rapida a GCP
- Amazon: Guida rapida ad AWS
- Azure: Guida rapida ad AzureML
- Docker: Guida rapida a Docker

Stato del progetto#

Questo badge indica che tutti i test di integrazione continua (CI) di YOLOv5 GitHub Actions sono superati correttamente. Questi test CI verificano rigorosamente la funzionalità e le prestazioni di YOLOv5 in diversi ambiti chiave: addestramento, validazione, inferenza, esportazione e benchmark. Garantiscono un funzionamento coerente e affidabile su macOS, Windows e Ubuntu, con test eseguiti ogni 24 ore e a ogni nuovo commit.
Domande frequenti#
Un numero qualsiasi. Elenca ogni checkpoint dopo
--weights, ad esempio--weights yolov5x.pt yolov5l6.pt runs/train/exp/weights/best.pt. Il tempo di inferenza aumenta all'incirca in proporzione al numero di modelli.Sì. Le previsioni vengono concatenate prima di NMS, quindi ogni modello deve essere addestrato sullo stesso elenco di classi, nello stesso ordine. Le dimensioni di input e le architetture possono essere diverse.
Sì. Aggiungi
--augmentallo stesso comandoval.pyodetect.pyper applicare la TTA a ogni modello dell'ensemble.La gestione degli ensemble è affidata al modulo
Ensembledi PyTorch inmodels/experimental.py, quindi si applica solo ai checkpoint.pt. Esporta ogni modello separatamente se ti servono file ONNX o TensorRT.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.