Potatura dei modelli e sparsità in YOLOv5#
Questa guida spiega come applicare il pruning ai modelli YOLOv5 per creare reti più efficienti mantenendo le prestazioni.
Che cos'è la potatura dei modelli?#
Il pruning dei modelli è una tecnica che riduce le dimensioni e la complessità delle reti neurali eliminando i parametri meno importanti (pesi e connessioni). Questo processo crea un modello più efficiente, con diversi vantaggi:
- Dimensioni del modello ridotte per semplificare la distribuzione su dispositivi con risorse limitate
- Inferenza più rapida con un impatto minimo sull'accuratezza
- Minore utilizzo di memoria e consumo energetico
- Maggiore efficienza complessiva per le applicazioni in tempo reale
Il pruning individua ed elimina i parametri che contribuiscono in misura minima alle prestazioni del modello, ottenendo un modello più leggero con un'accuratezza simile.
Prima di iniziare#
Clona il repository e installa requirements.txt in un ambiente Python>=3.8.0, includendo PyTorch>=1.8. Modelli e dataset vengono scaricati automaticamente dall'ultima release di YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Test delle prestazioni di riferimento#
Prima del pruning, definisci le prestazioni di riferimento con cui confrontare i risultati. Questo comando testa YOLOv5x su COCO val2017 con immagini da 640 pixel. yolov5x.pt è il modello P5 più grande e accurato. Tra le altre opzioni ci sono i checkpoint pretrained più piccoli yolov5n.pt, yolov5s.pt, yolov5m.pt e yolov5l.pt, oppure un tuo checkpoint ottenuto addestrando il modello su un dataset personalizzato, ad esempio runs/train/exp/weights/best.pt.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfOutput:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
Applicare la potatura a YOLOv5x (sparsità del 30%)#
Possiamo applicare la potatura al modello usando la funzione prune() definita in utils/torch_utils.py. Per testare un modello potato, aggiorniamo val.py per portare la sparsità di YOLOv5x a 0.3 (il 30% dei pesi viene azzerato):
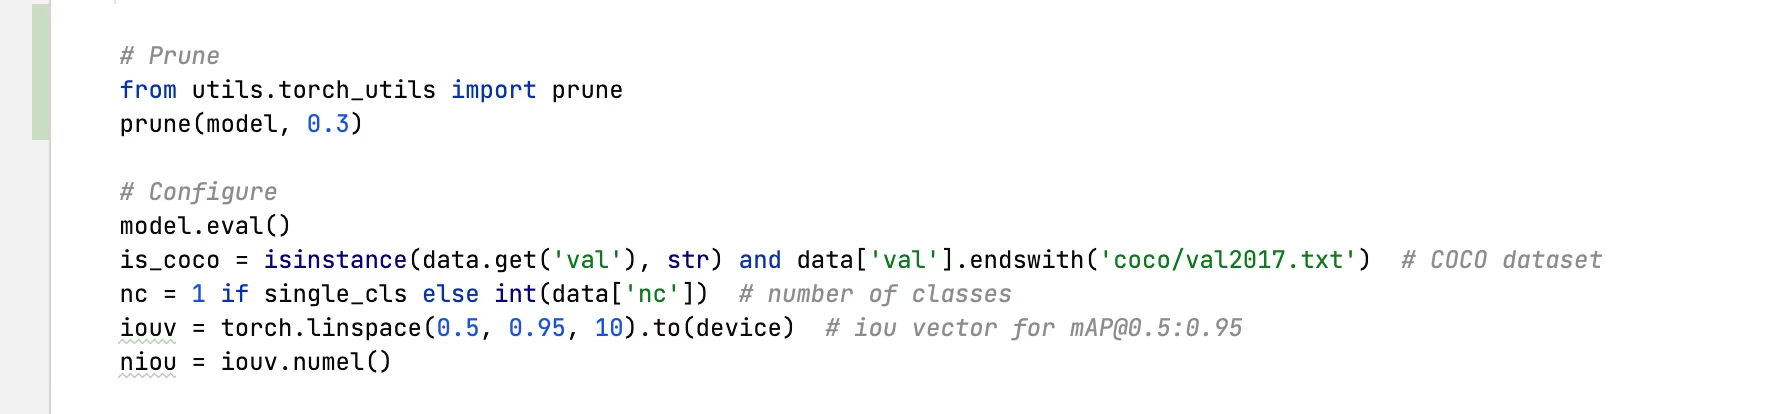
Output dopo la potatura del 30%:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
Analisi dei risultati#
Dai risultati possiamo osservare che:
- Sparsità del 30% raggiunta: il 30% dei parametri dei pesi del modello nei layer
nn.Conv2dè ora pari a zero - Il tempo di inferenza resta invariato: nonostante la potatura, la velocità di elaborazione è sostanzialmente la stessa
- Impatto minimo sulle prestazioni: mAP è sceso leggermente da 0.507 a 0.489 (una riduzione di appena il 3.6%)
- Le dimensioni del modello restano invariate: i pesi azzerati vengono comunque memorizzati in forma densa, quindi le dimensioni del file si riducono solo con formati o compressione che supportano la sparsità
Questo dimostra che è possibile rimuovere il 30% dei pesi convoluzionali con un impatto minimo sull'accuratezza. Per trasformare questa sparsità in inferenza più veloce o file più piccoli servono un runtime che tenga conto della sparsità, il pruning strutturato o la compressione.
Fine-tuning dei modelli potati#
Per ottenere i risultati migliori, dopo la potatura è consigliabile eseguire il fine-tuning dei modelli per recuperare accuratezza. Puoi farlo nel modo seguente:
- Applicare la potatura con il livello di sparsità desiderato
- Addestrare il modello sottoposto a pruning per alcune epoche con un learning rate più basso
- Valutare il modello potato sottoposto a fine-tuning confrontandolo con il modello di riferimento
Questo processo aiuta i parametri rimanenti ad adattarsi per compensare le connessioni rimosse, recuperando spesso la maggior parte o tutta l'accuratezza originale.
Ambienti supportati#
Ultralytics offre una gamma di ambienti pronti all'uso, ciascuno con dipendenze essenziali preinstallate, come CUDA, cuDNN, Python e PyTorch, per dare slancio ai tuoi progetti.
- Notebook GPU gratuiti:


- Google Cloud: Guida rapida a GCP
- Amazon: Guida rapida ad AWS
- Azure: Guida rapida ad AzureML
- Docker: Guida rapida a Docker

Stato del progetto#

Questo badge indica che tutti i test di integrazione continua (CI) di YOLOv5 GitHub Actions sono superati correttamente. Questi test CI verificano rigorosamente la funzionalità e le prestazioni di YOLOv5 in diversi ambiti chiave: addestramento, validazione, inferenza, esportazione e benchmark. Garantiscono un funzionamento coerente e affidabile su macOS, Windows e Ubuntu, con test eseguiti ogni 24 ore e a ogni nuovo commit.
Domande frequenti#
La potatura non strutturata azzera i pesi ma lascia invariate le forme dei tensori, quindi i kernel densi di PyTorch eseguono la stessa quantità di calcoli. Per ottenere accelerazioni servono un runtime che supporti la sparsità, come DeepSparse, oppure una potatura strutturata che rimuova interi canali.
Chiama la funzione helper da
utils/torch_utils.pyprima della convalida o dell'esportazione:from utils.torch_utils import prune prune(model, amount=0.3) # Sparsità globale del 30% sui pesi nn.Conv2dInizia da 0.3 e misura mAP. Senza fine-tuning, YOLOv5x ha perso circa il 3.6% di mAP con una sparsità del 30%; livelli di sparsità più elevati richiedono solitamente alcune epoche di nuovo addestramento con un learning rate basso per recuperare accuratezza.
Sì. I pesi azzerati vengono salvati come tutti gli altri, quindi
export.pyfunziona senza modifiche. Le dimensioni del file si riducono solo se il formato di destinazione o il runtime comprime i tensori sparsi.
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.