Addestramento di YOLOv5 con più GPU
Questa guida spiega il training distribuito di YOLOv5 con più GPU su un singolo computer o su più computer.
Prima di iniziare#
Clona il repository e installa requirements.txt in un ambiente Python>=3.8.0, includendo PyTorch>=1.8. Modelli e dataset vengono scaricati automaticamente dall'ultima release di YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # installL'immagine Docker di Ultralytics è consigliata per tutti gli addestramenti multi-GPU. Consulta la Guida rapida a Docker.

torch.distributed.run sostituisce torch.distributed.launch in PyTorch >= 1.9. Consulta la documentazione di PyTorch sulla distribuzione per maggiori dettagli.
Addestramento#
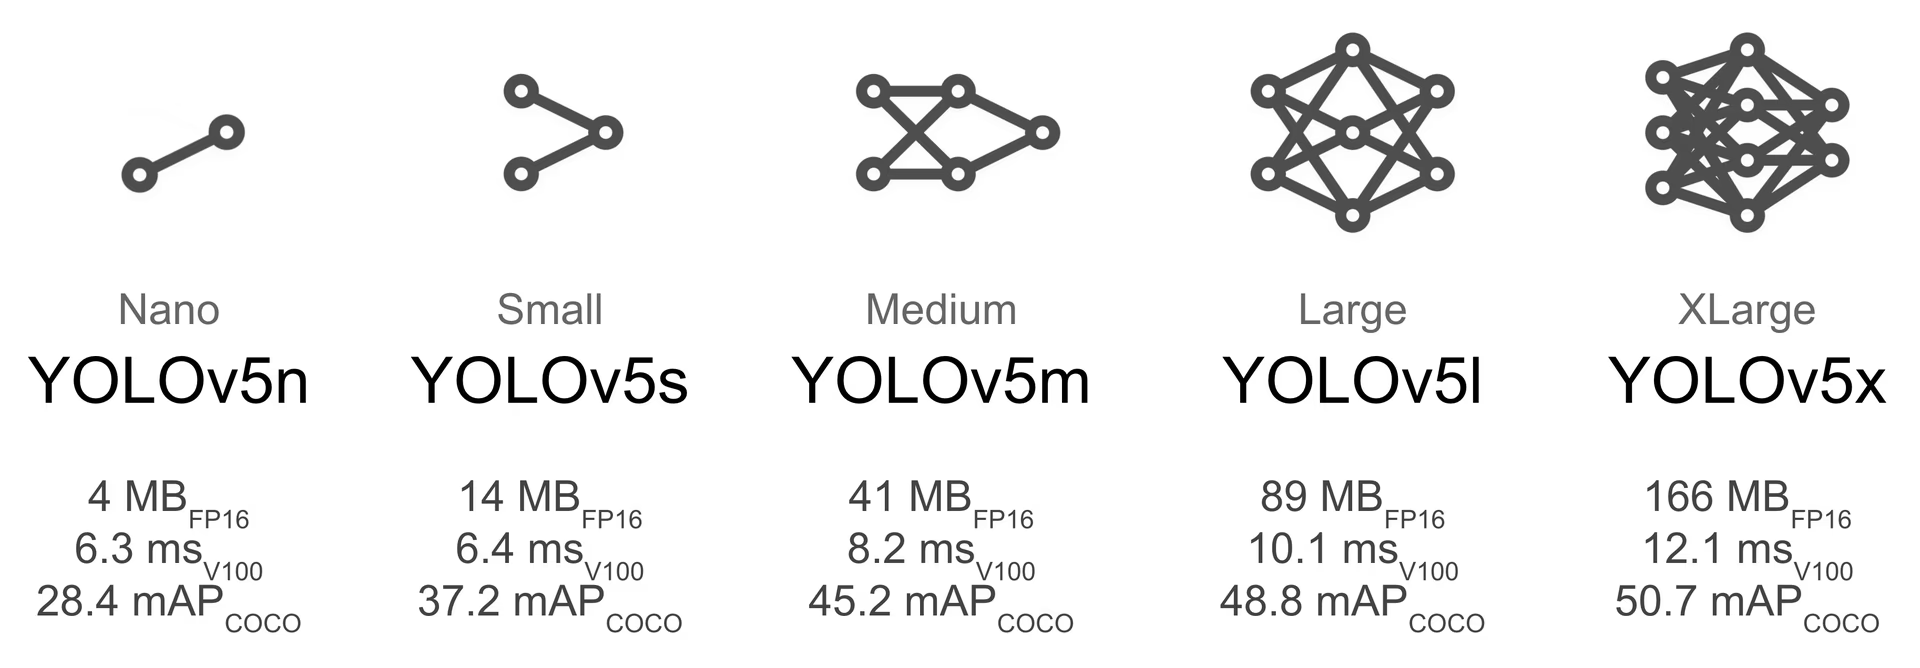
Seleziona un modello pretrained da cui avviare il training. Qui scegliamo YOLOv5s, un modello piccolo e veloce. Alleneremo questo modello con più GPU sul dataset COCO.
Una sola GPU#
python train.py --batch 64 --data coco.yaml --weights yolov5s.pt --device 0Modalità Multi-GPU DataParallel (⚠️ non consigliata)#
Passa più ID di GPU a --device per abilitare la modalità DataParallel:
python train.py --batch 64 --data coco.yaml --weights yolov5s.pt --device 0,1DataParallel è lento e accelera appena l'addestramento rispetto all'uso di una sola GPU.
Modalità Multi-GPU DistributedDataParallel (✅ consigliata)#
Aggiungi python -m torch.distributed.run --nproc_per_node all'inizio del comando di addestramento, quindi passa i soliti argomenti:
python -m torch.distributed.run --nproc_per_node 2 train.py --batch 64 --data coco.yaml --weights yolov5s.pt --device 0,1--nproc_per_nodeè il numero di GPU da usare. Nell'esempio precedente, è2.--batchè la dimensione totale del batch, suddivisa equamente tra le GPU. Nell'esempio precedente, corrisponde a64 / 2 = 32per GPU.
Il comando precedente usa le GPU 0...(N-1). Per controllare quali dispositivi sono visibili tramite variabili d'ambiente, imposta CUDA_VISIBLE_DEVICES=2,3 (o un altro elenco) prima dell'avvio.
Usa GPU specifiche (fai clic per espandere)
Passa --device seguito dagli ID delle GPU specifiche. L'esempio seguente usa le GPU 2,3.
python -m torch.distributed.run --nproc_per_node 2 train.py --batch 64 --data coco.yaml --cfg yolov5s.yaml --weights '' --device 2,3Usa SyncBatchNorm (fai clic per espandere)
SyncBatchNorm può aumentare l'accuratezza dell'addestramento multi-GPU, ma lo rallenta notevolmente. È disponibile solo per l'addestramento multi-GPU con DistributedDataParallel.
È preferibile usarlo quando la dimensione del batch su ogni GPU è ridotta (<= 8).
Per attivare SyncBatchNorm, passa --sync-bn:
python -m torch.distributed.run --nproc_per_node 2 train.py --batch 64 --data coco.yaml --cfg yolov5s.yaml --weights '' --sync-bnUsa più macchine (fai clic per espandere)
È disponibile solo per l'addestramento multi-GPU con DistributedDataParallel.
Prima di proseguire, assicurati che dataset, base di codice e tutte le altre dipendenze siano identici su tutte le macchine, quindi verifica che le macchine possano comunicare tra loro in rete.
Scegli una macchina master (a cui si collegheranno le altre), annota il suo indirizzo (master_addr) e scegli una porta (master_port). L'esempio seguente usa master_addr = 192.168.1.1 e master_port = 1234.
Poi esegui:
# On master machine 0
python -m torch.distributed.run --nproc_per_node G --nnodes N --node_rank 0 --master_addr "192.168.1.1" --master_port 1234 train.py --batch 64 --data coco.yaml --cfg yolov5s.yaml --weights ''
# On machine R
python -m torch.distributed.run --nproc_per_node G --nnodes N --node_rank R --master_addr "192.168.1.1" --master_port 1234 train.py --batch 64 --data coco.yaml --cfg yolov5s.yaml --weights ''dove G è il numero di GPU per macchina, N è il numero di macchine e R è il rango della macchina in 0...(N-1). Ad esempio, con due macchine e due GPU ciascuna, imposta G = 2, N = 2 e R = 1 sulla seconda macchina.
L'addestramento non inizia finché non sono connesse tutte le macchine N. L'output viene mostrato solo sulla macchina master.
Note#
-
Il supporto per Windows non è stato testato; si consiglia Linux.
-
--batchdeve essere un multiplo del numero di GPU. -
La GPU 0 usa leggermente più memoria delle altre perché mantiene l'EMA e gestisce i checkpoint.
-
Se ricevi
RuntimeError: Address already in use, di solito significa che più esecuzioni di addestramento stanno usando la stessa porta. Specifica una porta diversa con--master_port:python -m torch.distributed.run --master_port 1234 --nproc_per_node 2 ...
Risultati#
Risultati della profilazione DDP su un'istanza AWS EC2 P4d con 8x A100 SXM4-40GB per YOLOv5l per 1 epoca COCO.
Profilazione del codice
# prepare
t=ultralytics/yolov5:latest && sudo docker pull $t && sudo docker run -it --ipc=host --device nvidia.com/gpu=all -v "$(pwd)"/coco:/usr/src/coco $t
pip3 install torch==1.9.0+cu111 torchvision==0.10.0+cu111 -f https://download.pytorch.org/whl/torch_stable.html
cd .. && rm -rf app && git clone https://github.com/ultralytics/yolov5 -b master app && cd app
cp data/coco.yaml data/coco_profile.yaml

# profile
python train.py --batch-size 16 --data coco_profile.yaml --weights yolov5l.pt --epochs 1 --device 0
python -m torch.distributed.run --nproc_per_node 2 train.py --batch-size 32 --data coco_profile.yaml --weights yolov5l.pt --epochs 1 --device 0,1
python -m torch.distributed.run --nproc_per_node 4 train.py --batch-size 64 --data coco_profile.yaml --weights yolov5l.pt --epochs 1 --device 0,1,2,3
python -m torch.distributed.run --nproc_per_node 8 train.py --batch-size 128 --data coco_profile.yaml --weights yolov5l.pt --epochs 1 --device 0,1,2,3,4,5,6,7| GPU A100 | dimensione del batch | CUDA_mem device0 (G) | COCO addestramento | COCO val |
|---|---|---|---|---|
| 1x | 16 | 26GB | 20:39 | 0:55 |
| 2x | 32 | 26GB | 11:43 | 0:57 |
| 4x | 64 | 26GB | 5:57 | 0:55 |
| 8x | 128 | 26GB | 3:09 | 0:57 |
Come mostrano i risultati, l'uso di DistributedDataParallel con più GPU consente una scalabilità pressoché lineare della velocità di addestramento. Con 8 GPU, l'addestramento termina circa 6,5 volte più velocemente rispetto a una singola GPU, mantenendo invariato l'utilizzo di memoria per dispositivo.
Ambienti supportati#
Ultralytics offre una gamma di ambienti pronti all'uso, ciascuno con dipendenze essenziali preinstallate, come CUDA, cuDNN, Python e PyTorch, per dare slancio ai tuoi progetti.
- Notebook GPU gratuiti:


- Google Cloud: Guida rapida a GCP
- Amazon: Guida rapida ad AWS
- Azure: Guida rapida ad AzureML
- Docker: Guida rapida a Docker
Stato del progetto#

Questo badge indica che tutti i test di integrazione continua (CI) di YOLOv5 GitHub Actions sono superati correttamente. Questi test CI verificano rigorosamente la funzionalità e le prestazioni di YOLOv5 in diversi ambiti chiave: addestramento, validazione, inferenza, esportazione e benchmark. Garantiscono un funzionamento coerente e affidabile su macOS, Windows e Ubuntu, con test eseguiti ogni 24 ore e a ogni nuovo commit.
Ringraziamenti#
Desideriamo ringraziare @MagicFrogSJTU, che ha fatto tutto il lavoro più impegnativo, e @glenn-jocher per averci guidato lungo il percorso.
Vedi anche#
- Modalità di addestramento - Scopri come addestrare i modelli YOLO con Ultralytics
- Ottimizzazione degli iperparametri - Ottimizza le prestazioni del tuo modello
- Guida rapida a Docker - Configura il tuo ambiente Docker per l'addestramento
Domande frequenti#
Leggi la checklist qui sotto prima di aprire una segnalazione: spesso ti fa risparmiare tempo.
Lista di controllo (fai clic per espandere)
- Hai letto questa guida dall'inizio alla fine?
- Hai clonato di nuovo il repository? Il codice cambia ogni giorno.
- Hai cercato il messaggio di errore? Qualcuno potrebbe aver già riscontrato lo stesso problema e condiviso una soluzione.
- Hai installato tutti i requisiti (incluse le versioni corrette di Python e PyTorch)?
- Hai provato uno degli ambienti supportati elencati sopra?
- Hai provato un dataset standard, ad esempio
coco128ococo2017, per individuare la causa principale?
Se hai verificato tutti i punti sopra, apri una segnalazione includendo più dettagli possibile e seguendo il modello.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.