Consigli per ottenere i migliori risultati nell'addestramento di YOLOv5#
Questa guida spiega come ottenere i migliori risultati di mAP e di addestramento con YOLOv5.
Nella maggior parte dei casi puoi ottenere buoni risultati senza modificare i modelli o le impostazioni di addestramento, a condizione che il tuo dataset sia sufficientemente ampio e ben etichettato. Se inizialmente non ottieni buoni risultati, puoi provare alcuni accorgimenti per migliorarli, ma consigliamo sempre agli utenti di addestrare prima con tutte le impostazioni predefinite prima di valutare qualsiasi modifica. In questo modo puoi stabilire una baseline delle prestazioni e individuare le aree da migliorare.
Se hai domande sui risultati dell'addestramento, fornisci quante più informazioni possibile per ricevere una risposta utile, includendo i grafici dei risultati (perdite di addestramento, perdite di convalida, P, R, mAP), la curva PR, la matrice di confusione, i mosaici di addestramento, i risultati dei test e le immagini con le statistiche del dataset, come labels.png. Tutti questi elementi si trovano nella directory project/name, in genere yolov5/runs/train/exp.
Le sezioni seguenti illustrano i principali fattori che influenzano i risultati dell'addestramento di YOLOv5.
Dataset#
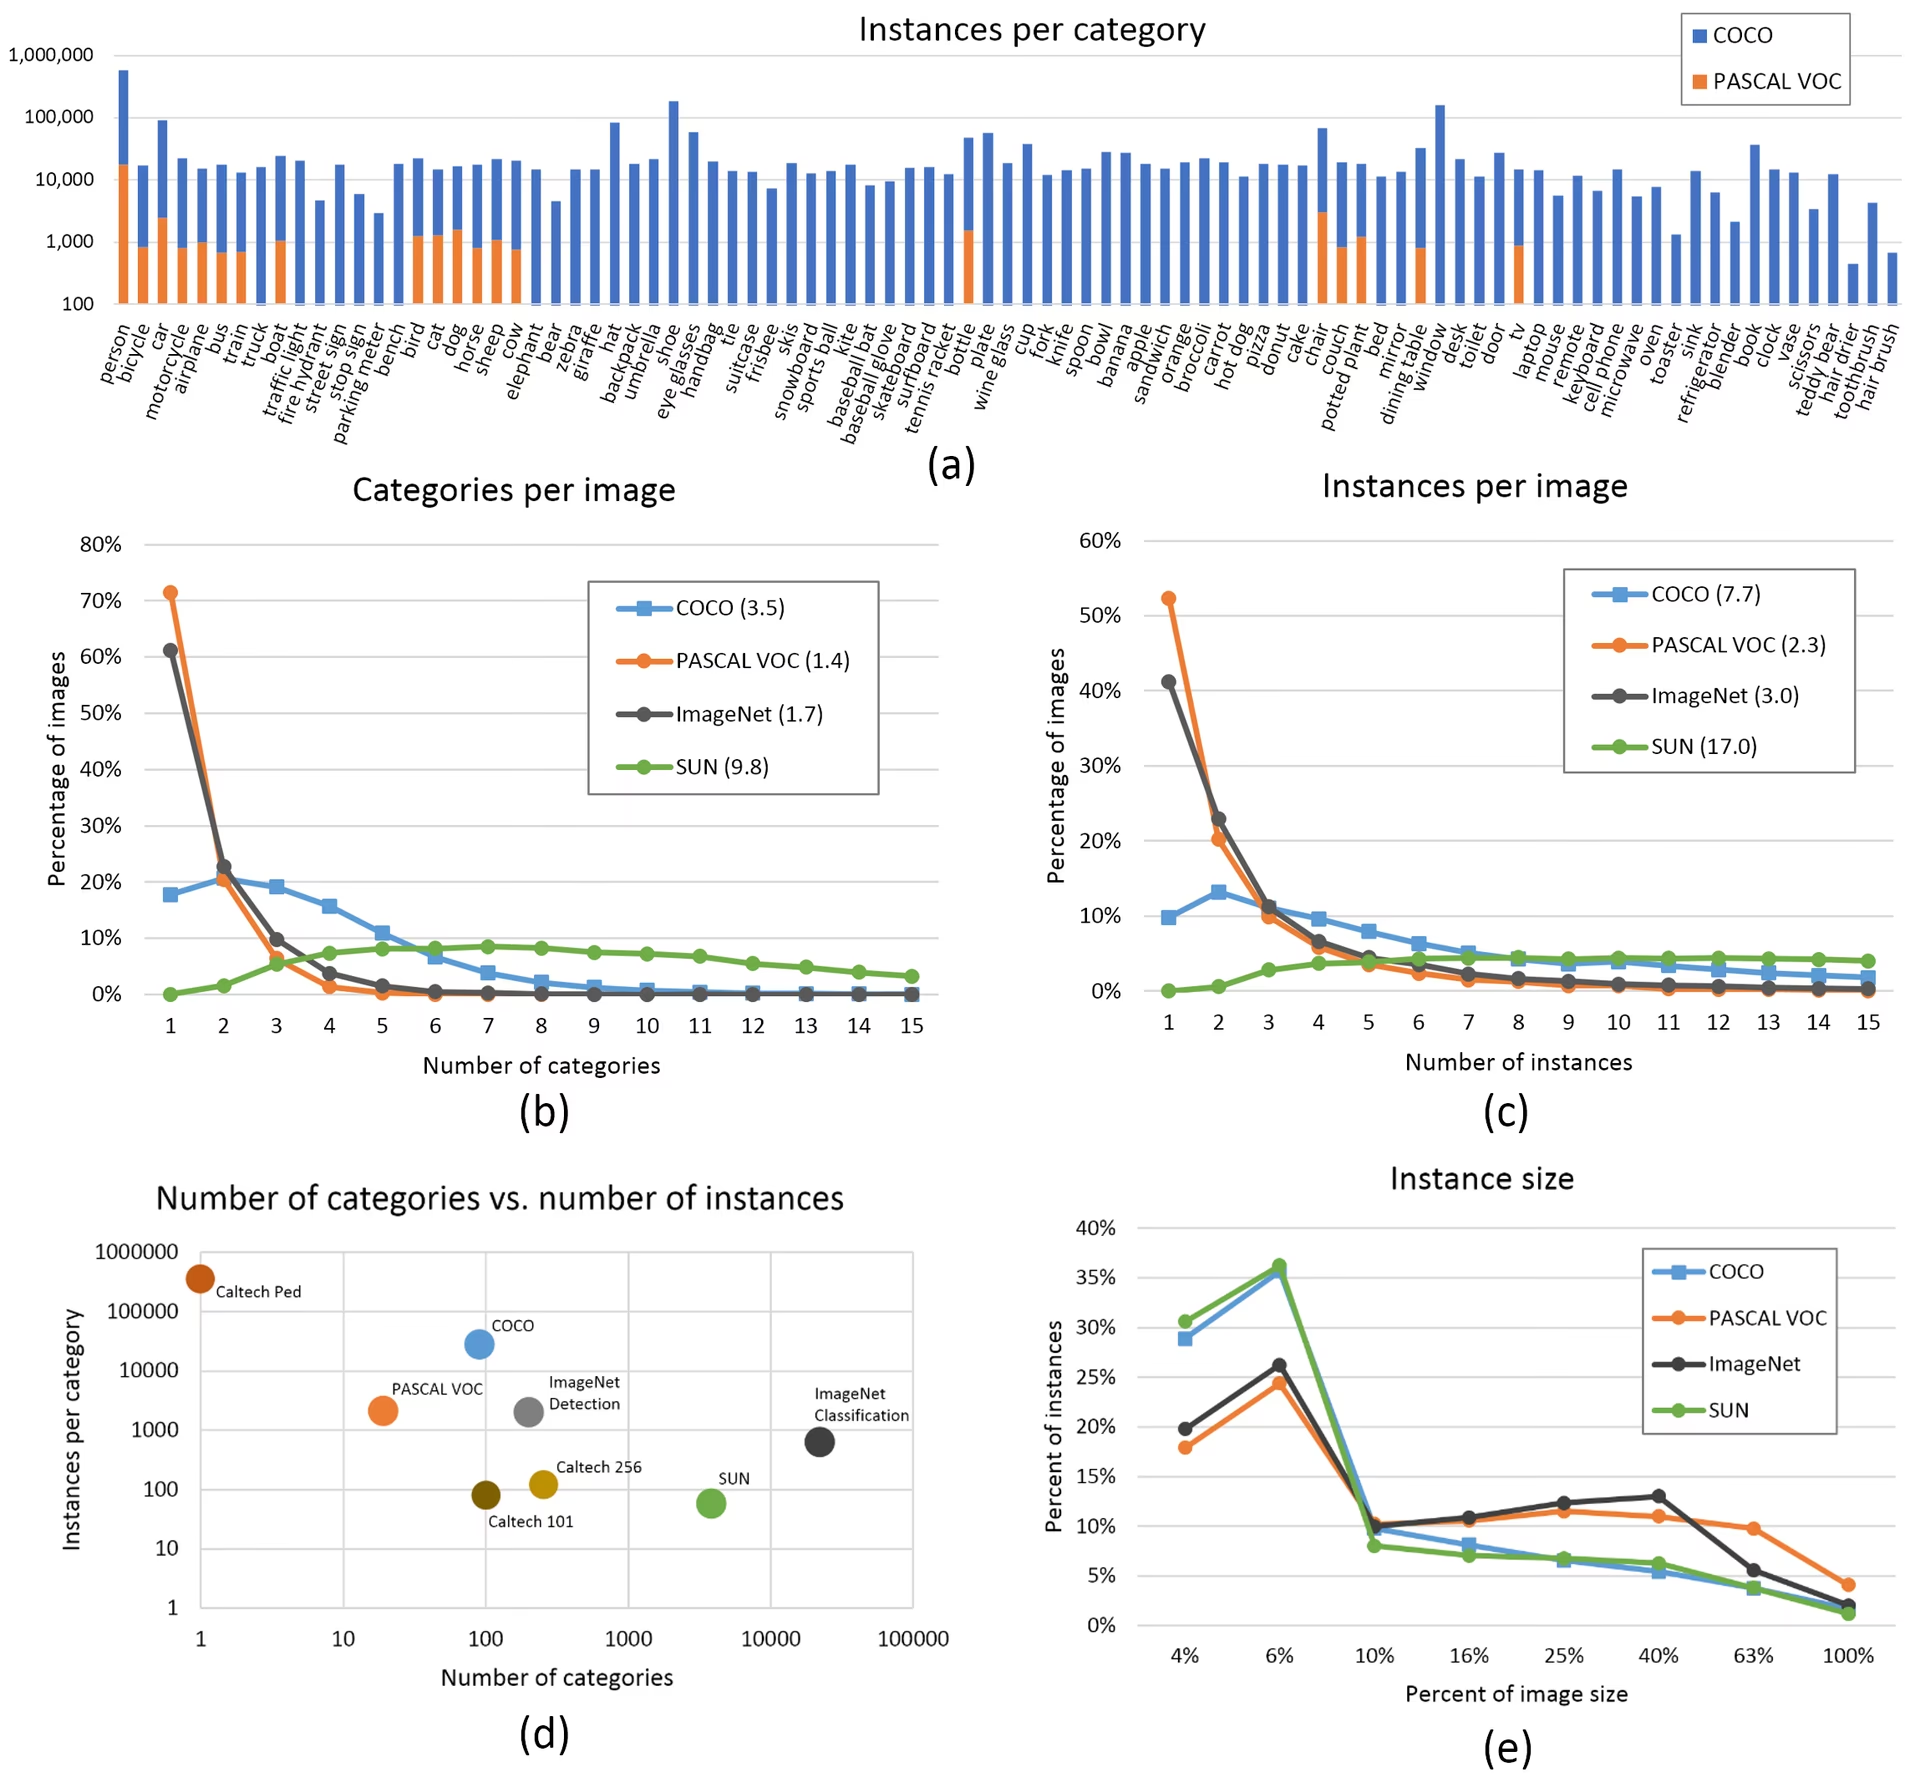
- Immagini per classe. Si consigliano ≥ 1500 immagini per classe
- Istanze per classe. Si consigliano ≥ 10000 istanze (oggetti etichettati) per classe
- Varietà delle immagini. Le immagini devono essere rappresentative dell'ambiente di distribuzione. Per i casi d'uso reali consigliamo immagini scattate in diversi momenti della giornata, stagioni, condizioni meteorologiche e di illuminazione, da angolazioni e fonti diverse (raccolte online, acquisite localmente, con fotocamere diverse) e così via.
- Coerenza delle etichette. Tutte le istanze di tutte le classi in tutte le immagini devono essere etichettate. Un'etichettatura parziale non è sufficiente.
- Accuratezza delle etichette. Le etichette devono racchiudere da vicino ogni oggetto. Non deve esserci spazio tra un oggetto e il relativo riquadro delimitatore. Nessun oggetto deve essere privo di etichetta.
- Gestione della suddivisione train/val. Per evitare metriche eccessivamente ottimistiche, assicurati che le immagini di validazione e test non compaiano mai nel set di addestramento. Mantieni distribuzioni delle classi simili tra le suddivisioni.
- Verifica delle etichette. All'avvio dell'addestramento, visualizza i mosaici
train_batch*.jpgper verificare che le etichette siano corrette. - Immagini di sfondo. Le immagini di sfondo non contengono oggetti e vengono aggiunte a un dataset per ridurre i falsi positivi (FP). Consigliamo che circa lo 0-10% del dataset sia composto da immagini di sfondo, così da contribuire a ridurre gli FP (COCO ne include 1000 come riferimento, pari all'1% del totale). Le immagini di sfondo non richiedono etichette.
Scelta del modello#
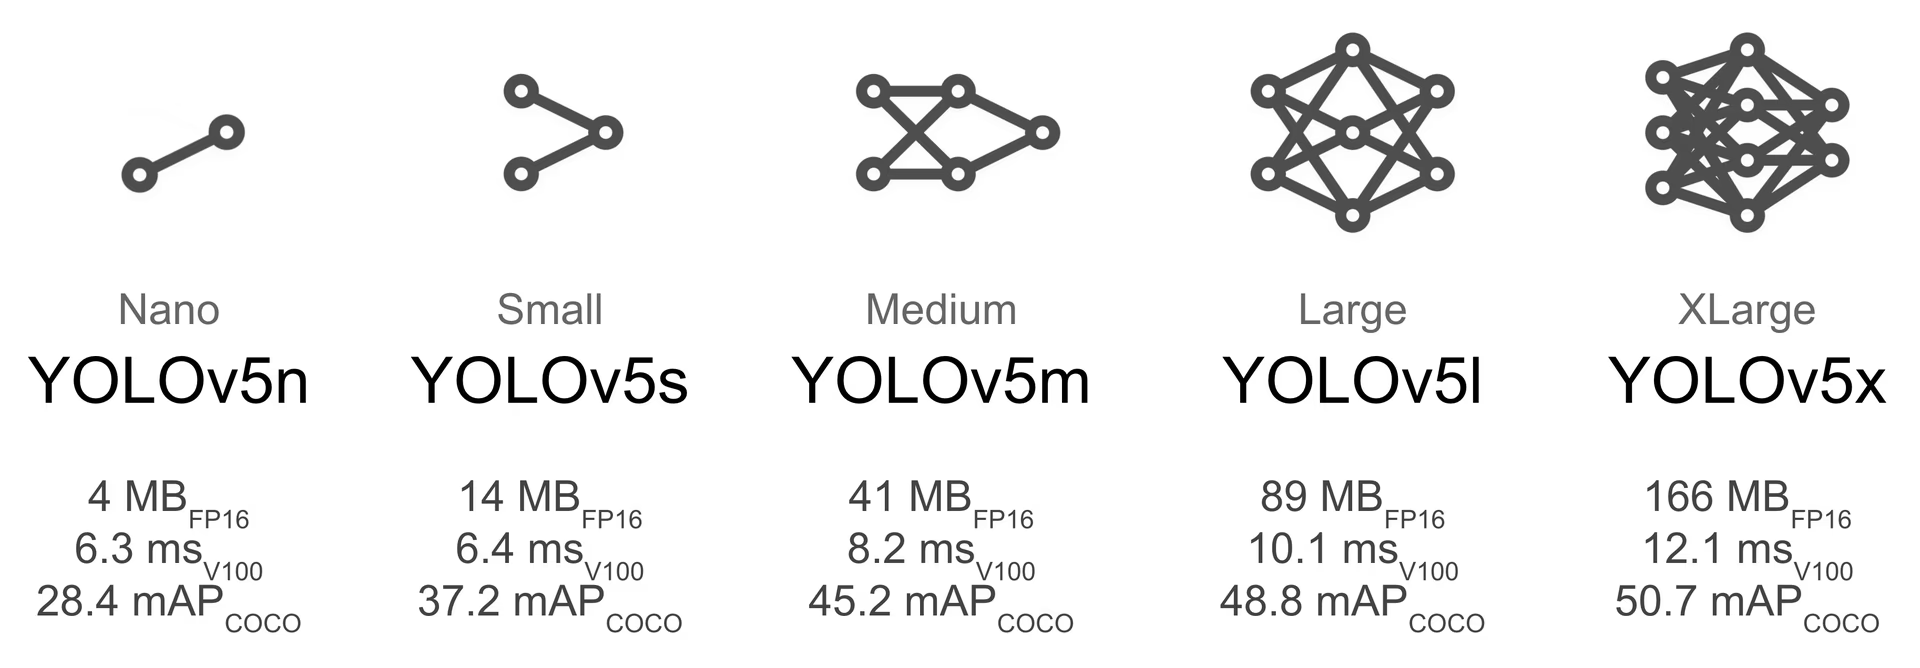
I modelli più grandi, come YOLOv5x e YOLOv5x6, in quasi tutti i casi producono risultati migliori, ma hanno più parametri, richiedono più memoria CUDA per l'addestramento e sono più lenti da eseguire. Per le distribuzioni su dispositivi mobili consigliamo YOLOv5s/m; per le distribuzioni su cloud consigliamo YOLOv5l/x.
-
Partire da pesi preaddestrati. Consigliato per dataset di dimensioni medio-piccole (ad es. VOC, VisDrone, GlobalWheat). Passa il nome del modello all'argomento
--weights. I modelli vengono scaricati automaticamente dall'ultima release di YOLOv5.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Partire da zero. Consigliato per dataset di grandi dimensioni (ad es. COCO, Objects365, OIv6). Passa l'architettura del modello YAML desiderata insieme a un argomento
--weights ''vuoto:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Impostazioni di addestramento#
Prima di modificare qualsiasi cosa, addestra prima con le impostazioni predefinite per stabilire un riferimento delle prestazioni. L'elenco completo delle impostazioni di train.py è disponibile nell'argparser di train.py.
- Epoche. Inizia con 300 epoche. Se si verifica overfitting precocemente, puoi ridurre il numero di epoche. Se dopo 300 epoche non si verifica overfitting, prolunga l'addestramento, ad esempio a 600 o 1200 epoche.
- Dimensione dell'immagine. COCO viene addestrato alla risoluzione nativa di
--img 640, ma, dato l'elevato numero di oggetti piccoli nel dataset, può trarre vantaggio dall'addestramento a risoluzioni maggiori, come--img 1280. Se il dataset personalizzato contiene molti oggetti piccoli, l'addestramento alla risoluzione nativa o a una risoluzione maggiore può essere vantaggioso. I risultati migliori in inferenza si ottengono alla stessa--imgusata per l'addestramento: ad esempio, se addestri a--img 1280, dovresti anche testare ed eseguire il rilevamento a--img 1280. - Dimensione del batch. Usa la dimensione
--batch-sizepiù grande supportata dal tuo hardware. Batch di piccole dimensioni producono statistiche di batch normalization scadenti e sono da evitare. Puoi usare--batch-size -1per selezionare automaticamente la dimensione ottimale del batch per la tua GPU. - Tasso di apprendimento. La pianificazione predefinita del tasso di apprendimento funziona bene nella maggior parte dei casi. Per una convergenza più rapida, puoi provare il flag
--cos-lrper attivare una pianificazione coseno del tasso di apprendimento, che lo riduce gradualmente seguendo una curva coseno durante le epoche. - Aumento dei dati. YOLOv5 include diverse tecniche di aumento dei dati, come il mosaico, che combina più immagini di addestramento. Regola l'intensità dell'aumento tramite l'iperparametro
mosaicnel file--hypper contribuire a stabilizzare l'addestramento. - Iperparametri. Gli iperparametri predefiniti si trovano in hyp.scratch-low.yaml. Ti consigliamo di addestrare prima con gli iperparametri predefiniti, prima di valutare eventuali modifiche. In generale, aumentare gli iperparametri di data augmentation riduce e ritarda l'overfitting, consentendo addestramenti più lunghi e un mAP finale più alto. Ridurre gli iperparametri di guadagno delle componenti della loss, come
hyp['obj'], aiuta a ridurre l'overfitting in quelle specifiche componenti della loss. Per un metodo automatizzato di ottimizzazione di questi iperparametri, consulta il nostro tutorial sull'evoluzione degli iperparametri. - Addestramento a precisione mista. YOLOv5 attiva automaticamente la precisione mista automatica (AMP) quando rileva una GPU supportata, velocizzando l'addestramento e riducendo l'uso di memoria senza sacrificare l'accuratezza del modello.
- Addestramento multi-GPU. Se hai più GPU, avvia l'addestramento DistributedDataParallel con
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3per ridurre significativamente i tempi di addestramento. - Arresto anticipato. Usa
--patience 50per interrompere l'addestramento se le metriche di validazione non migliorano per 50 epoche, risparmiando tempo e prevenendo l'overfitting.
Tecniche di ottimizzazione avanzate#
- Transfer learning. Per dataset specializzati, inizia dai pesi pretrained e, facoltativamente, congela alcuni layer con
--freezeper adattare il modello al tuo compito specifico. - Pruning del modello. Dopo l'addestramento, valuta di applicare il pruning al modello per azzerare i pesi ridondanti con una perdita minima di accuratezza, quindi distribuiscilo con un runtime sensibile alla sparsità per ottenere incrementi di velocità.
- Ensemble di modelli. Per le applicazioni critiche, addestra più modelli con configurazioni diverse e combina le loro previsioni per migliorare l'accuratezza.
- Aumento dei dati in fase di test. Abilita TTA durante l'inferenza con
--augmentper migliorare l'accuratezza delle previsioni combinando quelle ottenute da versioni capovolte e ridimensionate dell'immagine di input.
Approfondimenti#
Per approfondire, un buon punto di partenza è A Recipe for Training Neural Networks di Karpathy, che propone idee per l'addestramento applicabili in generale a tutti i domini del ML.
Buona fortuna e facci sapere se hai altre domande.
Domande frequenti#
Il tuo modello potrebbe essere in overfitting se la loss di training continua a diminuire mentre la loss di validazione inizia ad aumentare. Monitora la mAP di validazione: se si stabilizza o diminuisce mentre la loss di training continua a migliorare, è un segnale di overfitting. Tra le possibili soluzioni ci sono aggiungere altri dati di training, aumentare l'augmentation dei dati o applicare tecniche di regolarizzazione.
La dimensione ottimale del batch dipende dalla memoria della tua GPU. In generale, batch più grandi forniscono statistiche di batch normalization migliori e maggiore stabilità durante l'addestramento. Usa la dimensione del batch più grande che il tuo hardware può gestire senza esaurire la memoria. Puoi usare
--batch-size -1per determinare automaticamente la dimensione ottimale del batch per la tua configurazione.Per velocizzare il training, prova a usare più GPU con DDP, a memorizzare nella cache il dataset con
--cachee a ottimizzare la dimensione del batch (la precisione mista viene abilitata automaticamente sulle GPU supportate). Valuta anche un modello più piccolo, come YOLOv5s, se la massima accuratezza non è fondamentale.
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.