Il dataset PASCAL VOC (classi di oggetti visivi) è un benchmark classico per il rilevamento degli oggetti, con 20 classi di oggetti di uso quotidiano. La configurazione Ultralytics VOC.yaml unisce gli split trainval di VOC2007 e VOC2012 in un set di addestramento da 16.551 immagini, esegue la convalida sulle 4.952 immagini di test VOC2007 annotate e rese pubbliche, e scarica automaticamente tutti i dati (2,8 GB) al primo utilizzo.
Guarda: Come addestrare Ultralytics YOLO sul dataset Pascal VOC | Rilevamento di oggetti | Visione artificiale 🚀
Le sfide PASCAL VOC si sono svolte dal 2005 al 2012 e hanno influenzato il modo in cui vengono valutati i modelli di rilevamento degli oggetti: il benchmark comprende attività di classificazione, rilevamento e segmentazione delle immagini, e ha reso popolare la precisione media media (mAP) come metrica standard per il rilevamento. La configurazione Ultralytics VOC.yaml usa le annotazioni di rilevamento e converte i riquadri di delimitazione XML originali nel formato YOLO durante il download.
20 classi di oggetti di uso quotidiano: persona; sei animali (uccello, gatto, mucca, cane, cavallo, pecora); sette veicoli (aeroplano, bicicletta, barca, autobus, automobile, motocicletta, treno); e sei oggetti da interni (bottiglia, sedia, tavolo da pranzo, pianta in vaso, divano, monitor TV).
Due generazioni di sfide combinate: l'addestramento unisce VOC2007 trainval (5.011 immagini) e VOC2012 trainval (11.540 immagini).
Valutazione standardizzata: decenni di baseline VOC pubblicate ne fanno un comodo riferimento per confrontare i modelli di rilevamento.
Pronto per YOLO: lo script di download recupera gli archivi e converte automaticamente le annotazioni; non è necessaria alcuna preparazione manuale.
Test VOC2007, usato per la valutazione durante l'addestramento
Test
4,952
Le stesse immagini di test VOC2007: la configurazione non definisce uno split separato riservato
Le annotazioni del test VOC2007 sono state rese pubbliche dopo la sfida di quell'anno, consentendo di usare questo split come set di convalida etichettato. Le annotazioni del test VOC2012 restano riservate: i risultati possono essere valutati solo tramite il server ufficiale di valutazione PASCAL, quindi non fanno parte di questa configurazione.
Oggetti difficili esclusi
Il convertitore automatico ignora gli oggetti contrassegnati con difficult nelle annotazioni XML VOC originali; per questo, il numero di istanze per classe differisce leggermente dalle statistiche VOC ufficiali.
Esplora VOC su Ultralytics Platform per sfogliare le immagini con le relative sovrapposizioni delle annotazioni, visualizzare la distribuzione delle classi e le mappe di calore dei riquadri di delimitazione nella scheda Grafici, e creare un clone per addestrare il tuo modello nel cloud.
PASCAL VOC è stato il benchmark principale per la ricerca sul rilevamento degli oggetti negli anni precedenti al più grande dataset COCO: rilevatori come Faster R-CNN e SSD vi hanno pubblicato i risultati originali, e i modelli Ultralytics YOLO possono essere addestrati direttamente su questo dataset. Oggi resta molto usato per:
Valutare nuove architetture di rilevamento confrontandole con una lunga serie di baseline pubblicate
Esperimenti rapidi e attività didattiche: con 16.551 immagini di addestramento, l'addestramento è molto più veloce che su COCO
VOC viene scaricato automaticamente al primo avvio dell'addestramento — tre archivi per un totale di 2,8 GB — e richiede circa 6 GB di spazio libero su disco durante l'estrazione e la conversione.
Per addestrare un modello YOLO26n sul dataset VOC per 100 epoche con una dimensione delle immagini di 640, puoi usare i seguenti snippet di codice.
Esempio di addestramento
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello: il dataset verrà scaricato automaticamente alla prima esecuzione
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
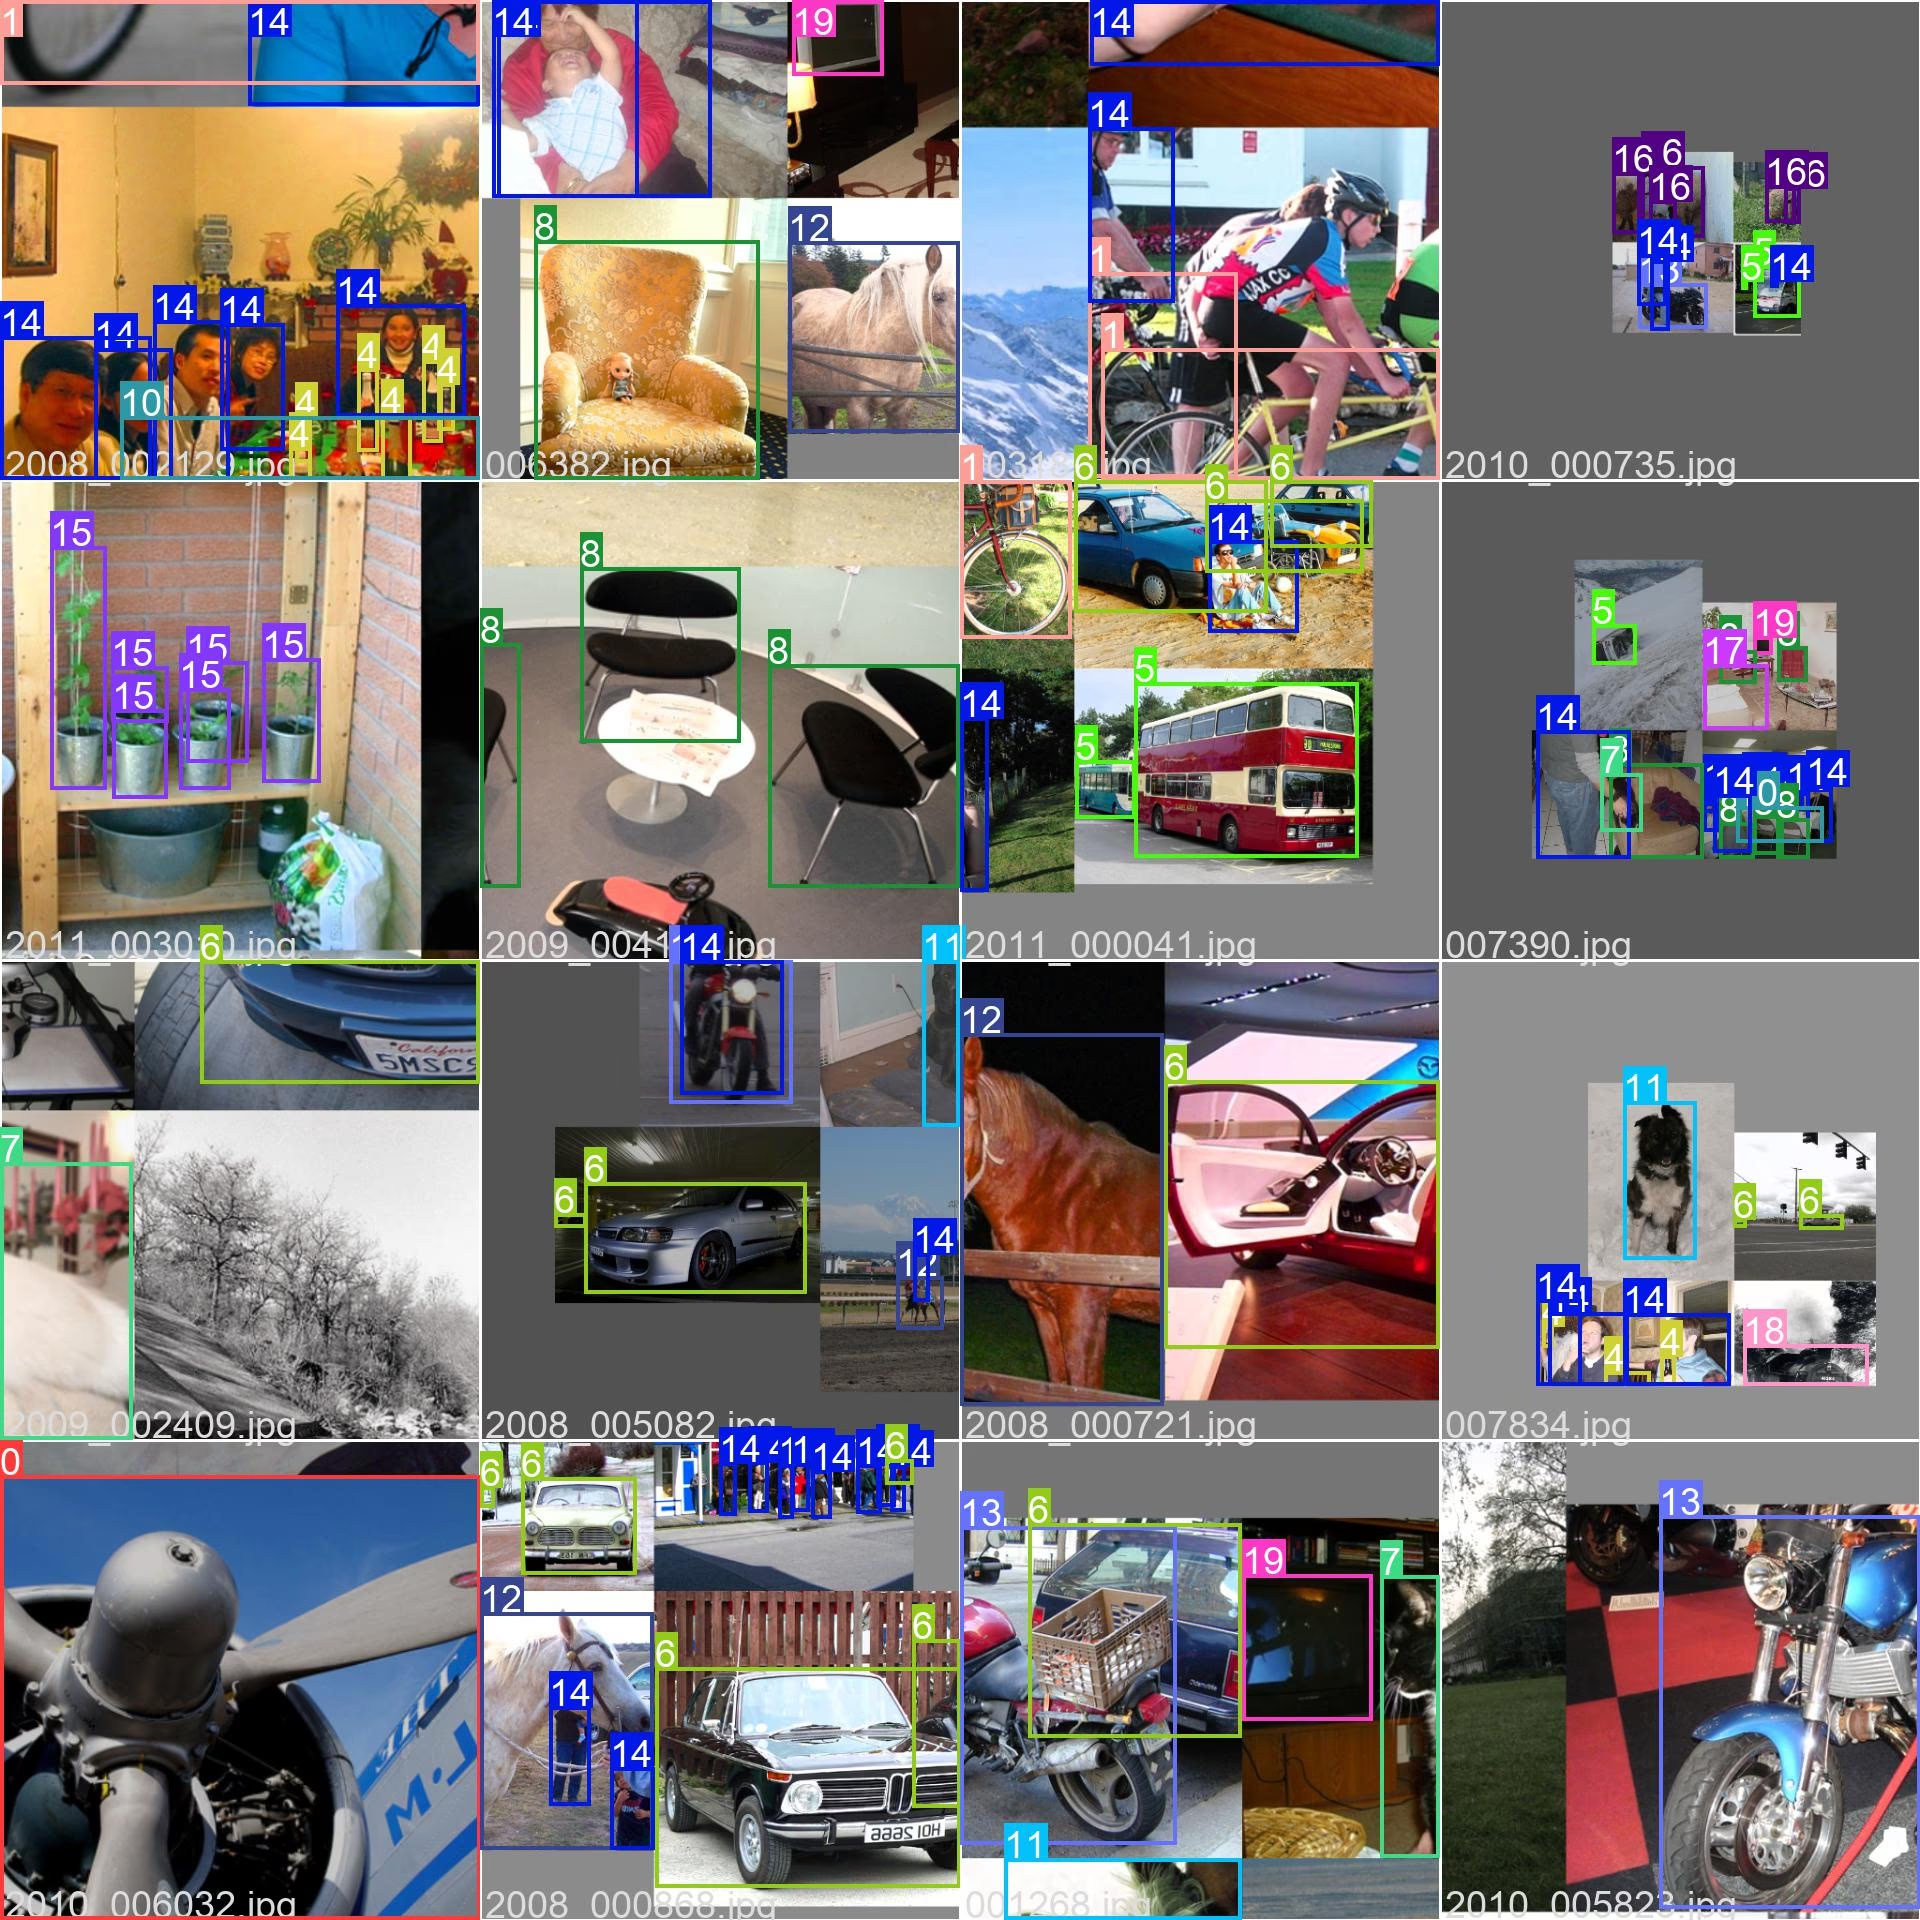
L'immagine qui sotto mostra un batch di addestramento mosaicato del dataset VOC. La mosaificazione combina più immagini in un singolo campione di addestramento, aumentando la varietà di oggetti, scale e contesti delle scene che il modello vede in ogni batch — per i dettagli, consulta la guida all'aumento dei dati di YOLO.
Se usi il dataset VOC nel tuo lavoro di ricerca o sviluppo, cita il seguente articolo:
Citazione
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
Desideriamo ringraziare il PASCAL VOC Consortium per aver creato e mantenuto questa preziosa risorsa per la comunità della visione artificiale. Per ulteriori informazioni sul dataset VOC e sui suoi creatori, visita il sito web del dataset PASCAL VOC.
PASCAL VOC è usato per addestrare e valutare tramite benchmark modelli di rilevamento di oggetti su 20 classi di oggetti di uso quotidiano, come persona, auto, cane e sedia. Poiché è compatto, completamente etichettato e supportato da anni di risultati di riferimento pubblicati, è una scelta comune per convalidare nuove architetture, svolgere esperimenti didattici e condurre rapidi studi di transfer learning.
La configurazione Ultralytics VOC contiene 21.503 immagini: 16.551 per l'addestramento (VOC2007 trainval + VOC2012 trainval) e 4.952 per la validazione (il test set VOC2007). Tutti gli split condividono le stesse 20 classi. Consulta Struttura del dataset per il dettaglio completo.
VOC viene scaricato automaticamente al primo addestramento con data="VOC.yaml" — non sono necessari passaggi manuali. Lo script scarica tre archivi (2,8 GB) dagli asset della release di Ultralytics GitHub e converte le annotazioni XML nel formato YOLO.
Addestra un modello YOLO26n su VOC per 100 epoche con una dimensione dell'immagine di 640:
Esempio di addestramento
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
Entrambe le sfide condividono le stesse 20 classi, ma includono immagini diverse. VOC2007 fornisce 5.011 immagini trainval e un test set di 4.952 immagini con annotazioni pubbliche; VOC2012 fornisce 11.540 immagini trainval, mentre le relative annotazioni di test non sono disponibili e vengono valutate solo dal server ufficiale di valutazione. VOC.yaml di Ultralytics unisce entrambi i set trainval per l'addestramento ed esegue la validazione sul test VOC2007.
VOC è più piccolo e semplice: 20 classi e 21.503 immagini, contro le 80 classi e le 330.000 immagini di COCO. Tradizionalmente, i risultati di VOC sono riportati come mAP a 0,5 IoU, mentre COCO calcola la media della mAP su soglie IoU da 0,5 a 0,95. VOC si addestra molto più rapidamente ed è adatto a esperimenti rapidi; il dataset COCO è lo standard per i benchmark su scala di produzione.
No: VOC.yaml è una configurazione dedicata solo al rilevamento: il suo convertitore estrae i riquadri di delimitazione dalle annotazioni XML di VOC, ma non converte le maschere di segmentazione incluse nel benchmark originale. Per addestrare un modello di segmentazione di istanze, usa un dataset con etichette poligonali, come COCO-Seg, insieme a un modello YOLO26n-seg.
raise RuntimeError(emojis(f"Dataset '{clean_url(self.args.data)}' error ❌ {e}")) from e
RuntimeError: Dataset 'VOC.yaml' error ❌ [Errno 2] No such file or directory: '/home/diana/Code/test/datasets/VOC/images/VOCdevkit/VOC2007/ImageSets/Main/train.txt'
Nice find on the root cause. To clean things up, delete the incomplete datasets/VOC folder and run your yolo ... data=VOC.yaml command again so the download/conversion script can fully re-download and unpack everything; if you still hit a path error after that, please share the full command and complete traceback so we can take a closer look.
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to train YOLO26 on your Pascal VOC dataset, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height in normalized coordinates). Use the conversion script provided in the VOC.yaml file under the "Download script/URL" section. Once converted, define a custom YAML file for your dataset paths and run the training using:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="your_dataset.yaml", epochs=100, imgsz=640)
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to use your Pascal VOC dataset for YOLO26 training, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height with normalized coordinates). You can adapt the XML-to-YOLO conversion script from the VOC dataset documentation here: https://docs.ultralytics.com/datasets/detect/voc/. Once converted, create a dataset YAML file similar to VOC.yaml, specifying your paths and classes, and then start training using yolo detect train data=your_dataset.yaml model=yolo26n.pt. Let me know if you encounter any issues!
I cookie ci aiutano a capire quali documenti, modelli e funzionalità trovi utili, così possiamo continuare a migliorarli. Scegli cosa condividere in oppure leggi la nostra Informativa sulla privacy.


mengdxiran
 Glenn JocherUltralytics
YustasDev