Strategie di raccolta e annotazione dei dati per la visione artificiale
La raccolta e l’annotazione dei dati sono i due passaggi fondamentali di ogni progetto di visione artificiale: raccogli immagini o video rappresentativi, poi etichettali affinché un modello possa apprendere da essi. La qualità di questi dati determina direttamente le prestazioni del modello; per questo, prima di iniziare l’addestramento, sono importanti la definizione delle classi, la raccolta imparziale dei dati e un’annotazione coerente.
Guarda: Come creare strategie efficaci di raccolta e annotazione dei dati per la visione artificiale 🚀
Questa guida spiega come impostare le classi e raccogliere i dati, che cos'è l'annotazione dei dati e quali tipi e formati di annotazione scegliere, oltre alle strategie di etichettatura efficienti, allineando ogni decisione agli obiettivi del tuo progetto.
Impostare le classi e raccogliere i dati#
Raccogliere immagini e video per un progetto di visione artificiale dipende da tre decisioni: quante classi definire, da dove reperire i dati e come mantenere il dataset privo di distorsioni.
Scegliere le classi giuste per il tuo progetto#
Una delle prime domande quando si avvia un progetto di visione artificiale è quante classi includere. Devi determinare l'appartenenza alle classi, ovvero le diverse categorie o etichette che vuoi che il modello riconosca e distingua. Il numero di classi va stabilito in base agli obiettivi specifici del tuo progetto.
Per esempio, se vuoi monitorare il traffico, le tue classi potrebbero includere «auto», «camion», «autobus», «motocicletta» e «bicicletta». Per il tracciamento degli articoli in un negozio, invece, le classi potrebbero essere «frutta», «verdura», «bevande» e «snack». Definire le classi in base agli obiettivi del tuo progetto aiuta a mantenere il dataset pertinente e mirato.
Quando definisci le classi, un'altra distinzione importante è scegliere un numero di classi ampio o dettagliato. Per «numero» si intende il conteggio delle classi distinte che ti interessano. Questa decisione influenza il livello di dettaglio dei dati e la complessità del modello. Ecco gli aspetti da considerare per ciascun approccio:
- Numero ridotto di classi: categorie più ampie e inclusive, come «veicolo» e «non veicolo». Semplificano l'annotazione e richiedono meno risorse di calcolo, ma forniscono meno informazioni dettagliate e possono limitare l'efficacia del modello negli scenari complessi.
- Numero elevato di classi: più categorie con distinzioni più precise, come «berlina», «SUV», «pick-up» e «motocicletta». Acquisiscono informazioni più dettagliate e migliorano l'accuratezza e le prestazioni del modello. Tuttavia, richiedono più tempo e lavoro per l'annotazione, oltre a maggiori risorse di calcolo.
Iniziare con classi più specifiche può essere molto utile, soprattutto nei progetti complessi in cui i dettagli sono importanti. Classi più specifiche ti permettono di raccogliere dati più dettagliati, ottenere approfondimenti maggiori e definire distinzioni più chiare tra le categorie. Questo non solo migliora l'accuratezza del modello, ma rende anche più facile modificarlo in seguito, se necessario, facendo risparmiare tempo e risorse.
Fonti dei dati#
Puoi usare dataset pubblici o raccogliere dati personalizzati. I dataset pubblici, come quelli disponibili su Kaggle e Google Dataset Search Engine, offrono dati standardizzati e ben annotati, costituendo ottimi punti di partenza per addestrare e convalidare i modelli.
La raccolta di dati personalizzati, invece, ti permette di adattare il dataset alle tue esigenze specifiche. Puoi acquisire immagini e video con fotocamere o droni, estrarre immagini dal Web o usare dati interni già disponibili nella tua organizzazione. I dati personalizzati ti offrono un maggiore controllo sulla loro qualità e pertinenza. Combinare fonti di dati pubbliche e personalizzate aiuta a creare un dataset diversificato e completo.
Evitare le distorsioni nella raccolta dei dati#
Si verifica una distorsione quando alcuni gruppi o scenari sono sottorappresentati o sovrarappresentati nel dataset. Ne deriva un modello che funziona bene su alcuni dati ma male su altri. È fondamentale evitare le distorsioni nell'IA, affinché il tuo modello di visione artificiale funzioni bene in una varietà di scenari.
Ecco come evitare le distorsioni durante la raccolta dei dati:
- Fonti diversificate: raccogli dati da molte fonti per acquisire prospettive e scenari diversi.
- Rappresentazione equilibrata: includi una rappresentazione equilibrata di tutti i gruppi pertinenti. Per esempio, considera età, generi ed etnie diverse.
- Monitoraggio continuo: esamina e aggiorna regolarmente il dataset per individuare e affrontare eventuali distorsioni emergenti.
- Tecniche di mitigazione delle distorsioni: usa metodi come il sovracampionamento delle classi sottorappresentate, l'aumento dei dati e gli algoritmi consapevoli dell'equità.
Seguire queste pratiche aiuta a creare un modello più robusto ed equo, capace di generalizzare bene nelle applicazioni del mondo reale.
Che cos'è l'annotazione dei dati?#
L'annotazione dei dati è il processo di etichettatura dei dati per renderli utilizzabili nell'addestramento di modelli di apprendimento automatico. Nella visione artificiale, consiste nell'etichettare immagini o video con le informazioni da cui il modello deve apprendere. Senza dati annotati correttamente, i modelli non possono apprendere con precisione le relazioni tra input e output.
Tipi di annotazione dei dati#
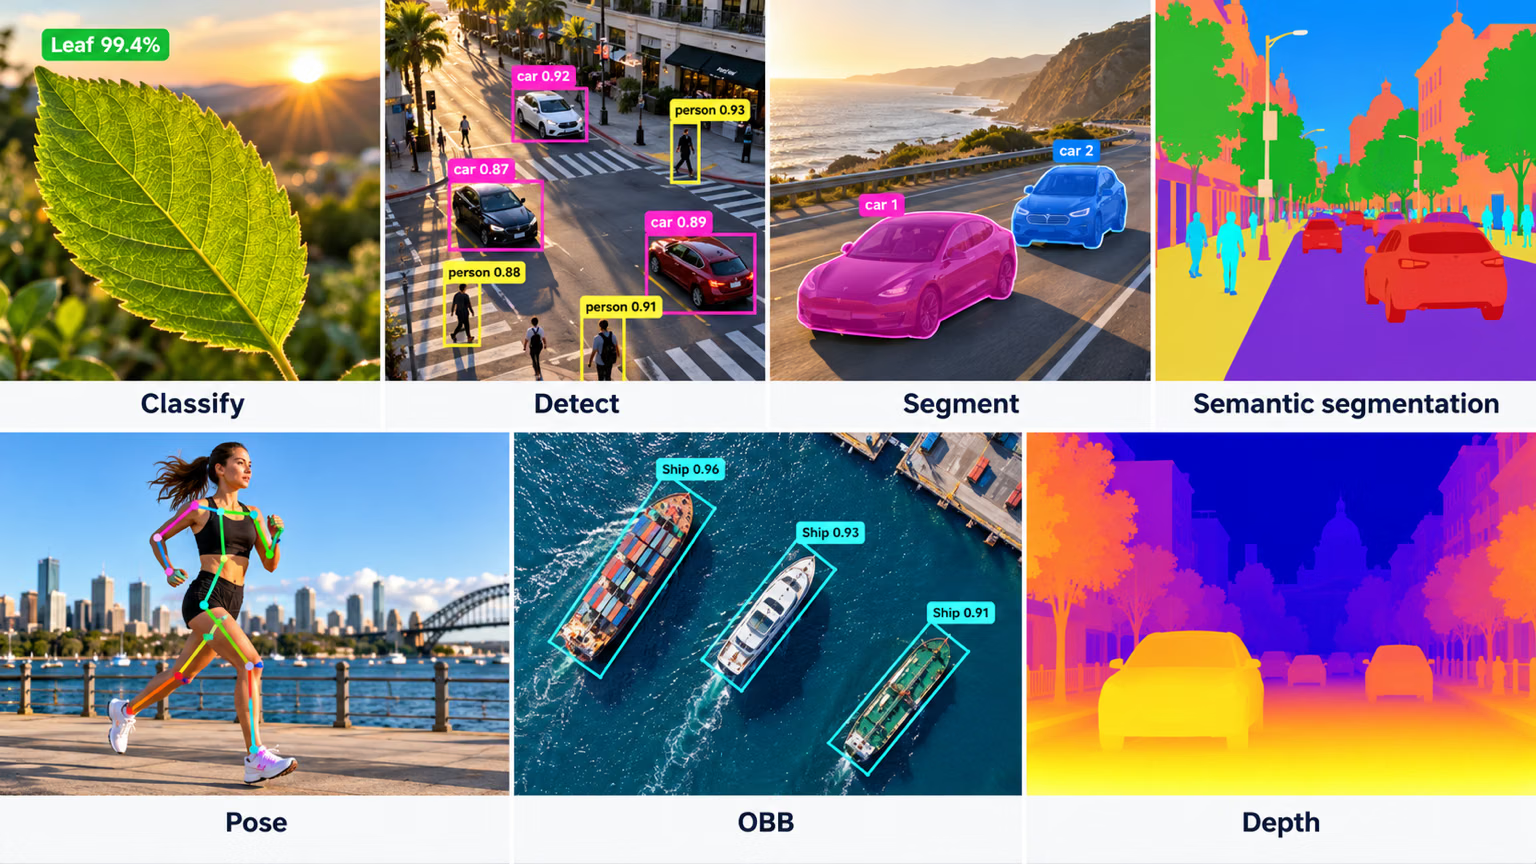
A seconda dei requisiti specifici di un compito di visione artificiale, esistono diversi tipi di annotazione dei dati. Ecco alcuni esempi:
- Bounding box: riquadri rettangolari disegnati attorno agli oggetti in un'immagine, usati soprattutto per il rilevamento degli oggetti. Sono definiti dalle coordinate dell'angolo superiore sinistro e di quello inferiore destro.
- Poligoni: contorni dettagliati degli oggetti, che consentono un'annotazione più precisa rispetto alle bounding box. I poligoni sono usati in attività come la segmentazione di istanze, in cui la forma dell'oggetto è importante.
- Maschere: maschere binarie in cui ogni pixel appartiene a un oggetto oppure allo sfondo. Le maschere sono usate nelle attività di segmentazione semantica per fornire dettagli a livello di pixel.
- Keypoint: punti specifici contrassegnati in un'immagine per identificare le posizioni di interesse. I keypoint sono usati in attività come la stima della posa e il rilevamento dei punti di riferimento facciali.
- Bounding box orientate: rettangoli con un angolo di rotazione, usati nelle attività OBB quando gli oggetti appaiono con orientamenti arbitrari, come nelle immagini aeree.
Formati di annotazione comuni#
Dopo aver scelto un tipo di annotazione, è importante selezionare il formato adatto per archiviare e condividere le annotazioni. I formati più comuni sono:
| Formato | Struttura dei file | Usato comunemente per |
|---|---|---|
| COCO | Un singolo file JSON | Rilevamento degli oggetti, segmentazione di istanze, rilevamento dei keypoint, classi di sfondo e segmentazione panottica, didascalie delle immagini |
| Pascal VOC | Un file XML per immagine | Rilevamento degli oggetti |
| YOLO | Un file .txt per immagine | Rilevamento degli oggetti, segmentazione, posa e bounding box orientate |
Il formato YOLO memorizza una riga per oggetto, con indici di classe a partire da 0. Per il rilevamento degli oggetti, la riga è class x_center y_center width height con coordinate normalizzate tra 0 e 1. In una riga di segmentazione, il riquadro è sostituito dai punti normalizzati del poligono dell’oggetto; una riga pose mantiene il riquadro e aggiunge le coordinate dei punti chiave, con un flag di visibilità per ogni punto chiave se il set di dati dichiara kpt_shape: [n, 3]. Una riga OBB memorizza class x1 y1 x2 y2 x3 y3 x4 y4 usando le coordinate normalizzate degli angoli.
Se il tuo strumento di annotazione esporta un JSON COCO, puoi convertirlo in etichette YOLO .txt oppure addestrare direttamente sul JSON con una classe di dataset personalizzata.
Definire le linee guida per l'annotazione#
Dopo aver scelto il tipo e il formato di annotazione, il passo successivo è stabilire regole di etichettatura chiare e oggettive. Queste regole fungono da guida per garantire coerenza e accuratezza durante tutto il processo di annotazione. Gli aspetti principali da considerare includono:
- Chiarezza e dettagli: assicurati che le istruzioni siano chiare. Usa esempi e illustrazioni per mostrare che cosa ci si aspetta.
- Coerenza: mantieni uniformi le annotazioni. Definisci criteri standard per annotare diversi tipi di dati, così che tutte le annotazioni seguano le stesse regole.
- Riduzione delle distorsioni: mantieni un atteggiamento neutrale. Abituati a essere obiettivo e riduci al minimo le distorsioni personali per garantire annotazioni eque.
- Efficienza: usa strumenti e flussi di lavoro che automatizzano le attività ripetitive, rendendo il processo di annotazione più rapido ed efficiente.
Esaminare e aggiornare regolarmente le regole di etichettatura aiuta a mantenere le annotazioni accurate, coerenti e in linea con gli obiettivi del progetto.
Strumenti di annotazione#
Un buon strumento di annotazione ti permette di etichettare ogni tipo richiesto dall'attività, applica linee guida coerenti ed esporta le etichette in un formato pronto per l'addestramento. Ultralytics Platform offre un editor di annotazione integrato per rilevamento, segmentazione di istanze, segmentazione semantica, classificazione, posa e OBB, con un'annotazione intelligente basata su SAM che trasforma un singolo clic in una maschera per le attività di rilevamento, segmentazione di istanze, segmentazione semantica e OBB. Poiché le annotazioni vengono salvate nel formato previsto da ciascuna attività — righe YOLO .txt per le attività spaziali e cartelle di classi per la classificazione — il dataset etichettato passa direttamente all'addestramento, senza conversioni.
Qualità dell'annotazione: accuratezza, precisione e valori anomali#
Prima di annotare su larga scala, è utile comprendere accuratezza, precisione, valori anomali e controllo qualità, così da non etichettare i dati in modo controproducente.
Comprendere accuratezza e precisione#
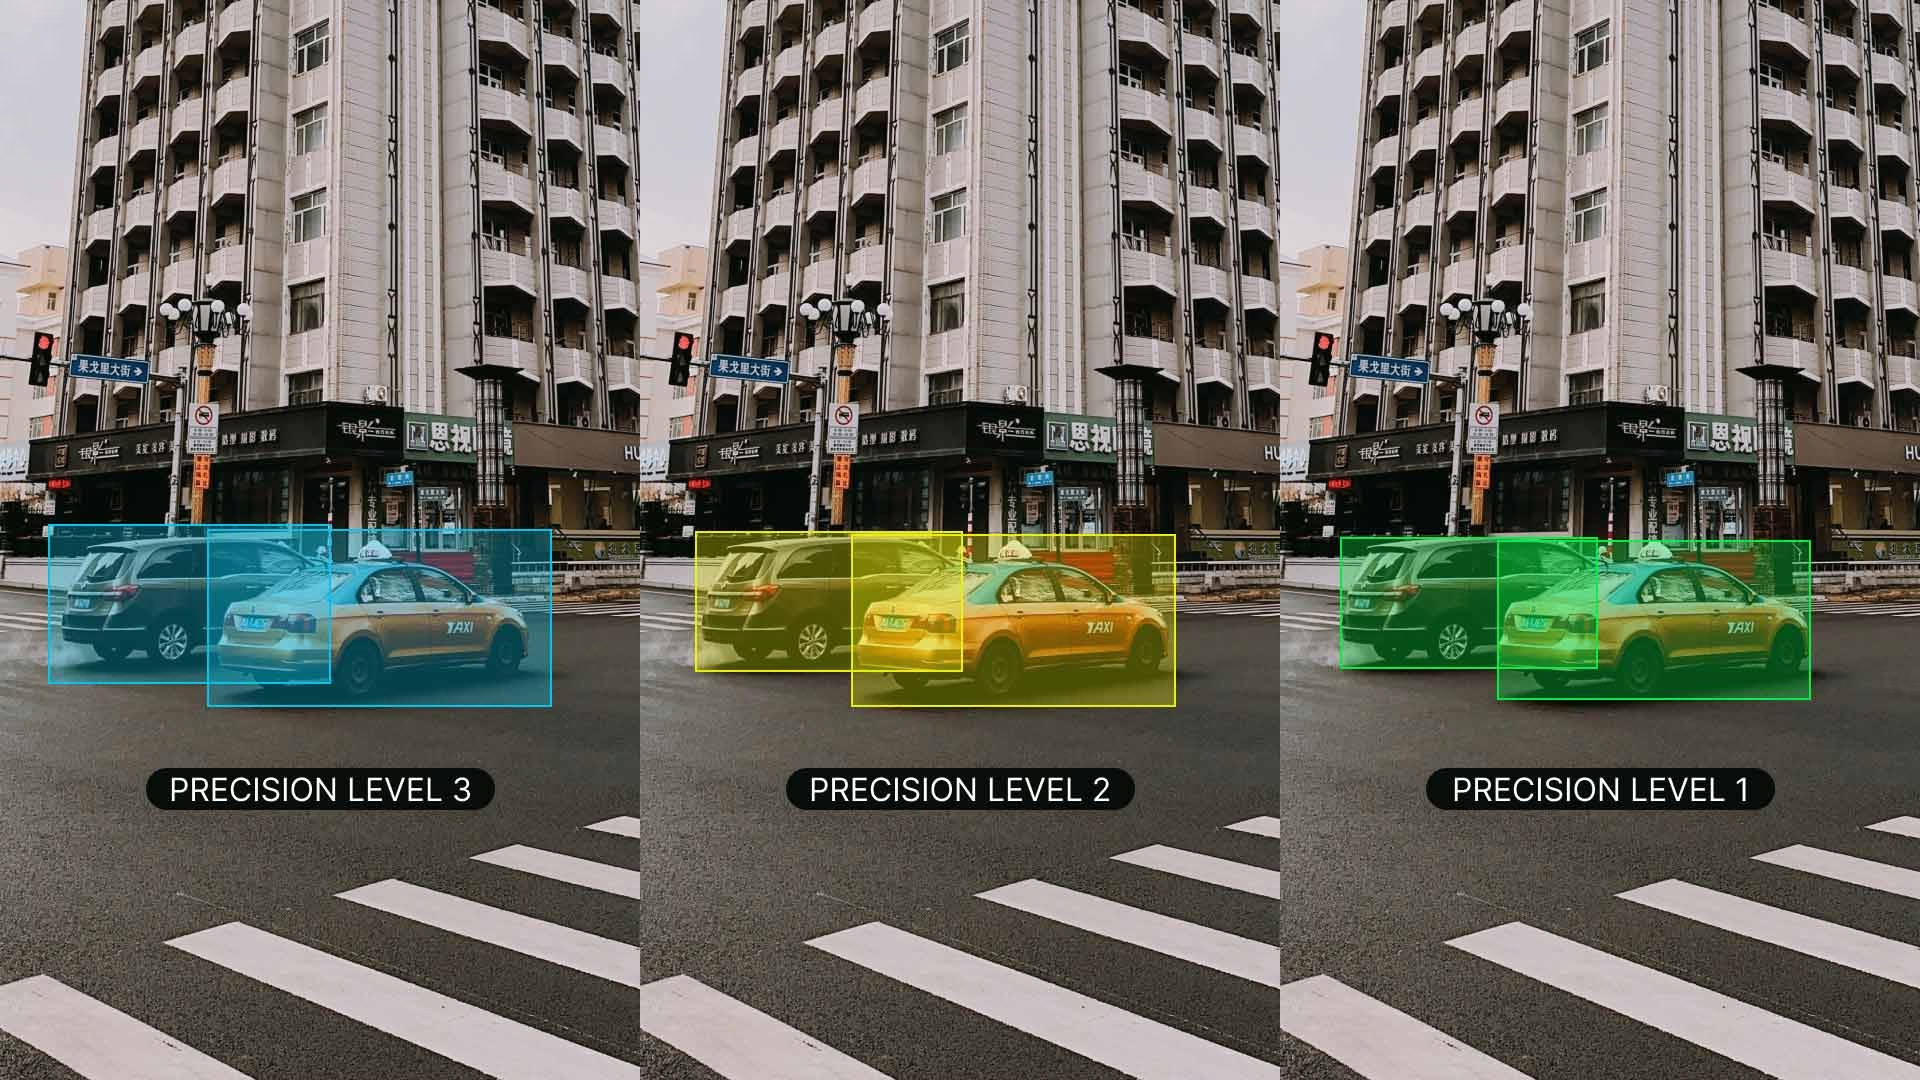
È importante comprendere la differenza tra accuratezza e precisione e il loro rapporto con l'annotazione. L'accuratezza indica quanto i dati annotati sono vicini ai valori reali. Ci aiuta a misurare quanto le etichette riflettano gli scenari del mondo reale. La precisione indica la coerenza delle annotazioni. Verifica se assegni la stessa etichetta allo stesso oggetto o alla stessa caratteristica in tutto il dataset. Un'elevata accuratezza e precisione contribuisce a ottenere modelli meglio addestrati, riducendo il rumore e migliorando la capacità del modello di generalizzare dai dati di addestramento.
Individuare i valori anomali#
I valori anomali sono punti dati che si discostano notevolmente dalle altre osservazioni del dataset. Nel contesto delle annotazioni, un valore anomalo potrebbe essere un'immagine etichettata in modo errato o un'annotazione che non è coerente con il resto del dataset. I valori anomali sono problematici perché possono distorcere il processo di apprendimento del modello, portando a previsioni imprecise e a una scarsa capacità di generalizzazione.
Puoi usare diversi metodi per individuare e correggere i valori anomali:
- Tecniche statistiche: per individuare valori anomali in caratteristiche numeriche come i valori dei pixel, le coordinate delle bounding box o le dimensioni degli oggetti, puoi usare metodi come i diagrammi a scatola, gli istogrammi o gli z-score.
- Tecniche visive: per individuare anomalie in caratteristiche categoriali come classi, colori o forme degli oggetti, usa metodi visivi come la visualizzazione di immagini, etichette o mappe di calore.
- Metodi algoritmici: usa strumenti come il clustering (ad es. clustering K-means, DBSCAN) e gli algoritmi di rilevamento delle anomalie per individuare i valori anomali in base ai modelli di distribuzione dei dati.
Controllo qualità dei dati annotati#
Come per gli altri progetti tecnici, il controllo qualità è indispensabile per i dati annotati. È buona pratica verificare regolarmente le annotazioni per assicurarsi che siano accurate e coerenti. Puoi farlo in diversi modi:
- Esaminare campioni di dati annotati
- Usare strumenti automatizzati per individuare gli errori comuni
- Chiedere a un'altra persona di ricontrollare le annotazioni
Se lavori con più persone, è importante che ci sia coerenza tra i diversi annotatori. Un buon accordo inter-annotatore significa che le linee guida sono chiare e che tutti le seguono allo stesso modo. In questo modo, tutti sono allineati e le annotazioni restano coerenti.
Durante la revisione, se trovi errori, correggili e aggiorna le linee guida per evitare che si ripetano. Fornisci riscontri agli annotatori e organizza sessioni di formazione regolari per contribuire a ridurre gli errori. Un processo efficace per gestire gli errori mantiene il dataset accurato e affidabile.
Strategie efficienti per l'etichettatura dei dati#
Per rendere il processo di etichettatura dei dati più fluido ed efficace, valuta l'implementazione di queste strategie:
- Linee guida chiare per l'annotazione: Fornisci istruzioni dettagliate con esempi per assicurarti che tutti gli annotatori interpretino le attività in modo coerente. Per esempio, quando etichetti gli uccelli, specifica se includere l'intero uccello o solo parti specifiche.
- Controlli di qualità regolari: Definisci parametri di riferimento e usa metriche specifiche per revisionare il lavoro, mantenendo standard elevati grazie a feedback continui.
- Usa strumenti di pre-annotazione: Molte piattaforme di annotazione moderne offrono funzionalità di pre-annotazione assistita dall'IA che possono velocizzare notevolmente il processo generando automaticamente annotazioni iniziali che gli operatori possono poi perfezionare.
- Implementa l'apprendimento attivo: questo approccio dà priorità all'etichettatura dei campioni più informativi, riducendo il numero totale di annotazioni necessarie e mantenendo al contempo le prestazioni del modello.
- Elaborazione in batch: Raggruppa immagini simili per l'annotazione, così da mantenere la coerenza e migliorare l'efficienza.
Queste strategie possono aiutarti a mantenere annotazioni di alta qualità riducendo il tempo e le risorse necessari per il processo di etichettatura.
Conclusione#
Raccogliere dati diversificati e imparziali e annotarli in modo coerente con gli strumenti giusti è il fondamento di un modello di visione artificiale affidabile. Una volta raccolto ed etichettato il tuo dataset, continua con la guida ai passaggi di un progetto di visione artificiale per passare all'addestramento e alla valutazione. Se hai domande, chiedi alla community nel repository GitHub di Ultralytics o nel server Discord di Ultralytics.
Domande frequenti#
Per ridurre al minimo le distorsioni, raccogli dati da fonti diverse, assicurati che tutti i gruppi pertinenti siano rappresentati in modo equilibrato (per esempio, diverse età, generi ed etnie), rivedi e aggiorna regolarmente il dataset per individuare eventuali distorsioni emergenti e applica tecniche di mitigazione come il sovracampionamento delle classi sottorappresentate, l'aumento dei dati e gli algoritmi che tengono conto dell'equità. Evitare le distorsioni in questo modo permette al tuo modello di visione artificiale di funzionare bene in scenari reali diversi e ne migliora la capacità di generalizzazione.
Definisci linee guida di etichettatura chiare e oggettive, con istruzioni dettagliate, esempi e illustrazioni, quindi applicale in modo uniforme a tutti i tipi di dati affinché ogni annotazione segua le stesse regole. Forma gli annotatori affinché mantengano la neutralità e riducano le distorsioni personali, rivedi e aggiorna regolarmente le linee guida e usa controlli automatici di coerenza e feedback tra annotatori per mantenere elevata l'accuratezza e allinearla agli obiettivi del progetto.
Qualche centinaio di oggetti annotati per classe è sufficiente per iniziare a sperimentare con l'apprendimento per trasferimento, ma per ottenere prestazioni affidabili nel mondo reale Ultralytics consiglia almeno 1.500 immagini e 10.000 istanze etichettate per classe. Abbina un dataset sufficientemente ampio a un programma di addestramento adeguato — circa 300 epoche sono un punto di partenza comune, da ridurre se il modello va rapidamente in overfitting — e assicurati che le annotazioni siano rigorose e in linea con gli obiettivi specifici del tuo progetto. Scopri strategie di addestramento dettagliate nella guida all'addestramento di YOLO26.
Sì. Ultralytics Platform include un editor di annotazioni integrato che supporta BBox, poligoni, punti chiave, riquadri orientati ed etichette di classificazione in un unico ambiente di lavoro. L'annotazione intelligente basata su SAM velocizza l'etichettatura per le attività di rilevamento, segmentazione di istanze, segmentazione semantica e OBB generando maschere con un solo clic; per i dataset di pose puoi usare i modelli di pose YOLO per l'annotazione intelligente, mentre la classificazione si annota manualmente. Le annotazioni vengono salvate nel formato previsto da ciascuna attività: righe YOLO
.txtper le attività spaziali e cartelle di classi per la classificazione, pronte per l'addestramento.Scegli il tipo di annotazione in base all'attività che intendi addestrare. I riquadri di delimitazione sono i più rapidi da disegnare e bastano per il rilevamento di oggetti. I poligoni e le maschere richiedono molto più tempo per oggetto, ma sono necessari per la segmentazione di istanze quando è importante conoscere la forma esatta di un oggetto. I punti chiave sono adatti alla stima della posa e al rilevamento dei punti di riferimento, mentre i riquadri orientati sono indicati per le attività OBB, come le immagini aeree, in cui un rettangolo allineato agli assi includerebbe troppo sfondo. Annotare i dati per l'attività più specifica di cui hai effettivamente bisogno mantiene lo sforzo di etichettatura proporzionato al risultato.


Commenti16
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
 Letícia Rama
Hello,
Has anyone worked with oriented object detection using a multisource dataset that combines satellite and UAV imagery?
I am currently developing a scientific project focused on oriented detection of fishing vessels. As part of this work, I conducted two systematic reviews: one covering existing oriented detection models and another covering publicly available datasets. So far, I have identified multisource datasets that combine imagery from multiple satellite platforms; however, I have not found datasets that explicitly integrate both satellite and UAV images.
I understand the importance of source diversity to mitigate dataset bias and improve model generalization. That said, I would appreciate insights from the community on whether combining UAV and satellite imagery might introduce excessive domain variability (e.g., differences in spatial resolution, viewing angles, and sensor characteristics), potentially hindering model training and convergence.
Any experiences, references, or best practices related to this type of multisource setup would be highly appreciated.
 Glenn JocherUltralytics
Great question—mixing UAV + satellite can increase domain shift (GSD/resolution, look-angle, sensor PSF), but it’s usually manageable if you control the dataset and evaluation: keep one unified, very explicit labeling policy (same object extent/rotation rules) and balanced sampling as described in our Data Collection and Annotation guide, then train with per-source “slice” validation (sat-only/UAV-only) and consider staged training (pretrain on the larger domain, then fine-tune on the smaller) rather than a single fully-mixed run; if you’re using Ultralytics YOLO for oriented detection, the OBB task docs cover the expected label format and training flow—feel free to share your planned split strategy and a couple example tiles (UAV + satellite) here and the team/community can sanity-check the setup.
1- Letícia Rama
Hi Glenn,
To be more specific,
I am using a pretrained yolo26 m obb to perform detection of a single class: ships of a particular type (fishing boats).
I have a dataset with satellite optical images collected from google earth pro counting 331 pairs of images/labels. The total number of instances is 5974. Images size are fixed at 4823 height x 8192 width. The bounding boxes have 0.075 height x 0.04 width (according to yolo train results). Resolution varies from very-low to very-high. The images were captured with an altitude between 200-400 meters.
I also have 21 very-high resolution images collected from UAV. Images size are fixed at 3072 height x 4096 width. The images were captured with an altitude of 120 meters.
I would like to test if incorporating UAV images in training data would improved the models hability to detect the objects.
From what you proposed, please confirm if I understood correctly:
- Should the train set be mixed (sat+UAV) and the validation set be separate (sat-only/UAV-only)?
- If so, is this separation configured the staged training you are refering? That is, pretrain with sat+UAV as the train set and sat-only as validation subset, and further fine-tune with the same train subset (sat+UAV) but now using the uav-only as the validation set?
Thanks
- Letícia Rama
OBS.: sorry, sometimes I wrote 'train subset', and 'validation subset' but all of them was supposed to be written as 'train set', and 'validation set'.
- Glenn JocherUltralytics
Your first interpretation is correct: compare a satellite-only baseline against mixed satellite+UAV training while keeping fixed, disjoint satellite-only and UAV-only evaluation sets. This is not staged training—changing only the validation set does not fine-tune the model. Staged training would first train on satellite data, then continue from that checkpoint using only the UAV training split with a lower learning rate, evaluating both domains afterward. With only 21 UAV images, split by original scene before tiling to prevent leakage, and consider grouped k-fold validation because a single UAV split will be unstable.
1 - Letícia Rama
Understood, thanks.
Sudharsanam-1
hello ! For detecting 31 Chinese symbols (16 true and 15 fake), how many classes should be used in the model? Is it more efficient to detect the true symbols using only true class , or should we also include the fake symbols as separate classes?
Team-Q-Botix
I’m working on Robocon 2026 (Kung Fu Quest) and using YOLO-seg for detecting KFS symbols — ancient Chinese oracle bone characters. There are 15 true symbols, 15 fake ones (random patterns mimicking the real ones), plus 1 “other” class → total 31 classes.
Do you think instance segmentation (YOLOv8-seg / YOLOv11-seg) is the right approach for these detailed 2D symbols, or would box detection + contour refinement be better? Also, any advice on which model to start with and how large a dataset (per class) you’d recommend for good mask performance on Jetson Orin?
robert-hardman
Hello In object recognition with YOLO11 If we label images by drawing polygons: When training, does YOLO11 convert polygon coordinates to boxes? How does Inference handle polygon coordinates?
- Glenn JocherUltralytics
@robert-hardman yOLO11 does not inherently convert polygon annotations to bounding boxes during training. Polygons are used directly for tasks like instance segmentation, while bounding boxes are utilized for object detection. During inference, polygon annotations are retained for segmentation tasks, ensuring accurate object shape representation. For more on annotation types, refer to Data Annotation Guide.
1
ghost
Hello, thanks for the info ! I would like to know how to perform active learning, specifically what are the metrics to choose the most informative images when the task is multi-instance multi-class object detection ?
 Paula DerrengerUltralytics(modificato)
@cawilchesp hello! Great question on active learning for multi-instance multi-class object detection. Active learning can significantly enhance your model by iteratively selecting the most informative samples for annotation. Here are some key metrics and strategies to consider:
Metrics for Selecting Informative Images:
-
Uncertainty Sampling: Choose images where the model is least confident. This can be measured using:
- Entropy: High entropy indicates uncertainty in predictions.
- Margin Sampling: Select samples where the difference between the top two class probabilities is smallest.
- Least Confidence: Select samples with the lowest maximum class probability.
-
Diversity Sampling: Ensure a diverse set of samples to avoid redundancy.
- Core-Set Selection: Use clustering techniques to select a diverse subset of data points.
- Representative Sampling: Choose samples that represent the overall data distribution.
-
Error-Based Sampling: Focus on samples where the model previously made errors.
- Misclassified Samples: Select images where the model's predictions were incorrect.
- High Loss Samples: Choose samples with high loss values during training.
Implementing Active Learning:
Here's a basic example using least-confidence uncertainty sampling for detection, based on each image's mean box confidence (
result.probsis only available for classification models):import numpy as np from ultralytics import YOLO # Load your model model = YOLO('yolo26n.pt') # Predict on a batch of images results = model(['image1.jpg', 'image2.jpg', 'image3.jpg']) # Mean box confidence per image (0 if nothing was detected) scores = [r.boxes.conf.mean().item() if len(r.boxes) else 0.0 for r in results] # Select the image with the lowest confidence most_informative_image = results[int(np.argmin(scores))]Additional Resources:
For more detailed strategies and examples, you can refer to our Data Collection and Annotation Strategies.
Feel free to experiment with these methods and see which works best for your specific use case. If you have any further questions or need more examples, don't hesitate to ask! 😊
-
MoAbbasid
Hello, Im looking for an open source annotation tool similar to labelme that exports directly to YOLOv8 format, something other than labelme?
- Glenn JocherUltralytics
@MoAbbasid hello! For an open-source annotation tool that exports directly to YOLOv8 format, you might want to try CVAT. It's quite versatile and supports exporting annotations directly into YOLO format among others. Another good option could be Label Studio, which offers flexibility in configuring export formats, including YOLO. Both tools provide robust features for efficient data labeling and are well-suited for various annotation tasks. Happy annotating! 😊
1 @glenn-jocher do they offer polygon annotations for instance segmentation?
- Glenn JocherUltralytics(modificato)
Hello @MoAbbasid,
Yes, Ultralytics YOLO does support polygon annotations for instance segmentation. This allows for more precise labeling of objects compared to traditional bounding boxes, which can be particularly useful for complex shapes and detailed segmentation tasks.
To create polygon annotations, you can use tools like Roboflow Annotate or CVAT. Both of these tools support polygon annotations and can export the data in a format compatible with Ultralytics YOLO.
Here's a brief overview of how you can use Roboflow for this purpose:
- Create a Project: Start by creating a new project in Roboflow.
- Upload Images: Upload your images to the project.
- Annotate Images: Use the polygon tool to draw detailed outlines around objects. Roboflow also offers a SAM-based label assistant to speed up the annotation process.
- Export Annotations: Once your annotations are complete, you can export the dataset in YOLO format.
For more detailed steps on using Roboflow for data annotation and management, you can refer to the Roboflow documentation.
Here's a quick example of how to load and use a dataset with polygon annotations:
from ultralytics import YOLO

# Load a YOLO26 segmentation model
model = YOLO('yolo26n-seg.pt')

# Train the model on your custom dataset
model.train(data='path/to/your/dataset.yaml', epochs=100, imgsz=640)

# Validate the model
metrics = model.val()

# Make predictions
results = model.predict(source='path/to/your/images')

# Visualize results
results[0].show()
Feel free to reach out if you have any more questions or need further assistance. Happy annotating! 😊
1