YOLO向けOpenVINO推論の最適化#
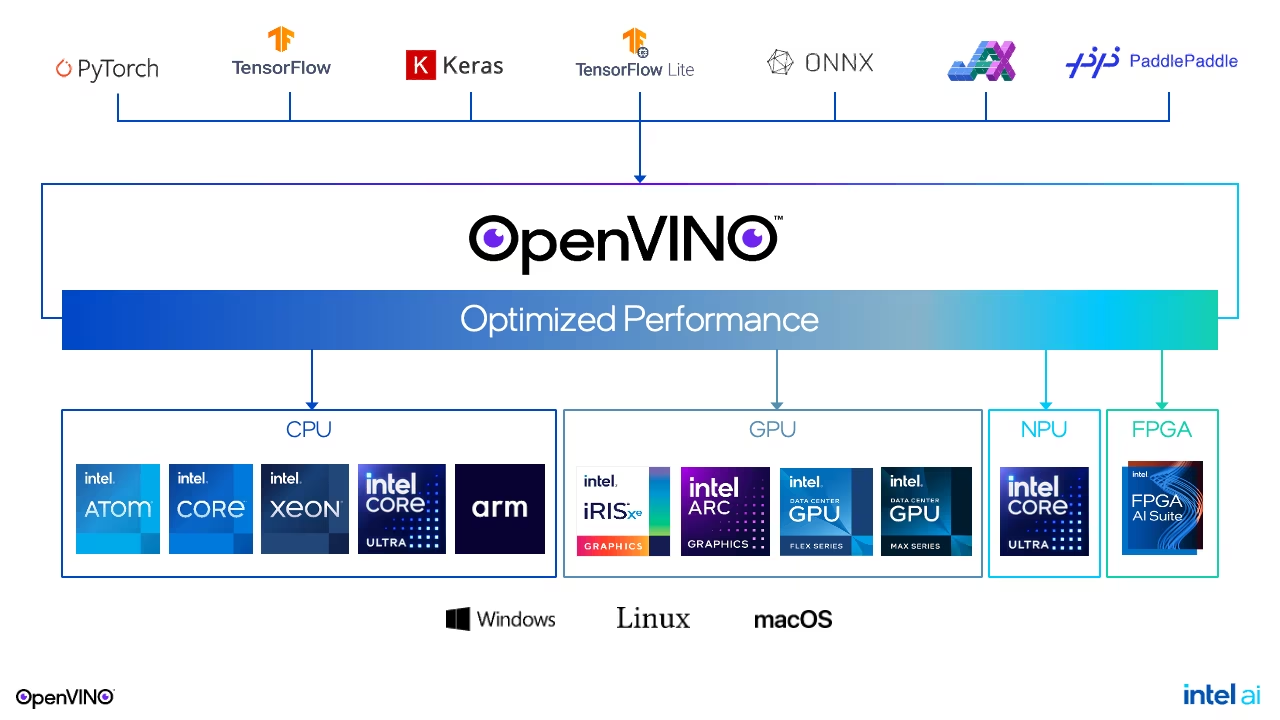
はじめに#
ディープラーニングモデル、特にUltralytics YOLOモデルのような物体検出モデルをデプロイする際は、最適なパフォーマンスを実現することが重要です。このガイドでは、IntelのOpenVINOツールキットを活用して推論を最適化する方法を、レイテンシとスループットに焦点を当てて詳しく説明します。コンシューマー向けアプリケーションでも大規模なデプロイでも、これらの最適化戦略を理解して適用することで、さまざまなデバイス上でモデルを効率的に実行できます。
レイテンシの最適化#
単一のモデルに単一の入力を与え、即時の応答が求められるアプリケーションでは、レイテンシの最適化が重要です。これはコンシューマー向けのシナリオでよく見られます。目標は、入力から推論結果が得られるまでの遅延を最小限に抑えることです。ただし、同時に推論を実行したり、複数のモデルを管理したりする場合は特に、低レイテンシの実現には慎重な検討が必要です。
レイテンシ最適化の主な戦略#
- デバイスあたりの推論を1回に制限する: 低レイテンシを実現する最も簡単な方法は、デバイスごとに一度に実行する推論を1つに制限することです。同時実行数を増やすと、レイテンシが増大することがよくあります。
- サブデバイスを活用する: マルチソケットCPUやマルチタイルGPUなどのデバイスでは、内部のサブデバイスを活用することで、レイテンシの増加を最小限に抑えながら複数のリクエストを実行できます。
- OpenVINOのパフォーマンスヒント: モデルのコンパイル時に、
ov::LATENCYをov::performance_modeプロパティに指定すると、パフォーマンス調整が簡素化され、デバイスに依存せず将来にも対応しやすい方法で最適化できます。
初回推論のレイテンシを管理する#
- モデルキャッシュ: モデルの読み込みやコンパイルにかかる時間がレイテンシに影響するのを抑えるには、可能な場合にモデルキャッシュを使用してください。キャッシュを利用できない場合、一般にCPUが最も速くモデルを読み込めます。
- モデルのマッピングと読み込み: 読み込み時間を短縮するため、OpenVINOはモデルの読み込みをマッピングに置き換えました。ただし、モデルがリムーバブルドライブまたはネットワークドライブ上にある場合は、
ov::enable_mmap(false)を使用して読み込みに戻すことを検討してください。 - AUTOデバイス選択: このモードではCPUで推論を開始し、準備ができるとアクセラレーターに切り替えるため、初回推論のレイテンシをシームレスに低減できます。
スループットの最適化#
スループットの最適化は、多数の推論リクエストを同時に処理し、個々のリクエストのパフォーマンスを大きく損なわずにリソース使用率を最大化する必要があるシナリオで重要です。
スループットを最適化する方法#
-
OpenVINOのパフォーマンスヒント: パフォーマンスヒントを使用して、デバイス間のスループットを向上させる、抽象度の高い将来にも対応しやすい方法です。
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
明示的なバッチ処理とストリーム: 明示的なバッチ処理とストリームを利用して、より詳細にパフォーマンスを調整する方法です。
スループット重視のアプリケーションを設計する#
スループットを最大化するには、アプリケーションで次の点を実施してください。
- 入力を並列に処理し、デバイスの能力を最大限に活用します。
- データフローを同時実行可能な推論リクエストに分割し、並列実行するようスケジュールします。
- コールバックを備えたAsync APIを利用して効率を維持し、デバイスが処理待ちになるのを防ぎます。
マルチデバイス実行#
OpenVINOのマルチデバイスモードでは、アプリケーション側でデバイスを管理しなくても、デバイス間で推論リクエストを自動的に分散できるため、スループットの拡張が簡単になります。
実環境でのパフォーマンス向上#
OpenVINOの最適化をUltralytics YOLOモデルに適用すると、パフォーマンスを大幅に向上できます。ベンチマークで示されているように、Intel CPUでは推論速度が最大3倍になる場合があり、内蔵GPU、専用GPU、NPUなど、Intelの幅広いハードウェアではさらに大きな高速化が期待できます。
たとえば、Intel Xeon CPUでYOLO26モデルを実行すると、OpenVINOで最適化したモデルは、精度を損なうことなく、画像あたりの推論時間でPyTorch版を一貫して上回ります。
実践的な実装#
Ultralytics YOLOモデルをOpenVINO向けにエクスポートして最適化するには、エクスポート機能を使用できます。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n.pt")

# モデルをOpenVINO形式にエクスポート
model.export(format="openvino", quantize=16)  # FP16精度でエクスポート
エクスポート後、最適化したモデルで推論を実行できます。
# OpenVINOモデルを読み込む
ov_model = YOLO("yolo26n_openvino_model/")

# 推論を実行する(UltralyticsはLATENCYパフォーマンスヒントを使用してOpenVINOモデルをコンパイルします)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)結論#
OpenVINOでUltralytics YOLOモデルを最適化してレイテンシとスループットを改善すると、アプリケーションのパフォーマンスを大幅に高められます。このガイドで説明した戦略を慎重に適用することで、開発者はさまざまなデプロイシナリオの要件を満たしながら、モデルを効率的に実行できます。レイテンシとスループットのどちらを最適化するかは、アプリケーションのニーズとデプロイ環境の特性によって異なります。
技術情報の詳細や最新情報については、OpenVINOのドキュメントとUltralytics YOLOリポジトリをご覧ください。これらのリソースには、ディープラーニングモデルを最大限に活用するための詳細なガイド、チュートリアル、コミュニティサポートが用意されています。
モデルのパフォーマンスを最適化するには、設定を調整するだけでなく、アプリケーションのニーズを理解し、情報に基づいて判断する必要があります。リアルタイム応答の最適化でも、大規模な処理のスループット最大化でも、Ultralytics YOLOモデルとOpenVINOを組み合わせることで、開発者は高性能なAIソリューションをデプロイするための強力なツールキットを利用できます。
よくある質問#
Ultralytics YOLOモデルの低レイテンシを実現するには、次のような主な戦略があります。
- デバイスあたりの推論を1回に制限する: 遅延を最小限に抑えるため、デバイスごとに一度に実行する推論を1つに制限します。
- サブデバイスを活用する: マルチソケットCPUやマルチタイルGPUなど、レイテンシの増加を最小限に抑えながら複数のリクエストを処理できるデバイスを活用します。
- OpenVINOのパフォーマンスヒント: モデルのコンパイル時にOpenVINOの
ov::LATENCYを使用すると、デバイスに依存しない簡単なチューニングが可能です。
レイテンシを最適化するための実践的なヒントについては、ガイドのレイテンシ最適化のセクションをご覧ください。
OpenVINOは、パフォーマンスを損なうことなくデバイスのリソース使用率を最大化し、Ultralytics YOLOモデルのスループットを向上させます。主なメリットは次のとおりです。
- パフォーマンスヒント: デバイス間で簡単に適用できる、抽象度の高いパフォーマンス調整です。
- 明示的なバッチ処理とストリーム: 高度なパフォーマンス調整を細かく行えます。
- マルチデバイス実行: 推論負荷を自動的に分散し、アプリケーション側での管理を簡素化します。
設定例:
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config)スループット最適化の詳細については、詳細ガイドのスループット最適化のセクションをご覧ください。
初回推論のレイテンシを削減するには、次の方法を検討してください。
- モデルキャッシュ: モデルの読み込みとコンパイルにかかる時間を短縮するため、モデルキャッシュを使用します。
- モデルのマッピングと読み込み: デフォルトではマッピング(
ov::enable_mmap(true))を使用しますが、モデルがリムーバブルドライブまたはネットワークドライブ上にある場合は、読み込み(ov::enable_mmap(false))に切り替えます。 - AUTOデバイス選択: AUTOモードを使用すると、CPUで推論を開始し、アクセラレーターへシームレスに移行できます。
初回推論のレイテンシを管理するための詳細な戦略については、初回推論のレイテンシ管理のセクションをご覧ください。
レイテンシとスループットの最適化を両立するには、アプリケーションのニーズを理解する必要があります。
- レイテンシの最適化: 即時応答が必要なリアルタイムアプリケーション(例: コンシューマー向けアプリ)に適しています。
- スループットの最適化: 多数の推論を同時に実行し、リソース使用率を最大化するシナリオ(例: 大規模なデプロイ)に最適です。
OpenVINOの抽象度の高いパフォーマンスヒントとマルチデバイスモードを活用すると、適切なバランスを実現できます。具体的な要件に基づいて、適切なOpenVINOのパフォーマンスヒントを選択してください。
はい。Ultralytics YOLOモデルは汎用性が高く、さまざまなAIフレームワークと統合できます。次のような選択肢があります。
- TensorRT: NVIDIA GPU向けに最適化するには、TensorRT統合ガイドをご覧ください。
- CoreML: Appleデバイス向けの使用方法については、CoreMLエクスポート手順をご覧ください。
- LiteRT.js: WebアプリやNode.jsアプリでの使用方法については、LiteRT統合ガイドとLiteRT.js Webランタイムをご覧ください。
詳しくは、Ultralytics統合ページをご覧ください。