YOLOE: リアルタイムのオープンボキャブラリー検出とセグメンテーション
Ultralytics YOLOE(リアルタイムであらゆるものを認識)は、オープンボキャブラリーの検出およびインスタンスセグメンテーションモデルです。トレーニング時に固定されたクラスリストを使う代わりに、推論時にテキストプロンプト、視覚的な例、または組み込みの4,585件の名称を含む語彙を使って、対象カテゴリを指定します。Ultralytics YOLOアーキテクチャ(YOLOv8、YOLO11、YOLO26)を基盤とし、YOLO-Worldに着想を得たYOLOEは、クローズドセットYOLOに近い速度で高いゼロショット精度を実現します。
視聴: Ultralytics YOLOE-26(新機能)の使い方 | オープンボキャブラリーとリアルタイムであらゆるものを認識
クイックスタート#
クラスを指定して実行するだけです。YOLOE-26は、トレーニング時に一度も学習していないカテゴリについても、バウンディングボックスとインスタンスセグメンテーションマスクを返します。
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# 「double-decker bus」はCOCOのクラスではありません。YOLOEは単語だけからそれを特定します
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()最初のset_classes()の呼び出しではテキストエンコーダーがダウンロードされます。ネットワークに接続できないマシンにデプロイする前に、インストールと要件をご確認ください。
プロンプトモードの選択#
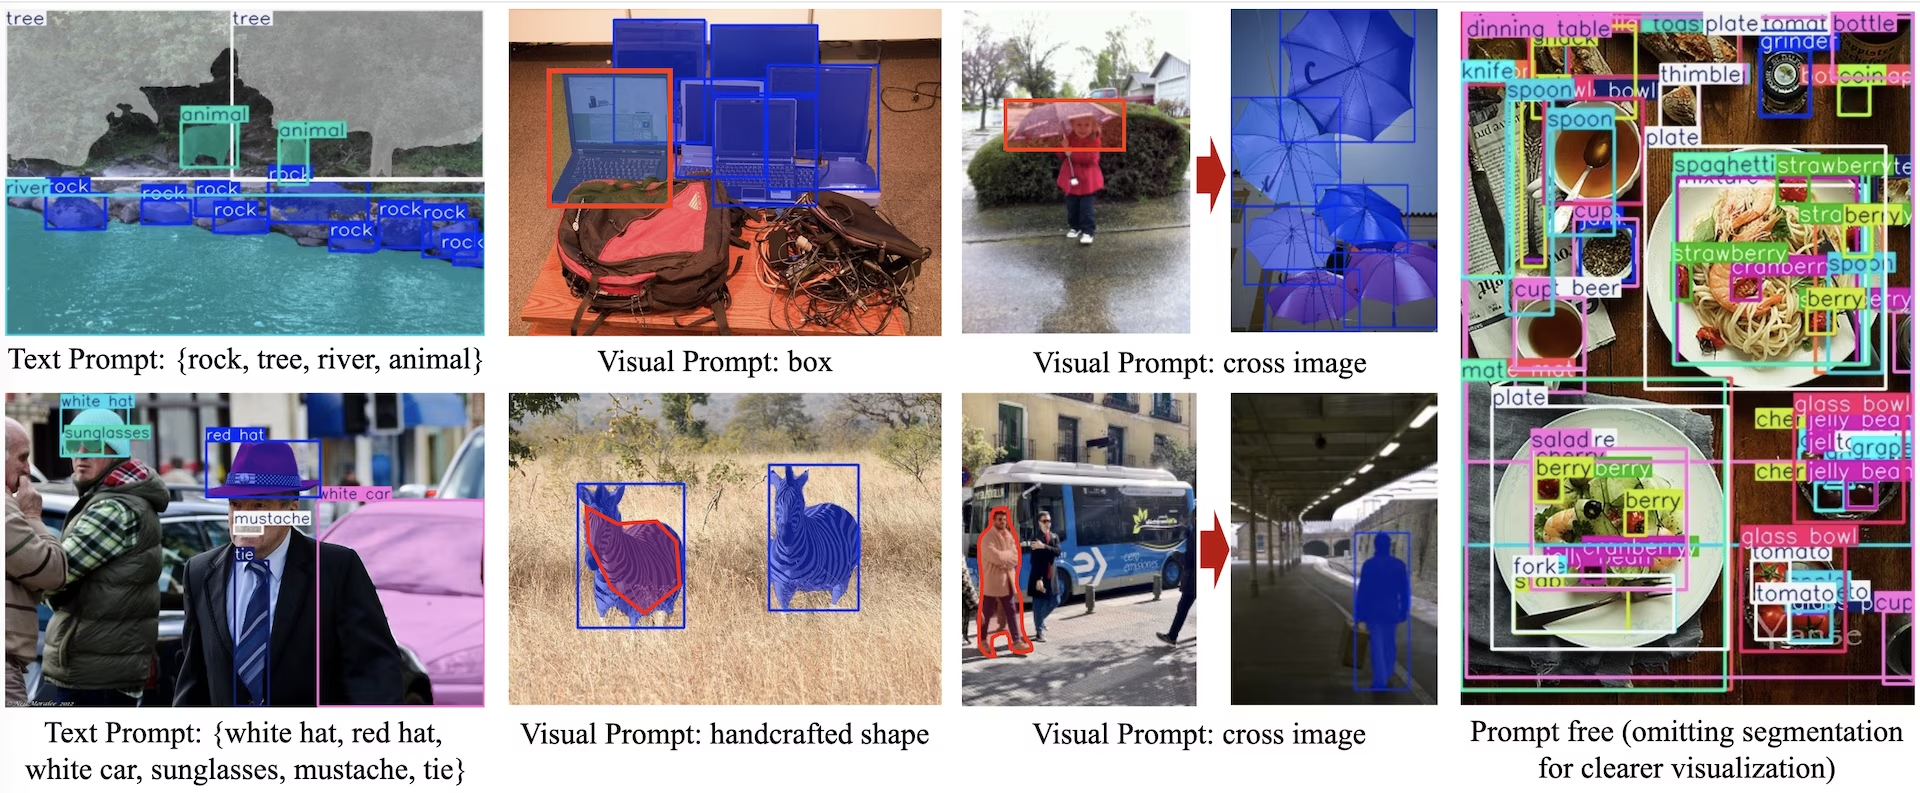
YOLOEは3つのプロンプトモードに対応しており、選択したモードによって読み込むチェックポイントとクラスラベルの形式が決まります。推論時に用意できるものに合った行を選んでください。
| モード | チェックポイント | 指定するもの | 結果に含まれるクラス名 | 使用する場面 |
|---|---|---|---|---|
| テキストプロンプト | *-seg.pt | 文字列としてのクラス名 | 指定した名前と完全に一致する名前 | 対象を言葉で説明できる場合(一般的な選択肢) |
| 視覚的プロンプト | *-seg.pt | 参照画像上のサンプルボックス | 汎用のobject0、object1、… | 特定の部位、ロゴ、欠陥など、対象を言葉で表せない場合 |
| プロンプト不要 | *-seg-pf.pt | なし | 組み込みの4,585個の名前を持つ語彙からの名前 | 事前に探すものがわからず、カタログ作成や探索を行う場合 |
- 視覚的プロンプトにラベルは引き継がれません。
visual_prompts内のクラスIDはサンプルをグループ化するためのもので、モデルはobject0、object1などとして出力します。独自の名前への対応付けは、ご自身で行ってください。 - プロンプト不要のチェックポイントは
set_classes()を受け付けません。*-seg-pf.ptモデルに対して呼び出すと、AssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.が発生します。独自のクラスが必要な場合は、代わりに*-seg.ptチェックポイントを読み込んでください。
インストールと要件#
YOLOEはUltralyticsのメインパッケージに含まれています:
pip install -U ultralyticsテキストプロンプトには、これに加えてテキストエンコーダーが必要です。テキストエンコーダーはインストール時ではなく、初回使用時に取得されます:
- 最初の
set_classes()呼び出しでは、pip(トークナイザーを提供)を使ってGitHubからultralytics/CLIPをインストールし、TorchScriptテキストエンコーダーを現在の作業ディレクトリにダウンロードします。YOLOE-26では約254 MBのmobileclip2_b.tsが、YOLOE-11とYOLOE-v8ではmobileclip_blt.tsがダウンロードされます。ダウンロードは実行するディレクトリから一度だけ行うか、ファイルをそのディレクトリにコピーしてください。そうしないと、再度ダウンロードされます。 - どちらの手順にもネットワーク接続が必要なため、オフライン環境またはネットワークから隔離されたマシンにデプロイする前に、プロンプトを使った予測を一度実行してください。
- 視覚的プロンプトとプロンプト不要のチェックポイントには、テキストエンコーダーは一切必要ありません。
YOLOE-26のチェックポイントにはultralytics8.4.0以降が必要です。YOLOE-11とYOLOE-v8の各モデルは、それ以前のリリースでも利用できます。テキストプロンプトを使った予測を一度実行すれば、チェックポイントのダウンロード、CLIPのインストール、テキストエンコーダー、推論という一連の処理を実行できます:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"推論時のテキストエンコーダーのダウンロードを完全に省くには、プロンプトを一度だけ重みに組み込み、再利用してください。詳しくはプロンプト埋め込みの再利用をご覧ください。
アーキテクチャの概要#

YOLOEは、特徴抽出用の畳み込みバックボーン、マルチスケール融合用のネック、クラスとボックスを予測するアンカーフリーの分離型ヘッドという標準的なYOLO構造を維持し、各プロンプトモードに対応する3つのモジュールを追加しています:
- 再パラメーター化可能な領域・テキストアライメント(RepRTA)は、小規模な補助ネットワークを通じてCLIPのテキスト埋め込みを調整します。このネットワークは
set_classes()の呼び出しごとに1回実行され、エクスポート時に折りたたまれるため、フレームごとの追加コストはありません。各フォワードパスで実行されるのは、保存されたプロンプト埋め込みと領域特徴量の比較です。大規模なプロンプトセットで発生するコストについては、制限事項を参照してください。 - セマンティック活性化型視覚プロンプトエンコーダー(SAVPE)は、サンプルボックスからセマンティック特徴と活性化特徴をエンコードし、それに似た外観の物体に合わせてモデルを条件付けます。ロゴや特定の部位など、名前を付けにくい対象に適したワンショット方式です。
- 遅延領域・プロンプト対比(LRPC)は、領域埋め込みを組み込みの4,585個の名前を持つ語彙と照合するため、プロンプト不要のチェックポイントは外部プロンプトもテキストエンコーダーも使わずに物体を認識できます。
インスタンスセグメンテーションは、YOLOv8-Segと同様に検出ヘッドのマスクブランチで実現され、各予測はresults[0].masks上にマスクを保持します。モデルをエクスポートすると、オープンワールドモジュールは標準のYOLOヘッドに再パラメーター化されるため、エクスポートしたファイルでは通常の検出・セグメンテーション処理が実行されます。
利用可能なモデル#
以下のすべてのチェックポイントはインスタンスセグメンテーションモデルであり、検証、予測、エクスポート、追跡をサポートしています。テキストまたは視覚プロンプトには*-seg.ptファイルを、プロンプト不要の推論には*-seg-pf.ptファイルを読み込んでください。両者は互換性がありません。詳細はプロンプト方式の選択を参照してください。*-seg.ptファイルのみがトレーニングをサポートします。プロンプト不要のチェックポイントは、トレーニング済みのテキストプロンプトモデルから生成されます。詳細は公式モデルをスクラッチからトレーニングするを参照してください。
| モデル | テキスト/視覚的プロンプト | プロンプト不要 |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
YOLOEのLVISでの性能#
640ピクセルでのLVIS minivalにおけるゼロショットの結果です。Ultralytics YOLO26の論文に基づいています。
テキストプロンプトと視覚的プロンプト#
精度とパラメーターの各セルはテキストプロンプト/視覚的プロンプトの順で示し、FLOPsは1つの値で示します。パラメーター数とFLOPsは、論文で評価された検出構成の値です。精度は論文のNon-E2E値です。比較対象のすべてのモデルについて論文が報告しているプロトコルはこれだけです。YOLOE-26のエンドツーエンドヘッドは、テキストプロンプトで最大1.1 AP、視覚的プロンプトで最大2.6 AP、この値を下回ります。
| モデル | mAP50-95 | mAPr | mAPc | mAPf | パラメーター (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
プロンプト不要#
プロンプト不要のチェックポイントはプロンプトを指定せず、組み込みの語彙を使って応答します。各精度セルは、論文でYOLOE-26の評価に用いられた2つのプロトコル、エンドツーエンド/Non-E2Eの順で示します。YOLO26のページではNon-E2E列の値を掲載しています。
| モデル | mAP50-95 | mAPr | mAPc | mAPf | パラメーター (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
テキストプロンプトとビジュアルプロンプトの両方で、YOLOE-26モデルは、対応するすべてのスケールにおいてmAP50-95でYOLOE-11およびYOLOE-v8の各モデルを上回り、パラメーター数とFLOPsはv8系列を下回ります。同じデータ分割で、論文ではYOLO-Worldv2が24.4(S)、32.4(M)、35.5(L)、Transformerベースの検出器はGLIP-Tが26.0、GDINO-Tが27.4、DetCLIP-Tが34.4と報告されています。各モデルのパラメーター数は155 Mから232 Mです。YOLOEの原論文では、導入されたv8スケールのモデルについて、さらに2つの結果が示されています。LVISでは、YOLOE-v8sがYOLO-Worldv2-Sを3.5 AP上回り、学習コストは3分の1、推論速度は1.4倍です。COCOに転移した場合、YOLOE-v8lはクローズドセットのYOLOv8-Lをbox APで0.6、mask APで0.4上回り、学習時間はほぼ4分の1です。
YOLO26の論文では、検出構成を評価しています。公開されている重みはセグメンテーションチェックポイントで、マスクブランチ、SAVPE、テキスト投影層が追加されているため、読み込んだyoloe-26l-seg.ptは上記の25.5 Mおよび89.0 Bではなく、35.4 Mおよび142.0 Bを報告します。どちらの場合も、FLOPsの数値には領域とテキストの類似度計算が含まれていないため、列の数値は変わらなくても、実際のコストはプロンプトセットの規模に応じて増加します。詳しくは制限事項をご覧ください。
使用例#
以下のYOLOEの例はすべてPython APIから実行できます。テキストプロンプトによる予測、検証、エクスポート、トラッキング、通常のトレーニングはCLIからも実行できます。ファインチューニングの手順ではトレーナークラスを渡し、ビジュアルプロンプティングではNumPyのプロンプト配列を渡しますが、これらに対応しているのはPython APIのみです。
トレーニングの使用方法#
リリース済みの *-seg.pt チェックポイントを、ご自身のYOLOデータセットでファインチューニングできます。手順の大部分は標準的なYOLOのトレーニング手順に沿っていますが、渡すトレーナーが異なります。YOLOEPESegTrainer はクラス名をヘッドに統合してからファインチューニングするため、ご自身のラベルを使用する場合に適しています。デフォルトのトレーナーでは、ご自身のクラス名を対象にトレーニングされません。こうして得られるチェックポイントは、データセットのクラスを直接予測します。ヘッドはプロンプトを読み取らなくなるため、クラスが変更されると set_classes() はエラーを発生させ、ビジュアルプロンプトも同様にエラーになります。他のクラスを使う場合は、元のチェックポイントにプロンプトを指定してください。
視聴: 車部品セグメンテーションデータセットでYOLOEをトレーニングする方法 | オープンボキャブラリーモデル、予測、エクスポート
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- 重要: デフォルトではなく、ファインチューニング用トレーナーを使います
)公開済みのチェックポイントはすべてセグメンテーションモデルです。検出器を学習するには、対応するYAMLからモデルを構築し、同じスケールのセグメンテーション重みを読み込んで、検出用トレーナーに切り替えます。それ以外は変更ありません。
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)予測の使用方法#
テキストプロンプトを使った呼び出しは、クイックスタートに示されています。ビジュアルプロンプティングでは visual_prompts 引数を追加し、プロンプトなしの予測では代わりに -pf チェックポイントを読み込みます。
ビジュアルプロンプトでは、対象を説明する代わりに、モデルに例を提示します。visual_promptsには、例示ボックスのbboxes配列と、各ボックスに1つずつ対応するクラスIDのcls配列を渡します。IDは一時的なグループ分けであり、ラベルではありません。0から順番に割り当てる必要があり、結果は任意に指定した名前ではなく、object0、object1、…として返されます。
例示ボックスは、予測対象の画像上に配置できます。
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# 対象ごとに例示ボックスを1つずつ指定し、それぞれにクラスIDを割り当てます
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # 人物、眼鏡
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()または、別の参照画像上に配置し、その画像をrefer_imageとして渡すこともできます。この場合、bboxesとclsは、予測対象ではなく参照画像内のオブジェクトを指定します。
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # 対象画像
    refer_image="ultralytics/assets/bus.jpg",  # 例示ボックスを配置する場所
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_imageを指定するとクラスも恒久的に設定されるため、以降の呼び出しではプロンプトが不要です
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # エクスポート後もクラス設定は保持されますsourceが動画またはストリームの場合、最初のフレームが自動的にrefer_imageになります。渡したプロンプトはそのフレームに適用され、動画の残りの部分にも引き継がれます。別のフレームを選ぶには、refer_imageを明示的に渡してください。
sourceとrefer_imageはどちらも、torchテンソルを直接受け取れます。画像が既存のパイプラインから取得される場合に便利です。ボックスはテンソル固有のピクセル座標で指定してください。
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # [0, 1]の範囲の(1, 3, H, W) floatテンソル
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)複数の画像を一度に予測するには、プロンプトをさらに1段階ネストします。ソース画像ごとにbboxes配列とcls配列を1つずつ用意し、ソース画像と同じ順序にしてください。
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: 人物、眼鏡
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: 人物
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()検証の使用方法#
セグメンテーションデータセットを使って、他のモデルと同じ方法で検証を実行します。
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # または、他のサイズにはyoloe-26s/m-seg.ptを使用します

metrics = model.val(data="coco128-seg.yaml")dataには、NDJSONファイルまたはPlatformのul://データセットURIも指定できます。テキストプロンプトまたはビジュアルプロンプトが作成される前に、YOLO形式に変換されます。
同じ呼び出し方法の2つのバリエーションで、他のプロンプトモードにも対応できます。
- ビジュアルプロンプト —
model.val(data="coco128-seg.yaml", load_vp=True)はデータセット自体からカテゴリごとのビジュアル埋め込みを抽出します。別のデータセットから埋め込みを取得するにはrefer_data="coco.yaml"を追加します。別のデータセットには、まったく同じカテゴリが含まれている必要があります。 - プロンプト不要 —
*-seg-pf.ptチェックポイントを読み込み、single_cls=Trueを渡します。
エクスポートの使い方#
プロンプト埋め込みは一度保存すれば、ONNX、OpenVINO、TensorRT、CoreML、LiteRT、RKNNなどの静的エクスポートを作成するときに再利用できます。エクスポート前に、元のPyTorchモデルでNPZプロファイルを読み込みます。NPZプロファイルは追加のランタイム入力ではなく、エクスポート済みモデルもNPZファイルを必要としません。
set_classes()で設定したクラス(ビジュアルプロンプトの場合はrefer_imageで設定したクラス)は、エクスポート済みの重みに組み込まれます。エクスポート後は新しいプロンプトを受け付けなくなります。読み込んだエクスポートに対してset_classes()を呼び出したり、predict()にvisual_prompts=...を渡したりすると、エラーになります。検出クラスを変更するには、新しいプロンプトを設定して元の.ptチェックポイントから再エクスポートしてください。エクスポート済みファイルは標準的なYOLOモデルと同様に動作し、YOLOE()の代わりにYOLO()で読み込むこともできます。
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# プロファイルは元のチェックポイントに紐付けられており、後続のエクスポートでも再利用できます。
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
同じプロンプトプロファイルを使って、対応するYOLOEアーキテクチャから検出専用モデルを構成することもできます。これにより、プロンプトで指定したクラスを保持しながら、マスクブランチを取り除けます。
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)トラッキングの使用方法#
プロンプトで指定したクラスはそのままトラッキングに引き継がれるため、トラッカーが学習したことのないオブジェクトも追跡できます。
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=Trueを設定すると、フレーム間でトラックIDが安定します
for result in model.track("path/to/video.mp4", stream=True, persist=True):
print(result.boxes.id)YOLOEの比較#
YOLOEは、クローズドセット検出器と大規模なオープンボキャブラリーモデルの中間に位置します。適切な選択肢かどうかは、次の3つの比較で判断できます。
- クローズドセットのYOLOとの比較。 プロンプトを設定すると、YOLOEは通常の検出/セグメンテーションの経路で予測し、他のモデルと同様にエクスポートできます。推論時に再学習せずクラスリストを変更できる一方、ゼロショット精度は独自のクラスで学習したモデルを大きく下回ります。
- 以前のYOLOEシリーズとの比較。 YOLOE-26はYOLO26のNMSフリーなエンドツーエンドヘッドを継承し、従来の3スケール(s/m/l)に対して5スケール(n/s/m/l/x)に対応します。また、性能では、対応するすべてのスケールで従来モデルを上回ります。
- Transformerベースのオープンボキャブラリー検出器との比較。 GLIPとOWL-ViTは推論時にビジョン・ランゲージTransformerを実行します。YOLOEはプロンプトを一度だけエンコードし、その後、畳み込みヘッド内で領域特徴と比較します。
最も近い代替モデルはいずれもテキストプロンプトを受け取りますが、マスクを返すのはYOLOEとSAM 3だけです。また、3つのモデルはそれぞれ異なる問いに答えます。
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| 用途 | 名称指定クラスのリアルタイム検出とセグメンテーション | 概念セグメンテーションとプロンプト可能なトラッキング | リアルタイムのオープンボキャブラリー検出 |
| マスク | はい。*-seg.ptチェックポイントで対応 | はい | いいえ。ボックスのみ |
| ビジュアルプロンプト | はい(SAVPE) | はい | いいえ |
| プロンプト不要モード | はい。4,585個の名称を含む語彙 | いいえ | いいえ |
| 選択する状況 | スループットが必要で、クラス名を指定できる場合 | 最高レベルの概念セグメンテーションが必要で、計算コストを許容できる場合 | すでに使用中の場合 — 以下の移行に関する注意をご覧ください |
YOLO-Worldから移行する場合: APIの構成は同じです。YOLOWorldをYOLOEに置き換え、*-seg.ptチェックポイントを読み込み、set_classes()の呼び出しはそのまま使います。マスクとビジュアルプロンプトが使えるようになります。クラスが固定される点については、エクスポートに関する注意がどちらにも当てはまります。
ユースケースと応用#
オープンボキャブラリー検出により、クラスごとに再学習する手順を省けます。特に、対象リストを事前に把握できない場合に有効です。
- オープンワールド検出 — 学習時に列挙されていないオブジェクトに遭遇するロボティクスやセキュリティシステム。
- 例を使ったワンショット検出 — ビジュアルプロンプトを使うと、1つの参照ボックスから特定の部品、ロゴ、欠陥を検出できます。産業検査で役立ちます。
- ロングテールのカタログ化 — 組み込みの4,585名称の語彙は、生物多様性モニタリングや小売在庫の調査にも十分な広さがあります。
- データセットのブートストラップ — 画像にボックスとマスクを事前ラベル付けして人手で確認し、その結果を使って高速なクローズドセットモデルを学習します。
- 任意の対象のセグメンテーション — 公開済みの
*-seg.ptチェックポイントは予測ごとにマスクを返すため、医用画像処理や衛星画像解析で、別のモデルを使わずにピクセル単位の精度で出力できます。
よく使われる方法は、2つのモードを組み合わせることです。まずプロンプト不要モードで対象を検出し、次に重要なカテゴリにテキストプロンプトを使います。
制限事項#
YOLOEは、推論時にクラスを変更できる代わりに精度を犠牲にします。導入前に把握しておきたい影響は次のとおりです。
- ゼロショット精度は、独自のクラスで学習したモデルを大きく下回ります。 プロンプト対応チェックポイントのLVIS minivalにおける性能は、おおむね22~40 mAPです。独自データで学習したクローズドセットYOLOは、これらのクラスでその精度を上回ります。YOLOEは学習できないクラスをカバーするために使い、学習の代替としては使わないでください。
- 希少カテゴリは弱点です。 性能のmAPr列は、LVISの希少クラスに対する精度を示します。テキストプロンプトを使うと、すべての行で一般的なクラスや頻出クラスの列を下回ります。対象が珍しい場合は、全体のmAPではなく、この値を確認してください。
- プロンプトで指定できるのは外観であり、関係性ではありません。 検出では、領域特徴をプロンプト埋め込みと比較します。そのため、状態、文脈、比較に依存する「損傷した」「最も左にある」「運ばれているもの」といったプロンプトには、照合できる信頼性の高い手がかりがありません。一般的なカテゴリ名に近い表現を使ってください。
- プロンプトセットが大きいほどレイテンシーが増加します。 プロンプト埋め込みは一度だけ計算されますが、各フォワードパスで領域特徴と比較されます。
yoloe-26s-seg.ptを使ってCPUで測定した場合、クラス数を80から1,203に増やすとフォワードパスは約19%遅くなり、4,585名称の全語彙では約89%遅くなります。領域とテキストの類似度計算が含まれないため、報告されるFLOPsはまったく変わらず、プロファイルにも警告は表示されません。 - プロンプトを設定するまでは、クラス名は仮のものです。 読み込んだばかりの
*-seg.ptチェックポイントは、数値の名称("0"、"1"、…)を使うnc=80を返すため、ラベルを読み取る前にset_classes()を呼び出してください。プロンプト不要のチェックポイントには、語彙全体がすでに設定されています。
デプロイに関する注意#
- ハードウェア。 推論には4~8 GBのVRAMを備えたNVIDIA GPUが必要です。
nおよびsのスケールは、JetsonなどのエッジGPU、または解像度を下げたCPUでも実行できます。ファインチューニングにはGPUが1基必要です。 - NMSはデフォルトでクラス非依存です。 YOLOEは
agnostic_nms=Trueで予測します。デフォルトでは、同じクラス内だけでなく異なるクラス間でも、スコアの低い重複ボックスを抑制します。これにより、1つのオブジェクトが複数のカテゴリに一致する場合の重複を防ぎます。nms=Falseでは、YOLOE-26はIoUによる抑制を行いません。クラス非依存モードでは、1つのアンカーから複数のクラスラベルを出力する代わりに、そのアンカーで最もスコアの高いクラスを1つだけ保持します。上書きするにはagnostic_nms=Falseを渡してください。 - 視覚プロンプトのデフォルト値は
conf=0.05です。 視覚プロンプトのボックスは、スコアが示すよりも高い頻度で正解します。LVIS minivalで、あるクラスのインスタンスを1つプロンプトとして指定した場合、conf=0.25では、YOLOE-26がconf=0.05で検出する他のインスタンスの44~55%を見逃します。小売店の棚や細胞のように、ほぼ同一のオブジェクトが密集するシーンでは、より低い値が必要になる場合があります。また、nms=FalseではYOLOE-26のone-to-oneヘッドのスコアはさらに低くなり、最適な閾値は0.01付近です。それ以外の呼び出しでは、後続の呼び出しや、refer_imageで設定されたクラスを再利用する保存済み埋め込みとエクスポートを含め、conf=0.25が維持されます。上書きするには、confを渡してください。 - バッチ処理。 バッチ推論をそのまま使えます。また、同じ呼び出し内で画像ごとに異なるビジュアルプロンプトを指定できます。
公式モデルをスクラッチから学習する#
ほとんどの読者には必要ありません。Objects365、GQA、Flickr30kから公開済みのオープンボキャブラリーチェックポイントを再現する手順です。8台のRTX 4090を使い、約140万件のサンプルで学習します。独自データのファインチューニングとは関係なく、その手順は上記の学習方法で説明しています。
YOLOETrainerを継承するすべてのトレーナーはcompile=Trueを拒否します。これには、デフォルトのYOLOESegTrainerと、以下のスクラッチ学習用トレーナーがすべて含まれます。compile=False(デフォルト)を渡してください。上記で使用した2つのファインチューニング用トレーナー、YOLOEPESegTrainerとYOLOEPETrainerには、この制限はありません。
学習にはセグメントアノテーションが必要です。以下の処理済みファイルをダウンロードするか、公式チームが提供するスクリプトを使って独自に生成してください。このスクリプトはSAM 2.1を利用します。検証にはLVIS minivalを使用します。
| データセット | 種類 | サンプル数 | ボックス | 処理済みセグメントアノテーション |
|---|---|---|---|---|
| Objects365v1 | 検出 | 609k | 9621k | objects365_train_segm.json |
| GQA | グラウンディング | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | グラウンディング | 149k | 641k | final_flickr_separateGT_train_segm.json |
最初にテキストプロンプトモデルを学習し、残り2つのプロンプトモードはそのモデルを調整して作成します。
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # または、同じ構造を持つYAMLファイルへのパス
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)visual-prompt用とprompt-free用のチェックポイントは、学習済みのtext-promptモデルをベースに、それぞれ1つのモジュールを更新します。YOLOESegVPTrainerはvisual-prompt用のレシピ、YOLOEPEFreeTrainerはprompt-free用のレシピですが、どちらのクラスも単独では何も凍結しません。選択的な学習は、併せて渡すfreezeリストによって行われます。このリストにはsavpe以外のすべてのヘッド子要素(それぞれ、すべての分類タワー)が指定されます。また、prompt-freeの実行にはsingle_cls=Trueも必要です。上流のYOLOEリポジトリには、v8スケールのモデル向けの完全なレシピが用意されています。
prompt-freeの学習が完了すると、get_vocabとset_vocabを使って再パラメーター化され、推論時にpromptなしでクラス名を返すチェックポイントになります。
from ultralytics import YOLOE

# prompt-freeの実行と、その実行のベースとなったtext-promptの実行で書き込まれた重み。各
# 再実行するたびに新しいディレクトリ(train-2、train-3、...)が作成されるため、各実行で出力されたパスを使用してください。
model = YOLOE("runs/segment/train-2/weights/best.pt")  # prompt-freeの実行では、ヘッドはすでに融合されています
text_model = YOLOE("runs/segment/train/weights/best.pt")  # text-promptの実行では、ヘッドはまだ融合されていません

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # 4,585個の名前からなる語彙、または独自のリスト
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt") # 公開済みのチェックポイントを上書きしないでくださいget_vocabは、モデルのend2endフラグで選択されるブランチを返し、set_vocabはそのブランチを再パラメーター化します。公開されているYOLOE-26のファイルには、各ブランチの語彙が含まれており、これによってnmsでブランチを選択できます。text-promptモデルの別コピーから2つ目の語彙を取得すると、同じ動作を再現できます。YOLOE-11とYOLOE-v8にはブランチが1つしかないため、上記の呼び出しをそのまま使用できます。
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocabは読み込んだヘッドを融合するため、2つ目のコピーを読み込んでください
one2one_model.model.end2end = True  # NMS-freeブランチを読み込む

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))引用と謝辞#
YOLOEが研究やプロジェクトに貢献した場合は、清華大学のAo Wang、Lihao Liu、Hui Chen、Zijia Lin、Jungong Han、Guiguang Dingによる原著論文を引用してください。
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}詳細については、YOLOEの原著論文をarXivでご覧いただけます。プロジェクトのソースコードやその他のリソースは、GitHubリポジトリから入手できます。
よくある質問#
Ultralytics YOLOEには、YOLO-Worldにはない2つの機能があります。クラス名の代わりにサンプルボックスを使うvisual promptと、promptなしで組み込みの4,585個の名前から判定するprompt-freeチェックポイントです。公開されている
*-seg.ptチェックポイントでは、すべての予測にインスタンスセグメンテーションのマスクも含まれます。精度については、YOLOEの原著論文によると、YOLOE-v8sはLVISでYOLO-Worldv2-Sを3.5 AP上回り、学習コストは3分の1、推論速度は1.4倍です。移行に必要な変更は1行です。詳しくはYOLOEの比較をご覧ください。Ultralytics YOLOEは3種類のprompt方式に対応しています。text promptは、
*-seg.ptチェックポイントに文字列でクラス名を指定する方式で、一般的に使用されます。visual promptは、言葉で表しにくい対象に対して、参照画像上の1つ以上のサンプルボックスを使う方式です。prompt-free推論では、何も指定せず、組み込みの4,585個の名前から判定する別の*-seg-pf.ptチェックポイントを使用します。text promptとvisual promptでは同じチェックポイントを使用しますが、prompt-free用は別ファイルであり、set_classes()を受け付けません。詳しい比較については、Prompt方式の選択をご覧ください。まずは
yoloe-26s-seg.ptから始めてください。YOLOE-26ファミリーは同じスケールのYOLOE-11やYOLOE-v8をすべて上回り、sスケールはLVIS minivalで30 mAPを超える最小モデルです。レイテンシよりも希少カテゴリの精度を重視する場合は、m、l、またはxに切り替えてください。比較する指標は性能のmAPr列です。エッジデプロイの場合に限り、nに切り替えてください。独自のクラス名ではなく組み込みの語彙を使う場合は、同じスケールの*-seg-pf.ptファイルを読み込んでください。object0やobject1のようなラベルは、予測がvisual promptから生成されたことを示します。この場合、サンプルボックスは指定した名前を引き継がず、一時的な番号付きクラスにまとめられます。visual_prompts["cls"]で渡すクラスIDは、このグループ化にのみ使われます。モデルは割り当てたIDの順にobject0、object1などとして返すため、結果上で独自のラベルに対応付けてください。出力に独自の名前を表示するには、代わりにtext promptを使用してください。プロンプト不要のチェックポイント(
*-seg-pf.pt)は、独自の内蔵語彙に基づいてクラスを判定し、set_classes()とAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.の組み合わせを拒否します。ビジュアルプロンプトを使用するとAssertionError: Visual prompts need an unfused YOLOE model.が発生します。独自のクラスリストが必要な場合は、*-seg.ptチェックポイントを読み込んでください。プロンプトモードの選択をご覧ください。最初のtext promptを実行すると、Ultralytics YOLOEはGitHubから
pipを使用してultralytics/CLIPをインストールし、TorchScriptのテキストエンコーダーを現在の作業ディレクトリにダウンロードします。YOLOE-26の場合、サイズは約254 MBです。各モデルファミリーで必要となる正確なアセットについては、インストールと要件をご覧ください。visual promptとprompt-freeのチェックポイントでは、どちらもこれらは必要ありません。対象マシンでのダウンロードを避けるには、promptを一度設定してsave_prompt_embeddings()で保存するか、クラスを設定済みの状態でモデルをエクスポートしてください。いいえ。YOLOEはエクスポート時にpromptで指定したクラスを重みに組み込むため、読み込んだエクスポート済みモデルは
set_classes()とvisual_prompts=の両方を受け付けません。新しいpromptを設定し、元の.ptチェックポイントから再エクスポートしてください。エクスポートしたファイルは標準的なYOLOモデルとして動作し、YOLO()とYOLOE()の両方で読み込めます。


コメント60
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(編集済み)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(編集済み)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.