TT100K 데이터셋#
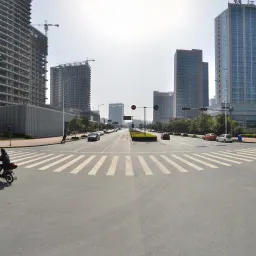
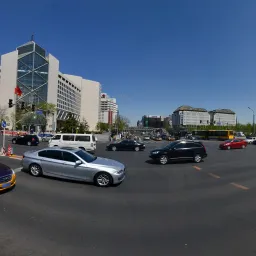
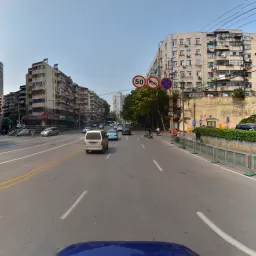
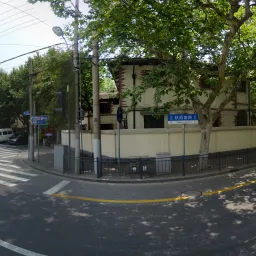
칭화-텐센트 100K(TT100K) 데이터셋은 Zhu 외 연구진이 CVPR 2016 논문 실제 환경에서의 교통 표지판 감지 및 분류를 위해 제작한 교통 표지판 객체 감지 벤치마크입니다. Ultralytics TT100K 구성에는 이미지 16,817개(학습 6,105개 / 검증 7,641개 / 테스트 3,071개)와 교통 표지판 카테고리 221개가 포함되며, 원본 벤치마크에는 표지판 인스턴스가 30,000개 이상 포함되어 있습니다. 이름의 "100K"는 벤치마크 제작에 사용된 약 100,000개의 Tencent Street View 이미지를 가리키며, 다운로드 및 학습에 사용하는 이미지 수를 의미하지 않습니다. 원 논문에서는 학습 인스턴스가 100개 이상인 카테고리만 유지하므로 흔히 사용되는 45개 클래스 하위 집합이 있지만, Ultralytics 구성에는 주석이 있는 221개 카테고리가 모두 포함되어 있습니다(그중 다수는 데이터가 희소합니다).
고해상도 스트리트 뷰 이미지에는 조명, 날씨, 시야각, 거리의 변화가 폭넓게 반영되어 있어, TT100K는 실제 주행 장면의 소형 객체 감지를 위한 까다로운 벤치마크입니다.
주요 기능#
- 다중 클래스 감지: 중국의 속도 제한, 금지, 경고, 높이/너비 제한 및 안내 표지판을 포함하는 교통 표지판 카테고리 221개입니다.
- 고해상도: 이미지 크기는 2048×2048픽셀이므로 표지판의 크기는 크게 촬영된 근접 이미지부터 미세한 세부 감지 성능을 시험하는 멀리 떨어진 작은 표지판까지 다양합니다.
- 실제 환경 조건: 날씨, 조명, 시야각 및 가림 현상이 크게 달라집니다.
- 바운딩 박스 주석: 자동 변환 후 각 표지판에 클래스와 YOLO 형식의 바운딩 박스가 지정됩니다.
- 사전 정의된 분할: 일관된 평가를 위해 학습 / 검증 / 테스트 이미지 수가 고정되어 있습니다(6,105 / 7,641 / 3,071개).
데이터셋 구조#
Ultralytics TT100K 구성은 세 가지 하위 집합으로 나뉘며, 모두 동일한 221개 카테고리를 공유합니다:
| 분할 | 이미지 | 설명 |
|---|---|---|
| 학습 | 6,105 | 감지기 학습에 사용되는 레이블이 지정된 교통 장면 이미지 |
| 검증 | 7,641 | 데이터셋의 원본 "기타" 분할로, 평가에 사용됩니다. |
| 테스트 | 3,071 | 학습된 모델의 최종 평가를 위해 분리해 둔 이미지 |
221개 카테고리는 여러 주요 그룹으로 구성됩니다:
- 속도 제한 표지판 — 금지 제한
pl*(예: pl5–pl120) 및 최저 속도pm*(예: pm5–pm55)입니다. - 금지 표지판 — 일반 금지
p1–p29, 진입 금지/주차 금지pn/pne, 제한pr*(pr10–pr100)입니다. - 경고 표지판 — 교차로, 급커브, 미끄러운 도로, 공사 구간 등의 도로 위험을 알리는
w1–w67입니다. - 높이/너비 제한 표지판 — 높이 제한
ph*(예: ph2–ph5.5) 및 너비 제한pb/pw*입니다. - 안내 표지판 — 일반 안내
i1–i15, 속도 제한 안내il*(il50–il110), 기타 안내io, 정보 보조 표지판ip입니다.
응용 분야#
TT100K는 실제 환경에서 교통 표지판 인식 시스템을 구축하고 벤치마킹하는 데 널리 사용됩니다. 일반적인 활용 분야는 다음과 같습니다:
- 자율 주행 인식 시스템
- 첨단 운전자 보조 시스템(ADAS)
- 교통 모니터링 및 도로 인프라 분석
- 도시 계획 및 교통 흐름 연구
- 고해상도 이미지의 소형 객체에 관한 컴퓨터 비전 연구
데이터셋 YAML#
TT100K.yaml 파일은 데이터셋 경로, 클래스 이름, 자동 다운로드 및 변환 스크립트를 포함한 데이터셋 구성을 정의합니다. 이 파일은 https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml의 Ultralytics 저장소에서 관리됩니다.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
tt100k2yolo(dir)사용법#
TT100K는 처음 학습할 때 자동으로 다운로드되며, 디스크 여유 공간이 약 18 GB 필요합니다. 처음 사용할 때 다운로드 스크립트가 원본 데이터를 가져와 주석을 YOLO 형식으로 변환하며, 이 작업에는 몇 분 정도 걸릴 수 있습니다.
TT100K 데이터셋에서 이미지 크기 640으로 YOLO26n 모델을 100 에폭 동안 학습하려면 다음 코드 예제를 사용할 수 있습니다. 사용 가능한 인수의 전체 목록은 모델 학습 페이지를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).

# 모델을 학습합니다 - 데이터셋은 첫 실행 시 자동으로 다운로드됩니다
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
추가 교통 표지판 이미지에 레이블을 지정하고 브라우저에서 TT100K 학습 실행을 관리하려면 Ultralytics Platform을 사용하세요.
샘플 데이터 및 어노테이션#
TT100K 이미지는 2048×2048 크기의 도로 장면으로, 교통 표지판이 프레임에서 차지하는 비율이 매우 작은 경우가 많습니다. 하나의 이미지에 크기와 거리가 서로 다른 여러 표지판이 포함될 수 있으며, 일부 표지판은 차량, 식생 또는 구조물에 가려져 있고 주간/야간 및 맑음/비 조건에서 촬영됩니다. 작은 객체와 까다로운 조건이 혼재한다는 점에서 이 데이터셋은 검출기의 강건성을 평가하기에 적합합니다.
인용 및 감사의 글#
연구 또는 개발 작업에 TT100K 데이터셋을 사용하는 경우, 다음 논문을 인용해 주세요:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
컴퓨터 비전 및 자율주행 커뮤니티를 위한 이 유용한 리소스를 만들고 유지 관리한 칭화대학교와 Tencent의 협력에 감사드립니다. TT100K 데이터셋에 대한 자세한 내용은 공식 데이터셋 웹사이트를 방문해 주세요.
자주 묻는 질문#
Tsinghua-Tencent 100K(TT100K) 데이터셋은 실제 환경에서 교통 표지판을 탐지하고 분류하는 데 사용됩니다. 221개 카테고리와 고해상도 도로 뷰 이미지로 구성되어 자율주행 인지, 첨단 운전자 보조 시스템(ADAS), 소형 객체 탐지 연구의 일반적인 벤치마크로 활용됩니다.
Ultralytics TT100K 구성에는 이미지 16,817장이 포함됩니다. 학습용 6,105장, 검증용 7,641장(데이터셋의 원래 "other" 분할), 테스트용 3,071장입니다. 전체 구성은 데이터셋 구조 섹션을 참조하세요.
"100K"는 원래 벤치마크를 만들 때 사용한 Tencent Street View 이미지 약 100,000장을 의미합니다. Ultralytics 탐지 구성은 이 가운데 YOLO 형식 레이블이 있는 이미지 16,817장을 제공합니다. 이 이름은 학습 세트의 크기가 아니라 원본 이미지 모음을 나타냅니다.
TT100K에는 제한 속도, 통행 금지, 경고, 높이/너비 제한, 안내 표지판을 아우르는 221개 카테고리가 정의되어 있습니다. 원본 논문에서는 학습 인스턴스가 100개 이상인 45개 카테고리만 사용하지만, Ultralytics 구성에는 221개 카테고리가 모두 포함됩니다. 그룹별 구성은 데이터셋 구조를 참조하세요.
TT100K의 용량은 약 18GB이며,
data="TT100K.yaml"로 처음 학습할 때 자동으로 다운로드되므로 수동으로 다운로드할 필요가 없습니다. 스크립트는 첫 실행 시 원본 어노테이션을 YOLO 형식으로 변환합니다.