Ultralytics YOLO를 사용한 데이터 증강#
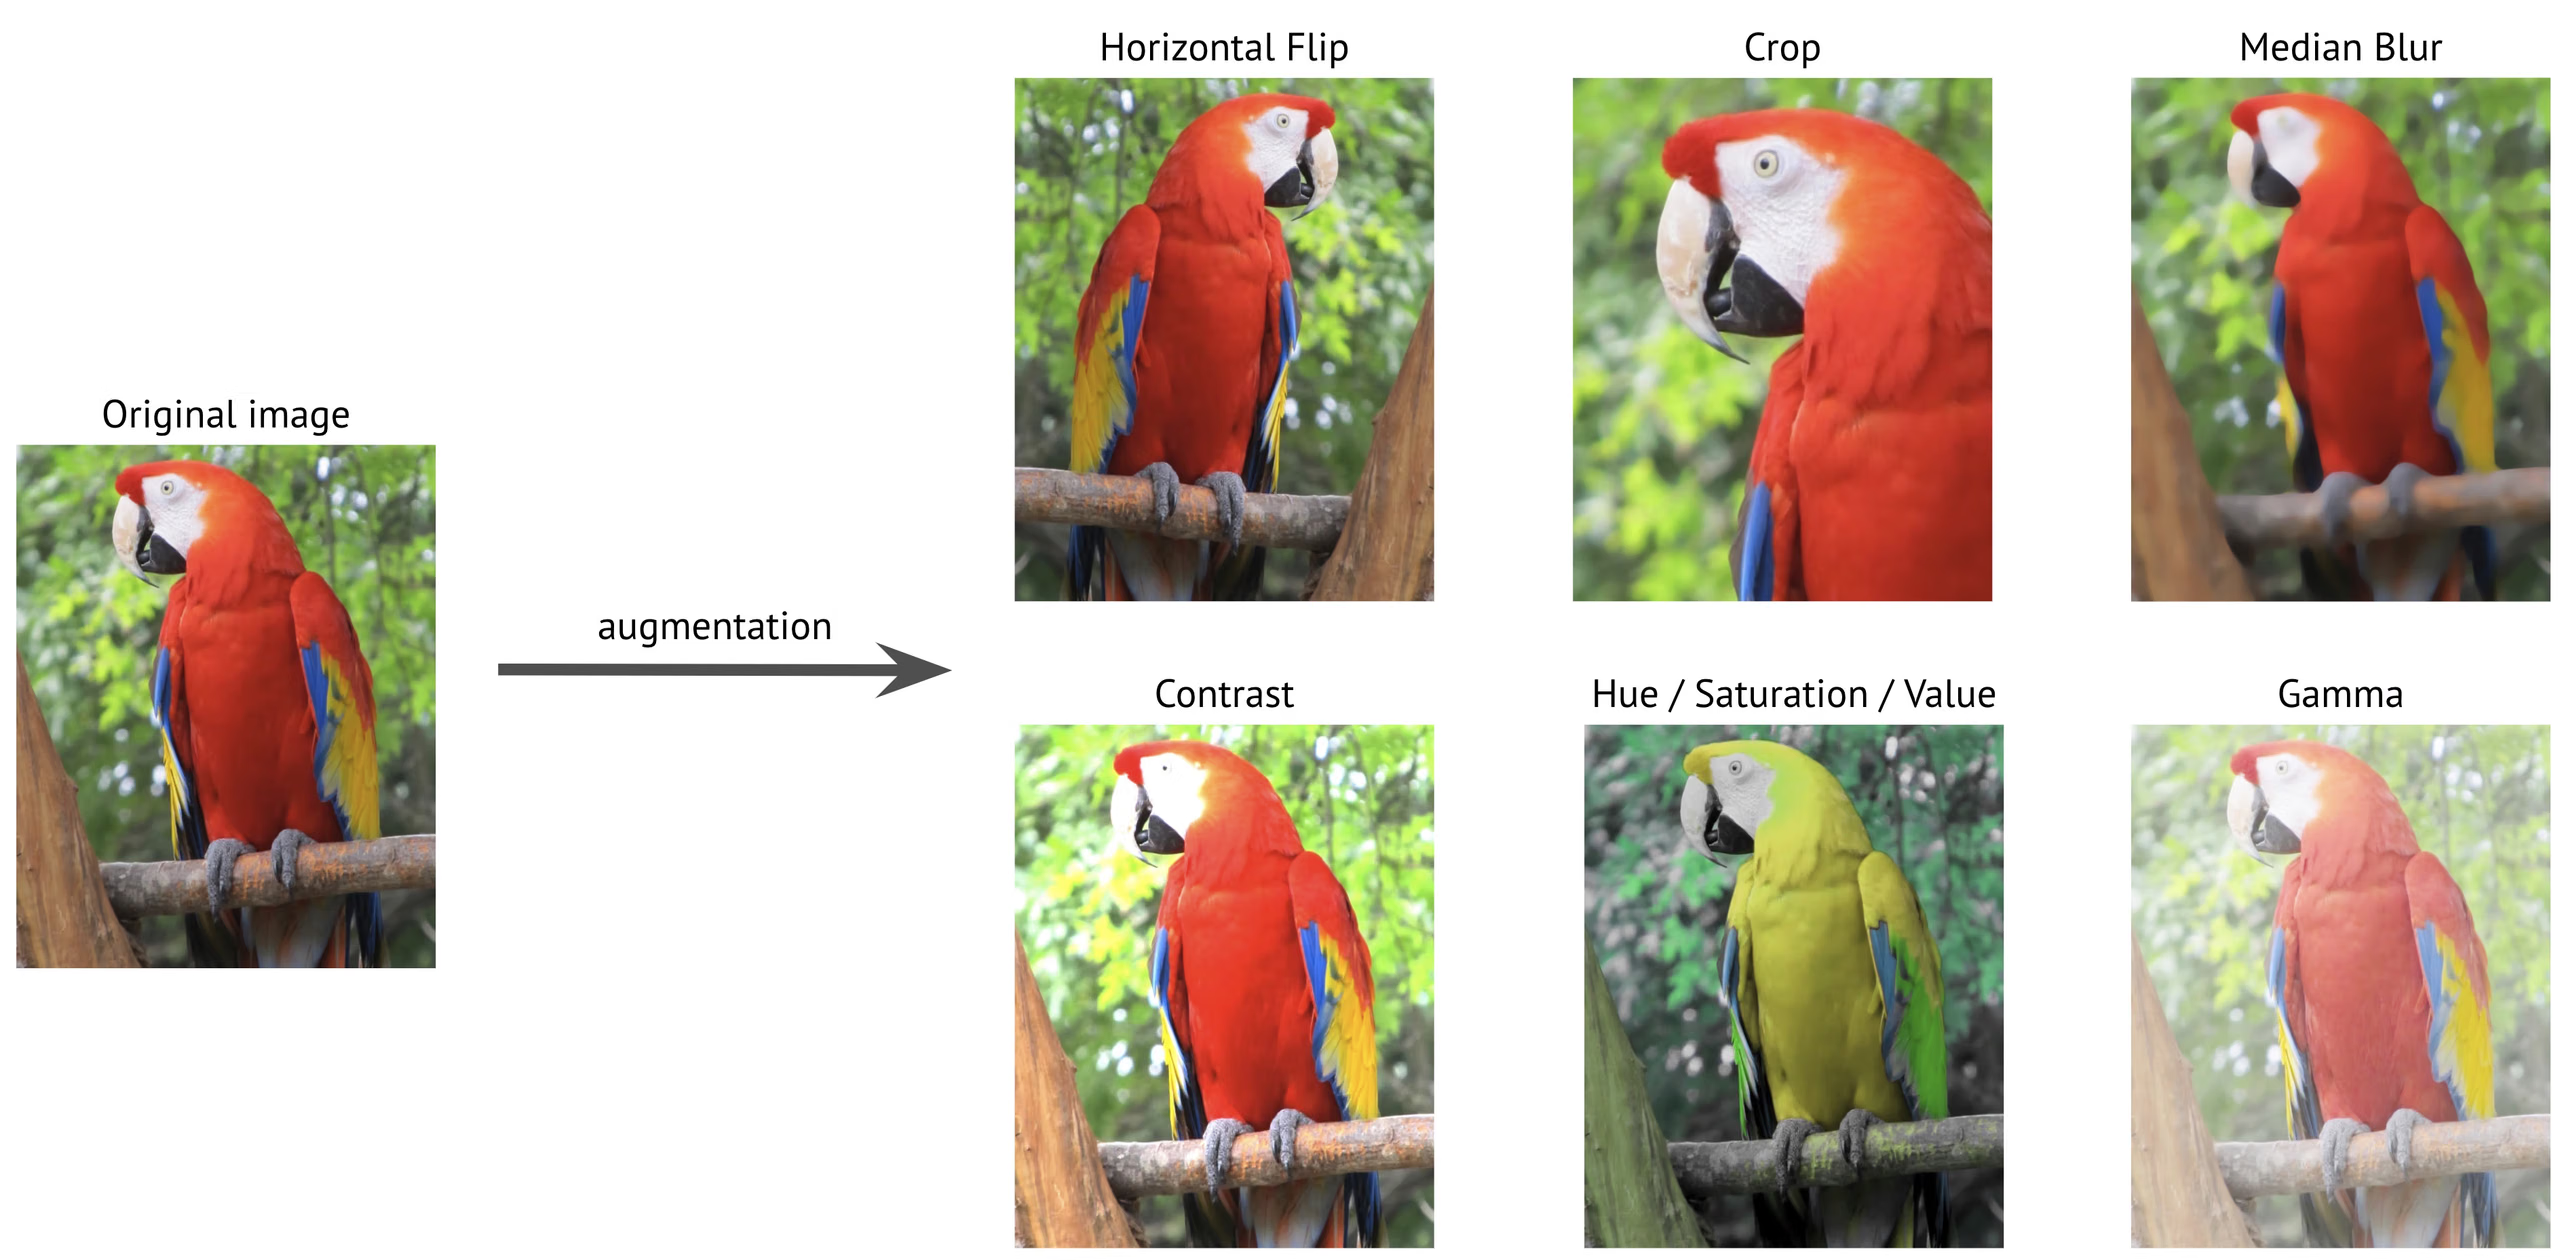
소개#
데이터 증강은 기존 이미지에 다양한 변환을 적용해 학습 데이터셋을 인위적으로 확장하는 컴퓨터 비전의 핵심 기법입니다. Ultralytics YOLO와 같은 딥러닝 모델을 학습할 때 데이터 증강은 모델의 견고성을 높이고 과적합을 줄이며 실제 환경에 대한 일반화 성능을 향상하는 데 도움이 됩니다.
시청: Ultralytics YOLO 모델의 일반화 성능을 높이는 Mosaic, MixUp 및 기타 데이터 증강 기법 사용 방법 🚀
데이터 증강이 중요한 이유#
데이터 증강은 컴퓨터 비전 모델 학습에서 몇 가지 중요한 목적을 수행합니다.
- 데이터셋 확장: 기존 이미지의 변형본을 생성하면 새로운 데이터를 수집하지 않고도 학습 데이터셋의 크기를 효과적으로 늘릴 수 있습니다.
- 일반화 성능 향상: 모델은 다양한 조건에서 객체를 인식하는 방법을 학습하므로 실제 애플리케이션에서 더욱 견고하게 작동합니다.
- 과적합 감소: 학습 데이터에 변동성을 추가하면 모델이 특정 이미지의 특성을 그대로 암기할 가능성이 줄어듭니다.
- 성능 향상: 적절한 증강을 적용해 학습한 모델은 일반적으로 검증 및 테스트 세트에서 더 높은 정확도를 달성합니다.
Ultralytics YOLO 구현은 포괄적인 증강 기법 모음을 제공하며, 각 기법은 고유한 목적을 수행하고 다양한 방식으로 모델 성능에 기여합니다. 이 가이드에서는 아래의 증강 설정을 살펴보고, 프로젝트에서 각 설정을 언제 어떻게 효과적으로 사용하는지 설명합니다.
예제 구성#
Python API, 명령줄 인터페이스(CLI) 또는 구성 파일을 사용하여 각 매개변수를 사용자 지정할 수 있습니다. 각 방법에서 데이터 증강을 설정하는 예제는 다음과 같습니다.
import albumentations as A

from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n.pt")

# 사용자 지정 증강 매개변수로 학습
model.train(data="coco8.yaml", epochs=100, hsv_h=0.03, hsv_s=0.6, hsv_v=0.5)

# 구성 가능한 모든 증강을 비활성화하여 학습(명확성을 위해 비활성화된 값은 생략)
model.train(
    data="coco8.yaml",
    epochs=100,
    hsv_h=0.0,
    hsv_s=0.0,
    hsv_v=0.0,
    translate=0.0,
    scale=0.0,
    fliplr=0.0,
    mosaic=0.0,
    erasing=0.0,
    auto_augment=None,
)

# 사용자 지정 Albumentations 변환으로 학습(Python API만 해당)
custom_transforms = [
    A.Blur(blur_limit=7, p=0.5),
    A.CLAHE(clip_limit=4.0, p=0.5),
]
model.train(data="coco8.yaml", epochs=100, augmentations=custom_transforms)이 페이지에 나열된 변환은 학습 인수를 통해 제어할 수 있는 변환입니다. Ultralytics는 albumentations 패키지가 설치되어 있으면 소규모 Albumentations 변환 세트(블러, 미디언 블러, 그레이스케일, CLAHE)를 각각 p=0.01의 확률로 적용하며, default.yaml의 어떤 인수로도 Albumentations 변환 세트를 비활성화할 수 없습니다. Albumentations 변환 세트를 제거하려면 패키지를 제거하거나, Albumentations 변환 세트를 대체할 자체 목록을 augmentations에 전달하세요.
구성 파일 사용#
증강을 비롯한 모든 학습 매개변수를 YAML 구성 파일(예: train_custom.yaml)에 정의할 수 있습니다. mode 매개변수는 CLI를 사용할 때만 필요합니다. 그런 다음 이 새 YAML 파일은 ultralytics 패키지에 있는 기본 파일을 덮어씁니다.
# train_custom.yaml
# 'mode' is required only for CLI usage
mode: train
data: coco8.yaml
model: yolo26n.pt
epochs: 100
hsv_h: 0.03
hsv_s: 0.6
hsv_v: 0.5
그런 다음 Python API로 학습을 시작합니다.
from ultralytics import YOLO

# COCO로 사전 학습된 YOLO26n 모델을 불러옵니다
model = YOLO("yolo26n.pt")

# 사용자 지정 구성으로 모델 학습
model.train(cfg="train_custom.yaml")
색 공간 증강#
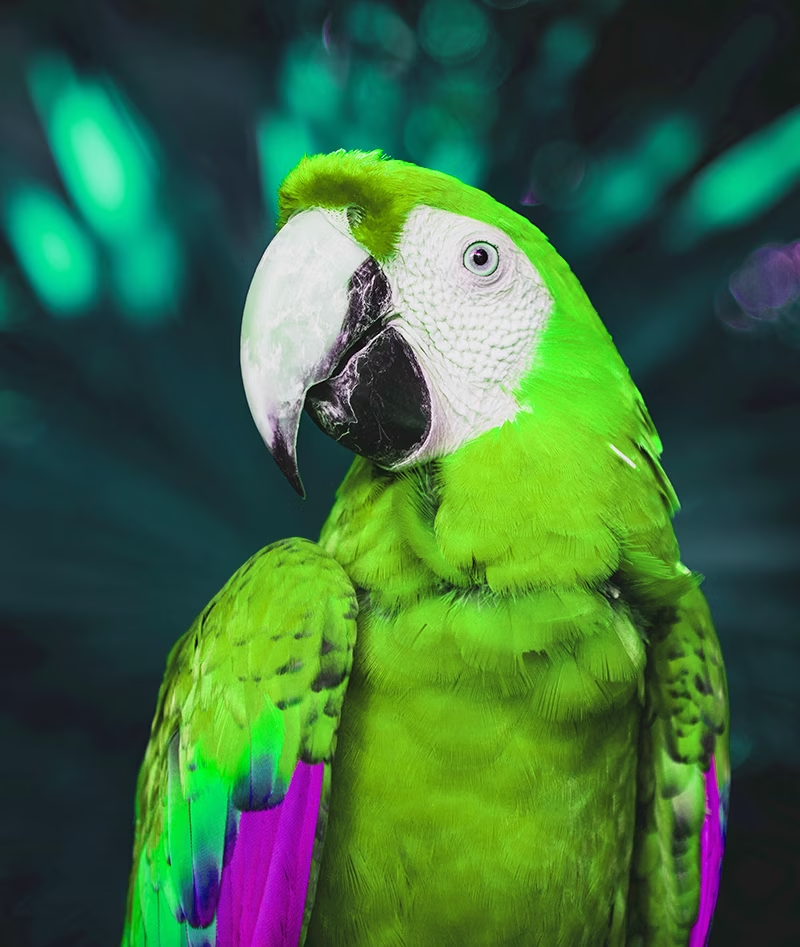
색조 조정 (hsv_h)#
- 범위:
0.0~1.0 - 기본값:
0.015 - 사용법: 색상 간의 관계를 유지하면서 이미지 색상을 이동합니다.
hsv_h하이퍼파라미터는 이동량을 정의하며, 최종 조정값은-hsv_h과hsv_h사이에서 무작위로 선택됩니다. 예를 들어hsv_h=0.3인 경우 이동값은-0.3~0.3범위에서 무작위로 선택됩니다. 값이0.5보다 크면 색조 이동이 색상환을 한 바퀴 돌아0.5과-0.5에서 증강 결과가 동일하게 나타납니다. - 목적: 조명 조건에 따라 객체의 외관이 크게 달라질 수 있는 야외 환경에서 특히 유용합니다. 예를 들어 바나나는 햇빛이 강한 곳에서는 더 노랗게 보이고 실내에서는 더 푸르게 보일 수 있습니다.
- Ultralytics 구현: RandomHSV
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
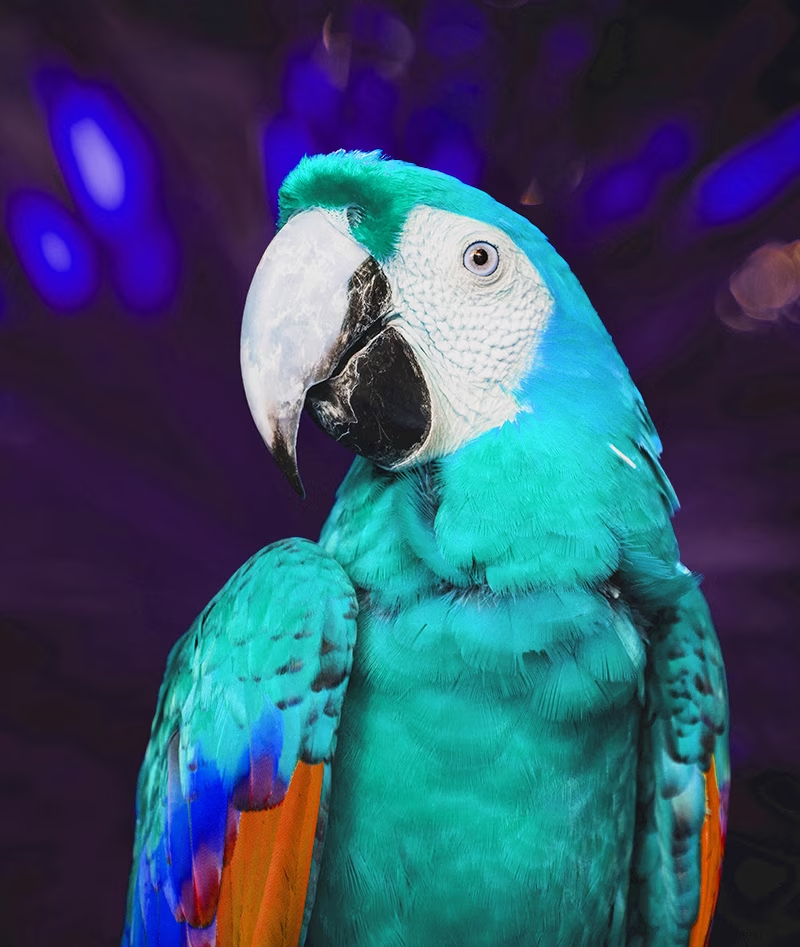 | 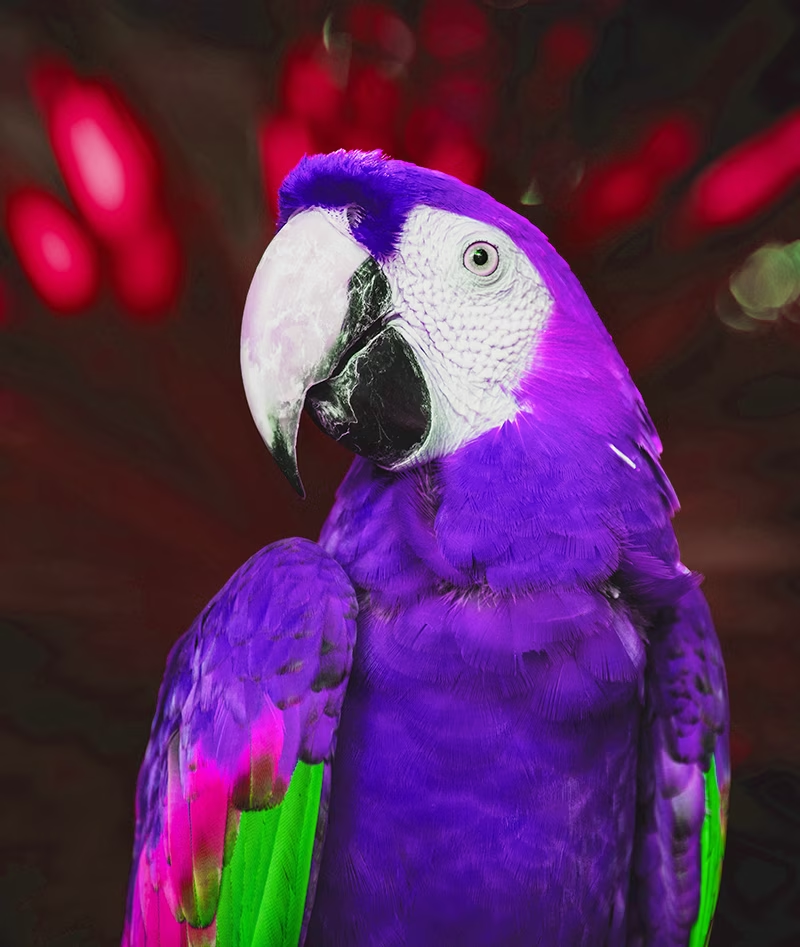 | 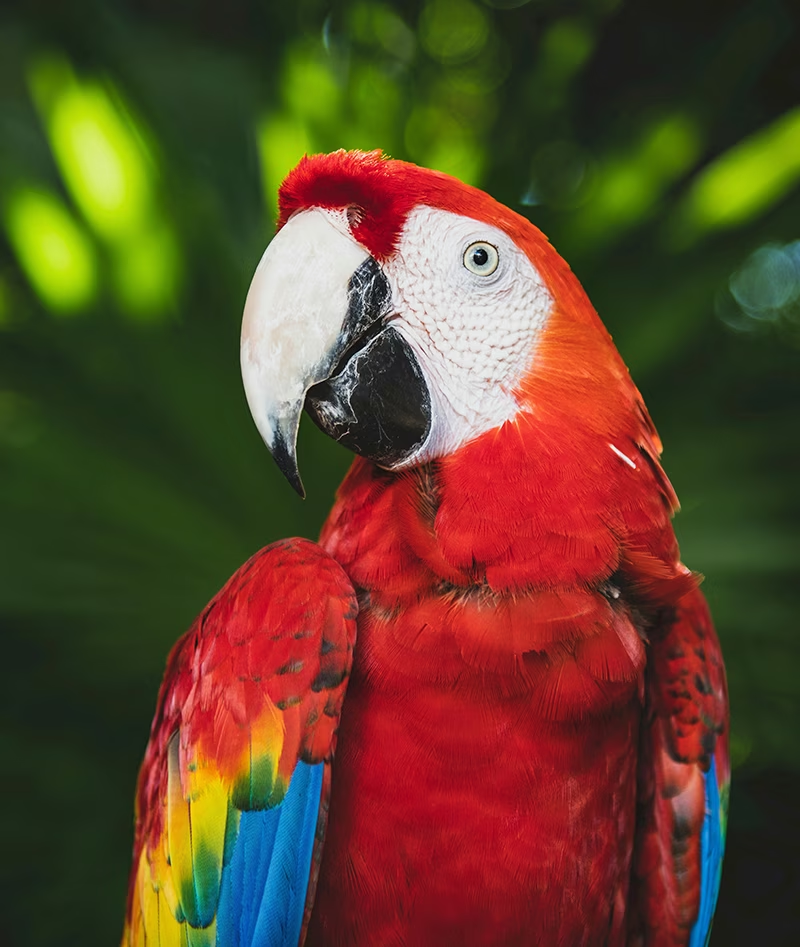 |  | |
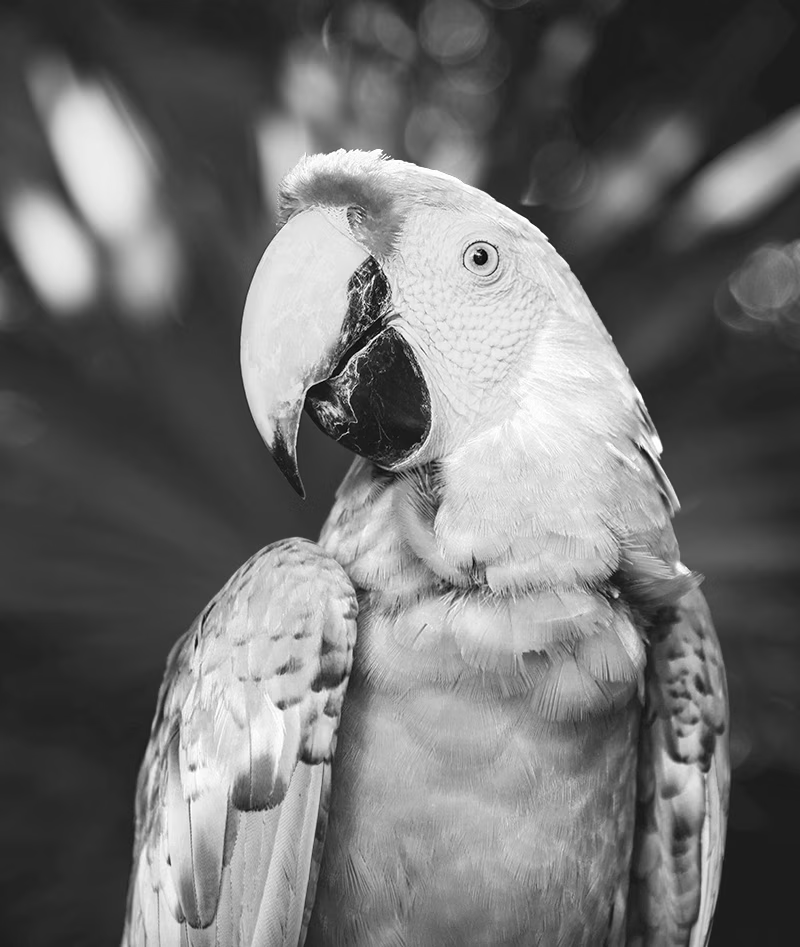
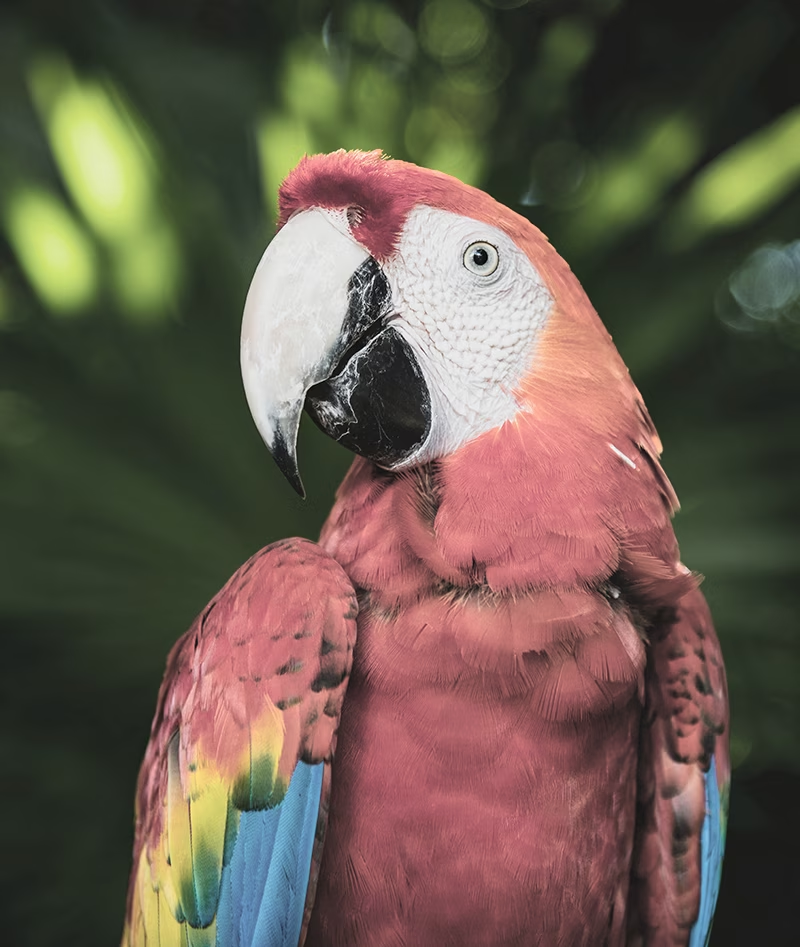
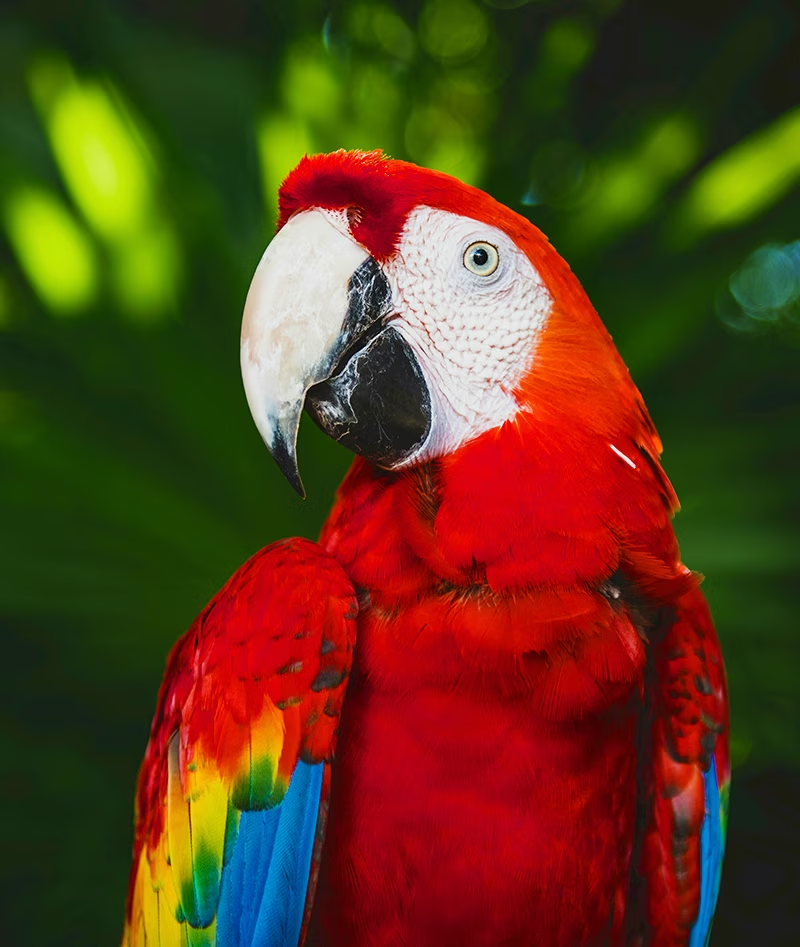
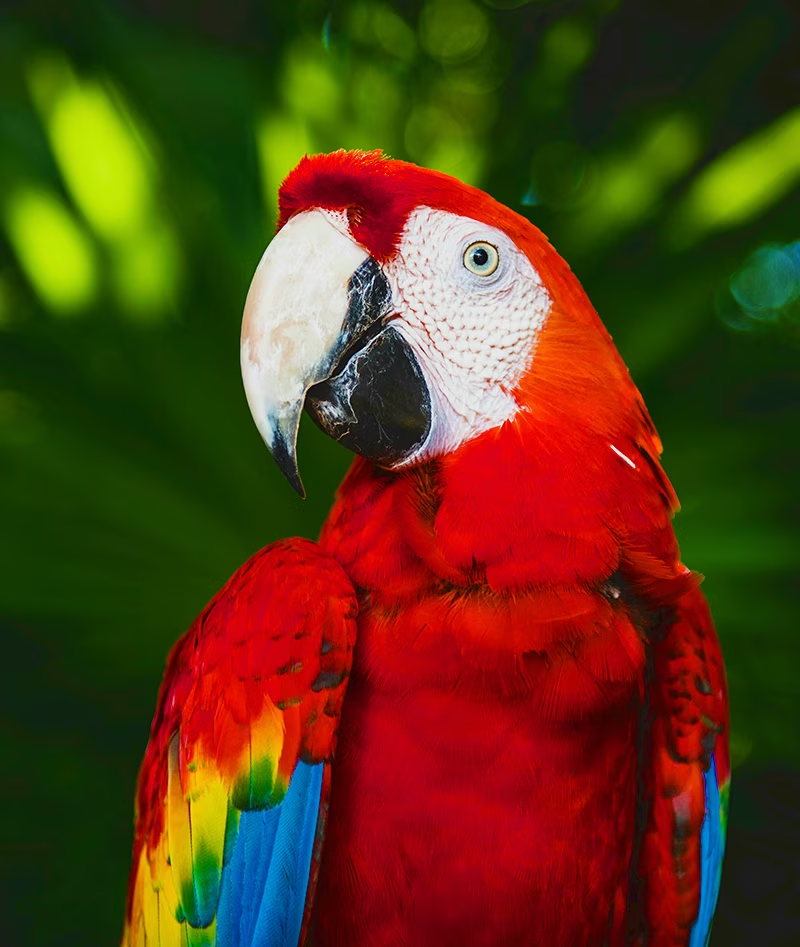
채도 조정 (hsv_s)#
- 범위:
0.0~1.0 - 기본값:
0.7 - 사용법: 이미지의 색상 강도를 조정합니다.
hsv_s하이퍼파라미터는 이동량을 정의하며, 최종 조정값은-hsv_s과hsv_s사이에서 무작위로 선택됩니다. 예를 들어hsv_s=0.7인 경우 강도는-0.7~0.7범위에서 무작위로 선택됩니다. - 목적: 다양한 기상 조건과 카메라 설정에 모델이 대응할 수 있도록 합니다. 예를 들어 빨간색 교통 표지판은 맑은 날에는 선명하게 보이지만 안개가 낀 날에는 흐릿하고 바랜 것처럼 보일 수 있습니다.
- Ultralytics 구현: RandomHSV
-1.0 | -0.5 | 0.0 | 0.5 | 1.0 |
|---|---|---|---|---|
 |  | |  |  |
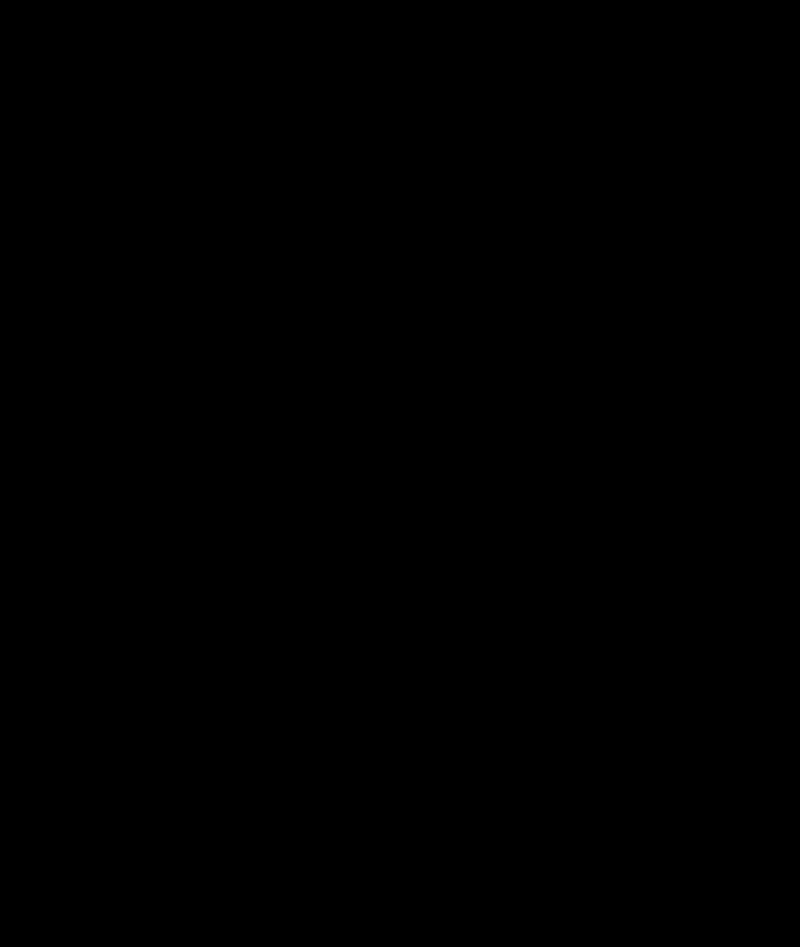
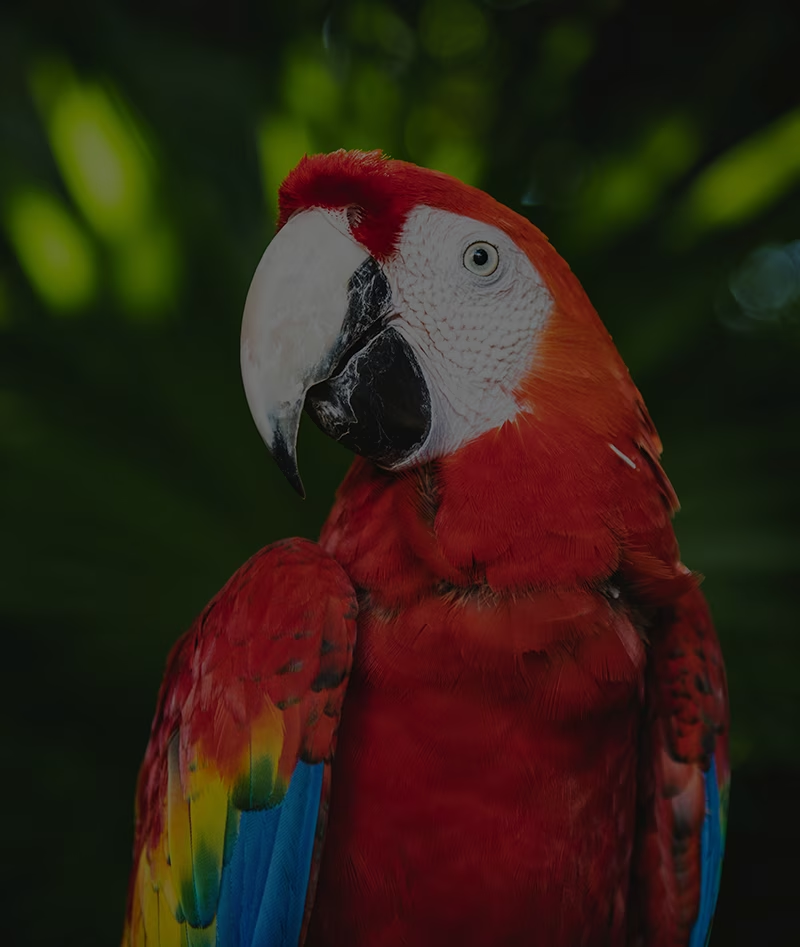
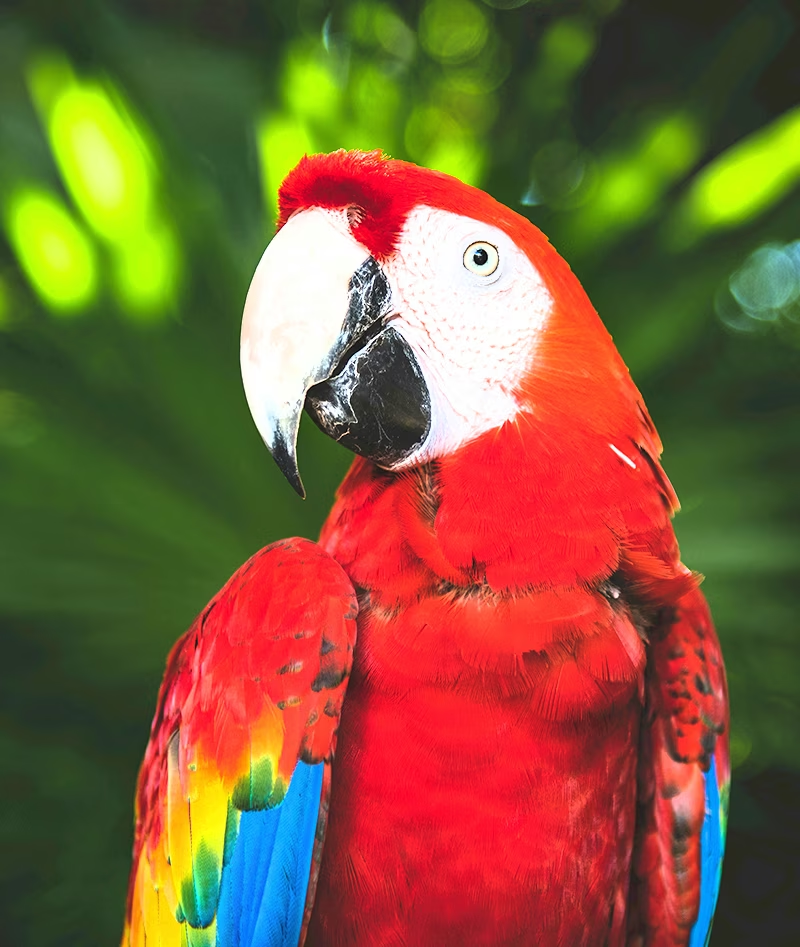
밝기 조정 (hsv_v)#
- 범위:
0.0~1.0 - 기본값:
0.4 - 사용법: 이미지의 밝기를 변경합니다.
hsv_v하이퍼파라미터는 이동량을 정의하며, 최종 조정값은-hsv_v과hsv_v사이에서 무작위로 선택됩니다. 예를 들어hsv_v=0.4인 경우 강도는-0.4~0.4범위에서 무작위로 선택됩니다. - 목적: 다양한 조명 조건에서 작동해야 하는 모델을 학습하는 데 필수적입니다. 예를 들어 빨간 사과는 햇빛 아래에서는 밝게 보이지만 그늘에서는 훨씬 어둡게 보일 수 있습니다.
- Ultralytics 구현: RandomHSV
-1.0 | -0.5 | 0.0 | 0.5 | 1.0 |
|---|---|---|---|---|
 |  | |  |  |
기하학적 변환#
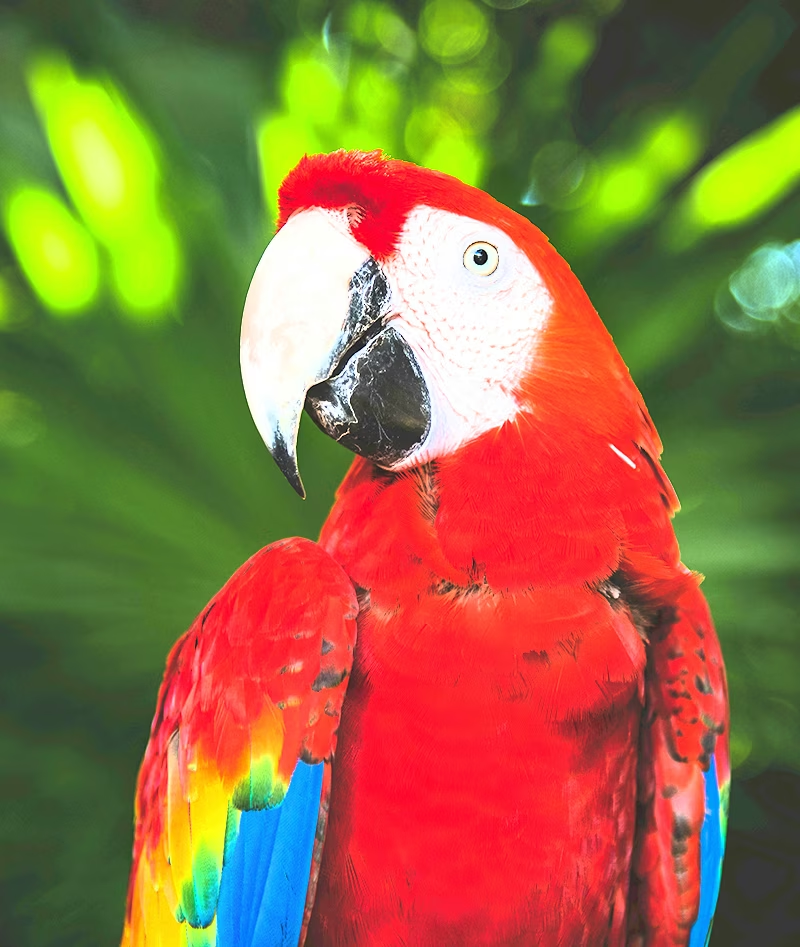
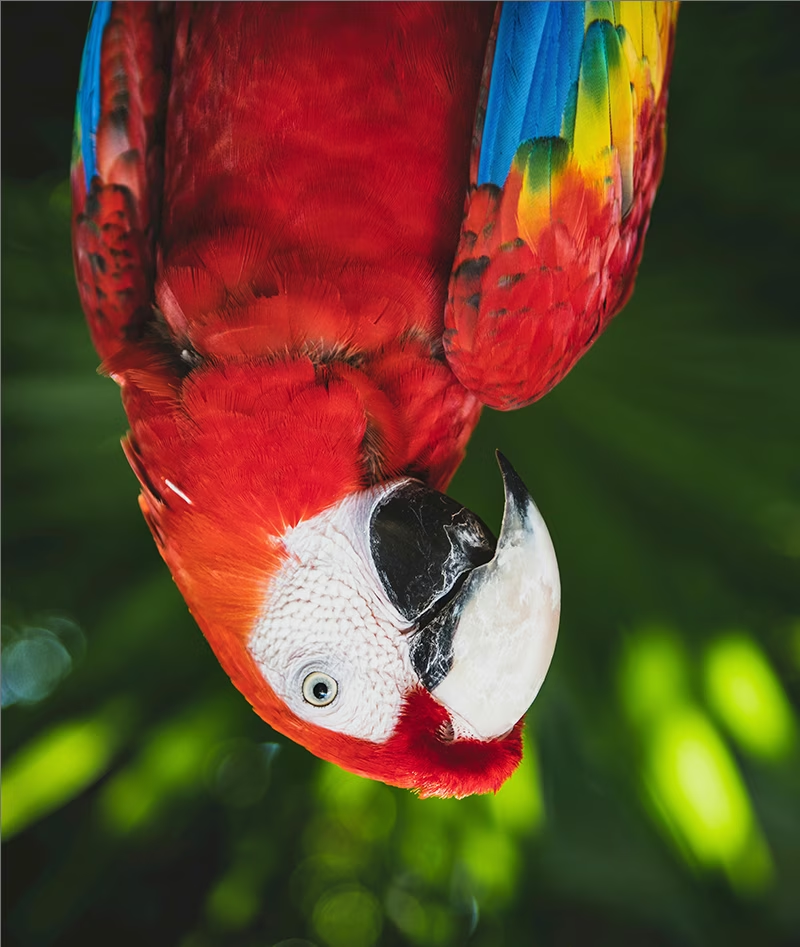
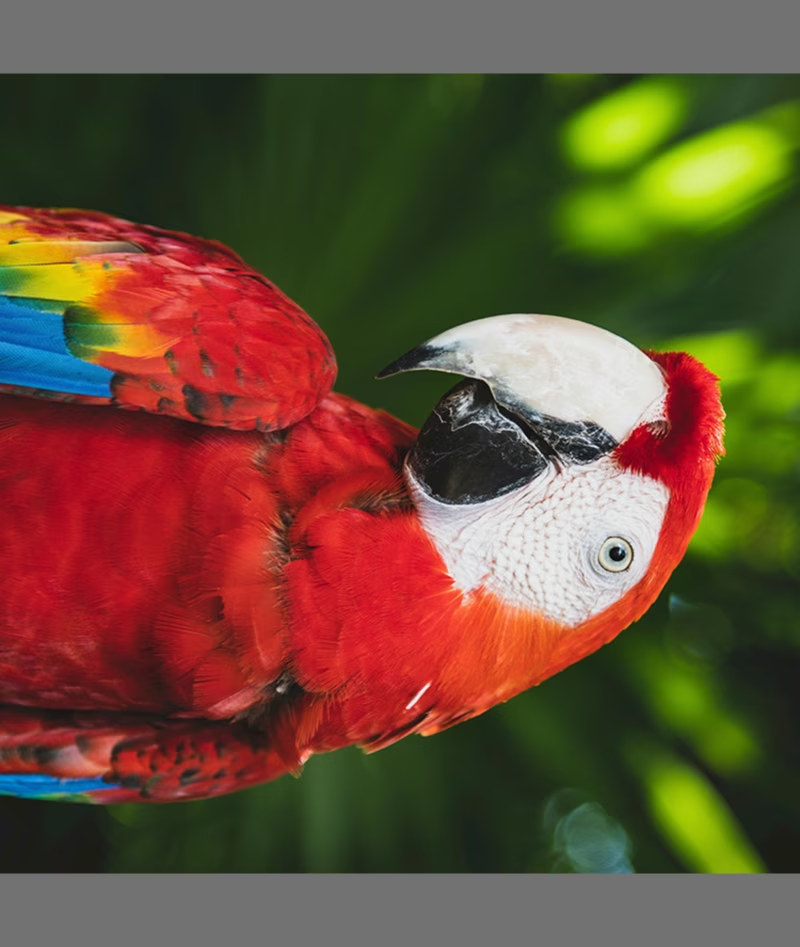
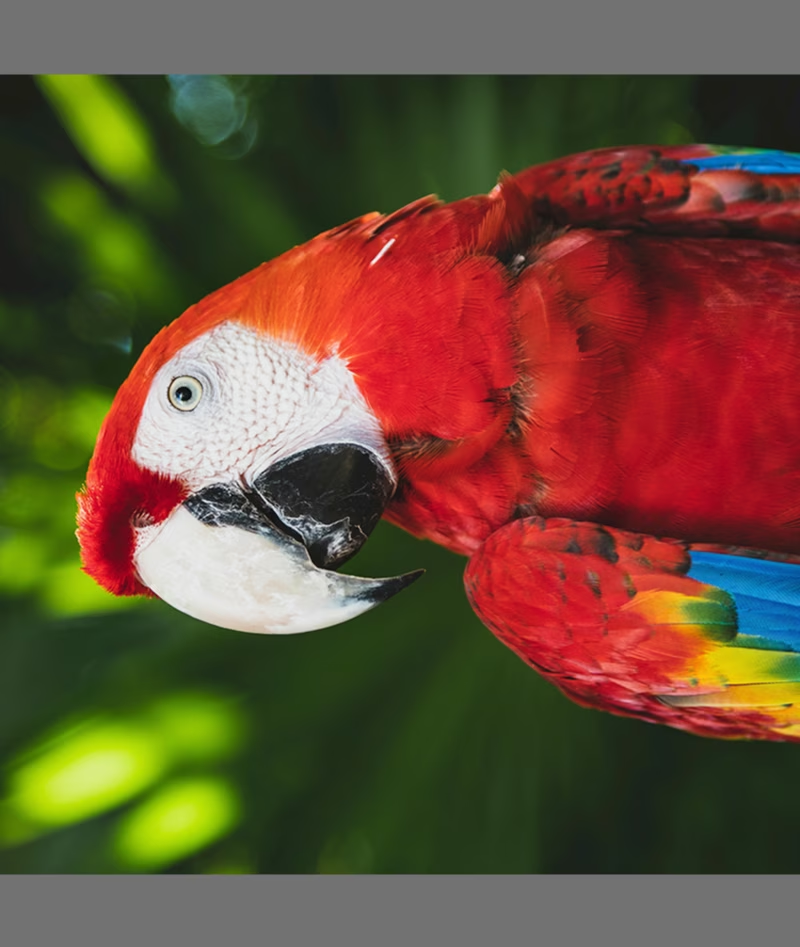
회전 (degrees)#
- 범위:
0.0~180 - 기본값:
0 - 사용법: 지정된 범위 내에서 이미지를 무작위로 회전합니다.
degrees하이퍼파라미터는 회전 각도를 정의하며, 최종 조정값은-degrees과degrees사이에서 무작위로 선택됩니다. 예를 들어degrees=10.0인 경우 회전값은-10.0~10.0범위에서 무작위로 선택됩니다. - 목적: 객체가 서로 다른 방향으로 나타날 수 있는 애플리케이션에 필수적입니다. 예를 들어 항공 드론 이미지에서는 차량의 방향이 어느 쪽이든 가능하므로, 회전 방향과 관계없이 객체를 인식하는 모델이 필요합니다.
- Ultralytics 구현: RandomPerspective
-180 | -90 | 0.0 | 90 | 180 |
|---|---|---|---|---|
 |  | |  | |
이동 (translate)#
- 범위:
0.0~1.0 - 기본값:
0.1 - 사용법: 이미지 크기에 대한 무작위 비율만큼 이미지를 가로 및 세로 방향으로 이동합니다.
translate하이퍼파라미터는 이동량을 정의하며, 최종 조정값은-translate과translate범위 내에서 두 번(각 축에 한 번씩) 무작위로 선택됩니다. 예를 들어translate=0.5인 경우 x축 이동값은-0.5~0.5범위에서 무작위로 선택되고, y축 이동값은 같은 범위에서 별도로 무작위 선택됩니다. - 목적: 모델이 부분적으로 보이는 객체를 감지하도록 학습시키고 객체 위치에 대한 견고성을 높입니다. 예를 들어 차량 손상 평가 애플리케이션에서는 촬영자의 위치와 거리에 따라 자동차 부품이 프레임에 완전히 또는 부분적으로 나타날 수 있습니다. 이동 증강을 적용하면 모델이 이러한 특징의 완전성이나 위치와 관계없이 이를 인식하도록 학습할 수 있습니다.
- Ultralytics 구현: RandomPerspective
- 참고: 간결성을 위해 아래에 적용된 이동은 매번
x및y축 모두에서 동일합니다.-1.0와1.0값은 이미지가 프레임 밖으로 완전히 이동하므로 표시하지 않았습니다.
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
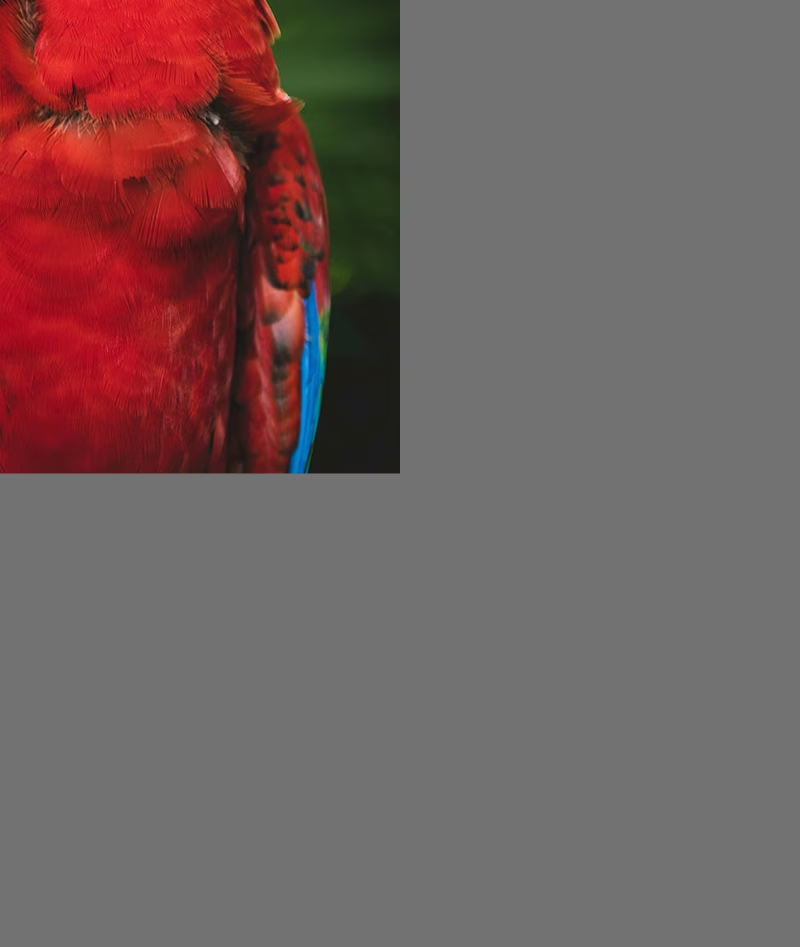 | 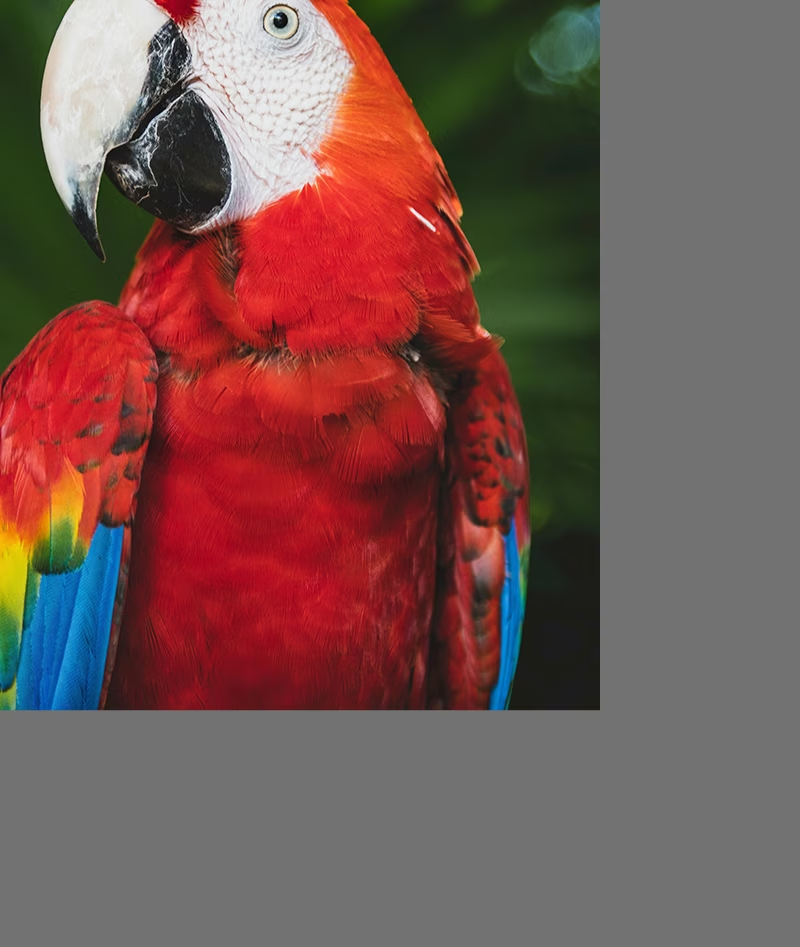 | | 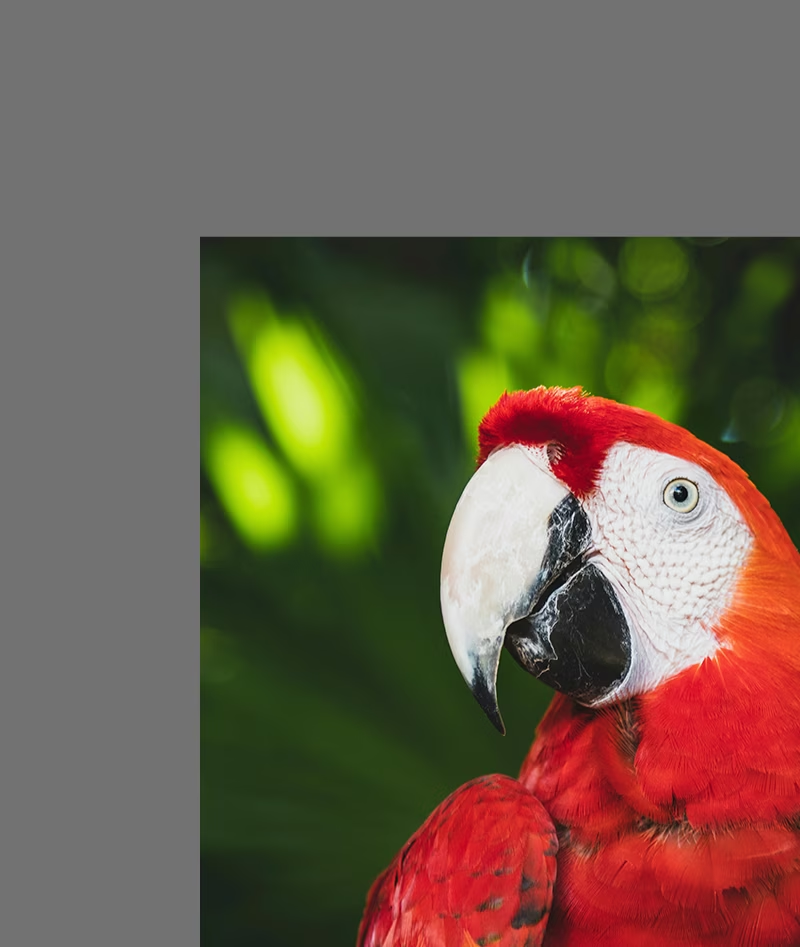 | 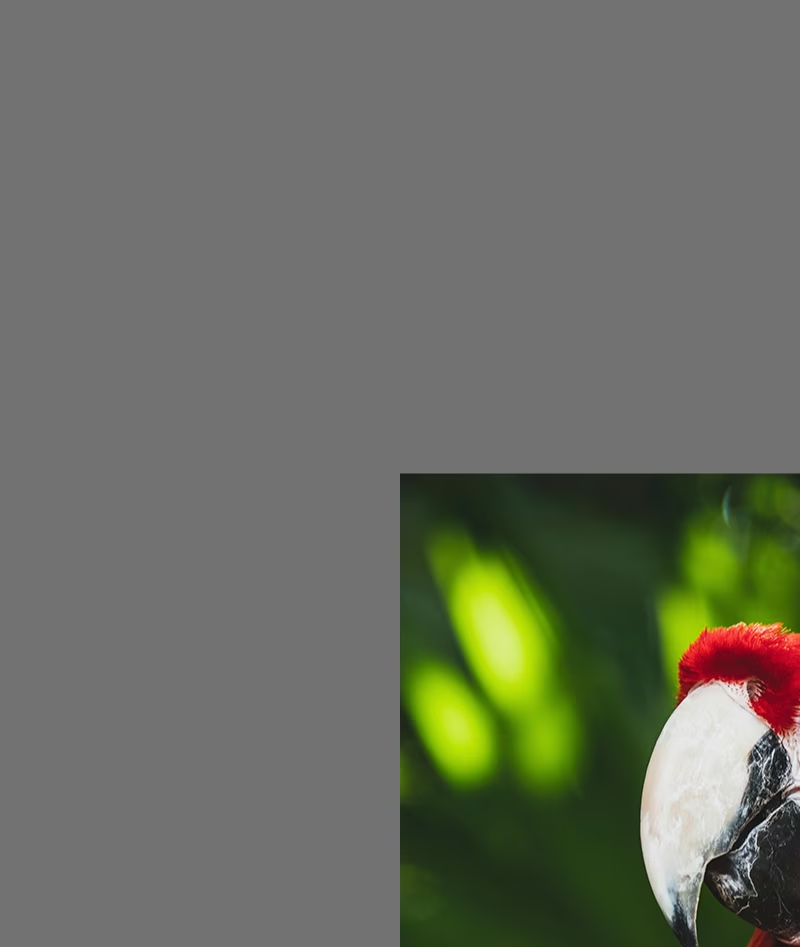 |
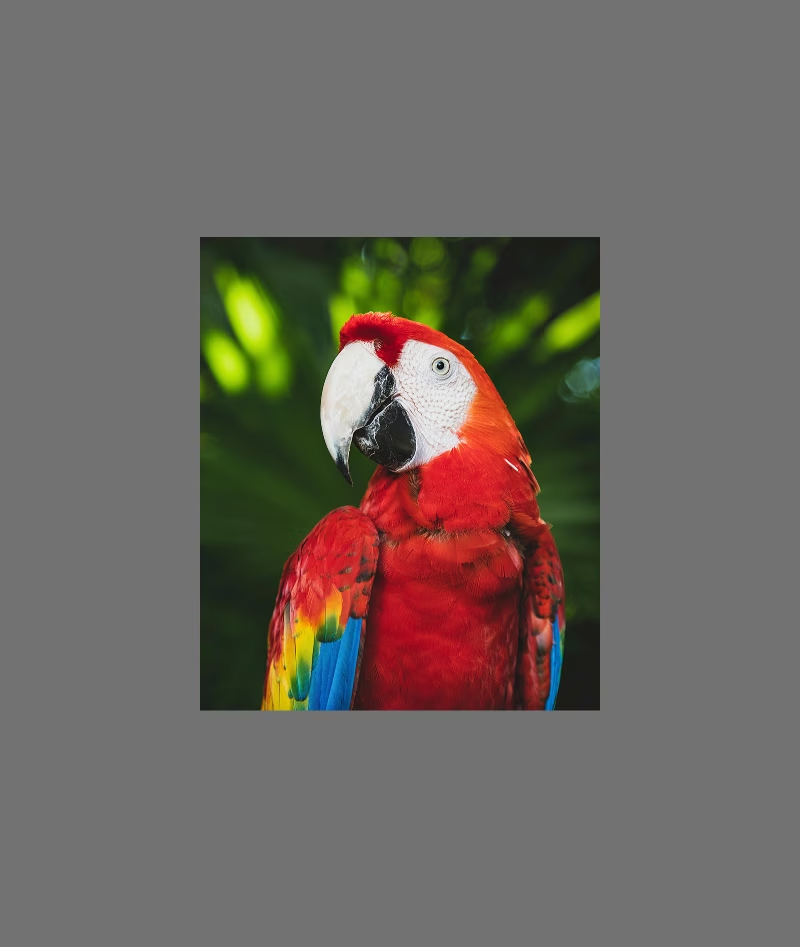
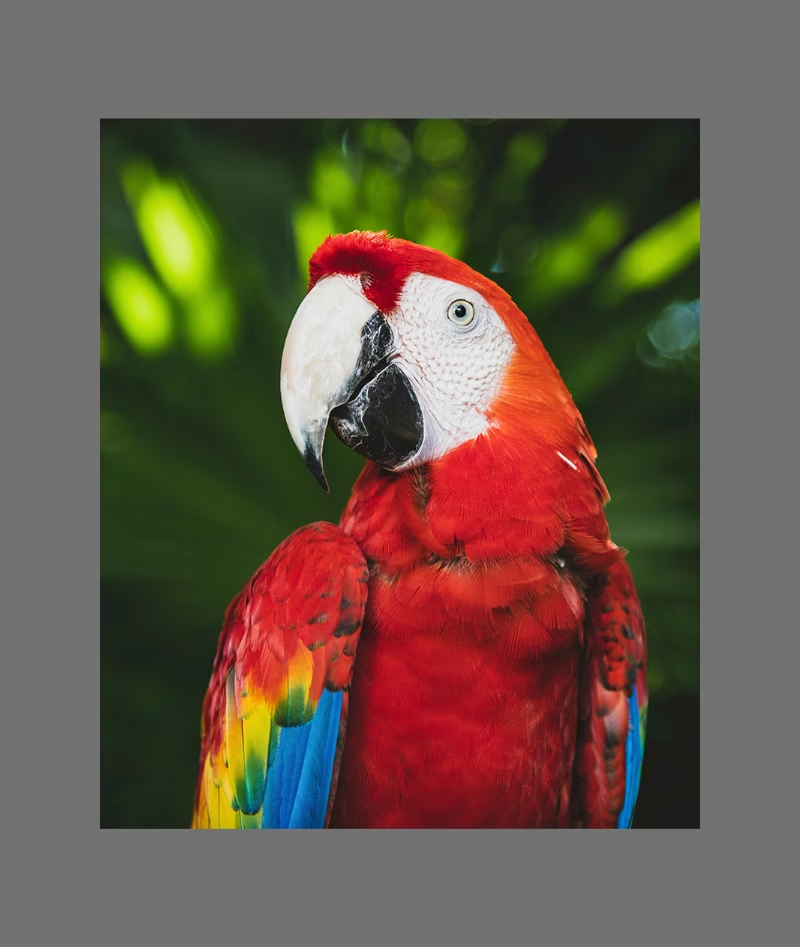
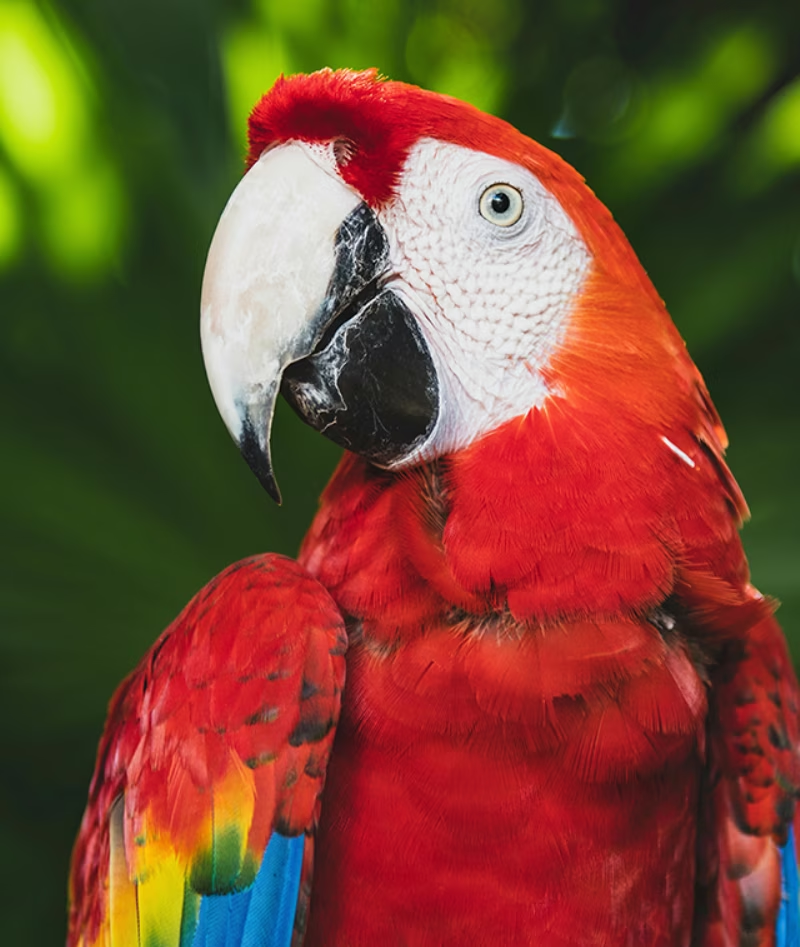
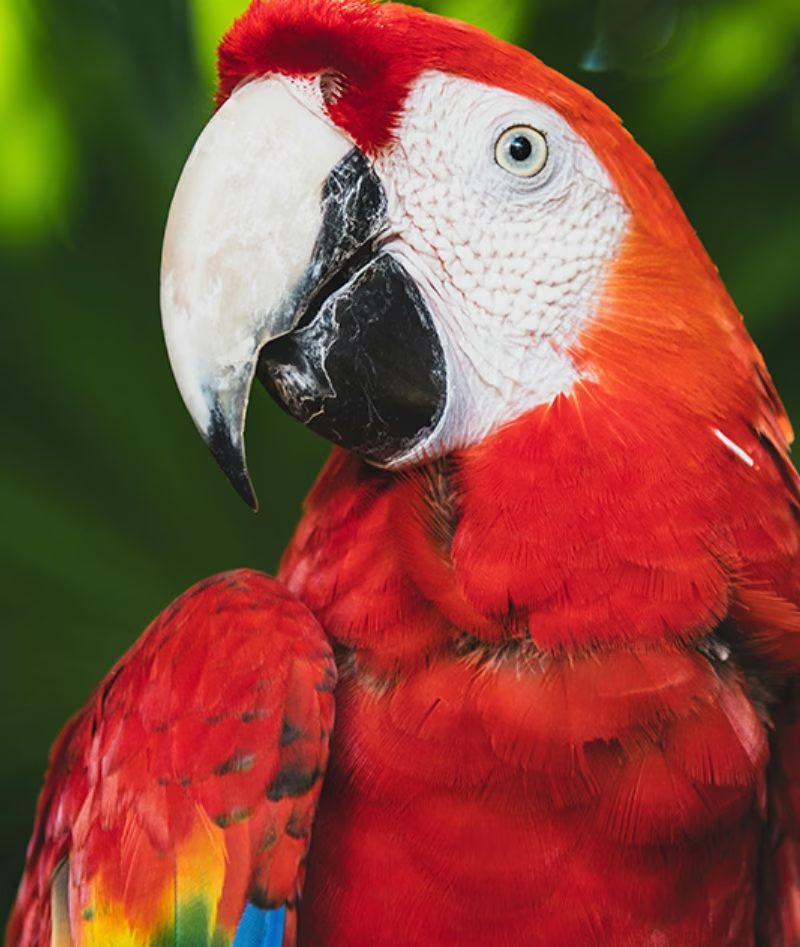
스케일 (scale)#
- 범위: 실수형
0.0~1.0또는 명시적인(min, max)튜플 - 기본값:
0.5 - 사용법: 지정된 범위 내에서 무작위 계수를 사용해 이미지 크기를 조정합니다. 실수형의 경우
scale하이퍼파라미터가 스케일링 계수를 정의하며, 최종 계수는1-scale과1+scale사이에서 무작위로 선택됩니다. 예를 들어scale=0.5인 경우 스케일링 계수는0.5~1.5범위에서 무작위로 선택됩니다. 튜플 형식에서는scale이 해당 범위를 직접 설정하므로,scale=(0.5, 2.0)은0.5과2.0사이에서 계수를 추출합니다. - 목적: 모델이 서로 다른 거리와 크기의 객체를 처리할 수 있도록 합니다. 예를 들어 자율 주행 애플리케이션에서 차량은 카메라와의 거리가 다양할 수 있으므로, 모델은 크기와 관계없이 차량을 인식해야 합니다.
- Ultralytics 구현: RandomPerspective
- 참고:
-1.0값은 이미지를 사라지게 하므로 표시하지 않았으며,1.0은 단순히 2배 확대합니다.- 아래 표에 표시된 값은 실제 스케일 변화량이며,
scale하이퍼파라미터에 전달하는 값이 아닙니다. - 실수형은
0.0~1.0범위로 검증되며, 범위를 벗어난 값을 사용하면ValueError가 발생합니다. 2배 확대를 초과하는 계수를 추출하려면 대신(min, max)튜플 형식을 전달하세요. - 튜플 형식은 기하학적 작업에만 적용됩니다. 분류 학습은 실수값(
1.0 - scale~1.0)에서 자체 크롭 범위를 계산하므로, 튜플을 전달하면TypeError가 발생합니다.
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
 |  | |  |  |
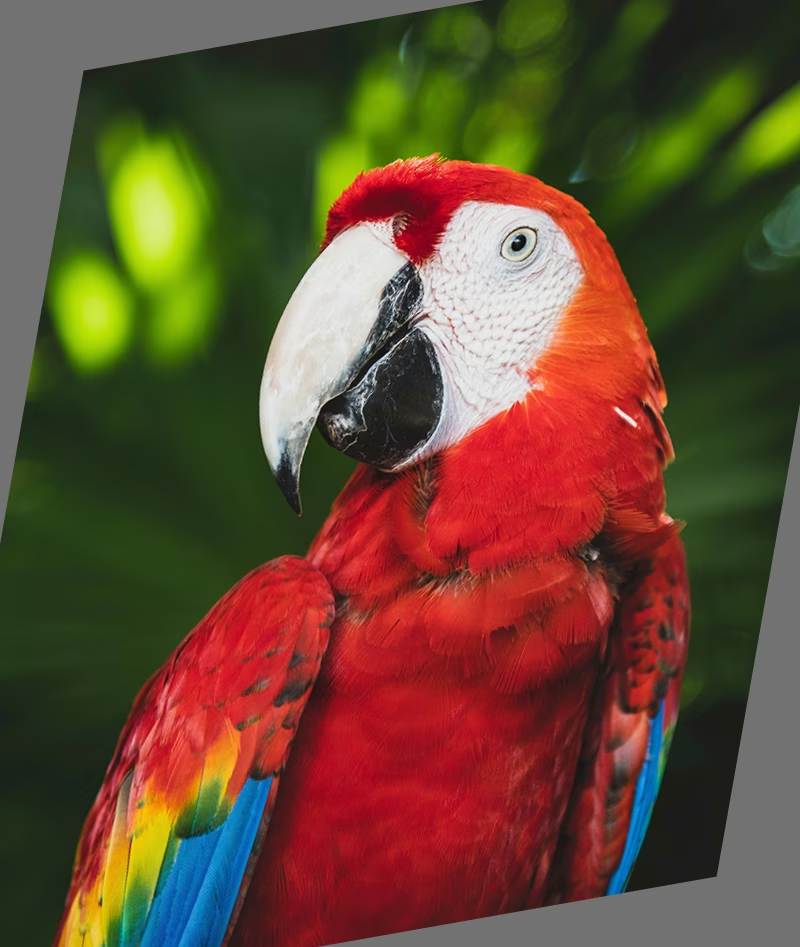
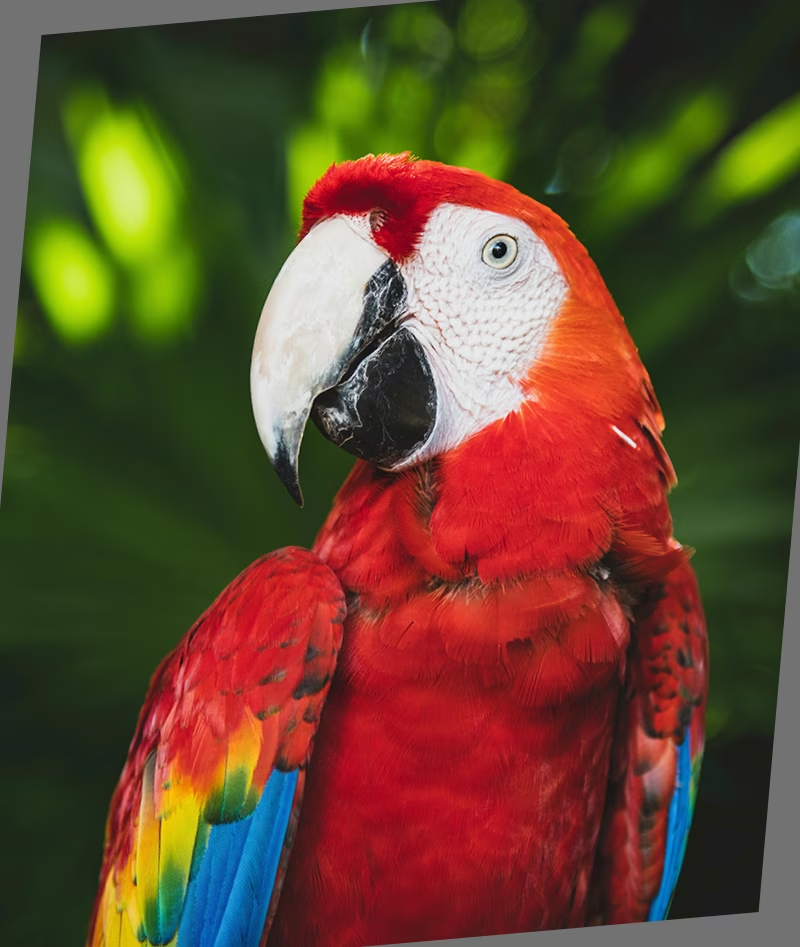
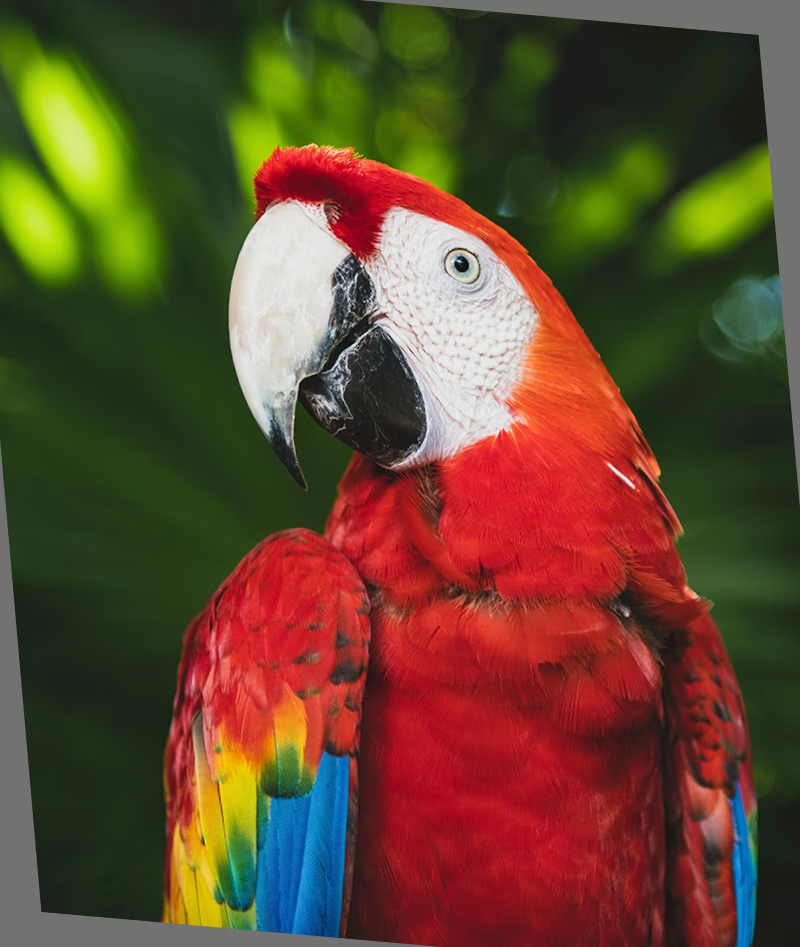
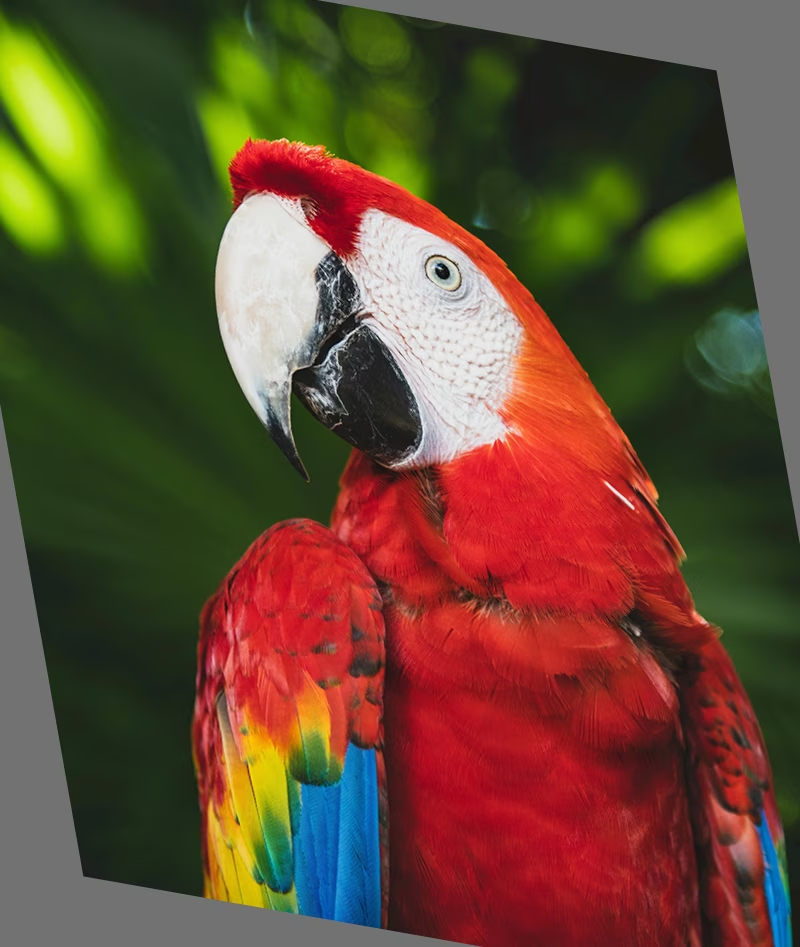
전단 (shear)#
- 범위:
-180~+180 - 기본값:
0 - 사용법: x축과 y축을 따라 이미지를 기울이는 기하학적 변환으로, 평행선을 유지하면서 이미지 일부를 한 방향으로 이동시킵니다.
shear하이퍼파라미터는 전단 각도를 정의하며, 최종 조정값은-shear과shear사이에서 무작위로 선택됩니다. 예를 들어shear=10.0인 경우 x축 전단값은-10~10범위에서 무작위로 선택되고, y축 전단값은 같은 범위에서 별도로 무작위 선택됩니다. - 목적: 약간 기울어진 시점이나 비스듬한 시점으로 인해 발생하는 시야각 변화에 모델이 일반화하도록 돕습니다. 예를 들어 교통 모니터링에서는 카메라가 수직으로 설치되지 않아 자동차와 도로 표지판 같은 객체가 기울어져 보일 수 있습니다. 전단 증강을 적용하면 모델이 이러한 왜곡에도 객체를 인식하도록 학습됩니다.
- Ultralytics 구현: RandomPerspective
- 참고:
shear값은 이미지를 빠르게 왜곡할 수 있으므로 작은 값부터 시작해 점진적으로 높이는 것이 좋습니다.- 원근 변환과 달리 전단은 깊이나 소실점을 만들지 않습니다. 대신 서로 마주 보는 변을 평행하게 유지하면서 각도를 변경해 객체의 형태를 왜곡합니다.
-10 | -5 | 0.0 | 5 | 10 |
|---|---|---|---|---|
 |  | |  |  |
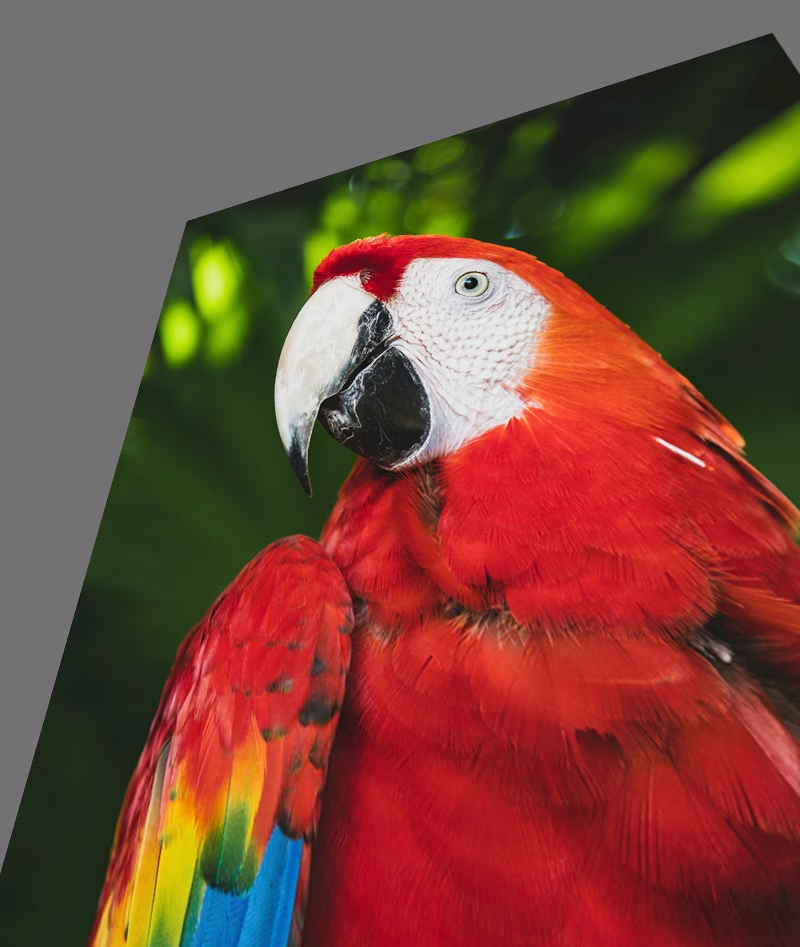
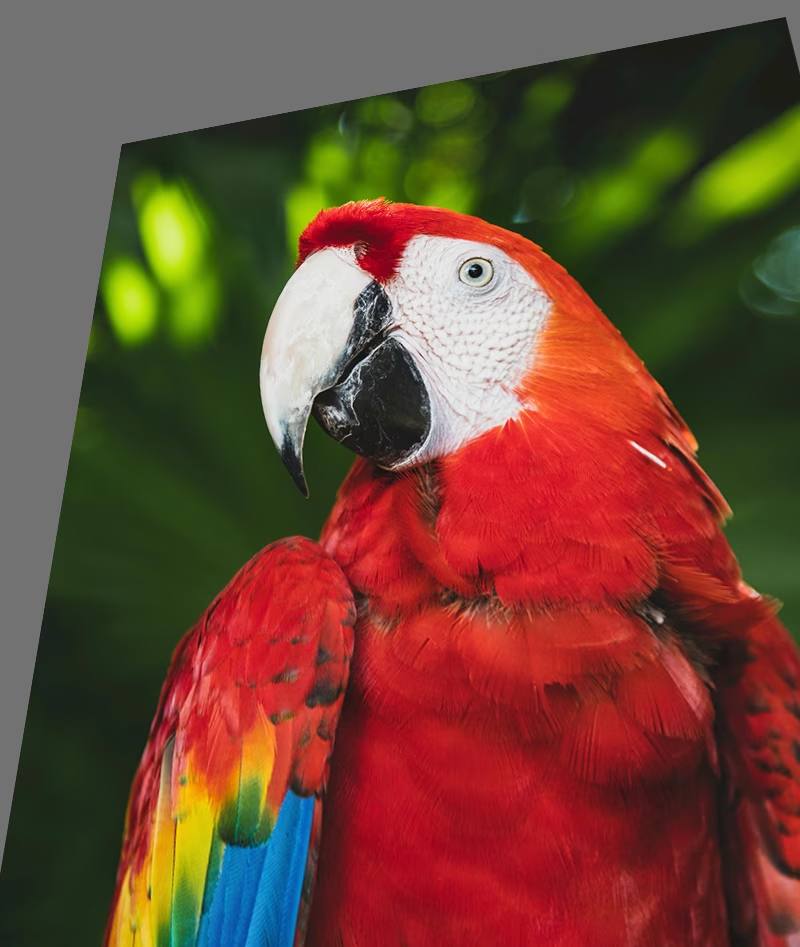
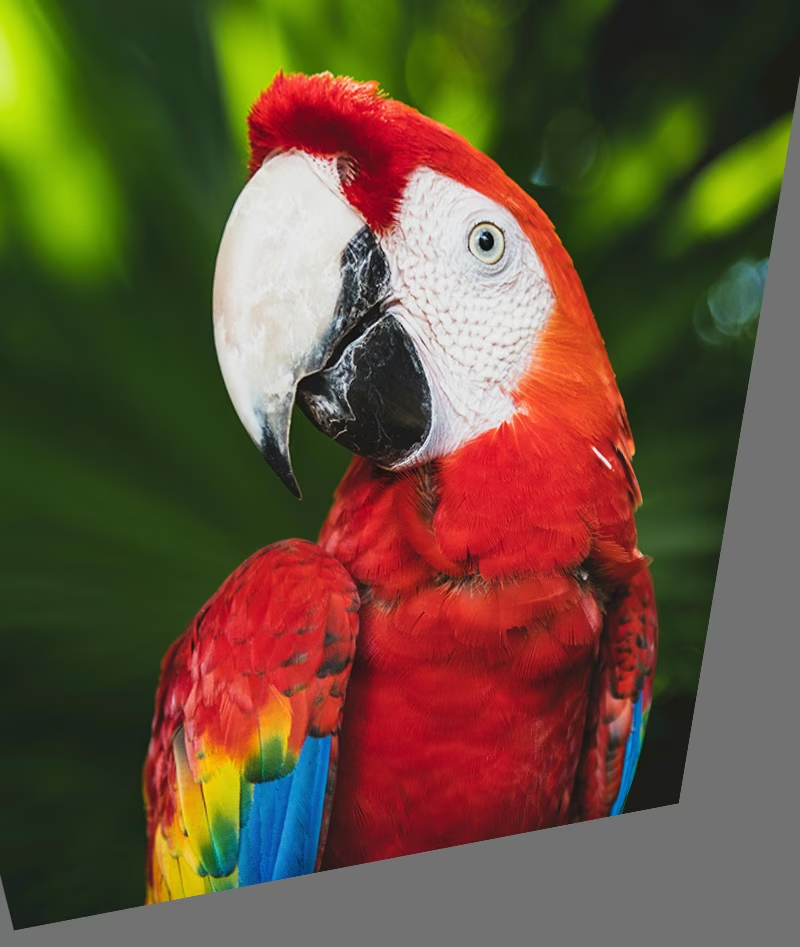
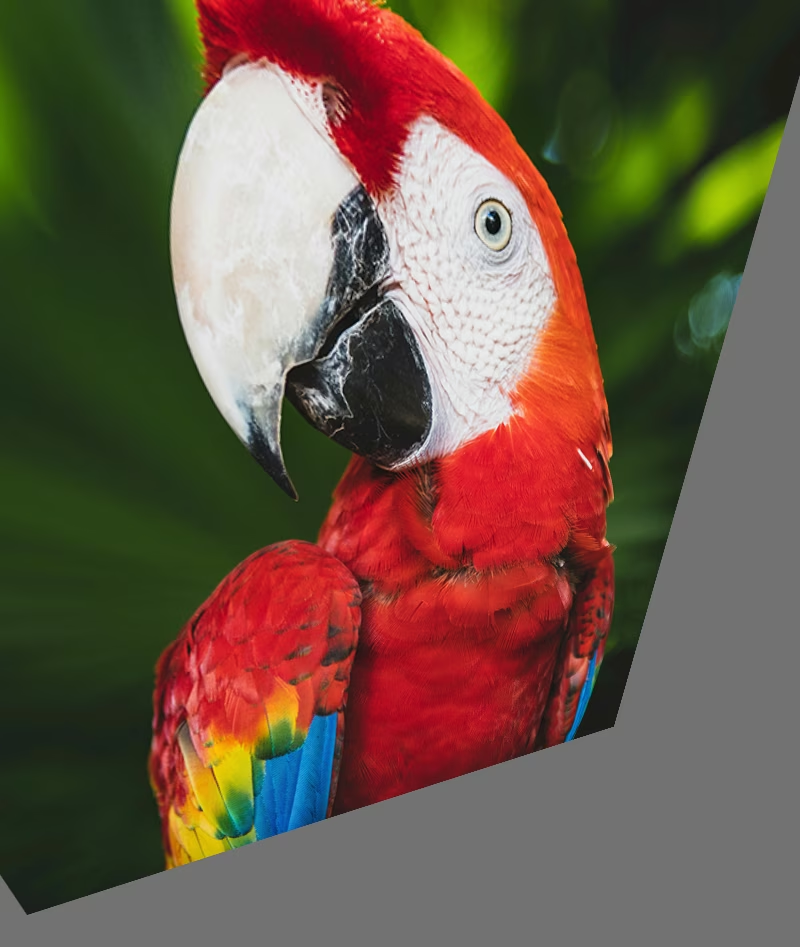
원근 (perspective)#
- 범위:
0.0~0.001 - 기본값:
0 - 사용법: x축과 y축을 따라 완전한 원근 변환을 적용하여 서로 다른 깊이나 각도에서 객체를 바라볼 때의 모습을 모방합니다.
perspective하이퍼파라미터는 원근 변환의 강도를 정의하며, 최종 조정값은-perspective과perspective사이에서 무작위로 선택됩니다. 예를 들어perspective=0.001인 경우 x축 원근 변환값은-0.001~0.001범위에서 무작위로 선택되고, y축 원근 변환값은 같은 범위에서 별도로 무작위 선택됩니다. - 목적: 원근 변화로 객체가 단축되거나 왜곡되어 보이는 경우처럼 시점이 크게 달라지는 상황에 대응하려면 원근 증강이 필수적입니다. 예를 들어 드론 기반 객체 감지에서는 드론의 기울기와 고도에 따라 건물, 도로, 차량이 늘어나거나 압축되어 보일 수 있습니다. 원근 변환을 적용하면 모델은 이러한 원근 왜곡에도 객체를 인식하도록 학습되어 실제 배포 환경에서의 견고성이 향상됩니다.
- Ultralytics 구현: RandomPerspective
-0.001 | -0.0005 | 0.0 | 0.0005 | 0.001 |
|---|---|---|---|---|
 |  | |  |  |
상하 반전 (flipud)#
- 범위:
0.0~1.0 - 기본값:
0 - 사용법: y축을 기준으로 이미지를 뒤집어 수직 반전을 수행합니다. 이 변환은 객체 간의 모든 공간적 관계를 유지하면서 이미지 전체를 위아래로 뒤집습니다. flipud 하이퍼파라미터는 변환 적용 확률을 정의하며,
flipud=1.0값은 모든 이미지를 뒤집고flipud=0.0값은 변환을 완전히 비활성화합니다. 예를 들어flipud=0.5인 경우 각 이미지가 위아래로 뒤집힐 확률은 50%입니다. - 목적: 객체가 위아래로 뒤집혀 나타날 수 있는 상황에 유용합니다. 예를 들어 로봇 비전 시스템에서는 컨베이어 벨트나 로봇 팔 위의 객체를 집어 여러 방향으로 배치할 수 있습니다. 수직 반전을 적용하면 모델이 객체의 위아래 방향과 관계없이 인식하도록 도울 수 있습니다.
- Ultralytics 구현: RandomFlip
flipud 꺼짐 | flipud 켜짐 |
|---|---|
|  |
좌우 반전 (fliplr)#
- 범위:
0.0~1.0 - 기본값:
0.5 - 사용법: x축을 기준으로 이미지를 좌우 반전합니다. 이 변환은 공간적 일관성을 유지하면서 왼쪽과 오른쪽을 바꾸므로, 모델이 거울에 비친 방향으로 나타나는 객체에 일반화하도록 돕습니다.
fliplr하이퍼파라미터는 변환 적용 확률을 정의하며,fliplr=1.0값은 모든 이미지를 반전하고fliplr=0.0값은 변환을 완전히 비활성화합니다. 예를 들어fliplr=0.5인 경우 각 이미지가 좌우 반전될 확률은 50%입니다. - 목적: 좌우 반전은 좌우 변화에 대한 견고성을 높이기 위해 객체 감지, 자세 추정, 얼굴 인식에서 널리 사용됩니다. 예를 들어 자율 주행에서는 차량과 보행자가 도로 양쪽에 나타날 수 있으며, 좌우 반전은 모델이 어느 방향에서든 동일하게 잘 인식하도록 돕습니다.
- Ultralytics 구현: RandomFlip
fliplr 꺼짐 | fliplr 켜짐 |
|---|---|
|  |
BGR 채널 교환 (bgr)#
- 범위:
0.0~1.0 - 기본값:
0 - 사용법: 이미지의 색상 채널을 RGB에서 BGR로 교환하여 색상 표현 순서를 변경합니다.
bgr하이퍼파라미터는 변환 적용 확률을 정의하며,bgr=1.0값은 모든 이미지의 채널을 교환하고bgr=0.0값은 변환을 비활성화합니다. 예를 들어bgr=0.5인 경우 각 이미지가 RGB에서 BGR로 변환될 확률은 50%입니다. - 목적: 다양한 색상 채널 순서에 대한 견고성을 높입니다. 예를 들어 RGB와 BGR 형식을 일관성 없이 사용하는 여러 카메라 시스템 및 이미지 처리 라이브러리에서 작동해야 하는 모델을 학습하거나, 입력 색상 형식이 학습 데이터와 다를 수 있는 환경에 모델을 배포할 때 유용합니다.
- Ultralytics 구현: Format
bgr 꺼짐 | bgr 켜짐 |
|---|---|
|  |
모자이크 (mosaic)#
- 범위:
0.0~1.0 - 기본값:
1 - 사용법: 학습 이미지 네 장을 하나로 결합합니다.
mosaic하이퍼파라미터는 변환 적용 확률을 정의하며,mosaic=1.0값은 모든 이미지를 결합하고mosaic=0.0값은 변환을 비활성화합니다. 예를 들어mosaic=0.5인 경우 각 이미지가 다른 이미지 세 장과 결합될 확률은 50%입니다. - 목적: 작은 객체 감지와 문맥 이해 성능을 높이는 데 매우 효과적입니다. 예를 들어 동물 보호 프로젝트에서 동물은 다양한 거리와 크기로 나타날 수 있습니다. 모자이크 증강은 제한된 데이터로 다양한 학습 샘플을 인위적으로 생성하여 모델이 크기, 부분 가림, 환경적 맥락이 달라도 같은 종을 인식하도록 학습하는 데 도움이 됩니다.
- Ultralytics 구현: Mosaic
- 참고:
mosaic증강은 모델의 견고성을 높일 수 있지만 학습 과정을 더 어렵게 만들 수도 있습니다.- 학습 종료 전 비활성화할 에포크 수를
close_mosaic에 설정하면 학습 후반에mosaic증강을 비활성화할 수 있습니다. 예를 들어epochs를200으로 설정하고close_mosaic를20로 설정하면180에포크 후mosaic증강이 비활성화됩니다.close_mosaic을0로 설정하면mosaic증강이 전체 학습 과정에서 활성화됩니다. - 모자이크를 종료하면 같은 에포크에
copy_paste,mixup,cutmix도 비활성화됩니다. 네 가지 증강은 함께 꺼지므로 마지막 에포크에서는 적용되지 않지만, 기하학적 변환, HSV, 반전, Albumentations 등 다른 모든 증강은 계속 실행됩니다. 기본flip모드의copy_paste은 여러 이미지를 결합하지 않고 단일 이미지 내에서 작동합니다. - 생성된 모자이크의 중심은 무작위 값으로 결정되며 이미지 안이나 바깥에 위치할 수 있습니다.
- 현재
mosaic증강 구현은 현재 이미지와 다른 이미지 세 장을 결합합니다. 다른 이미지는 최근 로드한 이미지 버퍼에서 가져오거나cache='ram'인 경우 데이터셋 전체에서 가져옵니다. 두 경우 모두 복원 추출되므로 같은 이미지가 하나의 모자이크에 두 번 이상 나타날 수 있습니다.
mosaic 꺼짐 | mosaic 켜짐 |
|---|---|
|  |
Mixup (mixup)#
- 범위:
0.0~1.0 - 기본값:
0 - 사용법: 지정된 확률로 두 이미지와 해당 레이블을 혼합합니다.
mixup하이퍼파라미터는 변환 적용 확률을 정의하며,mixup=1.0값은 모든 이미지를 혼합하고mixup=0.0값은 변환을 비활성화합니다. 예를 들어mixup=0.5인 경우 각 이미지가 다른 이미지와 혼합될 확률은 50%입니다. - 목적: 모델의 견고성을 높이고 과적합을 줄입니다. 예를 들어 소매 제품 인식 시스템에서 Mixup은 서로 다른 제품 이미지를 혼합해 모델이 더 견고한 특징을 학습하도록 돕습니다. 이를 통해 매장 진열대가 혼잡해 다른 제품에 가려지거나 일부만 보이는 경우에도 제품을 식별하도록 학습할 수 있습니다.
- Ultralytics 구현: MixUp
- 참고:
mixup비율은np.random.beta(32.0, 32.0)베타 분포에서 선택한 무작위 값입니다. 따라서 각 이미지가 약 50%씩 기여하며 약간의 변동이 생깁니다.
첫 번째 이미지, mixup 꺼짐 | 두 번째 이미지, mixup 꺼짐 | mixup 켜짐 |
|---|---|---|
| 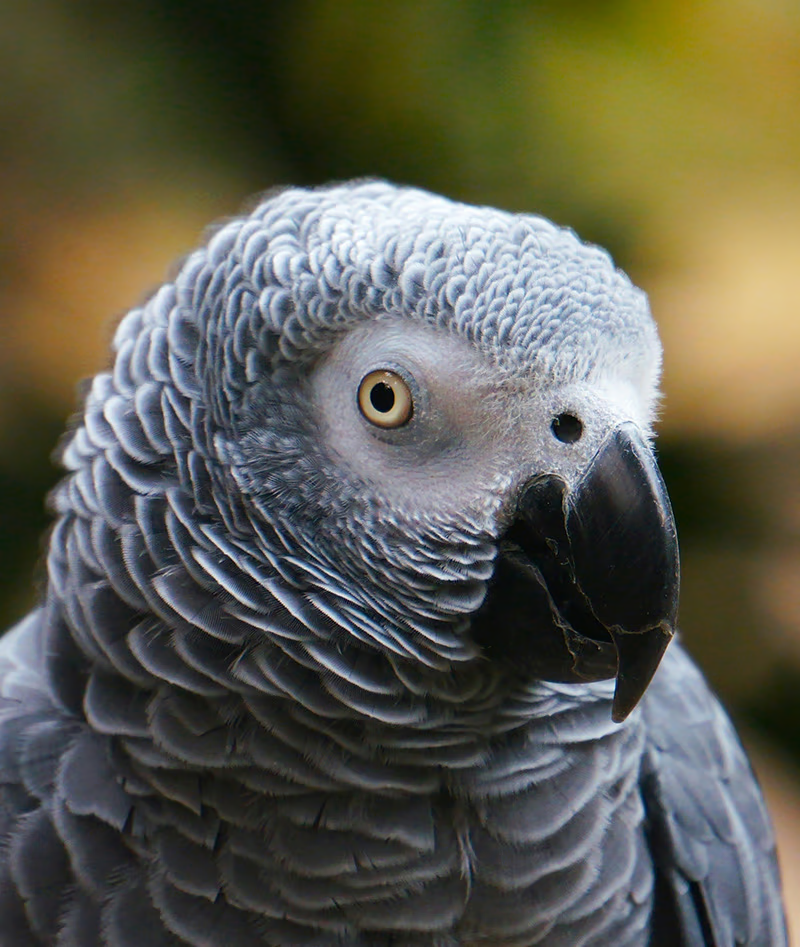 | 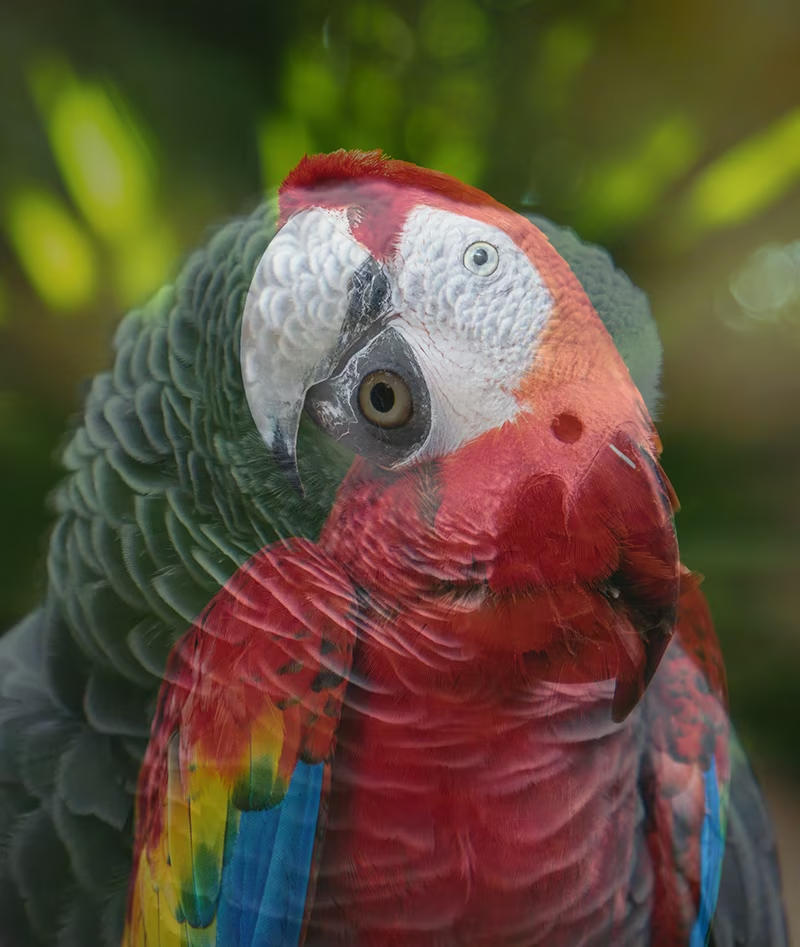 |
CutMix (cutmix)#
- 범위:
0.0~1.0 - 기본값:
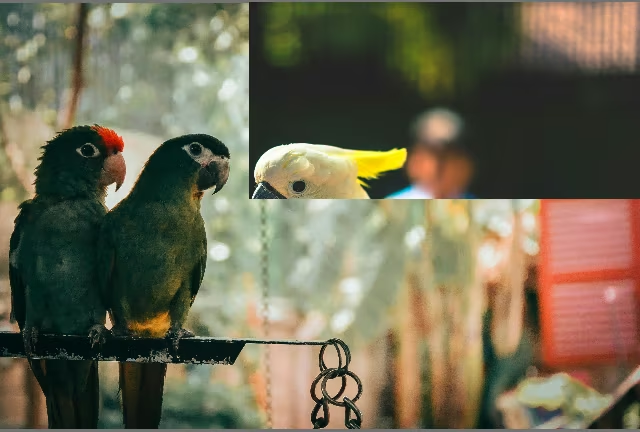
0 - 사용법: 지정된 확률에 따라 한 이미지에서 직사각형 영역을 잘라 다른 이미지에 붙여넣습니다.
cutmix하이퍼파라미터는 변환을 적용할 확률을 정의하며,cutmix=1.0은 모든 이미지에 이 변환을 적용하고cutmix=0.0는 변환을 완전히 비활성화합니다. 예를 들어cutmix=0.5을 설정하면 각 이미지의 영역이 다른 이미지의 패치로 대체될 확률은 50%입니다. - 목적: 로컬 특징의 무결성을 유지하면서 현실적인 가림 상황을 만들어 모델 성능을 향상합니다. 예를 들어 자율 주행 시스템에서 cutmix는 다른 객체에 부분적으로 가려진 차량이나 보행자도 인식하도록 모델을 학습시켜, 객체가 겹치는 복잡한 실제 환경에서 탐지 정확도를 높입니다.
- Ultralytics 구현: CutMix
- 참고:
- 잘라낼 영역의 크기와 위치는 적용할 때마다 무작위로 결정됩니다.
- 픽셀 값을 전역적으로 혼합하는 mixup과 달리,
cutmix은 잘라낸 영역의 원래 픽셀 강도를 유지하여 로컬 특징을 보존합니다. - 대상 이미지에 이미 있는 바운딩 박스와 겹치지 않는 경우에만 영역을 붙여넣습니다. 또한 붙여넣은 영역 안에서 원래 면적을 충분히 유지하는 바운딩 박스만 보존됩니다.
- 현재 구현에서는 이 최소 바운딩 박스 면적 임계값을 변경할 수 없습니다. 탐지 라벨의 경우
0.1(10%)이며, 라벨에 세그먼트가 포함되면0.01(1%)입니다.
첫 번째 이미지, cutmix 꺼짐 | 두 번째 이미지, cutmix 꺼짐 | cutmix 켜짐 |
|---|---|---|
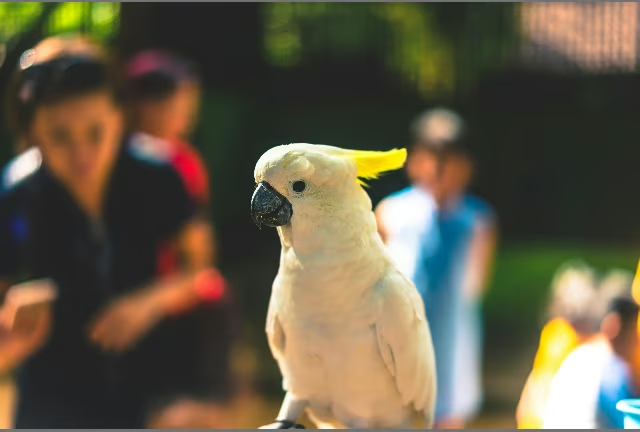 | 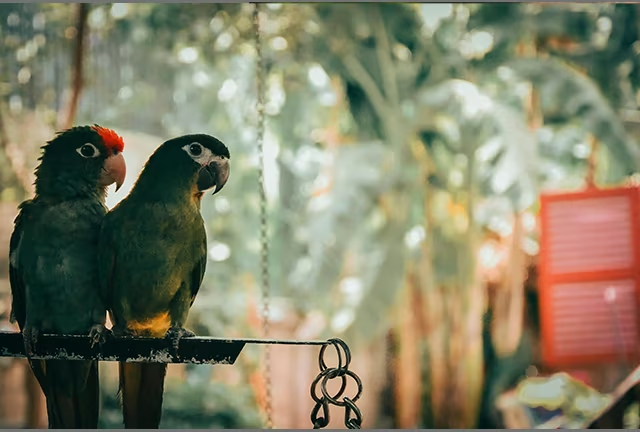 |  |
Copy-Paste 증강#
Copy-Paste (copy_paste)#
- 범위:
0.0~1.0 - 기본값:
0 - 사용법: 폴리곤 라벨이 필요하므로 세그먼트 및 OBB 작업에 적용됩니다. 이 증강은
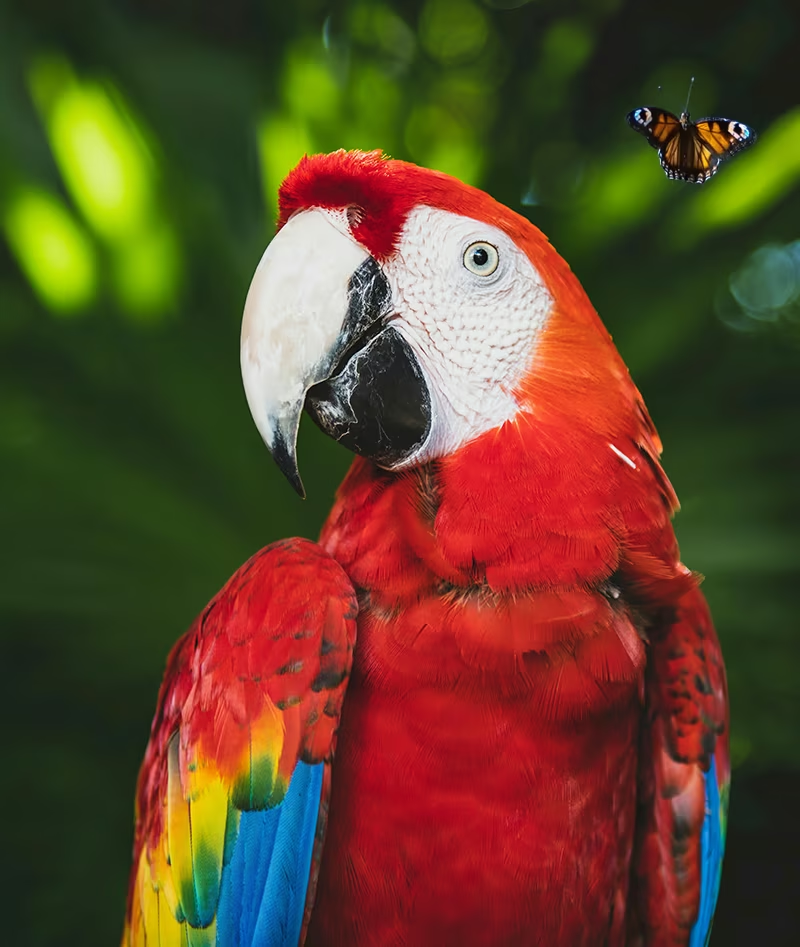
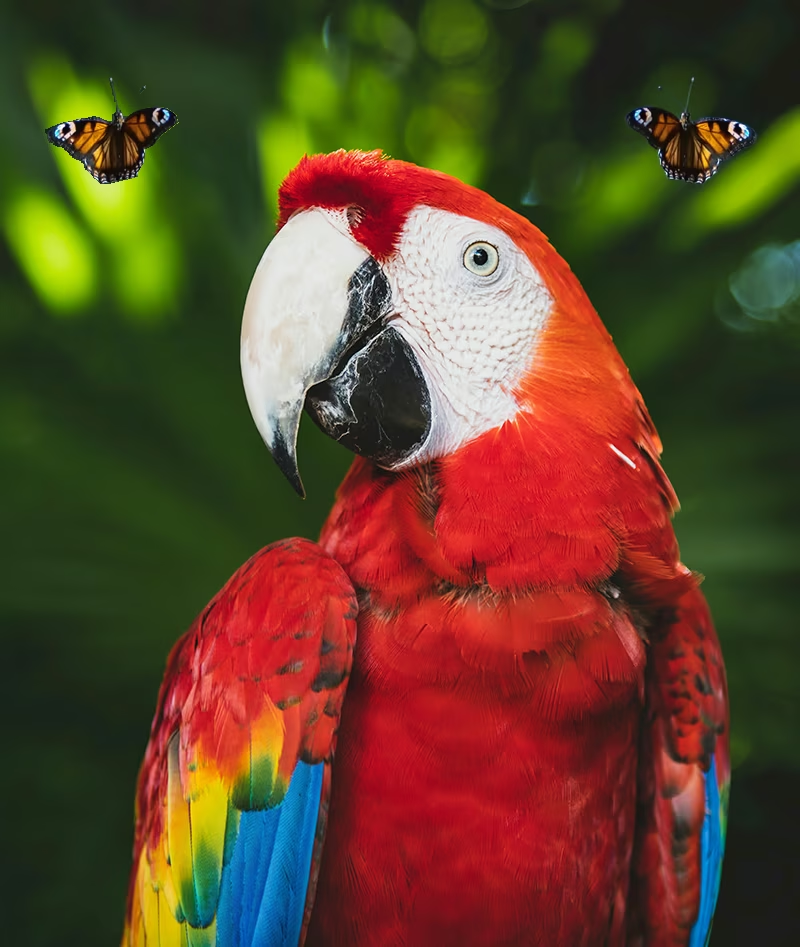
copy_paste_mode로 제어하며, 이미지 내부 또는 이미지 간에 객체를 복사합니다.flip모드에서copy_paste은 복사 가능한 객체 중 복사할 비율입니다. 복사 가능한 객체가 6개인 이미지에서는copy_paste=0.5에서 복사본 3개가 추가됩니다.mixup모드에서는 동일한 값이 copy-paste 실행 확률도 제어합니다.copy_paste=0.0은 변환을 비활성화합니다. - 목적: 인스턴스 세그멘테이션 작업과 희귀 객체 클래스에 특히 유용합니다. 예를 들어 특정 유형의 결함이 드물게 나타나는 산업용 결함 탐지에서는 copy-paste 증강을 통해 한 이미지의 희귀 결함을 다른 이미지에 복사하여 인위적으로 발생 빈도를 높일 수 있습니다. 추가 결함 샘플 없이도 모델이 이러한 과소 표현 사례를 더 잘 학습하도록 돕습니다.
- Ultralytics 구현: CopyPaste
- 참고:
- 아래 동영상에 나온 것처럼
copy_paste증강을 사용하여 한 이미지의 객체를 다른 이미지로 복사할 수 있습니다. - 복사할 객체를 선택하면
copy_paste_mode여부와 관계없이 대상 이미지에 이미 있는 모든 객체와의 IoA를 계산합니다. 모든 IoA 값이0.3(30%)보다 낮은 경우에만 객체를 붙여넣으며, IoA 값 중 하나라도0.3이상이면 붙여넣지 않습니다. - 현재 구현에서는 IoA 임계값을 변경할 수 없으며 기본값은
0.3입니다.
- 아래 동영상에 나온 것처럼
copy_paste 꺼짐 | copy_paste을 copy_paste_mode=flip과 함께 사용 | copy_paste 프로세스 시각화 |
|---|---|---|
 |  |
Copy-Paste 모드 (copy_paste_mode)#
- 옵션:
'flip','mixup' - 기본값:
'flip' - 사용법: copy-paste 증강에 사용할 방법을 결정합니다.
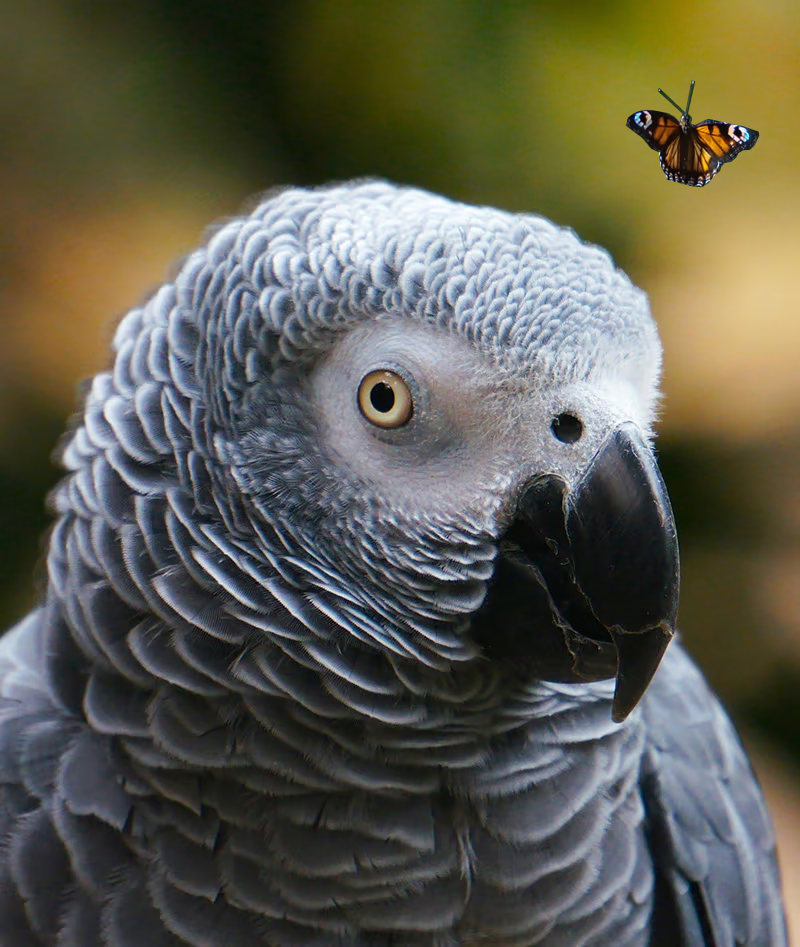
'flip'로 설정하면 같은 이미지에서 객체를 가져오고,'mixup'로 설정하면 다른 이미지에서 객체를 복사할 수 있습니다. - 목적: 복사한 객체를 대상 이미지에 통합하는 방식을 유연하게 설정할 수 있습니다.
- Ultralytics 구현: CopyPaste
- 참고:
- 두
copy_paste_mode옵션의 IoA 원칙은 같지만 객체를 복사하는 방식은 다릅니다. - 이미지 크기에 따라 객체가 일부 또는 전부 프레임 바깥으로 복사될 수 있습니다.
- 폴리곤 어노테이션의 품질에 따라 복사한 객체의 모양이 원본과 약간 다를 수 있습니다.
- 두
| 참조 이미지 | copy_paste에 선택된 이미지 | copy_paste을 copy_paste_mode=mixup과 함께 사용 |
|---|---|---|
| |  |
분류 전용 증강#
Auto Augment (auto_augment)#
- 옵션:
'randaugment','autoaugment','augmix',None - 기본값:
'randaugment' - 사용법: 분류를 위한 자동 증강 정책을 적용합니다.
'randaugment'옵션은 RandAugment를 사용하고,'autoaugment'은 AutoAugment를 사용하며,'augmix'는 AugMix를 사용합니다.None으로 설정하면 자동 증강이 비활성화됩니다. - 목적: 분류 작업의 증강 전략을 자동으로 최적화합니다. 차이점은 다음과 같습니다.
- AutoAugment: ImageNet, CIFAR10, SVHN과 같은 데이터셋에서 학습된 사전 정의 증강 정책을 적용합니다. 사용자는 기존 정책을 선택할 수 있지만 Torchvision 내에서 새 정책을 학습시킬 수는 없습니다. 특정 데이터셋에 최적화된 증강 전략을 찾으려면 외부 라이브러리나 사용자 지정 구현이 필요합니다. AutoAugment 논문을 참조하세요.
- RandAugment: 크기가 균일한 변환을 무작위로 선택해 적용합니다. 이 방식은 광범위한 탐색 단계를 줄여 계산 효율성을 높이면서도 모델의 견고성을 향상합니다. RandAugment 논문을 참조하세요.
- AugMix: AugMix는 간단한 변환을 무작위로 조합해 다양한 이미지 변형을 만들고, 이를 통해 모델의 견고성을 향상하는 데이터 증강 방법입니다. AugMix 논문을 참조하세요.
- Ultralytics 구현: classify_augmentations()
- 참고:
- 기본적으로 세 가지 방법의 주요 차이는 증강 정책을 정의하고 적용하는 방식입니다.
- 세 가지 방법을 자세히 비교한 이 문서를 참조하세요.
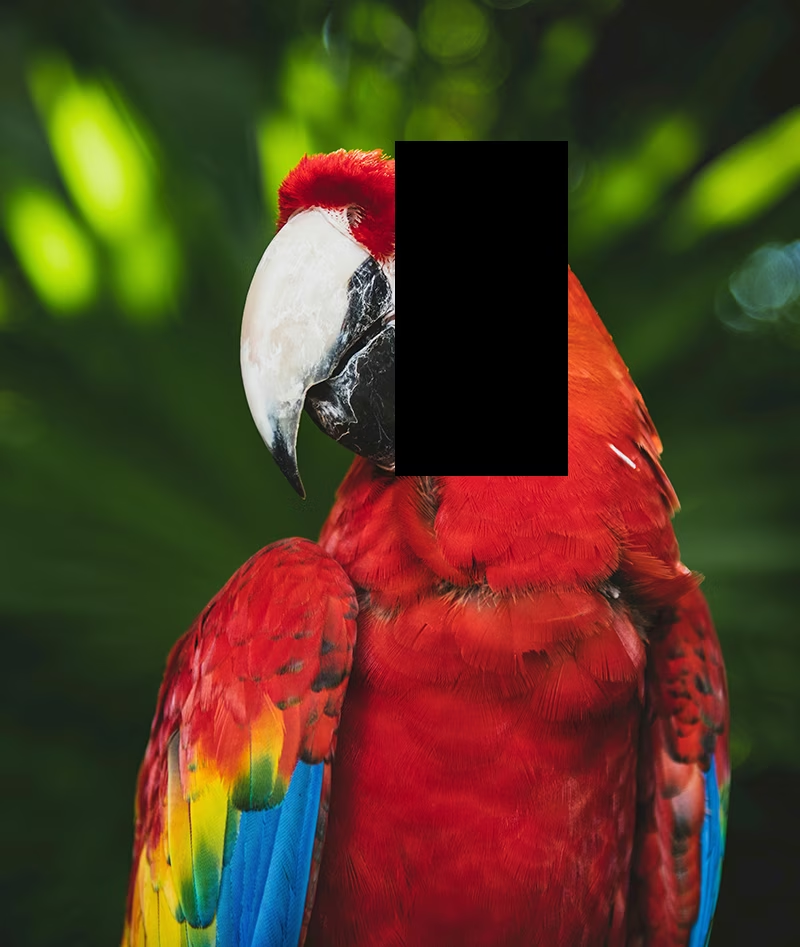
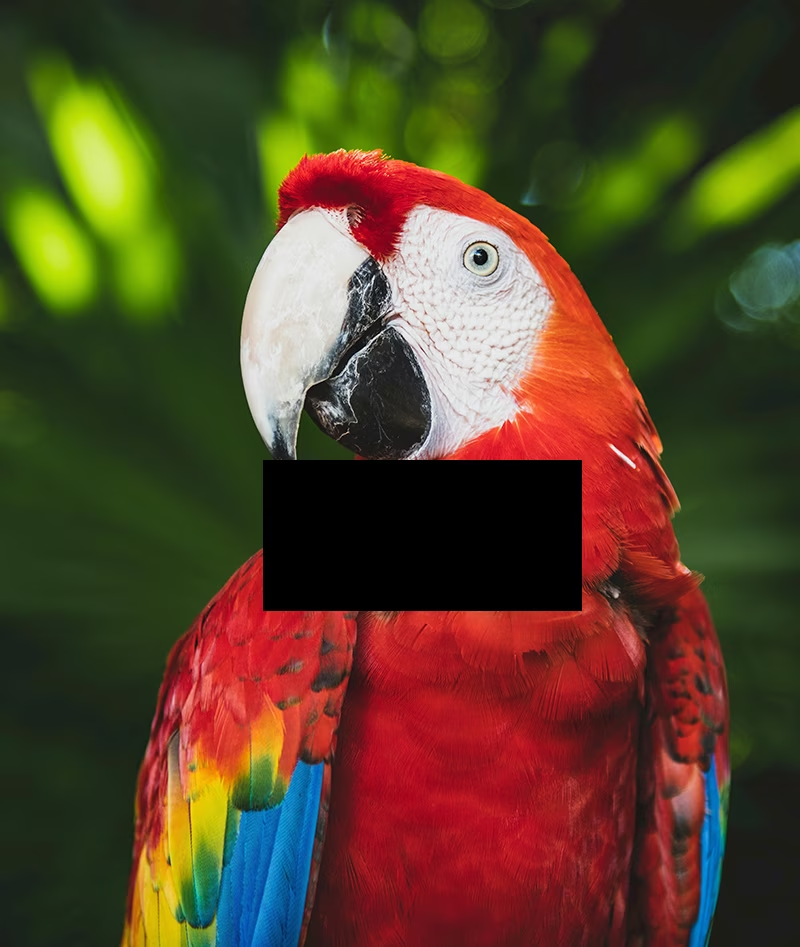
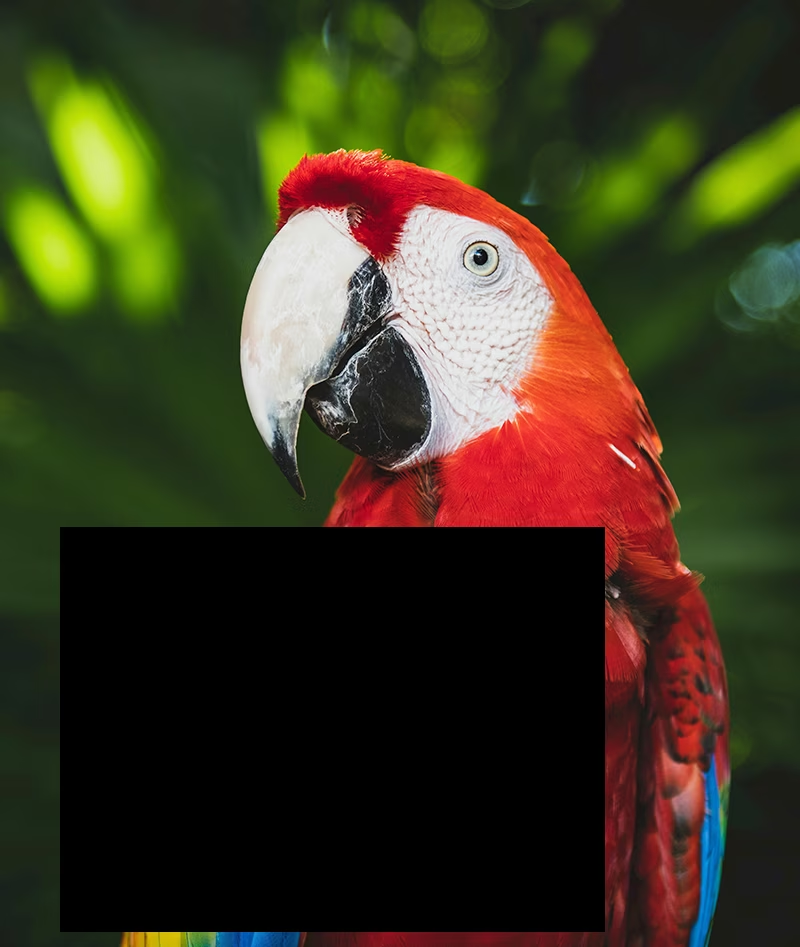
Random Erasing (erasing)#
- 범위:
0.0~1.0 - 기본값:
0.4 - 사용법: 분류 학습 중 이미지 일부를 무작위로 지웁니다.
erasing하이퍼파라미터는 변환을 적용할 확률을 정의하며,erasing=1.0은 모든 이미지의 한 영역을 지우고erasing=0.0는 변환을 비활성화합니다. 예를 들어erasing=0.5을 설정하면 각 이미지의 일부가 지워질 확률은 50%입니다. - 목적: 모델이 견고한 특징을 학습하도록 돕고 특정 이미지 영역에 지나치게 의존하지 않게 합니다. 예를 들어 안면 인식 시스템에서 random erasing은 선글라스, 안면 마스크 또는 얼굴 특징을 부분적으로 가릴 수 있는 다른 객체와 같은 부분 가림에 모델이 더 잘 대응하도록 합니다. 모델이 가려질 수 있는 고유한 특징에만 의존하는 대신 여러 안면 특징을 사용해 사람을 식별하게 함으로써 실제 환경에서의 성능을 향상합니다.
- Ultralytics 구현: classify_augmentations()
- 참고:
erasing 꺼짐 | erasing 사용 (예시 1) | erasing 사용 (예시 2) | erasing 사용 (예시 3) |
|---|---|---|---|
|  |  |  |
고급 증강 기능#
사용자 지정 Albumentations 변환 (augmentations)#
- 유형: Albumentations 변환의
list - 기본값:
None - 사용법: Python API를 사용하여 데이터 증강을 위한 사용자 지정 Albumentations 변환을 제공할 수 있습니다. 이 매개변수는 학습 중 기본 Albumentations 변환 대신 적용할 Albumentations 변환 객체 목록을 받습니다.
- 목적: 방대한 Albumentations 변환 라이브러리를 활용하여 데이터 증강 전략을 세밀하게 제어할 수 있습니다. 탄성 변형과 의료 영상용 그리드 왜곡, 항공 및 위성 영상 시점에 맞춘 변환, 저조도 환경을 모사하는 노이즈 및 밝기 변화, 산업 검사에서 결함과 유사한 질감 변화 등 기본 제공 YOLO 옵션 이상의 특수 증강이 필요할 때 특히 유용합니다.
- Ultralytics 구현: Albumentations
- 참고:
- 변환 객체를 생성하려면 Python API가 필요합니다. 체크포인트 저장 시 Ultralytics는
A.to_dict()으로 변환 객체를 직렬화합니다. 따라서 이미 직렬화된 목록은 YAML 구성 파일이나 CLI를 통해 왕복 처리할 수 있으며, 이를 통해resume이 목록을 복원합니다. - 사용자 지정 변환은 기본 Albumentations 세트를 완전히 대체합니다. 이 페이지의 다른 위치에서 구성한 모든 증강, 즉
mosaic,hsv_h,degrees등은 계속 활성 상태를 유지하며 각각 독립적으로 적용됩니다. A.OneOf또는A.Compose안에 중첩된 변환을 포함하여 이미지 기하 구조를 변경하는 공간 변환은 이미지와 함께 바운딩 박스, 폴리곤, 키포인트, 깊이 또는 시맨틱 마스크를 이동합니다.A.RandomGridShuffle는 폴리곤이나 키포인트의 위상 구조를 보존할 수 없으므로 세그멘테이션, 포즈, OBB 샘플에서 오류를 발생시킵니다.- Albumentations는 70개 이상의 변환을 제공합니다. 전체 목록은 Albumentations 문서에 있습니다. 변환을 많이 추가하거나 계산 비용이 큰 변환을 추가하면 학습 속도가 느려지므로, 적은 수로 시작하고 에포크 시간을 확인하세요.
detect,segment,semantic,depth,pose,obb작업에 적용됩니다. 분류는 별도의 증강 파이프라인을 사용하므로 제외됩니다.
- 변환 객체를 생성하려면 Python API가 필요합니다. 체크포인트 저장 시 Ultralytics는
아래 예제에는 Albumentations 1.4.22 이상이 필요하며, 따라서 Python 3.9 이상이 필요합니다.
import albumentations as A

from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n.pt")

# 사용자 지정 Albumentations 변환 정의
custom_transforms = [
    A.Blur(blur_limit=7, p=0.5),
    A.GaussNoise(std_range=(0.0124, 0.0277), p=0.3),
    A.CLAHE(clip_limit=4.0, p=0.5),
    A.RandomBrightnessContrast(brightness_limit=0.2, contrast_limit=0.2, p=0.5),
    A.HueSaturationValue(hue_shift_limit=20, sat_shift_limit=30, val_shift_limit=20, p=0.5),
]

# 사용자 지정 Albumentations 변환으로 학습
model.train(
    data="coco8.yaml",
    epochs=100,
    augmentations=custom_transforms,  # 사용자 지정 변환 전달
    imgsz=640,
)
자주 묻는 질문#
적절한 증강을 선택하는 방법은 구체적인 사용 사례와 데이터셋에 따라 달라집니다. 선택에 도움이 될 몇 가지 일반적인 지침은 다음과 같습니다.
- 대부분의 경우 색상과 밝기를 약간 변경하면 도움이 됩니다.
hsv_h,hsv_s,hsv_v의 기본값을 좋은 시작점으로 삼을 수 있습니다. - 카메라 시점이 일정하고 모델 배포 후에도 바뀌지 않는다면
degrees(회전),translate,scale,shear,perspective와 같은 기하학적 변환을 생략해도 됩니다. 하지만 카메라 각도가 달라질 수 있고 모델의 견고성을 높여야 한다면 이러한 증강을 유지하는 편이 좋습니다. - 부분적으로 가려진 객체나 이미지당 여러 객체가 있어도 괜찮고 라벨 값이 달라지지 않는 경우에만
mosaic증강을 사용하세요. 또는mosaic을 활성 상태로 유지하되close_mosaic값을 높여 학습 과정 초기에 증강을 비활성화할 수 있습니다.
요약하면, 단순하게 유지하세요. 적은 수의 증강으로 시작하고 필요에 따라 점차 추가하세요. 목표는 학습 과정을 지나치게 복잡하게 만드는 것이 아니라 모델의 일반화 성능과 견고성을 높이는 것입니다. 또한 적용하는 증강이 모델이 프로덕션에서 접할 데이터 분포를 반영하는지 확인하세요.
- 대부분의 경우 색상과 밝기를 약간 변경하면 도움이 됩니다.
albumentations패키지가 설치되어 있으면 Ultralytics는 이 패키지를 사용해 이미지에 추가 증강을 자동으로 적용합니다. 이러한 증강은 내부적으로 처리되며 추가 구성이 필요하지 않습니다.적용되는 변환의 전체 목록은 기술 문서와 Albumentations 통합 가이드에서 확인할 수 있습니다. 확률이
0보다 큰p증강만 활성화됩니다. 블러나 그레이스케일 효과와 같은 실제 시각적 아티팩트를 모사하기 위해 의도적으로 낮은 빈도로 적용합니다.Python API를 사용해 사용자 지정 Albumentations 변환을 제공할 수도 있습니다. 자세한 내용은 고급 증강 기능 섹션을 참조하세요.
albumentations패키지가 설치되어 있는지 확인하세요. 설치되어 있지 않다면 설치하세요.pip install albumentations설치하면 Ultralytics가 패키지를 자동으로 감지하여 사용합니다.
사용자 지정 데이터셋 클래스와 트레이너를 만들어 증강을 사용자 지정할 수 있습니다. 예를 들어 기본 Ultralytics 분류 증강을 PyTorch의 torchvision.transforms.Resize나 다른 변환으로 대체할 수 있습니다. 구현 세부 정보는 분류 문서의 사용자 지정 학습 예제를 참조하세요.