YOLOE: 실시간 개방형 어휘 탐지 및 세그멘테이션#
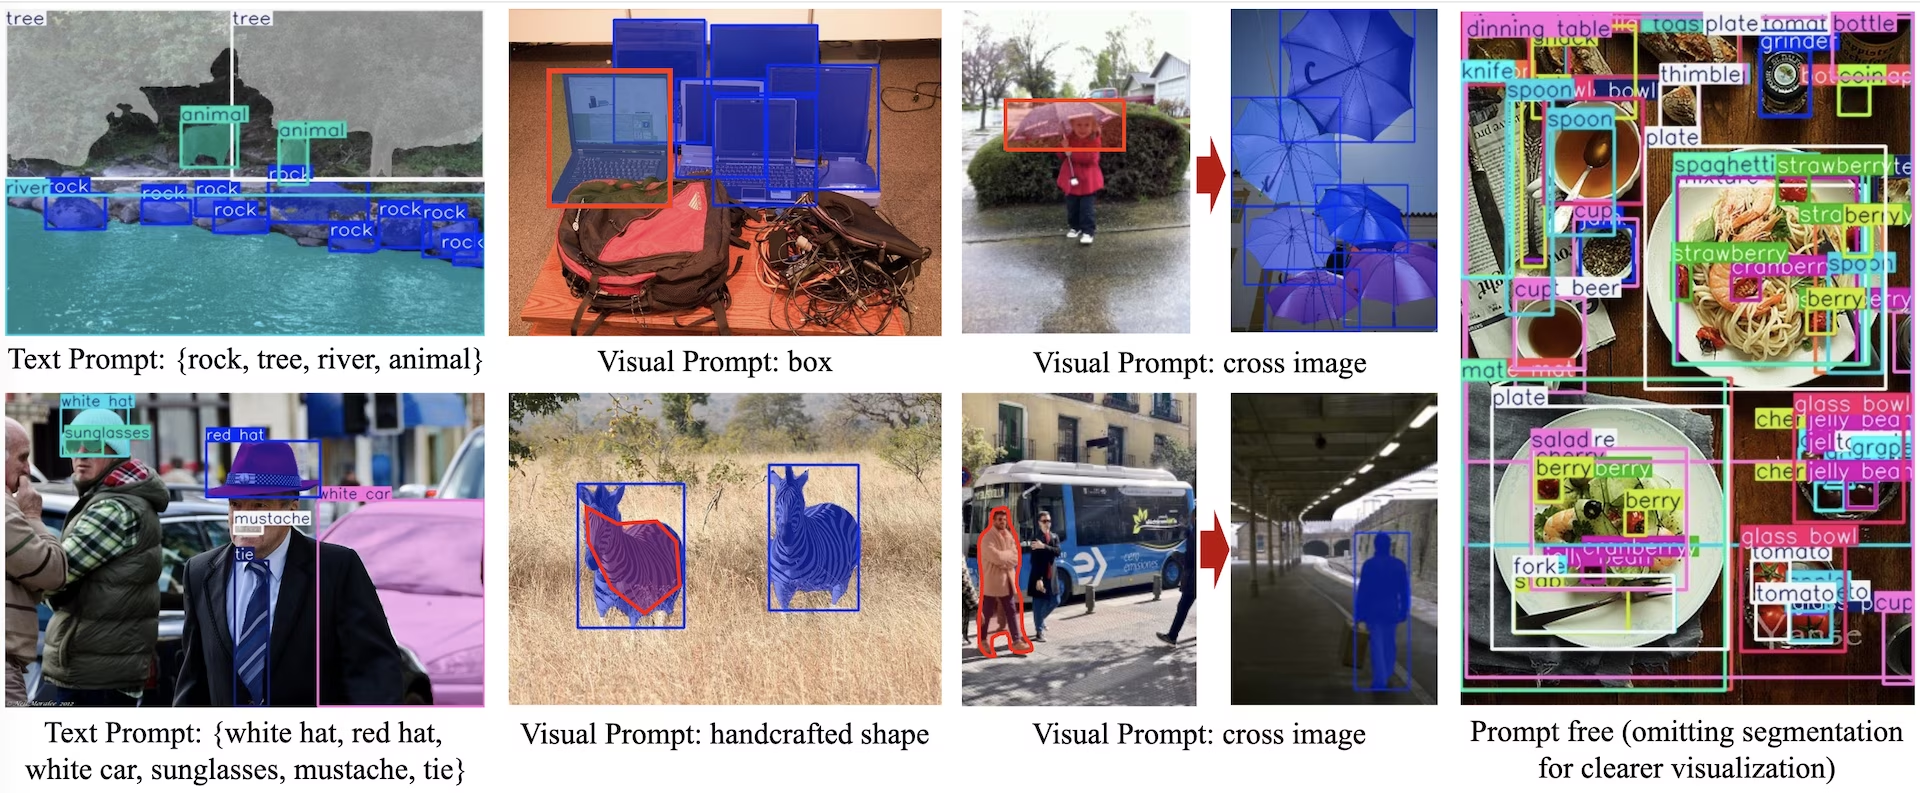
Ultralytics YOLOE(실시간으로 모든 것을 보는 기술)는 개방형 어휘 탐지 및 인스턴스 세그멘테이션 모델입니다. 학습 시 고정된 클래스 목록을 사용하는 대신, 추론 시 텍스트 프롬프트, 시각적 예시 또는 기본 제공되는 4,585개 이름의 어휘를 통해 원하는 카테고리를 지정할 수 있습니다. Ultralytics YOLO 아키텍처인 YOLOv8, YOLO11, YOLO26을 기반으로 하고 YOLO-World에서 영감을 얻은 YOLOE는 폐쇄형 세트 YOLO에 가까운 속도로 최첨단 제로샷 정확도를 달성합니다.
시청: Ultralytics YOLOE-26(신규) 사용 방법 | 개방형 어휘 및 실시간 모든 객체 인식 🚀
빠른 시작#
원하는 클래스를 지정하고 실행하면 됩니다. YOLOE-26은 학습 데이터에 없던 카테고리의 박스와 인스턴스 세그멘테이션 마스크를 반환합니다.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# "2층 버스"는 COCO 클래스가 아닙니다. YOLOE는 단어만으로 이를 찾아냅니다.
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
첫 번째 set_classes() 호출 시 텍스트 인코더를 다운로드합니다. 네트워크에 연결되지 않은 머신에 배포하기 전에 설치 및 요구 사항을 확인하세요.
프롬프트 모드 선택#
YOLOE는 세 가지 프롬프트 모드를 지원하며, 선택한 모드에 따라 불러올 체크포인트와 클래스 레이블의 형식이 결정됩니다. 추론 시 제공할 수 있는 항목에 맞는 행을 선택하세요.
| 모드 | 체크포인트 | 제공 항목 | 결과에 표시되는 클래스 이름 | 사용 시점 |
|---|---|---|---|---|
| 텍스트 프롬프트 | *-seg.pt | 문자열로 된 클래스 이름 | 입력한 이름과 정확히 일치 | 대상을 말로 설명할 수 있는 경우 — 일반적으로 선택하는 방식입니다 |
| 시각적 프롬프트 | *-seg.pt | 참조 이미지의 예시 박스 | 일반적인 object0, object1, … | 대상을 말로 표현할 수 없는 경우: 특정 부품, 로고 또는 결함 |
| 프롬프트 없음 | *-seg-pf.pt | 없음 | 기본 제공되는 4,585개 이름의 어휘에서 가져온 이름 | 카탈로그를 만들거나 탐색하는 중이며 미리 찾으려는 대상을 알지 못하는 경우 |
- 시각적 프롬프트에는 레이블이 포함되지 않습니다.
visual_prompts의 클래스 ID는 예시를 그룹화합니다. 모델은 이를object0,object1등으로 반환합니다. 이를 직접 자체 이름에 매핑해야 합니다. - 프롬프트 없는 체크포인트는
set_classes()을 거부합니다.*-seg-pf.pt모델에 이를 호출하면AssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.오류가 발생합니다. 자체 클래스를 사용해야 하는 경우 대신*-seg.pt체크포인트를 불러오세요.
설치 및 요구 사항#
YOLOE는 기본 Ultralytics 패키지에 포함되어 있습니다:
pip install -U ultralytics텍스트 프롬프트를 사용하려면 여기에 텍스트 인코더가 추가로 필요합니다. 텍스트 인코더는 설치 시점이 아니라 처음 사용할 때 다운로드됩니다:
- 첫 번째
set_classes()호출은pip(토크나이저 제공)를 사용해 GitHub에서 ultralytics/CLIP을 설치하고, TorchScript 텍스트 인코더를 현재 작업 디렉터리에 다운로드합니다. YOLOE-26은 약 254 MB인mobileclip2_b.ts을 다운로드하고, YOLOE-11 및 YOLOE-v8은mobileclip_blt.ts를 다운로드합니다. 실행할 디렉터리에서 한 번 다운로드를 수행하거나 파일을 해당 디렉터리에 복사하세요. 그렇지 않으면 파일이 다시 다운로드됩니다. - 두 단계 모두 네트워크 연결이 필요하므로 오프라인 또는 에어갭 머신에 배포하기 전에 프롬프트를 사용한 예측을 한 번 실행하세요.
- 시각적 프롬프트 및 프롬프트 없는 체크포인트는 텍스트 인코더가 전혀 필요하지 않습니다.
YOLOE-26 체크포인트에는 ultralytics 8.4.0 이상이 필요합니다. YOLOE-11 및 YOLOE-v8 제품군은 이전 릴리스에서도 사용할 수 있습니다. 텍스트 프롬프트를 사용한 예측을 한 번 실행하면 체크포인트 다운로드, CLIP 설치, 텍스트 인코더 및 추론의 전체 경로를 확인할 수 있습니다:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"추론 시 텍스트 인코더 다운로드를 완전히 건너뛰려면 프롬프트를 가중치에 한 번 저장해 재사용하세요. 자세한 내용은 프롬프트 임베딩 재사용을 참조하세요.
아키텍처 개요#

YOLOE는 표준 YOLO 구조를 유지합니다. 특징 추출을 위한 컨볼루션 백본, 다중 스케일 융합을 위한 넥, 클래스와 박스를 예측하는 앵커 프리 분리형 헤드를 사용하며, 각 프롬프트 모드에 하나씩 총 세 가지 모듈을 추가합니다:
- 재매개변수화 가능한 영역-텍스트 정렬(RepRTA)은 작은 보조 네트워크를 통해 CLIP의 텍스트 임베딩을 정제합니다. 이 네트워크는
set_classes()호출마다 한 번 실행된 후 내보내기 시 통합되므로 프레임당 비용이 발생하지 않습니다. 매 순전파에서 실제로 수행되는 작업은 저장된 프롬프트 임베딩을 영역 특징과 비교하는 것입니다. 프롬프트 세트가 큰 경우의 비용은 제한 사항을 참조하세요. - 시맨틱 활성화 시각 프롬프트 인코더(SAVPE)는 예시 박스의 시맨틱 및 활성화 특징을 인코딩해 모델이 해당 박스와 비슷한 객체를 대상으로 작동하도록 합니다. 로고나 특정 부품처럼 이름으로 설명하기 어려운 대상을 위한 원샷 경로입니다.
- 지연 영역-프롬프트 대조(LRPC)는 영역 임베딩을 기본 제공되는 4,585개 이름의 어휘와 비교하므로 프롬프트 없는 체크포인트도 외부 프롬프트나 텍스트 인코더 없이 객체를 인식합니다.
인스턴스 세그멘테이션은 YOLOv8-Seg와 마찬가지로 디텍션 헤드의 마스크 분기에서 비롯되며, 각 예측에는 results[0].masks에 마스크가 포함됩니다. 모델이 내보내지면, 개방형 세계 모듈이 표준 YOLO 헤드로 재매개변수화되므로 내보낸 파일은 일반적인 탐지/세그멘테이션 경로를 실행합니다.
사용 가능한 모델#
아래의 모든 체크포인트는 인스턴스 세그멘테이션 모델이며 val, predict, export, track을 지원합니다. 텍스트 또는 시각적 프롬프트에는 *-seg.pt 파일을, 프롬프트 없는 추론에는 *-seg-pf.pt 파일을 불러오세요. 두 파일은 서로 바꿔 사용할 수 없습니다. 프롬프트 모드 선택을 참조하세요. *-seg.pt 파일만 train을 지원합니다. 프롬프트 없는 체크포인트는 학습된 텍스트 프롬프트 모델에서 생성됩니다. 자세한 내용은 공식 모델을 처음부터 학습하기를 참조하세요.
| 모델 | 텍스트/시각적 프롬프트 | 프롬프트 없음 |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
LVIS에서의 YOLOE 성능#
640픽셀에서 LVIS minival을 대상으로 측정한 제로샷 결과이며, Ultralytics YOLO26 논문을 기준으로 합니다.
텍스트 및 시각적 프롬프트#
각 정확도 및 파라미터 셀은 텍스트 프롬프트 / 시각적 프롬프트 순서이며, FLOPs는 한 번만 표시됩니다. 파라미터와 FLOPs는 논문에서 평가한 탐지 구성에 해당합니다. 정확도는 논문에 제시된 Non-E2E 수치로, 비교 대상의 모든 모델에 대해 보고된 유일한 프로토콜입니다. YOLOE-26 엔드투엔드 헤드의 성능은 텍스트 프롬프트에서 최대 1.1 AP, 시각적 프롬프트에서 최대 2.6 AP 낮습니다.
| 모델 | mAP50-95 | mAPr | mAPc | mAPf | 파라미터 (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
프롬프트 없음#
프롬프트 없는 체크포인트는 프롬프트 입력 없이 기본 제공 어휘를 사용해 예측합니다. 각 정확도 셀은 논문에서 YOLOE-26을 평가한 두 프로토콜인 엔드투엔드 / Non-E2E 순서로 표시됩니다. YOLO26 페이지에는 Non-E2E 열의 값이 인용되어 있습니다.
| 모델 | mAP50-95 | mAPr | mAPc | mAPf | 파라미터 (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
텍스트 및 시각 프롬프트에서 YOLOE-26 모델은 mAP50-95 기준으로 같은 규모의 YOLOE-11 및 YOLOE-v8 모델보다 모두 앞서며, 파라미터 수와 FLOPs는 v8 계열보다 낮게 유지합니다. 같은 데이터 분할에서 논문은 YOLO-Worldv2의 성능을 24.4(S), 32.4(M), 35.5(L)로 보고하고, Transformer 기반 검출기인 GLIP-T는 26.0, GDINO-T는 27.4, DetCLIP-T는 34.4로 각각 155~232 M개의 파라미터를 사용합니다. 원본 YOLOE 논문은 새로 소개한 v8 규모 모델에 대한 결과 두 가지를 추가로 제시합니다. LVIS에서 YOLOE-v8s는 학습 비용의 3분의 1과 1.4배의 추론 속도로 YOLO-Worldv2-S보다 3.5 AP 높은 성능을 냅니다. COCO로 전이 학습했을 때 YOLOE-v8l은 폐쇄형 세트 YOLOv8-L보다 박스 AP 0.6, 마스크 AP 0.4 높으며, 학습 시간은 거의 4배 단축됩니다.
YOLO26 논문에서는 검출 설정을 평가합니다. 공개된 가중치는 세그멘테이션 체크포인트이며 마스크 브랜치, SAVPE, 텍스트 프로젝션이 추가되어 있으므로, 로드된 yoloe-26l-seg.pt은 위의 25.5 M 및 89.0 B가 아니라 35.4 M 및 142.0 B를 보고합니다. 두 경우 모두 FLOPs 수치에는 영역-텍스트 유사도가 포함되지 않으므로 열의 값은 달라지지 않더라도 프롬프트 집합의 크기에 따라 실제 비용은 증가합니다. 자세한 내용은 제한 사항을 참조하세요.
사용 예시#
아래의 모든 YOLOE 예제는 Python API를 사용합니다. 텍스트 프롬프트 예측, 검증, 내보내기, 추적 및 일반 학습은 CLI에서도 사용할 수 있습니다. 미세 조정 레시피와 시각 프롬프트는 트레이너 또는 예측기 클래스를 인수로 전달하며, 이는 Python API에서만 지원됩니다.
학습 사용법#
공개된 *-seg.pt 체크포인트를 사용해 자체 YOLO 데이터셋으로 미세 조정할 수 있습니다. 이 과정은 대체로 표준 YOLO 학습 절차를 따르며, 전달하는 트레이너가 다릅니다. YOLOEPESegTrainer는 클래스 이름을 헤드에 통합한 다음 해당 상태에서 미세 조정하므로 자체 레이블에 적합합니다. 기본 트레이너는 사용자의 클래스 이름을 대상으로 학습하지 않습니다.
시청: 자동차 부품 분할 데이터셋으로 YOLOE를 학습하는 방법 | 개방형 어휘 모델, 예측 및 내보내기 🚀
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- 중요: 기본 트레이너가 아니라 미세 조정 트레이너입니다
)공개된 체크포인트는 모두 세그멘테이션 모델입니다. 검출기를 학습하려면 해당 YAML에서 모델을 생성하고, 같은 규모의 세그멘테이션 가중치를 불러온 다음 검출 트레이너로 교체합니다. 나머지는 변경하지 않습니다.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
예측 사용법#
텍스트 프롬프트 호출은 빠른 시작에 나와 있습니다. 나머지 두 모드에는 각각 추가 인수가 필요합니다.
시각 프롬프트는 대상을 설명하는 대신 예시를 모델에 보여줍니다. visual_prompts에는 예시 박스의 bboxes 배열과 클래스 ID의 cls 배열을 전달하며, 박스마다 ID 하나를 지정합니다. ID는 레이블이 아니라 임시 그룹을 나타내며 0부터 순차적으로 지정해야 합니다. 결과는 사용자가 지정한 이름이 아니라 object0, object1, …로 반환됩니다.
예시 박스는 예측 대상 이미지 위에 배치할 수 있습니다.
import numpy as np

from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor

model = YOLOE("yoloe-26l-seg.pt")

# 대상마다 예시 박스 하나씩, 각각 고유한 클래스 ID 지정
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # 사람, 안경
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
    predictor=YOLOEVPSegPredictor,
)
results[0].show()
또는 별도의 참조 이미지에 배치하고 refer_image으로 전달할 수 있습니다. 이 경우 bboxes과 cls는 대상 이미지가 아니라 참조 이미지의 객체를 설명합니다.
import numpy as np

from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # 대상 이미지
    refer_image="ultralytics/assets/bus.jpg",  # 예시 박스가 있는 위치
    visual_prompts=visual_prompts,
    predictor=YOLOEVPSegPredictor,
)
results[0].show()

# refer_image는 클래스도 영구적으로 설정하므로 이후 호출에는 프롬프트가 전혀 필요하지 않습니다
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # 내보낸 모델에도 클래스가 유지됩니다source이 동영상 또는 스트림인 경우 첫 번째 프레임이 자동으로 refer_image이 되므로 전달한 프롬프트가 해당 프레임에 적용되고 나머지 동영상 프레임에도 이어서 적용됩니다. 다른 프레임을 선택하려면 refer_image를 명시적으로 전달합니다.
source과 refer_image은 모두 torch 텐서를 직접 받을 수 있으며, 이미지가 기존 파이프라인에서 제공되는 경우 유용합니다. 박스는 텐서 자체의 픽셀 좌표로 지정합니다.
import numpy as np
import torch

from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # (1, 3, H, W) [0, 1] 범위의 float 텐서
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    predictor=YOLOEVPSegPredictor,
    imgsz=640,
)
여러 이미지에 한 번에 예측을 수행하려면 프롬프트를 한 단계 더 중첩합니다. 원본 이미지와 같은 순서로 각 원본 이미지마다 bboxes 배열 하나와 cls 배열 하나를 지정합니다.
import numpy as np

from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: 사람, 안경
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: 사람
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
    predictor=YOLOEVPSegPredictor,
)
results[0].show()
검증 사용법#
검증은 세그멘테이션 데이터셋에서 다른 모델과 동일한 방식으로 실행합니다.
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # 또는 다른 크기에는 yoloe-26s/m-seg.pt를 사용합니다

metrics = model.val(data="coco128-seg.yaml")
다른 프롬프트 모드는 동일한 호출의 두 가지 변형으로 사용할 수 있습니다.
- 시각 프롬프트 —
model.val(data="coco128-seg.yaml", load_vp=True)은 데이터셋 자체에서 범주별 시각 임베딩을 추출합니다. 다른 데이터셋에서 임베딩을 가져오려면refer_data="coco.yaml"을 추가합니다. 이 데이터셋에는 정확히 동일한 범주가 포함되어야 합니다. - 프롬프트 없음 —
*-seg-pf.pt체크포인트를 불러오고single_cls=True을 전달합니다.
내보내기 사용법#
프롬프트 임베딩은 한 번 저장한 다음 ONNX, OpenVINO, TensorRT, CoreML, LiteRT, RKNN 등의 정적 내보내기를 생성할 때 재사용할 수 있습니다. 내보내기 전에 원본 PyTorch 모델이 NPZ 프로필을 불러옵니다. NPZ 프로필은 추가 런타임 입력이 아니며, 내보낸 모델에 NPZ 파일이 필요하지 않습니다.
set_classes()으로 설정한 클래스(또는 시각 프롬프트의 경우 refer_image로 설정한 클래스)는 내보낸 가중치에 고정됩니다. 내보낸 후에는 모델이 새 프롬프트를 더 이상 받을 수 없습니다. 로드된 내보내기 모델에서 set_classes()를 호출하거나 predict()에 visual_prompts=...을 전달하면 오류가 발생합니다. 검출 클래스를 변경하려면 새 프롬프트를 설정하고 원본 .pt 체크포인트에서 다시 내보내야 합니다. 내보낸 파일은 표준 YOLO 모델처럼 동작하며 YOLOE() 대신 YOLO()으로도 불러올 수 있습니다.
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# 프로필은 소스 체크포인트에 연결되며 이후 내보내기에도 재사용할 수 있습니다.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
동일한 프롬프트 프로필을 사용하여 일치하는 YOLOE 아키텍처에서 생성한 검출 전용 모델도 설정할 수 있습니다. 이렇게 하면 프롬프트로 지정한 클래스는 유지하면서 마스크 브랜치는 제거됩니다.
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
추적 사용법#
프롬프트로 지정한 클래스는 추적에도 그대로 적용되므로 트래커가 학습한 적 없는 객체도 추적할 수 있습니다.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True를 설정하면 프레임 간 추적 ID가 안정적으로 유지됩니다
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
YOLOE 비교#
YOLOE는 폐쇄형 세트 검출기와 대규모 오픈 어휘 모델 사이에 위치합니다. YOLOE가 적합한 선택인지 판단하려면 다음 세 가지를 비교해야 합니다.
- 폐쇄형 세트 YOLO와 비교. 프롬프트를 설정하면 YOLOE는 일반 검출/세그멘테이션 경로로 예측하고 다른 모델과 마찬가지로 내보냅니다. 재학습 없이 추론 시점에 클래스 목록을 변경할 수 있다는 장점이 있지만, 제로샷 정확도는 자체 클래스에 학습된 모델보다 훨씬 낮습니다.
- 이전 YOLOE 계열과 비교. YOLOE-26은 YOLO26의 NMS 없는 엔드투엔드 헤드를 계승하고, 이전의 세 가지(s/m/l) 규모 대신 다섯 가지(n/s/m/l/x) 규모를 지원합니다. 또한 성능에서 동일한 규모마다 앞섭니다.
- Transformer 기반 오픈 어휘 검출기와 비교. GLIP 및 OWL-ViT는 추론 시 비전-언어 Transformer를 실행합니다. YOLOE는 프롬프트를 한 번 인코딩한 다음 합성곱 헤드 내부에서 영역 특징과 비교합니다.
가장 가까운 대안은 모두 텍스트 프롬프트를 받지만, 마스크를 반환하는 것은 YOLOE와 SAM 3뿐이며 세 모델은 서로 다른 질문에 답합니다.
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| 용도 | 이름이 지정된 클래스의 실시간 검출 및 세그멘테이션 | 개념 세그멘테이션 및 프롬프트 기반 추적 | 실시간 오픈 어휘 검출 |
| 마스크 | 예, *-seg.pt 체크포인트 사용 | 예 | 아니요, 박스만 지원 |
| 시각 프롬프트 | 예(SAVPE) | 예 | 아니요 |
| 프롬프트 없는 모드 | 예, 4,585개 이름의 어휘 | 아니요 | 아니요 |
| 다음과 같은 경우 선택 | 처리량이 중요하고 클래스 이름을 지정할 수 있는 경우 | 가장 강력한 개념 세그멘테이션이 필요하고 연산 비용을 감당할 수 있는 경우 | 이미 사용 중인 경우 — 아래 마이그레이션 참고 사항 참조 |
YOLO-World에서 전환하시나요? API 구조는 동일합니다. YOLOWorld을 YOLOE로 바꾸고, *-seg.pt 체크포인트를 불러온 다음 set_classes() 호출은 그대로 사용합니다. 마스크와 시각 프롬프트를 사용할 수 있으며, 클래스 고정에 관한 내보내기 참고 사항은 두 모델 모두에 적용됩니다.
사용 사례 및 적용 분야#
오픈 어휘 검출을 사용하면 클래스별 재학습 단계를 생략할 수 있습니다. 이는 대상 목록을 사전에 알 수 없는 경우 특히 중요합니다.
- 오픈 월드 검출 — 학습 시점에 열거되지 않은 객체를 마주치는 로보틱스 및 보안 시스템.
- 예시 기반 원샷 검출 — 시각 프롬프트를 사용하면 단일 참조 박스에서 특정 부품, 로고 또는 결함을 포착할 수 있어 산업 검사에 유용합니다.
- 롱테일 카탈로그화 — 4,585개 이름의 내장 어휘는 생물다양성 모니터링이나 소매 재고 조사에 충분히 폭넓습니다.
- 데이터셋 부트스트래핑 — 사람이 검토하기 전에 이미지에 박스와 마스크를 사전 레이블링한 다음, 결과를 사용해 빠른 폐쇄형 세트 모델을 학습합니다.
- 임의 대상 세그멘테이션 — 공개된
*-seg.pt체크포인트는 모든 예측에 마스크를 반환하므로, 의료 영상 및 위성 분석에서 두 번째 모델 없이 픽셀 단위로 정밀한 출력을 얻을 수 있습니다.
두 가지 모드를 결합하는 일반적인 방식은 먼저 프롬프트 없이 실행해 무엇이 있는지 파악한 다음, 중요한 범주에 텍스트 프롬프트를 적용하는 것입니다.
제한 사항#
YOLOE는 추론 시점에 클래스를 변경할 수 있는 대신 정확도가 낮아집니다. 도입 전에 알아두어야 할 주요 사항은 다음과 같습니다.
- 제로샷 정확도는 자체 클래스에 학습된 모델보다 훨씬 낮습니다. 프롬프트가 적용된 체크포인트는 LVIS minival에서 대략 22~40 mAP 수준입니다. 자체 데이터로 학습한 폐쇄형 세트 YOLO 모델은 해당 클래스에서 이보다 높은 성능을 냅니다. 학습할 수 없는 클래스를 다룰 때 YOLOE를 사용하고, 학습을 대체하는 용도로 사용하지 마세요.
- 희귀 범주가 취약한 부분입니다. 성능의 mAPr 열은 LVIS의 희귀 클래스에서만 측정한 정확도를 보고합니다. 텍스트 프롬프트를 사용하면 모든 행에서 일반 및 빈번 클래스 열보다 낮습니다. 대상이 특이한 경우 대표 mAP 수치가 아니라 이 값을 확인하세요.
- 프롬프트는 관계가 아니라 외형을 설명합니다. 검출은 영역 특징을 프롬프트 임베딩과 비교하는 방식으로 이루어지므로 상태, 맥락 또는 비교에 의존하는 프롬프트(예: "손상된", "가장 왼쪽의", "들고 있는 객체")는 안정적으로 대응시킬 기준이 없습니다. 일상적인 범주 이름에 가까운 표현을 사용하세요.
- 프롬프트 집합이 크면 지연 시간이 늘어납니다. 프롬프트 임베딩은 한 번 계산하지만 매 순전파마다 영역 특징과 비교합니다.
yoloe-26s-seg.pt을 사용해 CPU에서 측정한 결과, 클래스 수가 80개에서 1,203개로 늘면 순전파 시간이 약 19%, 전체 4,585개 이름 어휘에서는 약 89% 증가합니다. 영역-텍스트 유사도는 계산에 포함되지 않으므로 보고되는 FLOPs는 전혀 변하지 않으며, 프로파일에도 경고가 표시되지 않습니다. - 프롬프트를 지정하기 전까지 클래스 이름은 자리 표시자입니다. 새로 불러온
*-seg.pt체크포인트는 숫자 이름("0","1", …)으로nc=80을 보고하므로, 레이블을 확인하기 전에set_classes()를 호출해야 합니다. 프롬프트 없는 체크포인트에는 전체 어휘가 이미 채워져 있습니다.
배포 참고 사항#
- 하드웨어. 추론에는 VRAM 4~8 GB를 갖춘 NVIDIA GPU가 필요합니다.
n및s규모 모델은 Jetson과 같은 엣지 GPU에서 실행하거나 해상도를 낮춰 CPU에서 실행할 수 있습니다. 미세 조정에는 GPU 한 개가 필요합니다. - 기본적으로 NMS는 클래스 구분 없이 적용됩니다. YOLOE는
agnostic_nms=True을 사용해 예측합니다. 기본적으로 동일 클래스 내에서만 처리하는 대신 서로 다른 클래스 간에 겹치는 박스 중 점수가 낮은 박스를 억제하여 하나의 객체가 여러 범주에 일치할 때 중복을 방지합니다.nms=False을 사용하면 YOLOE-26은 IoU 억제를 적용하지 않습니다. 클래스 구분 없는 모드에서는 앵커 하나가 여러 클래스 레이블을 출력하지 않고 가장 적합한 클래스 하나만 유지합니다. 재정의하려면agnostic_nms=False를 전달합니다. - 배치 처리. 배치 추론을 바로 사용할 수 있으며, 한 번의 호출에서도 이미지마다 서로 다른 시각 프롬프트를 지정할 수 있습니다.
공식 모델을 처음부터 학습하기#
대부분의 독자에게는 이 과정이 필요하지 않습니다. Objects365, GQA, Flickr30k를 사용해 공개된 오픈 어휘 체크포인트를 재현하는 과정으로, RTX 4090 8개에서 약 140만 개의 학습 샘플을 사용합니다. 자체 데이터에 대한 미세 조정과는 관련이 없으며, 이는 위의 학습 사용법에서 설명합니다.
YOLOETrainer을 상속하는 모든 트레이너는 기본 YOLOESegTrainer와 아래의 모든 처음부터 학습하는 트레이너를 포함해 compile=True을 거부합니다. compile=False(기본값)를 전달하세요. 위에서 사용한 두 미세 조정 트레이너인 YOLOEPESegTrainer와 YOLOEPETrainer에는 이러한 제한이 없습니다.
학습에는 세그먼트 주석이 필요합니다. 아래에서 처리된 파일을 다운로드하거나 공식 팀이 제공하는 스크립트를 사용해 직접 생성할 수 있습니다. 이 스크립트는 SAM 2.1을 기반으로 합니다. 검증에는 LVIS minival을 사용합니다.
| 데이터셋 | 유형 | 샘플 | 박스 | 처리된 세그먼트 주석 |
|---|---|---|---|---|
| Objects365v1 | 탐지 | 609k | 9621k | objects365_train_segm.json |
| GQA | 그라운딩 | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | 그라운딩 | 149k | 641k | final_flickr_separateGT_train_segm.json |
텍스트 프롬프트 모델을 먼저 학습하고, 나머지 두 프롬프트 모드는 해당 모델을 개선해 생성합니다.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # 또는 동일한 구조를 포함하는 YAML 파일의 경로
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
시각 프롬프트 및 프롬프트 없는 체크포인트는 학습된 텍스트 프롬프트 모델에서 시작해 각각 하나의 모듈을 업데이트합니다. YOLOESegVPTrainer은 시각 프롬프트 레시피이고 YOLOEPEFreeTrainer은 프롬프트 없는 레시피이지만, 어느 클래스도 자체적으로 특정 항목을 동결하지는 않습니다. 선택적 학습은 클래스와 함께 전달하는 freeze 목록에서 설정하며, 이 목록에는 savpe을 제외한 모든 헤드 하위 항목(분류 타워의 경우 모든 분류 타워)이 지정됩니다. 프롬프트 없는 실행에는 single_cls=True도 필요합니다. YOLOE 업스트림 저장소에는 v8 규모 모델의 전체 레시피가 포함되어 있습니다.
프롬프트 없는 실행이 완료되면 재매개변수화하여 추론 시 프롬프트 없이 클래스 이름을 보고하는 체크포인트를 생성합니다. 이때 get_vocab 및 set_vocab를 사용합니다.
from ultralytics import YOLOE

# 프롬프트 없는 실행과 그 실행의 기반이 된 텍스트 프롬프트 실행에서 기록한 가중치입니다. 각각
# 다시 실행할 때마다 새 디렉터리(train-2, train-3, ...)가 생성되므로 실행 로그에 출력된 경로를 사용하세요.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # 프롬프트 없는 실행에서는 헤드가 이미 퓨즈된 상태입니다.
text_model = YOLOE("runs/segment/train/weights/best.pt")  # 텍스트 프롬프트 실행에서는 헤드가 아직 퓨즈되지 않은 상태입니다.

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # 4,585개 이름으로 이루어진 어휘 목록 또는 직접 만든 목록입니다.
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt") # 배포된 체크포인트를 덮어쓰지 마세요.get_vocab은 모델의 end2end 플래그가 선택하는 분기를 반환하고, set_vocab는 해당 분기를 재매개변수화합니다. 배포된 YOLOE-26 파일에는 분기별 어휘 목록이 포함되어 있어 nms이 두 분기 중 하나를 선택할 수 있습니다. 이를 재현하려면 텍스트 프롬프트 모델의 사본을 하나 더 만들고 그 사본에서 두 번째 어휘 목록을 가져오세요. YOLOE-11과 YOLOE-v8에는 분기가 하나뿐이므로 위 호출을 그대로 사용합니다.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab은 읽어 들이는 헤드를 퓨즈하므로 사본을 하나 더 로드하세요.
one2one_model.model.end2end = True  # NMS가 없는 분기를 읽습니다.

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
인용 및 감사의 글#
YOLOE가 연구 또는 프로젝트에 기여했다면 칭화대학교의 Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han, Guiguang Ding이 작성한 원 논문을 인용해 주세요.
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
자세한 내용은 원본 YOLOE 논문을 arXiv에서 확인할 수 있습니다. 프로젝트 소스 코드와 추가 리소스는 GitHub 저장소에서 확인할 수 있습니다.
자주 묻는 질문#
Ultralytics YOLOE에는 YOLO-World에는 없는 두 가지 기능이 추가되었습니다. 예시 박스가 클래스 이름을 대체하는 시각 프롬프트와, 아무런 프롬프트 없이 내장된 4,585개 이름의 어휘 목록을 바탕으로 답을 생성하는 프롬프트 없는 체크포인트입니다. 배포된
*-seg.pt체크포인트의 모든 예측에는 인스턴스 분할 마스크도 포함됩니다. 정확도 측면에서 원본 YOLOE 논문은 YOLOE-v8s가 LVIS에서 YOLO-Worldv2-S보다 AP가 3.5 높고, 학습 비용은 3분의 1이며 추론 속도는 1.4배 빠르다고 보고합니다. 한 줄만 변경하면 마이그레이션할 수 있습니다. 자세한 내용은 YOLOE 비교를 참조하세요.Ultralytics YOLOE는 세 가지 프롬프트 모드를 지원합니다. 텍스트 프롬프트는
*-seg.pt체크포인트에 문자열로 클래스 이름을 지정하는 방식이며, 일반적으로 가장 많이 사용됩니다. 시각 프롬프트는 참조 이미지에 하나 이상의 예시 박스를 지정하는 방식으로, 말로 표현하기 어려운 대상을 지정할 때 유용합니다. 프롬프트 없는 추론은 별도의*-seg-pf.pt체크포인트를 사용하며, 아무것도 입력하지 않아도 내장된 4,585개 이름의 어휘 목록을 바탕으로 답을 생성합니다. 텍스트 프롬프트와 시각 프롬프트는 동일한 체크포인트를 사용하지만, 프롬프트 없는 체크포인트는 별도 파일이며set_classes()를 거부합니다. 전체 비교는 프롬프트 모드 선택을 참조하세요.yoloe-26s-seg.pt으로 시작하세요. YOLOE-26 제품군은 모든 동일 규모 비교에서 YOLOE-11 및 YOLOE-v8보다 우수하며,s규모 모델은 LVIS minival에서 30 mAP를 넘는 가장 작은 모델입니다. 지연 시간보다 희귀 범주 정확도가 중요하다면m,l또는x로 확장하세요. 비교할 항목은 성능의 mAPr 열입니다. 엣지 배포에서만n로 낮추세요. 사용자 지정 클래스 이름 대신 내장 어휘 목록을 사용하려면 같은 규모의*-seg-pf.pt파일을 로드하세요.object0및object1과 같은 레이블은 예측이 시각 프롬프트에서 생성되었음을 의미합니다. 시각 프롬프트는 사용자가 지정한 이름을 유지하는 대신 예시 박스를 임시 번호 클래스에 그룹화합니다.visual_prompts["cls"]에 전달하는 클래스 ID는 그룹화에만 사용됩니다. 모델은 지정한 ID 순서에 따라object0,object1등으로 결과를 보고하므로 결과에서 이를 자체 레이블에 대응시켜야 합니다. 출력에 사용자가 지정한 이름을 표시하려면 텍스트 프롬프트를 사용하세요.프롬프트 없는 체크포인트(
*-seg-pf.pt)는 자체 내장 어휘 목록으로 클래스를 확인하며AssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.을 사용한 외부 프롬프트를 거부합니다. 자체 클래스 목록이 필요하면*-seg.pt체크포인트를 로드하세요. 프롬프트 모드 선택을 참조하세요.첫 텍스트 프롬프트를 사용하면 Ultralytics YOLOE가 GitHub에서 ultralytics/CLIP을
pip과 함께 설치하고 현재 작업 디렉터리에 TorchScript 텍스트 인코더를 다운로드합니다. YOLOE-26의 경우 약 254 MB입니다. 모델 제품군별 정확한 리소스는 설치 및 요구 사항을 참조하세요. 시각 프롬프트와 프롬프트 없는 체크포인트에는 둘 다 필요하지 않습니다. 대상 머신에서 다운로드를 방지하려면 프롬프트를 한 번 설정한 뒤save_prompt_embeddings()을 사용해 저장하거나, 클래스가 이미 설정된 상태로 모델을 내보내세요.아니요. YOLOE는 내보낼 때 프롬프트로 지정한 클래스를 가중치에 포함하므로, 로드된 내보내기 모델은
set_classes()과visual_prompts=을 모두 거부합니다. 새 프롬프트를 설정한 뒤 원본.pt체크포인트에서 다시 내보내세요. 내보낸 파일은 표준 YOLO 모델처럼 작동하며YOLO()뿐 아니라YOLOE()로도 로드할 수 있습니다.