Otimização da inferência do YOLO com OpenVINO#
Introdução#
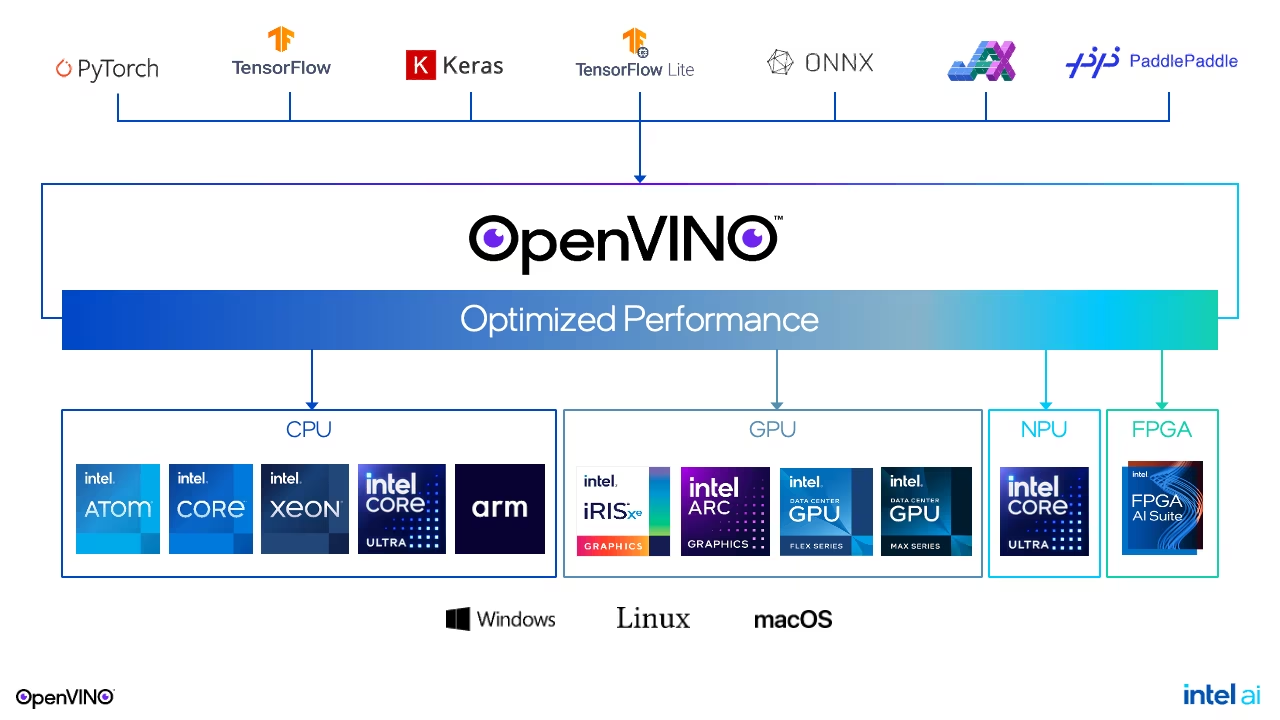
Ao implementar modelos de aprendizagem profunda, especialmente os de deteção de objetos, como os modelos Ultralytics YOLO, é fundamental alcançar o melhor desempenho possível. Este guia explora como tirar partido do kit de ferramentas OpenVINO da Intel para otimizar a inferência, com foco na latência e no throughput. Quer estejas a trabalhar em aplicações para consumidores ou em implementações em larga escala, compreender e aplicar estas estratégias de otimização vai garantir que os teus modelos funcionam eficientemente em vários dispositivos.
Otimização da latência#
A otimização da latência é essencial para aplicações que exigem uma resposta imediata de um único modelo para uma única entrada, algo comum em cenários de consumo. O objetivo é minimizar o atraso entre a entrada e o resultado da inferência. No entanto, alcançar uma latência baixa exige uma análise cuidadosa, especialmente ao executar inferências simultâneas ou gerir vários modelos.
Principais estratégias para otimizar a latência#
- Uma inferência por dispositivo: a forma mais simples de alcançar uma latência baixa é limitar cada dispositivo a uma inferência de cada vez. Muitas vezes, a concorrência adicional aumenta a latência.
- Tirar partido dos subdispositivos: dispositivos como CPUs com vários sockets ou GPUs com vários tiles podem executar vários pedidos com um aumento mínimo da latência, tirando partido dos seus subdispositivos internos.
- Dicas de desempenho do OpenVINO: usar
ov::LATENCYdo OpenVINO para a propriedadeov::performance_modedurante a compilação do modelo simplifica o ajuste de desempenho e oferece uma abordagem independente do dispositivo e preparada para o futuro.
Gerir a latência da primeira inferência#
- Armazenamento em cache do modelo: para reduzir o impacto dos tempos de carregamento e compilação do modelo na latência, usa o armazenamento em cache do modelo sempre que possível. Nos casos em que o armazenamento em cache não é viável, as CPUs geralmente oferecem os tempos de carregamento de modelo mais rápidos.
- Mapeamento do modelo vs. leitura: para reduzir os tempos de carregamento, o OpenVINO substituiu a leitura do modelo pelo mapeamento. No entanto, se o modelo estiver numa unidade removível ou de rede, considera usar
ov::enable_mmap(false)para voltar à leitura. - Seleção automática do dispositivo: este modo inicia a inferência na CPU e passa para um acelerador assim que este estiver pronto, reduzindo sem interrupções a latência da primeira inferência.
Otimização do throughput#
A otimização do throughput é essencial em cenários que processam muitos pedidos de inferência em simultâneo, maximizando a utilização de recursos sem prejudicar significativamente o desempenho de cada pedido.
Abordagens para otimizar o throughput#
-
Dicas de desempenho do OpenVINO: um método de alto nível, preparado para o futuro, que melhora o throughput em vários dispositivos com dicas de desempenho.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Agrupamento explícito e fluxos: uma abordagem mais granular, que envolve o agrupamento explícito e o uso de fluxos para um ajuste avançado do desempenho.
Conceber aplicações orientadas para o throughput#
Para maximizar o throughput, as aplicações devem:
- Processar as entradas em paralelo, aproveitando ao máximo os recursos do dispositivo.
- Dividir o fluxo de dados em pedidos de inferência simultâneos, agendados para execução paralela.
- Usar a API assíncrona com callbacks para manter a eficiência e evitar que o dispositivo fique sem trabalho.
Execução em vários dispositivos#
O modo de vários dispositivos do OpenVINO simplifica o aumento do throughput ao distribuir automaticamente os pedidos de inferência entre dispositivos, sem exigir a gestão dos dispositivos ao nível da aplicação.
Ganhos de desempenho no mundo real#
A implementação de otimizações do OpenVINO com modelos Ultralytics YOLO pode proporcionar melhorias significativas de desempenho. Como demonstram os benchmarks, os utilizadores podem obter inferências até 3 vezes mais rápidas em CPUs Intel, com acelerações ainda maiores possíveis em todo o portefólio de hardware da Intel, incluindo GPUs integradas, GPUs dedicadas e NPUs.
Por exemplo, ao executar modelos YOLO26 em CPUs Intel Xeon, as versões otimizadas com OpenVINO superam consistentemente as versões PyTorch em tempo de inferência por imagem, sem comprometer a precisão.
Implementação prática#
Para exportar e otimizar o teu modelo Ultralytics YOLO para OpenVINO, podes usar a funcionalidade de exportação:
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")

# Exporta o modelo para o formato OpenVINO
model.export(format="openvino", quantize=16)  # Exporta com precisão FP16
Após a exportação, podes executar a inferência com o modelo otimizado:
# Carrega o modelo OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")

# Executa a inferência (o Ultralytics compila modelos OpenVINO com a dica de desempenho LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)Conclusão#
Otimizar modelos Ultralytics YOLO para latência e throughput com OpenVINO pode melhorar significativamente o desempenho da tua aplicação. Ao aplicar cuidadosamente as estratégias descritas neste guia, os programadores podem garantir que os modelos funcionam eficientemente e satisfazem as exigências de vários cenários de implementação. Lembra-te: a escolha entre otimizar para latência ou throughput depende das necessidades específicas da tua aplicação e das características do ambiente de implementação.
Para obteres informações técnicas mais detalhadas e as atualizações mais recentes, consulta a documentação do OpenVINO e o repositório Ultralytics YOLO. Estes recursos oferecem guias aprofundados, tutoriais e apoio da comunidade para te ajudar a tirar o máximo partido dos teus modelos de aprendizagem profunda.
Garantir que os teus modelos alcançam o melhor desempenho possível não se resume a ajustar configurações; é preciso compreender as necessidades da tua aplicação e tomar decisões informadas. Quer estejas a otimizar para respostas em tempo real ou a maximizar o throughput do processamento em larga escala, a combinação dos modelos Ultralytics YOLO com OpenVINO oferece aos programadores um conjunto poderoso de ferramentas para implementar soluções de IA de alto desempenho.
Perguntas frequentes#
Otimizar modelos Ultralytics YOLO para baixa latência envolve várias estratégias importantes:
- Uma inferência por dispositivo: limita as inferências a uma de cada vez por dispositivo para minimizar os atrasos.
- Tirar partido dos subdispositivos: usa dispositivos como CPUs com vários sockets ou GPUs com vários tiles, que conseguem processar vários pedidos com um aumento mínimo da latência.
- Dicas de desempenho do OpenVINO: usa
ov::LATENCYdo OpenVINO durante a compilação do modelo para simplificar o ajuste independente do dispositivo.
Para mais sugestões práticas sobre como otimizar a latência, consulta a secção sobre otimização da latência do nosso guia.
O OpenVINO aumenta o throughput dos modelos Ultralytics YOLO ao maximizar a utilização dos recursos do dispositivo sem sacrificar o desempenho. Entre as principais vantagens estão:
- Dicas de desempenho: ajuste de desempenho simples e de alto nível em vários dispositivos.
- Agrupamento explícito e fluxos: ajuste fino para melhorar o desempenho de forma avançada.
- Execução em vários dispositivos: balanceamento automático da carga de inferência, simplificando a gestão ao nível da aplicação.
Exemplo de configuração:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Sabe mais sobre a otimização do throughput na secção sobre otimização do throughput do nosso guia detalhado.
Para reduzir a latência da primeira inferência, considera estas práticas:
- Armazenamento em cache do modelo: usa o armazenamento em cache do modelo para reduzir os tempos de carregamento e compilação.
- Mapeamento do modelo vs. leitura: usa o mapeamento (
ov::enable_mmap(true)) por predefinição, mas muda para a leitura (ov::enable_mmap(false)) se o modelo estiver numa unidade removível ou de rede. - Seleção automática do dispositivo: usa o modo AUTO para iniciar a inferência na CPU e passar sem interrupções para um acelerador.
Para conheceres estratégias detalhadas de gestão da latência da primeira inferência, consulta a secção sobre gestão da latência da primeira inferência.
Equilibrar a otimização da latência e do throughput exige compreender as necessidades da tua aplicação:
- Otimização da latência: ideal para aplicações em tempo real que exigem respostas imediatas (por exemplo, aplicações para consumidores).
- Otimização do throughput: ideal para cenários com muitas inferências simultâneas, maximizando o uso dos recursos (por exemplo, implementações em larga escala).
As dicas de desempenho de alto nível e os modos de vários dispositivos do OpenVINO podem ajudar a encontrar o equilíbrio certo. Escolhe as dicas de desempenho do OpenVINO adequadas aos teus requisitos específicos.
Sim, os modelos Ultralytics YOLO são muito versáteis e podem ser integrados com várias estruturas de IA. Entre as opções estão:
- TensorRT: para otimização em GPUs NVIDIA, segue o guia de integração do TensorRT.
- CoreML: para dispositivos Apple, consulta as nossas instruções de exportação do CoreML.
- LiteRT.js: para aplicações Web e Node.js, consulta o guia de integração do LiteRT e o ambiente de execução Web do LiteRT.js.
Descobre mais integrações na página de integrações do Ultralytics.