Implante um modelo YOLO pré-treinado com Ultralytics no Vertex AI para inferência#
Este guia mostra como conteinerizar um modelo YOLO26 pré-treinado com Ultralytics, criar um servidor de inferência FastAPI e implantar o modelo com o servidor de inferência no Google Cloud Vertex AI. A implementação de exemplo aborda o caso de uso de detecção de objetos com YOLO26, mas os mesmos princípios se aplicam ao uso de outras tarefas YOLO.
Antes de começar, você precisará criar um projeto do Google Cloud Platform (GCP). Como novo usuário, você recebe US$ 300 em créditos do GCP para usar gratuitamente, um valor suficiente para testar uma configuração em funcionamento que poderá ampliar depois para qualquer outro caso de uso do YOLO26, incluindo treinamento ou inferência em lote e por streaming.
O que você vai aprender#
- Criar um back-end de inferência para o modelo Ultralytics YOLO26 usando FastAPI.
- Criar um repositório do GCP Artifact Registry para armazenar sua imagem Docker.
- Criar e enviar a imagem Docker com o modelo para o Artifact Registry.
- Importar seu modelo para o Vertex AI.
- Criar um endpoint do Vertex AI e implantar o modelo.
- Controle total do modelo com Ultralytics: você pode usar lógica de inferência personalizada, com controle completo sobre o pré-processamento, o pós-processamento e a formatação da resposta.
- O Vertex AI cuida do restante: ele escala automaticamente e ainda oferece flexibilidade para configurar recursos computacionais, memória e configurações de GPU.
- Integrações nativas com o GCP e segurança: configuração simples com Cloud Storage, BigQuery, Cloud Functions, controles de VPC, políticas de IAM e registros de auditoria.
Pré-requisitos#
- Instale o Docker na sua máquina.
- Instale o Google Cloud SDK e faça a autenticação para usar a CLI do gcloud.
- É altamente recomendável consultar o Guia de início rápido do Docker para Ultralytics, pois, ao seguir este guia, você precisará estender uma das imagens Docker oficiais da Ultralytics.
1. Criar um back-end de inferência com FastAPI#
Primeiro, você precisa criar uma aplicação FastAPI que processe as solicitações de inferência do modelo YOLO26. Essa aplicação cuidará do carregamento do modelo, do pré-processamento das imagens e da lógica de inferência (predição).
Fundamentos de conformidade do Vertex AI#
O Vertex AI espera que seu contêiner implemente dois endpoints específicos:
-
Endpoint Health (
/health): deve retornar o status HTTP200 OKquando o serviço estiver pronto. -
Endpoint Predict (
/predict): aceita solicitações de predição estruturadas com imagens codificadas em base64 e parâmetros opcionais. Aplicam-se limites de tamanho da carga útil, dependendo do tipo de endpoint.As cargas úteis de solicitação para o endpoint
/predictdevem seguir esta estrutura JSON:{ "instances": [{ "image": "base64_encoded_image" }], "parameters": { "confidence": 0.5 } }
Estrutura de pastas do projeto#
A maior parte da compilação acontecerá dentro do contêiner Docker, e a Ultralytics também carregará um modelo YOLO26 pré-treinado. Portanto, você pode manter simples a estrutura de pastas local:
YOUR_PROJECT/
├── src/
│   ├── __init__.py
│   ├── app.py              # Core YOLO26 inference logic
│   └── main.py             # FastAPI inference server
├── tests/
├── .env                    # Environment variables for local development
├── Dockerfile              # Container configuration
├── LICENSE                 # AGPL-3.0 License
└── pyproject.toml # Python dependencies and project configOs modelos e a estrutura de trabalho Ultralytics YOLO26 são licenciados sob AGPL-3.0, que tem requisitos importantes de conformidade. Leia a documentação da Ultralytics sobre como cumprir os termos da licença.
Criar pyproject.toml com as dependências#
Para gerenciar seu projeto com praticidade, crie um arquivo pyproject.toml com as seguintes dependências:
[project]
name = "YOUR_PROJECT_NAME"
version = "0.0.1"
description = "YOUR_PROJECT_DESCRIPTION"
requires-python = ">=3.10,<3.13"
dependencies = [
   "ultralytics>=8.4.0",
   "fastapi[all]>=0.89.1",
   "uvicorn[standard]>=0.20.0",
   "pillow>=9.0.0",
   "loguru",
]

[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"uvicornserá usado para executar o servidor FastAPI.loguruserá usado para registrar logs no servidor FastAPI.pillowserá usado para o processamento de imagens, mas você não está limitado apenas a imagens PIL — a Ultralytics oferece suporte a muitos outros formatos.
Criar a lógica de inferência com Ultralytics YOLO26#
Agora que você configurou a estrutura do projeto e as dependências, pode implementar a lógica principal de inferência do YOLO26. Crie um arquivo src/app.py para cuidar do carregamento do modelo, do processamento de imagens e da predição, usando a API Python da Ultralytics.
# src/app.py

from ultralytics import YOLO

# Model initialization and readiness state
model_yolo = None
_model_ready = False

def _initialize_model():
    """Initialize the YOLO model."""
    global model_yolo, _model_ready

    try:
        # Use pretrained YOLO26n model from Ultralytics base image
        model_yolo = YOLO("yolo26n.pt")
        _model_ready = True

    except Exception as e:
        print(f"Error initializing YOLO model: {e}")
        _model_ready = False
        model_yolo = None

# Initialize model on module import
_initialize_model()

def is_model_ready() -> bool:
    """Check if the model is ready for inference."""
    return _model_ready and model_yolo is not None
Isso carregará o modelo uma vez, quando o contêiner iniciar, e o modelo será compartilhado entre todas as solicitações. Se o modelo for lidar com uma carga elevada de inferência, recomendamos selecionar uma máquina com mais memória ao importar o modelo para o Vertex AI em uma etapa posterior.
Em seguida, crie duas funções utilitárias para processar as imagens de entrada e saída com pillow. O YOLO26 oferece suporte nativo a imagens PIL.
def get_image_from_bytes(binary_image: bytes) -> Image.Image:
    """Convert image from bytes to PIL RGB format."""
    input_image = Image.open(io.BytesIO(binary_image)).convert("RGB")
    return input_image
def get_bytes_from_image(image: Image.Image) -> bytes:
"""Convert PIL image to bytes."""
return_image = io.BytesIO()
image.save(return_image, format="JPEG", quality=85)
return_image.seek(0)
return return_image.getvalue()Por fim, implemente a função run_inference para lidar com a detecção de objetos. Neste exemplo, extrairemos as caixas delimitadoras, os nomes das classes e as pontuações de confiança das predições do modelo. A função retornará um dicionário com as detecções e os resultados brutos para processamento ou anotação posterior.
def run_inference(input_image: Image.Image, confidence_threshold: float = 0.5) -> Dict[str, Any]:
    """Run inference on an image using YOLO26n model."""
    # Check if model is ready
    if not is_model_ready():
        print("Model not ready for inference")
        return {"detections": [], "results": None}

    try:
        # Make predictions and get raw results
        results = model_yolo.predict(
            imgsz=640, source=input_image, conf=confidence_threshold, save=False, augment=False, verbose=False
        )

        # Extract detections (bounding boxes, class names, and confidences)
        detections = []
        if results and len(results) > 0:
            result = results[0]
            if result.boxes is not None and len(result.boxes.xyxy) > 0:
                boxes = result.boxes

                # Convert tensors to numpy for processing
                xyxy = boxes.xyxy.cpu().numpy()
                conf = boxes.conf.cpu().numpy()
                cls = boxes.cls.cpu().numpy().astype(int)

                # Create detection dictionaries
                for i in range(len(xyxy)):
                    detection = {
                        "xmin": float(xyxy[i][0]),
                        "ymin": float(xyxy[i][1]),
                        "xmax": float(xyxy[i][2]),
                        "ymax": float(xyxy[i][3]),
                        "confidence": float(conf[i]),
                        "class": int(cls[i]),
                        "name": model_yolo.names.get(int(cls[i]), f"class_{int(cls[i])}"),
                    }
                    detections.append(detection)

        return {
            "detections": detections,
            "results": results,  # Keep raw results for annotation
        }
    except Exception as e:
        # If there's an error, return empty structure
        print(f"Error in YOLO detection: {e}")
        return {"detections": [], "results": None}
Opcionalmente, você pode adicionar uma função para anotar a imagem com caixas delimitadoras e rótulos usando o método integrado de plotagem da Ultralytics. Isso será útil se quiser retornar imagens anotadas na resposta da predição.
def get_annotated_image(results: list) -> Image.Image:
    """Get annotated image using Ultralytics built-in plot method."""
    if not results or len(results) == 0:
        raise ValueError("No results provided for annotation")

    result = results[0]
    # Usar o método integrado de plotagem da Ultralytics com saída PIL
    return result.plot(pil=True)
Criar um servidor de inferência HTTP com FastAPI#
Agora que você tem a lógica principal de inferência do YOLO26, pode criar uma aplicação FastAPI para disponibilizá-la. Ela incluirá os endpoints de verificação de integridade e de predição exigidos pelo Vertex AI.
Primeiro, crie src/main.py, adicione as importações, crie a aplicação FastAPI e configure o registro de logs para o Vertex AI. Como o Vertex AI trata stderr como saída de erro, faz sentido direcionar os logs para stdout.
# src/main.py

import sys

from fastapi import FastAPI
from loguru import logger

app = FastAPI()

# Configurar o logger
logger.remove()
logger.add(
    sys.stdout,
    colorize=True,
    format="<green>{time:HH:mm:ss}</green> | <level>{message}</level>",
    level=10,
)
logger.add("log.log", rotation="1 MB", level="DEBUG", compression="zip")
Para garantir a conformidade total com o Vertex AI, defina os endpoints obrigatórios em variáveis de ambiente e estabeleça o limite de tamanho das solicitações. Recomendamos usar endpoints privados do Vertex AI em implantações de produção. Assim, você terá um limite maior para a carga útil das solicitações (10 MB em vez de 1,5 MB nos endpoints públicos), além de segurança robusta e controle de acesso.
# Variáveis de ambiente do Vertex AI
AIP_HTTP_PORT = int(os.getenv("AIP_HTTP_PORT", "8080"))
AIP_HEALTH_ROUTE = os.getenv("AIP_HEALTH_ROUTE", "/health")
AIP_PREDICT_ROUTE = os.getenv("AIP_PREDICT_ROUTE", "/predict")

# Limite de tamanho da solicitação (10 MB para endpoints privados, 1,5 MB para públicos)
MAX_REQUEST_SIZE = 10 * 1024 * 1024  # 10 MB em bytes
Adicione dois modelos Pydantic para validar suas solicitações e respostas:
# Modelos Pydantic para solicitação/resposta
class PredictionRequest(BaseModel):
    instances: list
    parameters: Optional[Dict[str, Any]] = None

class PredictionResponse(BaseModel):
    predictions: list
Adicione o endpoint de verificação de integridade para confirmar que seu modelo está pronto. Isso é importante para o Vertex AI: sem uma verificação de integridade dedicada, o orquestrador enviará pings a sockets aleatórios e não conseguirá determinar se o modelo está pronto para inferência. A verificação deve retornar 200 OK em caso de sucesso e 503 Service Unavailable em caso de falha:
# Endpoint de verificação de integridade
@app.get(AIP_HEALTH_ROUTE, status_code=status.HTTP_200_OK)
def health_check():
    """Health check endpoint for Vertex AI."""
    if not is_model_ready():
        raise HTTPException(status_code=503, detail="Model not ready")
    return {"status": "healthy"}
Agora você tem tudo para implementar o endpoint de predição que processará as solicitações de inferência. Ele aceitará um arquivo de imagem, executará a inferência e retornará os resultados. Observe que a imagem deve ser codificada em base64, o que também aumenta o tamanho da carga útil em até 33%.
@app.post(AIP_PREDICT_ROUTE, response_model=PredictionResponse)
async def predict(request: PredictionRequest):
    """Prediction endpoint for Vertex AI."""
    try:
        predictions = []

        for instance in request.instances:
            if isinstance(instance, dict):
                if "image" in instance:
                    image_data = base64.b64decode(instance["image"])
                    input_image = get_image_from_bytes(image_data)
                else:
                    raise HTTPException(status_code=400, detail="Instance must contain 'image' field")
            else:
                raise HTTPException(status_code=400, detail="Invalid instance format")

            # Extract YOLO26 parameters if provided
            parameters = request.parameters or {}
            confidence_threshold = parameters.get("confidence", 0.5)
            return_annotated_image = parameters.get("return_annotated_image", False)

            # Run inference with YOLO26n model
            result = run_inference(input_image, confidence_threshold=confidence_threshold)
            detections_list = result["detections"]

            # Format predictions for Vertex AI
            detections = []
            for detection in detections_list:
                formatted_detection = {
                    "class": detection["name"],
                    "confidence": detection["confidence"],
                    "bbox": {
                        "xmin": detection["xmin"],
                        "ymin": detection["ymin"],
                        "xmax": detection["xmax"],
                        "ymax": detection["ymax"],
                    },
                }
                detections.append(formatted_detection)

            # Build prediction response
            prediction = {"detections": detections, "detection_count": len(detections)}

            # Add annotated image if requested and detections exist
            if (
                return_annotated_image
                and result["results"]
                and result["results"][0].boxes is not None
                and len(result["results"][0].boxes) > 0
            ):
                annotated_image = get_annotated_image(result["results"])
                img_bytes = get_bytes_from_image(annotated_image)
                prediction["annotated_image"] = base64.b64encode(img_bytes).decode("utf-8")

            predictions.append(prediction)

        logger.info(
            f"Processed {len(request.instances)} instances, found {sum(len(p['detections']) for p in predictions)} total detections"
        )

        return PredictionResponse(predictions=predictions)

    except HTTPException:
        # Re-raise HTTPException as-is (don't catch and convert to 500)
        raise
    except Exception as e:
        logger.error(f"Prediction error: {e}")
        raise HTTPException(status_code=500, detail=f"Prediction failed: {e}")
Por fim, adicione o ponto de entrada da aplicação para executar o servidor FastAPI.
if __name__ == "__main__":
    import uvicorn

    logger.info(f"Starting server on port {AIP_HTTP_PORT}")
    logger.info(f"Health check route: {AIP_HEALTH_ROUTE}")
    logger.info(f"Predict route: {AIP_PREDICT_ROUTE}")
    uvicorn.run(app, host="0.0.0.0", port=AIP_HTTP_PORT)
Agora você tem uma aplicação FastAPI completa que pode processar solicitações de inferência do YOLO26. Você pode testá-la localmente instalando as dependências e executando o servidor, por exemplo, com uv.
# Install dependencies
uv pip install -e .

# Run the FastAPI server directly
uv run src/main.py
Para testar o servidor, você pode consultar os endpoints /health e /predict usando cURL. Coloque uma imagem de teste na pasta tests. Em seguida, execute os seguintes comandos no Terminal:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
Você deverá receber uma resposta JSON com os objetos detectados. Espere um breve atraso na primeira solicitação, pois a Ultralytics precisa baixar e carregar o modelo YOLO26.
2. Estender a imagem Docker da Ultralytics com sua aplicação#
A Ultralytics oferece várias imagens Docker que você pode usar como base para a imagem da sua aplicação. Elas incluem a Ultralytics e as bibliotecas CUDA necessárias, então você só precisa adicionar sua aplicação.
Para aproveitar todos os recursos dos modelos Ultralytics YOLO, selecione a imagem otimizada para CUDA para inferência em GPU. No entanto, se a inferência em CPU for suficiente para sua tarefa, você também poderá economizar recursos computacionais selecionando a imagem somente para CPU:
- Dockerfile: imagem otimizada para CUDA, destinada ao treinamento e à inferência do YOLO26 com uma ou várias GPU.
- Dockerfile-cpu: imagem somente para CPU, destinada à inferência do YOLO26.
Criar uma imagem Docker para sua aplicação#
Crie um Dockerfile na raiz do seu projeto com o seguinte conteúdo:
# Extends official Ultralytics Docker image for YOLO26
FROM ultralytics/ultralytics:latest

ENV PYTHONUNBUFFERED=1

# Install FastAPI and dependencies
RUN uv pip install --system fastapi[all] uvicorn[standard] loguru

WORKDIR /app
COPY src/ ./src/
COPY pyproject.toml ./

# Install the application package
RUN uv pip install --system -e .

RUN mkdir -p /app/logs
ENV PYTHONPATH=/app/src

# Port for Vertex AI
EXPOSE 8080

# Start the inference server
ENTRYPOINT ["python", "src/main.py"]
No exemplo, a imagem Docker oficial da Ultralytics ultralytics:latest é usada como base. Ela já contém o modelo YOLO26 e todas as dependências necessárias. O ponto de entrada do servidor é igual ao que usamos para testar a aplicação FastAPI localmente.
Compilar e testar a imagem Docker#
Agora você pode compilar a imagem Docker com o seguinte comando:
docker build --platform linux/amd64 -t IMAGE_NAME:IMAGE_VERSION .Substitua IMAGE_NAME e IMAGE_VERSION pelos valores desejados, por exemplo, yolo26-fastapi:0.1. Observe que, se for implantar no Vertex AI, você deverá compilar a imagem para a arquitetura linux/amd64. O parâmetro --platform precisa ser definido explicitamente se você estiver compilando a imagem em um Mac com Apple Silicon ou em qualquer outra arquitetura diferente de x86.
Quando a compilação da imagem for concluída, você poderá testar localmente a imagem Docker:
docker run --platform linux/amd64 -p 8080:8080 IMAGE_NAME:IMAGE_VERSIONSeu contêiner Docker está executando um servidor FastAPI na porta 8080, pronto para aceitar solicitações de inferência. Você pode testar os endpoints /health e /predict com os mesmos comandos cURL usados anteriormente:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
3. Enviar a imagem Docker para o GCP Artifact Registry#
Para importar seu modelo conteinerizado para o Vertex AI, você precisa enviar a imagem Docker para o Google Cloud Artifact Registry. Se ainda não tiver um repositório no Artifact Registry, primeiro será necessário criar um.
Criar um repositório no Google Cloud Artifact Registry#
Abra a página do Artifact Registry no Google Cloud Console. Se estiver usando o Artifact Registry pela primeira vez, talvez seja solicitado que você ative primeiro a API do Artifact Registry.

- Selecione Criar repositório.
- Insira o nome do repositório. Selecione a região desejada e use as configurações padrão para as demais opções, a menos que precise alterá-las especificamente.
A seleção da região pode afetar a disponibilidade de máquinas e certas limitações de computação para usuários que não são Enterprise. Você encontra mais informações na documentação oficial do Vertex AI: Cotas e limites do Vertex AI
- Depois de criar o repositório, salve o PROJECT_ID, a localização (região) e o nome do repositório no cofre de segredos ou no arquivo
.env. Você precisará dessas informações mais tarde para marcar e enviar sua imagem Docker ao Artifact Registry.
Autenticar o Docker no Artifact Registry#
Autentique o cliente Docker no repositório do Artifact Registry que você acabou de criar. Execute o seguinte comando no terminal:
gcloud auth configure-docker YOUR_REGION-docker.pkg.devMarcar e enviar sua imagem para o Artifact Registry#
Marque e envie a imagem Docker para o Google Artifact Registry.
Recomendamos usar tags exclusivas sempre que atualizar sua imagem. A maioria dos serviços do GCP, incluindo o Vertex AI, depende das tags de imagem para o controle automatizado de versões e a escalabilidade. Portanto, é uma boa prática usar tags de versionamento semântico ou baseadas em datas.
Marque sua imagem com o URL do repositório do Artifact Registry. Substitua os espaços reservados pelos valores salvos anteriormente.
docker tag IMAGE_NAME:IMAGE_VERSION YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONEnvie a imagem marcada para o repositório do Artifact Registry.
docker push YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONAguarde até que o processo seja concluído. Agora você deve ver a imagem no repositório do Artifact Registry.
Para obter instruções mais específicas sobre como trabalhar com imagens no Artifact Registry, consulte a documentação do Artifact Registry: Enviar e baixar imagens.
4. Importe seu modelo no Vertex AI#
Usando a imagem do Docker que você acabou de enviar, agora você pode importar o modelo no Vertex AI.
-
No menu de navegação do Google Cloud, acesse Vertex AI > Model Registry. Como alternativa, pesquise por "Vertex AI" na barra de pesquisa na parte superior do Google Cloud Console.

-
Clica em Importar.
-
Seleciona Importar como um novo modelo.
-
Seleciona a região. Podes escolher a mesma região do teu repositório do Artifact Registry, mas a tua escolha deve ser determinada pela disponibilidade de tipos de máquina e quotas na região.
-
Seleciona Importar um contêiner de modelo existente.

-
No campo Imagem do contêiner, procura o repositório do Artifact Registry que criaste anteriormente e seleciona a imagem que acabaste de enviar.
-
Desce até à secção Variáveis de ambiente e introduz os endpoints de predição e de integridade, bem como a porta que definiste na tua aplicação FastAPI.

-
Clica em Importar. O Vertex AI demorará vários minutos a registar o modelo e a prepará-lo para a implementação. Receberás uma notificação por e-mail quando a importação estiver concluída.
5. Crie um endpoint do Vertex AI e implante seu modelo#
Na terminologia do Vertex AI, endpoints se referem aos modelos implantados, pois representam os endpoints HTTP para os quais você envia solicitações de inferência, enquanto modelos são os artefatos de ML treinados e armazenados no Model Registry.
Para implantar um modelo, você precisa criar um endpoint no Vertex AI.
-
No menu de navegação do Vertex AI, acesse Endpoints. Selecione a região que você usou ao importar o modelo. Clique em Create.

-
Introduz o nome do endpoint.
-
Para o Acesso, o Vertex AI recomenda a utilização de endpoints privados do Vertex AI. Além dos benefícios de segurança, terás um limite de payload maior se selecionares um endpoint privado; no entanto, terás de configurar a tua rede VPC e as regras de firewall para permitir o acesso ao endpoint. Consulta a documentação do Vertex AI para obter mais instruções sobre endpoints privados.
-
Clica em Continuar.
-
Na caixa de diálogo Definições do modelo, seleciona o modelo que importaste anteriormente. Agora podes configurar o tipo de máquina, a memória e as definições da GPU para o teu modelo. Reserva memória suficiente se esperas cargas elevadas de inferência para garantir que não existem gargalos de E/S e obter o desempenho adequado do YOLO26.
-
Em Tipo de acelerador, seleciona o tipo de GPU que pretendes utilizar para a inferência. Se não tiveres a certeza de qual GPU selecionar, podes começar com a NVIDIA T4, compatível com CUDA.
Lembre-se de que algumas regiões têm cotas de computação muito limitadas, então talvez você não consiga selecionar determinados tipos de máquina ou GPUs na sua região. Se isso for essencial, altere a região da implantação para uma com uma cota maior. Encontre mais informações na documentação oficial do Vertex AI: Cotas e limites do Vertex AI.
- Depois de selecionar o tipo de máquina, você pode clicar em Continue. Nesse momento, você pode optar por ativar o monitoramento de modelos no Vertex AI — um serviço adicional que acompanhará o desempenho do modelo e fornecerá informações sobre o comportamento dele. Esse recurso é opcional e tem custos adicionais, então selecione-o de acordo com suas necessidades. Clique em Create.
O Vertex AI levará vários minutos (até 30 minutos em algumas regiões) para implantar o modelo. Você receberá uma notificação por e-mail quando a implantação for concluída.
6. Teste seu modelo implantado#
Quando a implantação for concluída, o Vertex AI fornecerá uma interface de API de exemplo para testar seu modelo.
Para testar a inferência remota, você pode usar o comando cURL fornecido ou criar outra biblioteca cliente Python que enviará solicitações ao modelo implantado. Lembre-se de codificar sua imagem em base64 antes de enviá-la ao endpoint /predict.
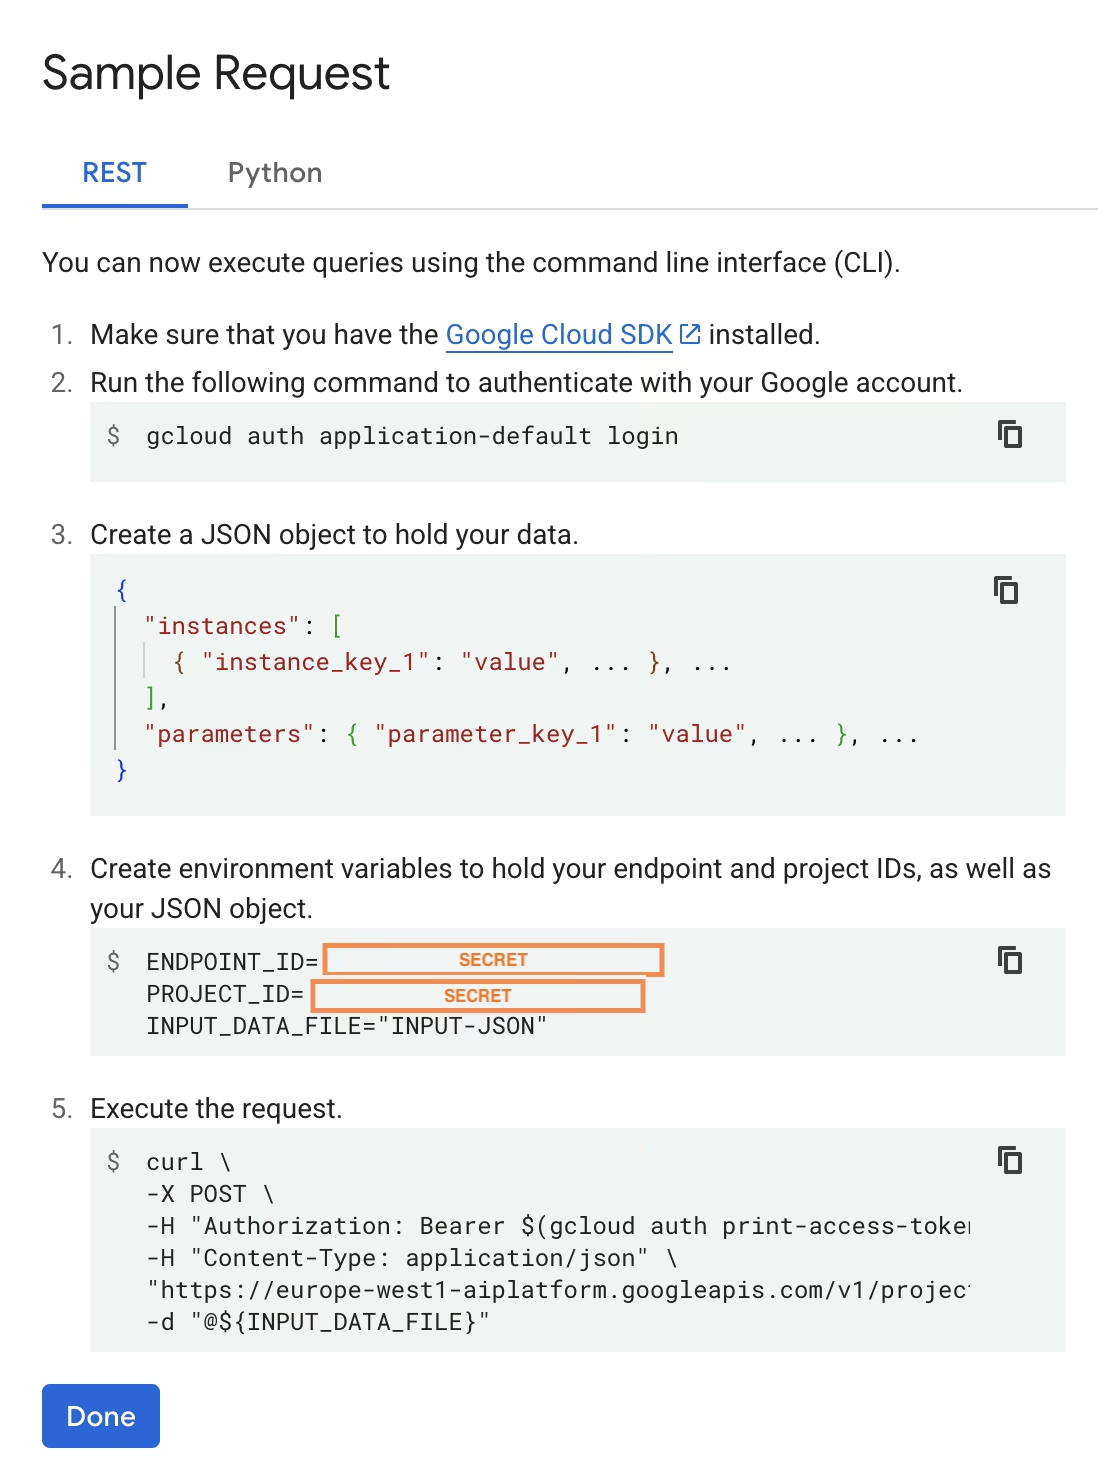
Assim como nos testes locais, espere um breve atraso na primeira solicitação, pois a Ultralytics precisará baixar e carregar o modelo YOLO26 no contêiner em execução.
Você implantou com sucesso um modelo YOLO26 pré-treinado da Ultralytics no Google Cloud Vertex AI.
Perguntas frequentes#
Sim; no entanto, primeiro você precisará exportar o modelo para um formato compatível com o Vertex AI, como TensorFlow, Scikit-learn ou XGBoost. O Google Cloud fornece um guia para executar modelos
.ptno Vertex, com uma visão geral completa do processo de conversão: Executar modelos PyTorch no Vertex AI.Observe que a configuração resultante dependerá apenas da camada padrão de serviço do Vertex AI e não oferecerá suporte aos recursos avançados do framework Ultralytics. Como o Vertex AI oferece suporte completo a modelos em contêineres e pode escalá-los automaticamente de acordo com a configuração da implantação, ele permite aproveitar todos os recursos dos modelos Ultralytics YOLO sem precisar convertê-los para outro formato.
O FastAPI oferece alto throughput para cargas de trabalho de inferência. O suporte assíncrono permite lidar com várias solicitações simultâneas sem bloquear a thread principal, o que é importante ao servir modelos de visão computacional.
A validação automática de solicitações e respostas do FastAPI reduz erros em tempo de execução nos serviços de inferência em produção. Isso é especialmente valioso para APIs de detecção de objetos, nas quais a consistência do formato de entrada é essencial.
O FastAPI adiciona uma sobrecarga computacional mínima ao pipeline de inferência, deixando mais recursos disponíveis para a execução do modelo e para tarefas de processamento de imagens.
O FastAPI também oferece suporte a SSE (eventos enviados pelo servidor), útil em cenários de inferência por streaming.
Na verdade, esse é um recurso de flexibilidade do Google Cloud Platform, no qual você precisa selecionar uma região para cada serviço utilizado. Para implantar um modelo em contêiner no Vertex AI, a seleção de região mais importante é a do Model Registry. Ela determinará a disponibilidade de tipos de máquina e cotas para a implantação do modelo.
Além disso, se você ampliar a configuração e armazenar dados de previsões ou resultados no Cloud Storage ou no BigQuery, precisará usar a mesma região do Model Registry para minimizar a latência e garantir alto throughput no acesso aos dados.