Aprimore seu conjunto de dados para treinar o YOLO26 usando Albumentations
Ao criar modelos de visão computacional, a qualidade e a variedade dos seus dados de treinamento podem ter grande impacto no desempenho do modelo. O Albumentations oferece uma maneira rápida, flexível e eficiente de aplicar uma ampla variedade de transformações às imagens, o que pode melhorar a capacidade do modelo de se adaptar a situações do mundo real. Ele se integra ao Ultralytics YOLO26 e pode ajudar você a criar conjuntos de dados robustos para tarefas de detecção de objetos, segmentação de instâncias, segmentação semântica, estimativa de profundidade, estimativa de pose e caixa delimitadora orientada.
O Albumentations adiciona técnicas como transformações geométricas e ajustes de cor aos seus dados de treinamento do YOLO26. Este guia explica como o Albumentations se integra ao pipeline de aumento de dados da Ultralytics e como personalizá-lo para seus projetos.
Albumentations para aumento de imagens#
Albumentations é uma biblioteca de aumento de dados de imagem de código aberto, criada em junho de 2018. Ela foi desenvolvida para simplificar e acelerar o processo de aumento de dados de imagem em visão computacional. Criada com foco em desempenho e flexibilidade, ela oferece suporte a diversas técnicas de aumento de dados, desde transformações simples, como rotações e inversões, até ajustes mais complexos, como alterações de brilho e contraste. O Albumentations ajuda desenvolvedores a gerar conjuntos de dados ricos e variados para tarefas como classificação de imagens, detecção de objetos e segmentação.
Você pode usar o Albumentations para aplicar facilmente aumentos de dados a imagens, máscaras de segmentação, caixas delimitadoras e pontos-chave, garantindo que todos os elementos do conjunto de dados sejam transformados juntos. Ele funciona com estruturas populares de aprendizado profundo, como PyTorch e TensorFlow, tornando-se acessível para uma ampla variedade de projetos.
O Albumentations é adequado tanto a pequenos conjuntos de dados quanto a tarefas de visão computacional de grande escala. Seu processamento rápido reduz o tempo dedicado à preparação dos dados, e dados de treinamento mais variados podem melhorar o desempenho do modelo em aplicações do mundo real.
Principais recursos do Albumentations#
O Albumentations oferece muitos recursos úteis que simplificam aumentos complexos de imagens para uma ampla variedade de aplicações de visão computacional. Veja alguns dos principais recursos:
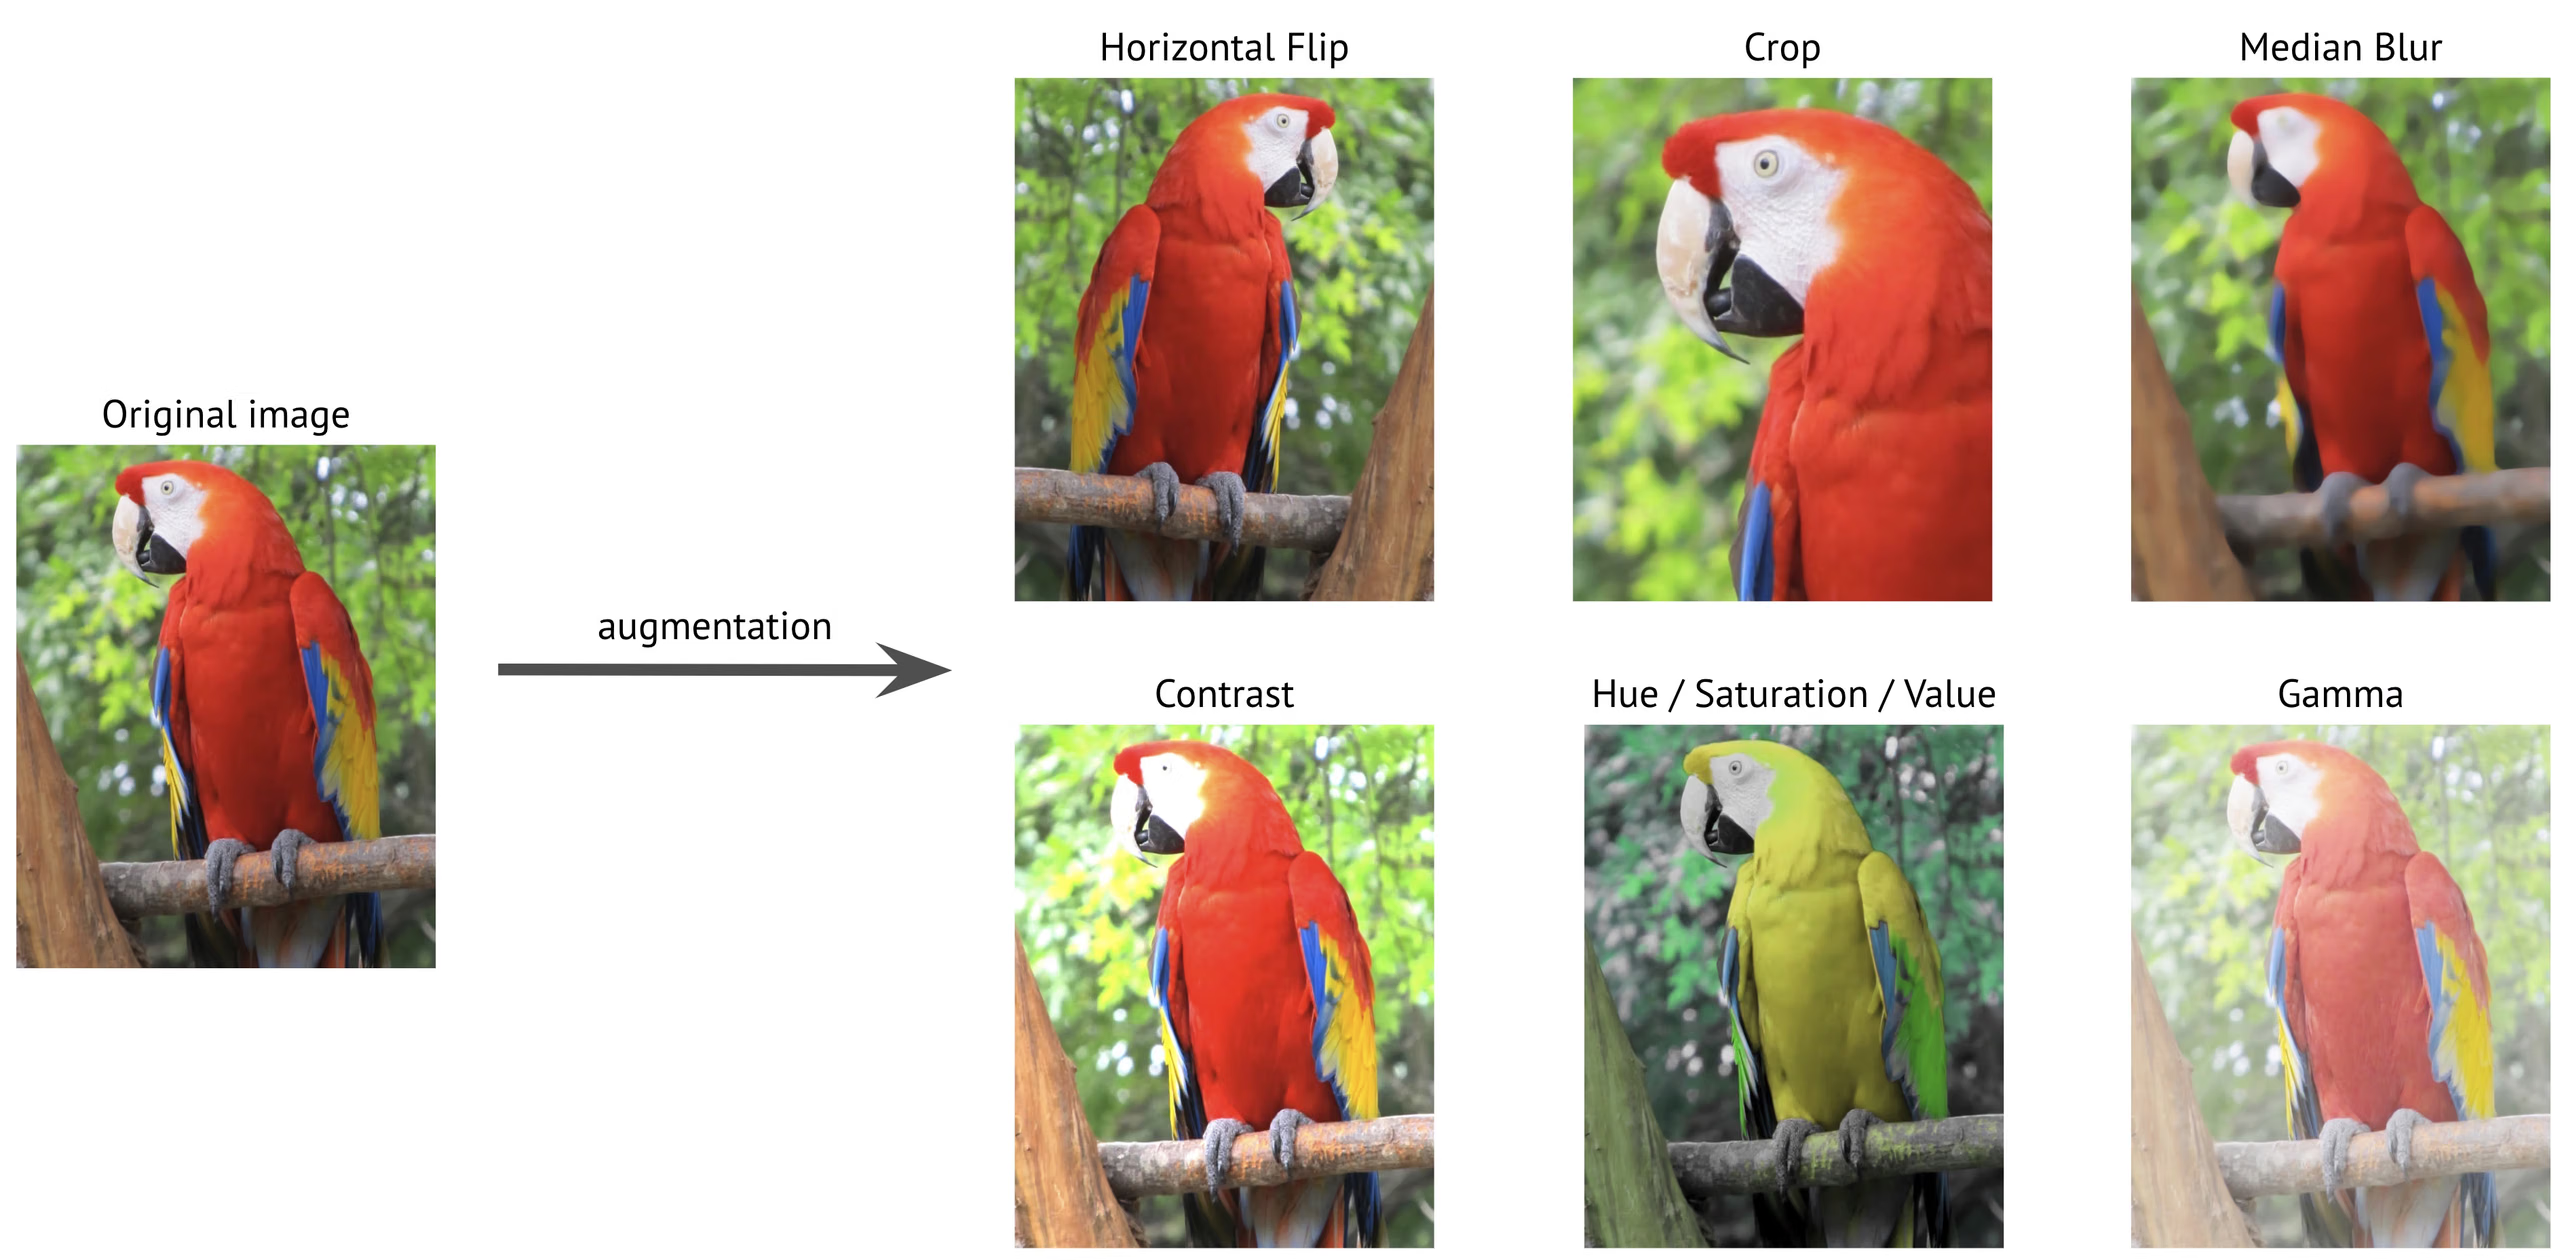
- Ampla variedade de transformações: o Albumentations oferece mais de 70 transformações diferentes, incluindo alterações geométricas (por exemplo, rotação e inversão), ajustes de cor (por exemplo, brilho e contraste) e adição de ruído (por exemplo, ruído gaussiano). A variedade de opções permite criar conjuntos de dados de treinamento altamente diversificados e robustos.
-
Otimização de alto desempenho: desenvolvido com OpenCV e NumPy, o Albumentations usa técnicas avançadas de otimização, como SIMD (Instrução Única, Múltiplos Dados), que processa vários pontos de dados simultaneamente para acelerar o processamento. Ele processa conjuntos de dados grandes rapidamente, o que faz dele uma das opções mais rápidas disponíveis para aumento de imagens.
-
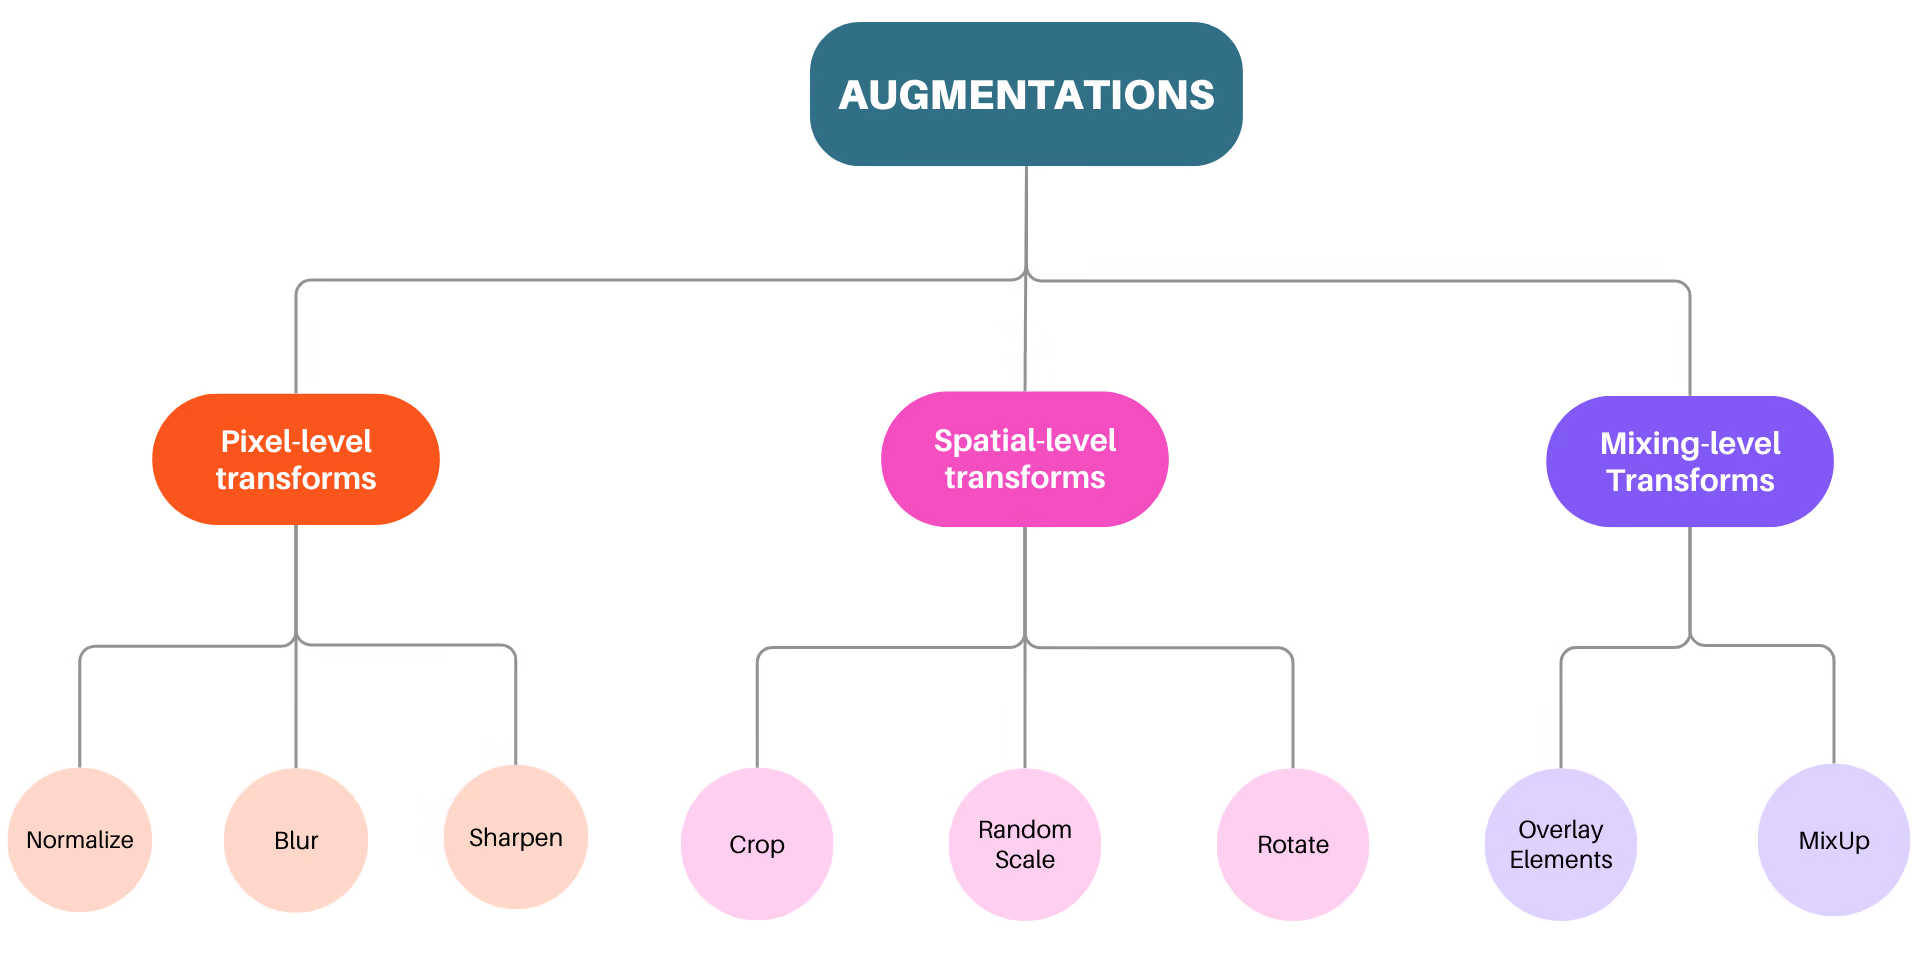
Três níveis de aumento de dados: o Albumentations oferece suporte a três níveis de aumento: transformações em nível de pixel, transformações espaciais e transformações de mistura. As transformações em nível de pixel afetam apenas as imagens de entrada, sem alterar máscaras, caixas delimitadoras ou pontos-chave. As transformações espaciais alteram tanto a imagem quanto seus elementos, como máscaras e caixas delimitadoras. As transformações de mistura combinam várias imagens em uma.
- Resultados de benchmark: os benchmarks publicados do Albumentations mostram que sua velocidade é competitiva em relação a outras bibliotecas de aumento de dados, especialmente em conjuntos de dados grandes.
Por que usar o Albumentations em seus projetos de IA visual?#
Para aumento de imagens, o Albumentations se destaca como uma ferramenta confiável para tarefas de visão computacional. Veja alguns dos principais motivos para considerar seu uso em projetos de IA visual:
-
API fácil de usar: o Albumentations oferece uma API única e simples para aplicar uma ampla variedade de aumentos a imagens, máscaras, caixas delimitadoras e pontos-chave. Ela foi desenvolvida para se adaptar facilmente a diferentes conjuntos de dados, simplificando e tornando mais eficiente a preparação de dados.
-
Testes rigorosos de bugs: bugs no pipeline de aumento podem corromper silenciosamente os dados de entrada, muitas vezes sem serem percebidos, mas acabando por prejudicar o desempenho do modelo. O Albumentations aborda esse problema com uma suíte de testes abrangente que ajuda a detectar bugs no início do desenvolvimento.
-
Extensibilidade: o Albumentations facilita a adição de novos aumentos de dados e seu uso junto com as transformações integradas por meio de uma única interface.
Como usar o Albumentations para aumentar os dados de treinamento do YOLO26#
O Albumentations se integra diretamente ao modo de treinamento da Ultralytics e é aplicado automaticamente quando o pacote Albumentations está instalado.
Instalação#
Para usar o Albumentations com o YOLO26, comece verificando se os pacotes necessários estão instalados. Se o Albumentations não estiver instalado, os aumentos de dados não serão aplicados durante o treinamento. Depois de instalado, as transformações são aplicadas às imagens de treinamento em tempo real.
# Install the required packages
pip install albumentations ultralytics
Para obter instruções detalhadas e boas práticas relacionadas ao processo de instalação, consulte nosso guia de instalação da Ultralytics. Se tiver dificuldades ao instalar os pacotes necessários para YOLO26, consulte nosso guia de problemas comuns para ver soluções e dicas.
Os exemplos de transformações personalizadas nesta página exigem Albumentations 1.4.22 ou mais recente e, portanto, Python 3.9 ou mais recente.
Uso#
Depois de instalar os pacotes necessários, você já pode começar a usar o Albumentations com o YOLO26. Quando você treina o YOLO26 com o Albumentations instalado, um conjunto padrão de transformações do Albumentations é aplicado automaticamente.
from ultralytics import YOLO

# Carregar um modelo pré-treinado
model = YOLO("yolo26n.pt")

# Treine o modelo com os aumentos padrão
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
As seções a seguir descrevem as transformações padrão do Albumentations aplicadas durante o treinamento.
Desfoque#
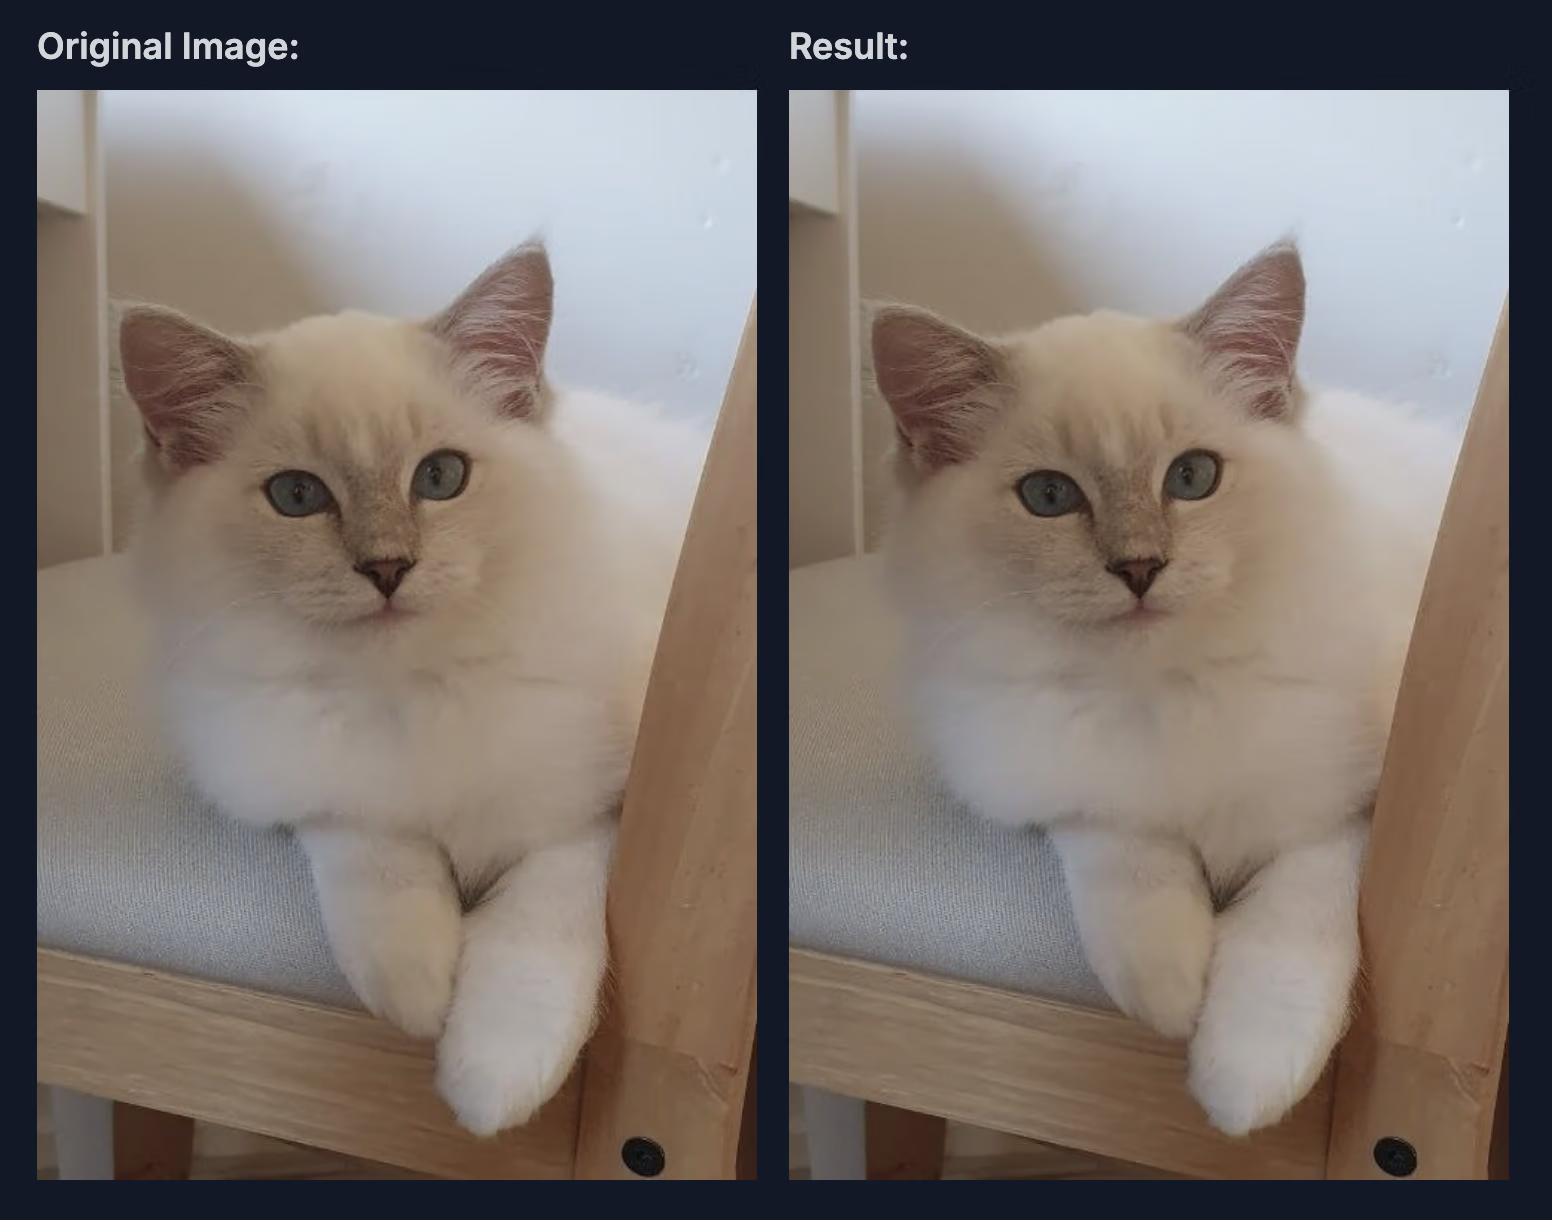
A transformação Blur do Albumentations aplica um efeito simples de desfoque à imagem, calculando a média dos valores dos pixels em uma pequena área quadrada, ou kernel. Isso é feito usando a função cv2.blur do OpenCV, que ajuda a reduzir o ruído na imagem, embora também reduza ligeiramente os detalhes.
Veja os parâmetros e valores usados nesta integração:
-
blur_limit: controla o intervalo de tamanho do efeito de desfoque. O intervalo padrão é (3, 7), o que significa que o tamanho do kernel de desfoque pode variar entre 3 e 7 pixels, permitindo apenas números ímpares para manter o desfoque centralizado.
-
p: a probabilidade de aplicar o desfoque. Na integração, p=0.01, ou seja, há 1% de chance de aplicar esse desfoque a cada imagem. A probabilidade baixa permite que o efeito apareça ocasionalmente, introduzindo um pouco de variação para ajudar o modelo a generalizar sem desfocar demais as imagens.
Desfoque mediano#
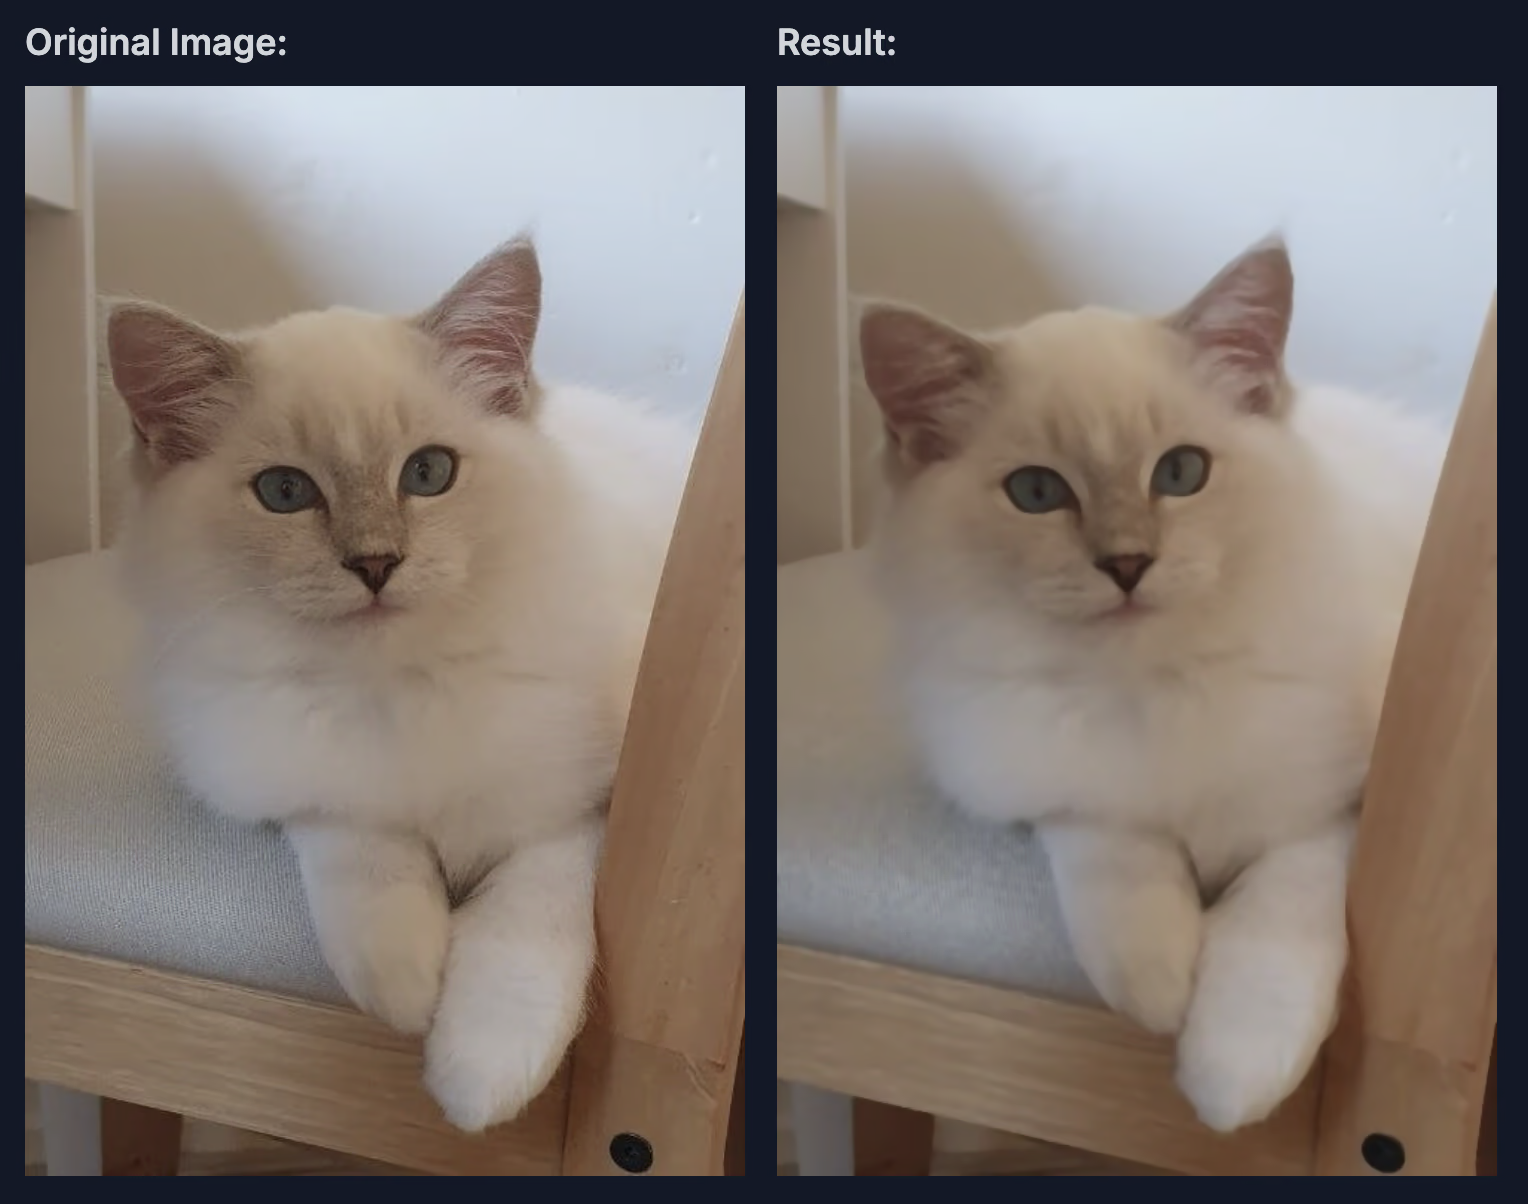
A transformação MedianBlur do Albumentations aplica um efeito de desfoque mediano à imagem, particularmente útil para reduzir o ruído sem perder as bordas. Diferentemente dos métodos de desfoque típicos, MedianBlur usa um filtro mediano, especialmente eficaz para remover o ruído sal e pimenta e manter as bordas nítidas.
Veja os parâmetros e valores usados nesta integração:
-
blur_limit: esse parâmetro controla o tamanho máximo do kernel de desfoque. Nesta integração, o intervalo padrão é (3, 7), o que significa que o tamanho do kernel é escolhido aleatoriamente entre 3 e 7 pixels, permitindo apenas valores ímpares para garantir o alinhamento correto.
-
p: define a probabilidade de aplicar o desfoque mediano. Aqui, p=0.01, então há 1% de chance de aplicar a transformação a cada imagem. Essa probabilidade baixa garante que o desfoque mediano seja usado com moderação, ajudando o modelo a generalizar ao apresentar ocasionalmente imagens com menos ruído e bordas preservadas.
A imagem abaixo mostra um exemplo dessa ampliação aplicada a uma imagem.
Escala de cinza#
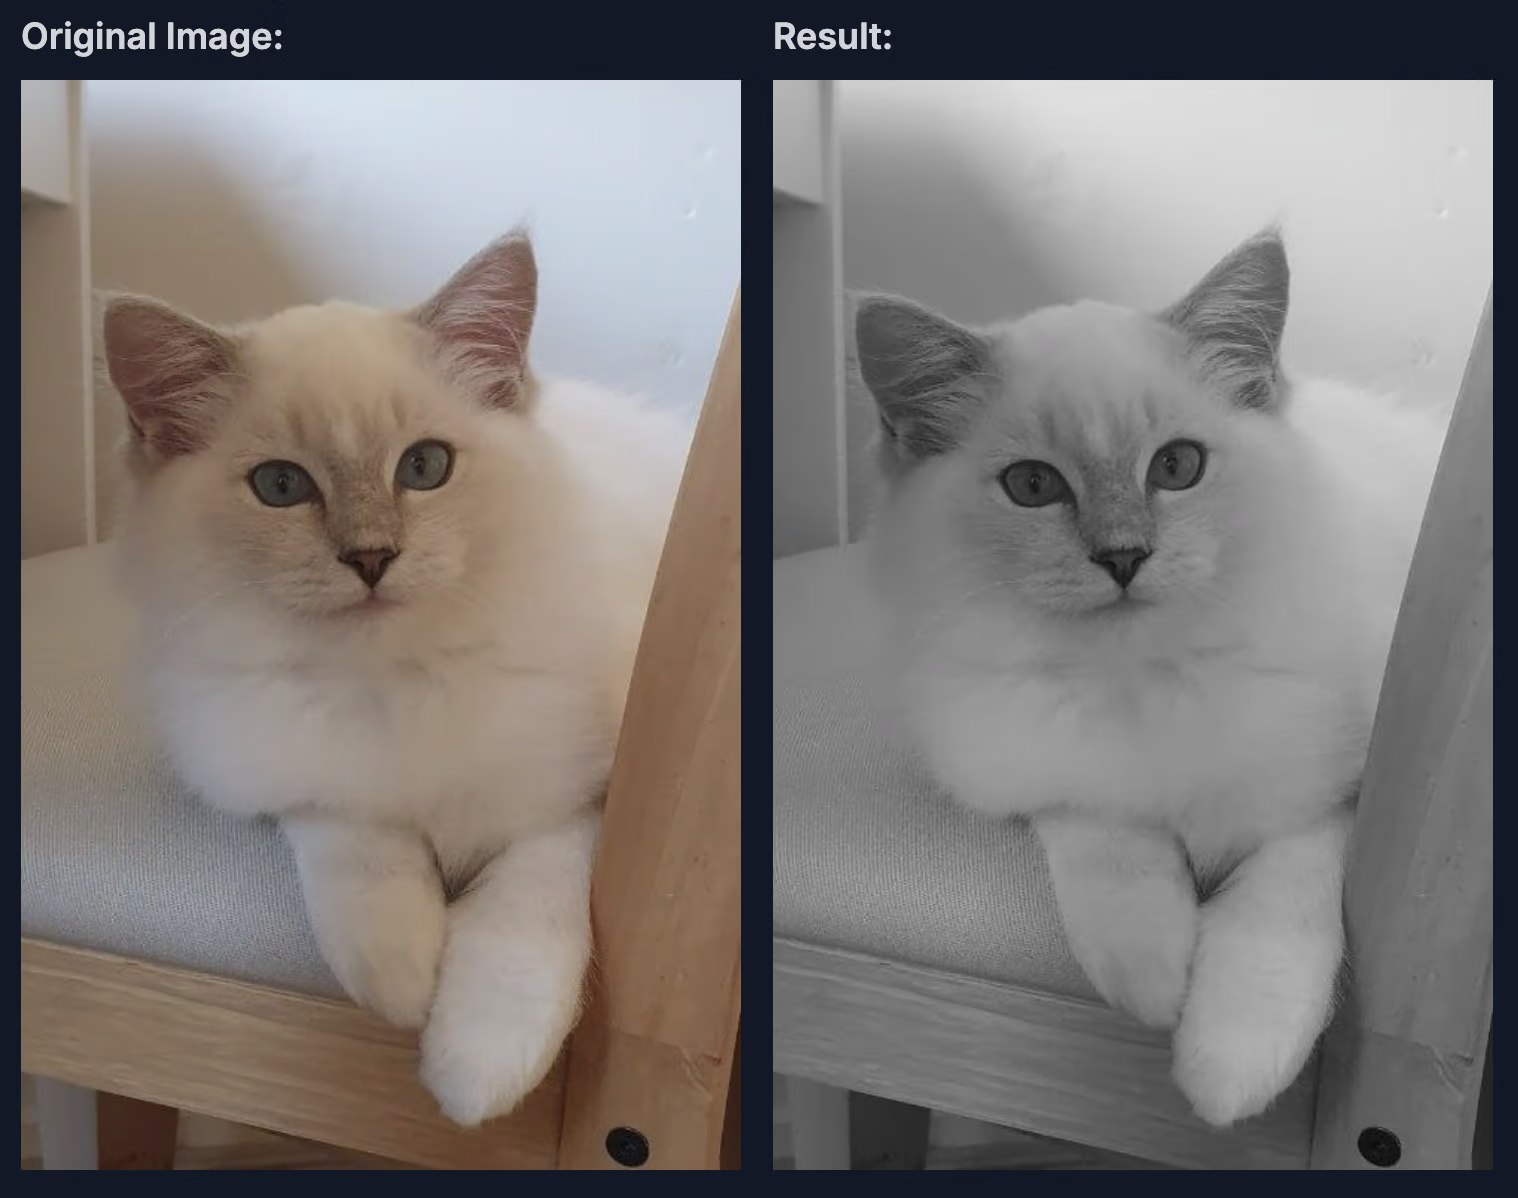
A transformação ToGray do Albumentations converte uma imagem para escala de cinza, reduzindo-a a um formato de canal único e, opcionalmente, replicando esse canal para corresponder a um número especificado de canais de saída. É possível usar diferentes métodos para ajustar o cálculo do brilho em escala de cinza, desde a simples média até técnicas mais avançadas para uma percepção realista de contraste e brilho.
Veja os parâmetros e valores usados nesta integração:
-
num_output_channels: define o número de canais na imagem de saída. Se esse valor for maior que 1, o canal único em escala de cinza será replicado para criar uma imagem em escala de cinza multicanal. Por padrão, o valor é 3, gerando uma imagem em escala de cinza com três canais idênticos.
-
method: define o método de conversão para escala de cinza. O método padrão, "weighted_average", aplica uma fórmula (0.299R + 0.587G + 0.114B) que se aproxima da percepção humana e produz um efeito natural de escala de cinza. Outras opções, como "from_lab", "desaturation", "average", "max" e "pca", oferecem maneiras alternativas de criar imagens em escala de cinza conforme diferentes necessidades de velocidade, destaque do brilho ou preservação de detalhes.
-
p: controla a frequência de aplicação da transformação para escala de cinza. Com p=0.01, há 1% de chance de converter cada imagem para escala de cinza, permitindo misturar imagens coloridas e em escala de cinza para ajudar o modelo a generalizar melhor.
A imagem abaixo mostra um exemplo dessa transformação para escala de cinza aplicada.
Equalização Adaptativa do Histograma com Contraste Limitado (CLAHE)#
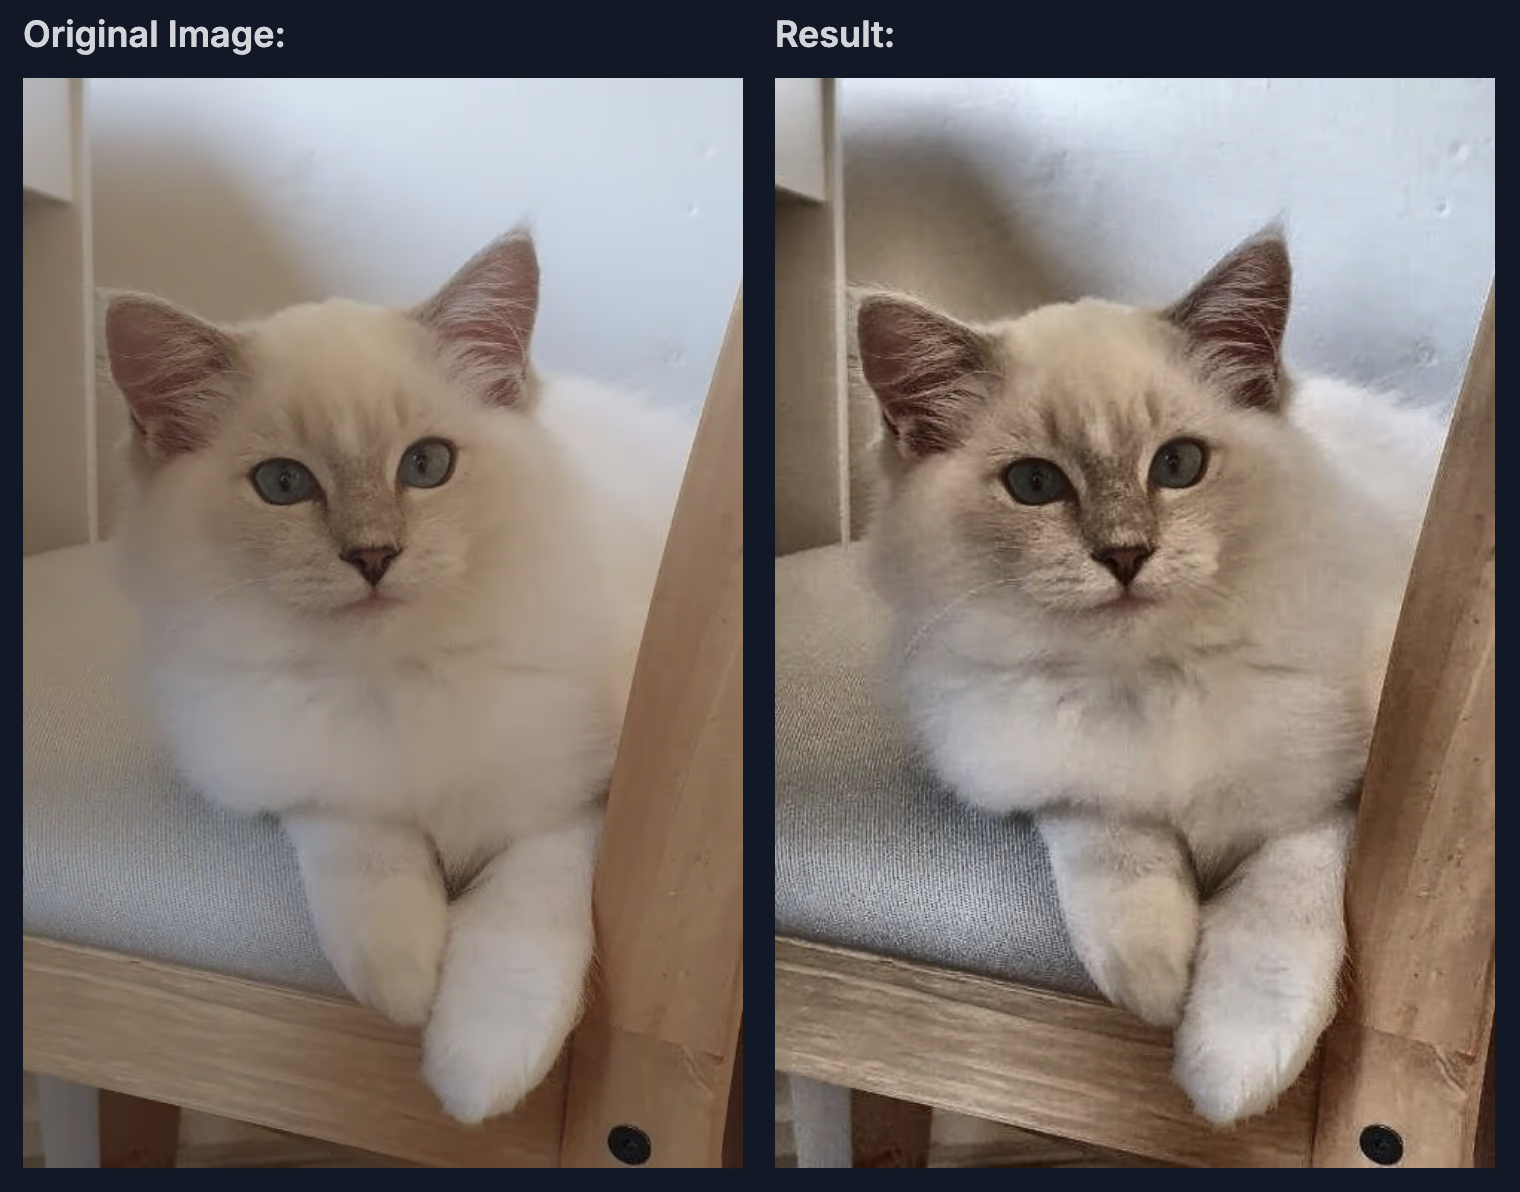
A transformação CLAHE do Albumentations aplica a Equalização Adaptativa do Histograma com Contraste Limitado (CLAHE), uma técnica que aprimora o contraste da imagem equalizando o histograma em regiões localizadas (blocos), em vez de fazê-lo na imagem inteira. O CLAHE produz um aprimoramento equilibrado, evitando o contraste excessivamente amplificado que pode resultar da equalização padrão do histograma, sobretudo em áreas com pouco contraste inicial.
Veja os parâmetros e valores usados nesta integração:
-
clip_limit: controla o intervalo de aprimoramento do contraste. Definido por padrão no intervalo (1, 4), determina o contraste máximo permitido em cada bloco. Valores maiores permitem mais contraste, mas também podem introduzir ruído.
-
tile_grid_size: define o tamanho da grade de blocos, normalmente no formato (linhas, colunas). O valor padrão é (8, 8), o que significa que a imagem é dividida em uma grade de 8x8. Blocos menores permitem ajustes mais localizados, enquanto blocos maiores produzem efeitos mais próximos da equalização global.
-
p: a probabilidade de aplicar CLAHE. Aqui, p=0.01 aplica o efeito de aprimoramento apenas 1% das vezes, garantindo que os ajustes de contraste sejam usados com moderação para introduzir variação ocasional nas imagens de treinamento.
A imagem abaixo mostra um exemplo da transformação CLAHE aplicada.
Usando transformações personalizadas do Albumentations#
Embora a integração padrão do Albumentations ofereça um conjunto sólido de aumentos de dados, talvez você queira personalizar as transformações para seu caso de uso específico. Com o Ultralytics YOLO26, você pode passar transformações personalizadas do Albumentations pela API Python usando o parâmetro augmentations. Os exemplos desta seção exigem o Albumentations 1.4.22 ou posterior.
Como definir transformações personalizadas#
Podes definir a tua própria lista de transformações do Albumentations e passá-la para a função de treino. Isso substitui as transformações padrão do Albumentations, mantendo ativas todas as outras ampliações do YOLO (como hsv_h, degrees, mosaic etc.).
Segue um exemplo com transformações mais avançadas:
import albumentations as A

from ultralytics import YOLO

# Carregar o modelo
model = YOLO("yolo26n.pt")

# Definir transformações personalizadas com várias técnicas de aumento
custom_transforms = [
    # Variações de desfoque
    A.OneOf(
        [
            A.MotionBlur(blur_limit=7, p=1.0),
            A.MedianBlur(blur_limit=7, p=1.0),
            A.GaussianBlur(blur_limit=7, p=1.0),
        ],
        p=0.3,
    ),
    # Variações de ruído
    A.OneOf(
        [
            A.GaussNoise(std_range=(0.0124, 0.0277), p=1.0),
            A.ISONoise(color_shift=(0.01, 0.05), intensity=(0.1, 0.5), p=1.0),
        ],
        p=0.2,
    ),
    # Ajustes de cor e contraste
    A.CLAHE(clip_limit=4.0, tile_grid_size=(8, 8), p=0.5),
    A.RandomBrightnessContrast(brightness_limit=0.3, contrast_limit=0.3, p=0.5),
    A.HueSaturationValue(hue_shift_limit=20, sat_shift_limit=30, val_shift_limit=20, p=0.5),
    # Simular oclusões
    A.CoarseDropout(num_holes_range=(1, 8), hole_height_range=(8, 32), hole_width_range=(8, 32), fill=0, p=0.2),
]

# Treinar com transformações personalizadas
results = model.train(
    data="coco8.yaml",
    epochs=100,
    imgsz=640,
    augmentations=custom_transforms,
)
Considerações importantes#
Ao usar transformações personalizadas do Albumentations, tem estes pontos em conta:
- Configuração: Cria objetos de transformação personalizados através da API Python. Também podes passar transformações serializadas através do CLI ou de ficheiros de configuração YAML, inclusive ao retomar o treino.
- Substituem as predefinições: As tuas transformações personalizadas substituirão completamente as transformações padrão do Albumentations. As outras ampliações do YOLO continuam ativas.
- Gestão de rótulos: As transformações espaciais, incluindo as aninhadas em
A.OneOfouA.Compose, movem caixas delimitadoras, polígonos, pontos-chave e máscaras de profundidade ou semânticas juntamente com a imagem.A.RandomGridShufflenão consegue preservar a topologia de polígonos ou pontos-chave e gera um erro com amostras de segmentação, pose e OBB. - Desempenho: Algumas transformações têm um custo computacional elevado. Monitoriza a velocidade do treino e ajusta conforme necessário.
- Compatibilidade com tarefas: As transformações personalizadas do Albumentations funcionam com deteção, segmentação, segmentação semântica, profundidade, pose e treino de OBB, mas não com classificação (que usa um pipeline de aumento diferente).
Casos de uso de transformações personalizadas#
Diferentes aplicações beneficiam de diferentes estratégias de aumento:
- Imagiologia médica: Usa deformações elásticas, distorções de grelha e padrões de ruído especializados
- Imagens aéreas/de satélite: Aplica transformações que simulam diferentes altitudes, condições meteorológicas e ângulos de iluminação
- Cenários com pouca luz: Dá ênfase à adição de ruído e aos ajustes de brilho para treinar modelos robustos em condições de iluminação difíceis
- Inspeção industrial: Adiciona variações de textura e defeitos simulados para aplicações de controlo de qualidade
Para veres a lista completa de transformações disponíveis e os respetivos parâmetros, consulta a documentação do Albumentations.
Para exemplos mais detalhados e práticas recomendadas sobre como usar transformações personalizadas do Albumentations com o YOLO26, consulta o guia de aumento de dados do YOLO.
Continua a aprender sobre o Albumentations#
Se quiseres saber mais sobre o Albumentations, consulta os seguintes recursos para obteres instruções e exemplos mais aprofundados:
-
Documentação do Albumentations: A documentação oficial apresenta uma ampla variedade de transformações suportadas e técnicas avançadas de utilização.
-
Referência da API Albumentations da Ultralytics: consulte os detalhes da classe que implementa esta integração.
-
Repositório do Albumentations no GitHub: O repositório inclui exemplos, benchmarks e discussões para te ajudar a começar a personalizar aumentos.
Principais conclusões#
Neste guia, exploramos os principais aspectos do Albumentations, uma biblioteca Python para aumento de dados de imagem. Abordamos a ampla variedade de transformações, o desempenho otimizado e como você pode usar a biblioteca no seu próximo projeto com YOLO26.
Perguntas frequentes#
O Albumentations se integra ao YOLO26 e é aplicado automaticamente durante o treinamento se o pacote estiver instalado. Veja como começar:
# Instalar os pacotes necessários
# !pip install albumentations ultralytics
from ultralytics import YOLO

# Carregar e treinar o modelo com aumentos automáticos
model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100)
A integração padrão aplica desfoque, desfoque mediano, conversão para escala de cinza e CLAHE, cada um com uma probabilidade baixa de 1%, para que adicionem variação ocasional sem dominar o treinamento.
O Albumentations destaca-se por vários motivos:
- Desempenho: baseado em OpenCV e NumPy, com otimização SIMD para alta velocidade
- Flexibilidade: Suporta mais de 70 transformações de aumento ao nível dos píxeis, espacial e de mistura
- Compatibilidade: funciona com estruturas populares, como PyTorch e TensorFlow
- Fiabilidade: Um conjunto abrangente de testes evita a corrupção silenciosa de dados
- Facilidade de utilização: Uma única API unificada para todos os tipos de aumento
O Albumentations melhora várias tarefas de visão computacional, incluindo:
- Deteção de objetos: Melhora a robustez do modelo face a variações de iluminação, escala e orientação
- Segmentação de instâncias: Melhora a precisão da previsão de máscaras através de transformações diversificadas
- Estimativa de pose: Ajuda os modelos a adaptarem-se a diferentes pontos de vista e condições de iluminação
- Deteção de caixas delimitadoras orientadas: Adiciona variações de cor e ruído a imagens aéreas e de objetos rodados
As diversas opções de aumento da biblioteca tornam-na valiosa para tarefas de visão que exigem um desempenho robusto do modelo. No Ultralytics YOLO26, o treino de classificação usa o seu próprio pipeline de aumento baseado no torchvision e não aplica transformações do Albumentations.


Comentários19
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
anushka-kore
Is there a way that we can define more custom albumentations transforms to be applied during model train? If yes, will they also change the bounding box coords accordingly if they are spatial transforms?
manuelescobar5036
The albumentations transforms are defined in the ultralytics/data/augment.py file. There you can find the following function that returns the transforms to be applied to the images, which includes the Albumentations transform.
Then, in the same file you can find the Albumentations class which defines the pipeline. In this pipeline you can add the new transforms that you want.
Bouding boxes are changed accordingly to their spatial transforms. This is done when you pass bbox_params to the Albumentations pipeline.
 Glenn JocherUltralytics(editado)
@anushka-kore Yes. Pass your own Albumentations transforms to training with the
augmentationsargument (Python only):import albumentations as A from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="coco8.yaml", augmentations=[A.Blur(p=0.01), A.CLAHE(p=0.01)])Spatial transforms (rotation, flips, perspective, etc.) are applied together with the bounding boxes, which are updated automatically through Albumentations' bbox handling in YOLO format. Non-spatial transforms like color adjustments only change the image. See the Albumentations integration guide for details.
Thanks a lot for the inputs @deox1994 and @glenn-jocher! I have made it work👍🏻
Hey @glenn-jocher and @deox1994, I later realised that simply defining my list of custom transform in the augment.py file is not working. This is the part I changed in the augment.py file (original ones are commented out)-
        T = [
            #A.Blur(p=0.01),
            #A.MedianBlur(p=0.01),
            #A.ToGray(p=0.01),
            #A.CLAHE(p=0.01),
            A.RandomBrightnessContrast(p=0.2),
            #A.RandomGamma(p=0.0),
            #A.ImageCompression(quality_range=(75, 100), p=0.0),
            A.HorizontalFlip(p=0.5),
            A.VerticalFlip(p=0.5),
            A.Rotate(limit=30, p=0.5),
            A.GaussianBlur(p=0.2),
            A.GaussNoise(p=0.2),
        ]
For your reference, this is the error I get, you could view the list of albumentation transforms I applied here as well- ..... Transferred 1009/1015 items from pretrained weights Freezing layer 'model.23.dfl.conv.weight' AMP: running Automatic Mixed Precision (AMP) checks... AMP: checks passed ✅ train: Scanning /home/xxx/dataset_MIP_clean/train/labels.cache... 831 images, 73 backgrounds, 0 corrupt: 100%|██████████| 831/831 [00:00<?, ?it/s] albumentations: RandomBrightnessContrast(p=0.2, brightness_by_max=True, brightness_limit=(-0.2, 0.2), contrast_limit=(-0.2, 0.2), ensure_safe_range=False), HorizontalFlip(p=0.5), VerticalFlip(p=0.5), Rotate(p=0.5, border_mode=0, crop_border=False, fill=0.0, fill_mask=0.0, interpolation=1, limit=(-30.0, 30.0), mask_interpolation=0, rotate_method='largest_box'), GaussianBlur(p=0.2, blur_limit=(0, 0), sigma_limit=(0.5, 3.0)), GaussNoise(p=0.2, mean_range=(0.0, 0.0), noise_scale_factor=1.0, per_channel=True, std_range=(0.2, 0.44)) val: Scanning /home/xxx/dataset_MIP_clean/val/labels.cache... 210 images, 13 backgrounds, 0 corrupt: 100%|██████████| 210/210 [00:00<?, ?it/s] Plotting labels to /home/xxx/yolov11_predictions/test4/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.000769, momentum=0.9) with parameter groups 167 weight(decay=0.0), 174 weight(decay=0.0005), 173 bias(decay=0.0) Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to /home/xxx/yolov11_predictions/test4 Starting training for 200 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
  1/200      15.4G      5.502      51.38      2.745         17        640:  10%|▉         | 5/52 [00:02<00:22,  2.07it/s]
Traceback (most recent call last): File "/home/xxx/yolo_train.py", line 149, in train_yolo(output_dir) File "/home/xxx/yolo_train.py", line 116, in train_yolo results = model.train( ^^^^^^^^^^^^ File "/home/xxx/env/lib/python3.12/site-packages/ultralytics/engine/model.py", line 791, in train self.trainer.train() File "/home/xxx/env/lib/python3.12/site-packages/ultralytics/engine/trainer.py", line 211, in train self._do_train(world_size) File "/home/xxx/env/lib/python3.12/site-packages/ultralytics/engine/trainer.py", line 366, in _do_train for i, batch in pbar: ^^^^ File "/home/xxx/env/lib/python3.12/site-packages/tqdm/std.py", line 1178, in iter for obj in iterable: ^^^^^^^^ File "/home/xxx/env/lib/python3.12/site-packages/ultralytics/data/build.py", line 59, in iter yield next(self.iterator) ^^^^^^^^^^^^^^^^^^^ File "/home/xxx/env/lib/python3.12/site-packages/torch/utils/data/dataloader.py", line 708, in next data = self._next_data() ^^^^^^^^^^^^^^^^^ File "/home/xxx/env/lib/python3.12/site-packages/torch/utils/data/dataloader.py", line 1455, in _next_data return self._process_data(data) ^^^^^^^^^^^^^^^^^^^^^^^^ File "/home/xxx/env/lib/python3.12/site-packages/torch/utils/data/dataloader.py", line 1505, in _process_data data.reraise() File "/home/xxx/env/lib/python3.12/site-packages/torch/_utils.py", line 733, in reraise raise exception RuntimeError: Caught RuntimeError in DataLoader worker process 5. Original Traceback (most recent call last): File "/home/xxx/env/lib/python3.12/site-packages/torch/utils/data/_utils/worker.py", line 349, in _worker_loop data = fetcher.fetch(index) # type: ignore[possibly-undefined] ^^^^^^^^^^^^^^^^^^^^ File "/home/xxx/env/lib/python3.12/site-packages/torch/utils/data/_utils/fetch.py", line 55, in fetch return self.collate_fn(data) ^^^^^^^^^^^^^^^^^^^^^ File "/home/xxx/env/lib/python3.12/site-packages/ultralytics/data/dataset.py", line 298, in collate_fn value = torch.cat(value, 0) ^^^^^^^^^^^^^^^^^^^ RuntimeError: Tensors must have same number of dimensions: got 1 and 2
All my transforms are correctly defined, and the spatial transforms (horizontalflip, verticalflip and rotate) exist in the spatial_transforms list. Could you please point where this is going wrong?
supriamir
Hi Glen,
I would like to optimize the hyperparameters using model.tune(). My goal is to identify the most important augmentations from Albumentations.
If I am not mistaken, the default hyperparameter optimization only includes a limited set of augmentation parameters, as described in the following link: https://docs.ultralytics.com/integrations/ray-tune/#tune-method-parameters
Could you advise how I can include and optimize additional Albumentations transforms beyond the default settings?
- Glenn JocherUltralytics
Yes, but not directly through the default
model.tune()search set: custom Albumentations are a Python-onlyaugmentationslist passed tomodel.train(), while the built-in tuner mutates the numericspace, so the usual workflow is to keep one fixedaugmentations=pipeline per tuning run and compare the best result across several candidate pipelines; if you want to search the pipeline itself, use a small custom Ray Tune wrapper aroundmodel.train()instead, and keep the standard YOLO augmentations fixed so you isolate the Albumentations effect—see the hyperparameter tuning guide and the Albumentations integration guide.
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend visiting the Docs for guidance—there you’ll find many Python and CLI usage examples, and answers to many common questions.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate.
If you have a custom training ❓ Question, please share as much relevant information as possible, including dataset image examples and training logs. Also, make sure to review our Tips for Best Training Results.
You’re welcome to join the Ultralytics community where it fits you best:
- For real-time chat, join us on Discord 🎧
- For in-depth discussions, visit Discourse
- For community sharing, check out our Subreddit
Upgrade
Upgrade to the latest
ultralyticspackage and all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re on the latest version:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies like CUDA/CUDNN, Python, and PyTorch preinstalled):
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. These tests confirm correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
欢迎来到 Ultralytics 中文文档的 Albumentations 集成讨论区!如果您对使用 Albumentations 来增强 YOLO11 训练数据有任何问题或想法,请在这里提出。
Albumentations 与 YOLO11 的集成非常简便,只需安装
albumentations包,就会在训练过程中自动应用多种图像增强技术,如模糊、中值模糊、灰度转换和 CLAHE,帮助您的模型更好地适应各种真实场景。您是否在特定项目中使用过 Albumentations?或者您对如何最佳配置这些增强技术有疑问?请随时在这里分享您的经验或提出问题,Ultralytics 团队将很乐意提供帮助!
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend visiting the Docs for guidance on integrations like Albumentations with YOLO11. You can also review many Python and CLI examples, and frequently asked questions may already be addressed there.
If this is a 🐛 Bug Report, please include a minimum reproducible example to help us investigate further.
If you have a custom training ❓ Question, please provide detailed info such as dataset image samples, training logs, and confirm you are following our Tips for Best Training Results.
Join the Ultralytics community wherever you prefer—real-time chat on Discord 🎧, in-depth discussions on Discourse, or knowledge-sharing on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage and all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure your issue is not already fixed in the latest version:pip install -U ultralyticsEnvironments
YOLO may be run in any of the following verified and up-to-date environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. These tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will review and assist you soon!
- Glenn JocherUltralytics
Bonjour! N'hésitez pas à poser vos questions sur l'intégration d'Albumentations avec YOLO11 dans cette discussion. Cette intégration vous permet d'améliorer automatiquement votre jeu de données pendant l'entraînement avec diverses transformations comme le flou, le flou médian, la conversion en niveaux de gris et CLAHE.
L'avantage principal est sa simplicité d'utilisation - il suffit d'installer les packages requis et les augmentations sont appliquées automatiquement pendant l'entraînement:
pip install albumentations ultralyticsSi vous rencontrez des difficultés avec cette intégration ou si vous avez des questions sur l'augmentation de données pour améliorer les performances de vos modèles YOLO11, n'hésitez pas à les partager ici!
- Notebooks with free GPU:
Dear Ultralytics team,
I’m working on a project focused on detecting the behavior of workers in underground mines. The classes and the number of labels per class in the training set are as follows:
- Sitting → 2500
- Standing → 9000
- Operation → 700
- Lean Against → 4000
- Tumble → 400
Since the dataset is imbalanced, I would like to apply data augmentation to avoid overfitting and improve accuracy. While researching YOLO's data augmentation capabilities, a few questions came up:
- As far as I understand, YOLO currently supports two methods for performing data augmentation:
- Modifying individual hyperparameters such as hsv_h, hsv_s, hsv_v, degrees, translate, etc., in the ultralytics/cfg/default.yaml file (does not require the Albumentations Python Library).
- Using the Albumentations Python Library (previously installed).
Is this correct? If so, what are the differences between the two methods, and which one is currently recommended?
-
Considering both options from question 1, does YOLO apply data augmentation only to images from the classes with less labels, or to images from all classes? I ask because if I have an imbalanced dataset and YOLO applies data augmentation to images from all classes, the imbalance would remain, wouldn’t it?
-
If I choose to use an older YOLO model, such as yolov8n.yaml, and I have Albumentations installed, will Albumentations-based data augmentation be applied during training?
-
What other suggestions would you recommend for dealing with imbalanced classes?
safwene-bahroun
Hello @glenn-jocher , Do you can , please , answer to these questions , because the same questions and problem.
THANKS
- Glenn JocherUltralytics
@deox1994 Thanks for your detailed questions about data augmentation in YOLO for handling your imbalanced mining worker dataset. Let me address each point:
- Yes, you're correct about the two augmentation approaches:
- Built-in YOLO augmentations (hsv_h, translate, scale, etc.) which are always available
- Albumentations integration which activates automatically when the library is installed
The key difference is that built-in augmentations focus primarily on geometric and color transformations, while Albumentations adds more specialized transformations like blur, grayscale, and CLAHE with carefully tuned probabilities (typically 0.01 as shown in the reference code). Both work together complementarily rather than being exclusive options.
-
Both augmentation methods apply to all images regardless of class. To address your imbalance specifically, consider:
- Using a weighted loss function
- Implementing class-aware sampling during training
- Creating custom data pipeline that applies additional augmentations to underrepresented classes
-
Yes, if Albumentations is installed, it will be automatically applied when training YOLOv8 models too. The integration is part of the Ultralytics framework, not specific to YOLO11.
-
For handling imbalanced classes beyond augmentation:
- Apply weighted loss based on inverse class frequency
- Use focal loss which naturally handles class imbalance better
- Consider different evaluation metrics (precision/recall per class rather than just mAP)
- Experiment with undersampling majority classes or oversampling minority classes
You can find implementation details for these approaches in the data augment reference documentation.
- Yes, you're correct about the two augmentation approaches:
Good morning ,@glenn-jocher, do you can help me ?
{ "total_images": 39152, "total_detections": 70910, "instances_per_class": { "Dress": 52999, "Skirt": 1259, "Handbag": 2495, "High heels": 3124, "Swimwear": 10079, "Miniskirt": 954 } } i will train this with yolo11n.pt and with albumentation the code : from ultralytics import YOLO import torch
def main(): # Load a pretrained YOLO model model = YOLO("yolo11n.pt") # Set device device = "cuda" if torch.cuda.is_available() else "cpu" print(f"Using device: {device}")
if device == "cuda":
    print(f"GPU name: {torch.cuda.get_device_name(0)}")

# Debug: Print dataset configuration
print("Training with dataset: OpenImagesV7-women.yaml")

# Train the model with enhanced hyperparameters
results = model.train(
data="OpenImagesV7-woman.yaml",
epochs=150,
imgsz=640,
device=device,
batch=16,
optimizer ="auto"
)
Dataset configuration
path: ../datasets/open-images-v7 train: c:\Users\GIGABYTE\datasets\open-images-v7\train val: C:/Users/GIGABYTE/datasets/open-images-v7/val
nc: 6 names: 0: Dress 1: High heels 2: Miniskirt 3: Skirt 4: Swimwear 5: Handbag
Hyperparameters for extreme imbalance
loss: cls_weight: [0.3, 0.5, 7.0, 5.0, 0.4, 0.6] # Calculated weights below box: 0.05 obj: 1.0 label_smoothing: 0.1
Strategic augmentation
augment:
For rare classes (Miniskirt, Skirt)
copy_paste: 0.7 # High frequency for rare classes paste_classes: [2, 3] # Only Miniskirt(class2)/Skirt(class3) paste_scale: [0.3, 0.7] # Realistic resizing of pasted objects
General augmentations (applied to all)
mosaic: 1.0 # Helps context learning mixup: 0.05 # Reduced to avoid label confusion fliplr: 0.5 hsv_h: 0.015 # Mild color variation degrees: 5.0 # Small rotation for fashion items
Training parameters
batch: 16 # Match GPU capacity accumulate: 4 # Simulates batch=64 epochs: 150 # Longer training for rare classes patience: 50 # Early stopping if no improveme
but i trained untill now :
Epoch GPU_mem box_loss cls_loss dfl_loss Instances Size 104/150 2.92G 1.026 0.9478 1.206 55 640: 100%|██████████| 2447/2447 [07:51<00:00, Class Images Instances Box(P R mAP50 mAP50-95): 100%|██████████| 32/32 [00:06 all 1016 1987 0.581 0.525 0.536 0.423Can you help me please to reach all metrics above 0.8
THANKS
hillsonghimire
Even when I turned off augment=False, albumentation-related operations were still performed in yolo11. How to completely turn it off/disable?
- Glenn JocherUltralytics
@hillsonghimire to completely disable Albumentations augmentations in YOLO11, uninstall the Albumentations package since its presence automatically enables the integration. Run
pip uninstall albumentationsand verify it's removed from your environment. This will prevent any Albumentations transformations from being applied regardless of other settings. For more details, see the Albumentations integration guide.
DP1701
Thanks for this explanation. But if I understand correctly, not all functions of Albuminations are directly supported, or am I misunderstanding?
The explanation says: The integration includes optimized augmentations like blur, median blur, grayscale conversion, and CLAHE with carefully tuned probabilities to enhance model performance.
So only blur, median blur, grayscale conversion and CLAHE are applied and the others cannot be individually selected and adjusted?
- Glenn JocherUltralytics(editado)
The integration with Albumentations in YOLO11 automatically applies specific augmentations like blur, median blur, grayscale conversion, and CLAHE. While these are the default transformations used to enhance model performance, you can pass your own Albumentations transforms to
model.train()with theaugmentationsargument (Python only).
