Guia passo a passo para treinar modelos YOLO26 com o IBM Watsonx
As soluções de visão computacional escaláveis necessitam de uma infraestrutura para dados, treino e implementação. O IBM Watsonx é uma plataforma de IA e dados que permite desenvolver, implementar e gerir modelos de IA. Abrange todo o ciclo de vida da IA e integra-se com os serviços IBM Cloud.
Podes treinar modelos Ultralytics YOLO26 com o IBM Watsonx. É uma boa opção para empresas interessadas em treino eficiente de modelos, ajuste fino para tarefas específicas e melhoria do desempenho dos modelos com ferramentas robustas e uma configuração intuitiva. Este guia explica como treinar o YOLO26 com o IBM Watsonx, desde a configuração do ambiente até à avaliação dos modelos treinados.
O que é o IBM Watsonx?#
O Watsonx é a plataforma na nuvem da IBM, concebida para IA generativa comercial e dados científicos. Os três componentes do IBM Watsonx — watsonx.ai, watsonx.data e watsonx.governance — combinam-se para criar uma plataforma de IA fiável e completa, capaz de acelerar projetos de IA destinados a resolver problemas empresariais. Fornece ferramentas para criar, treinar e implementar modelos de aprendizagem automática, além de facilitar a ligação a várias fontes de dados.
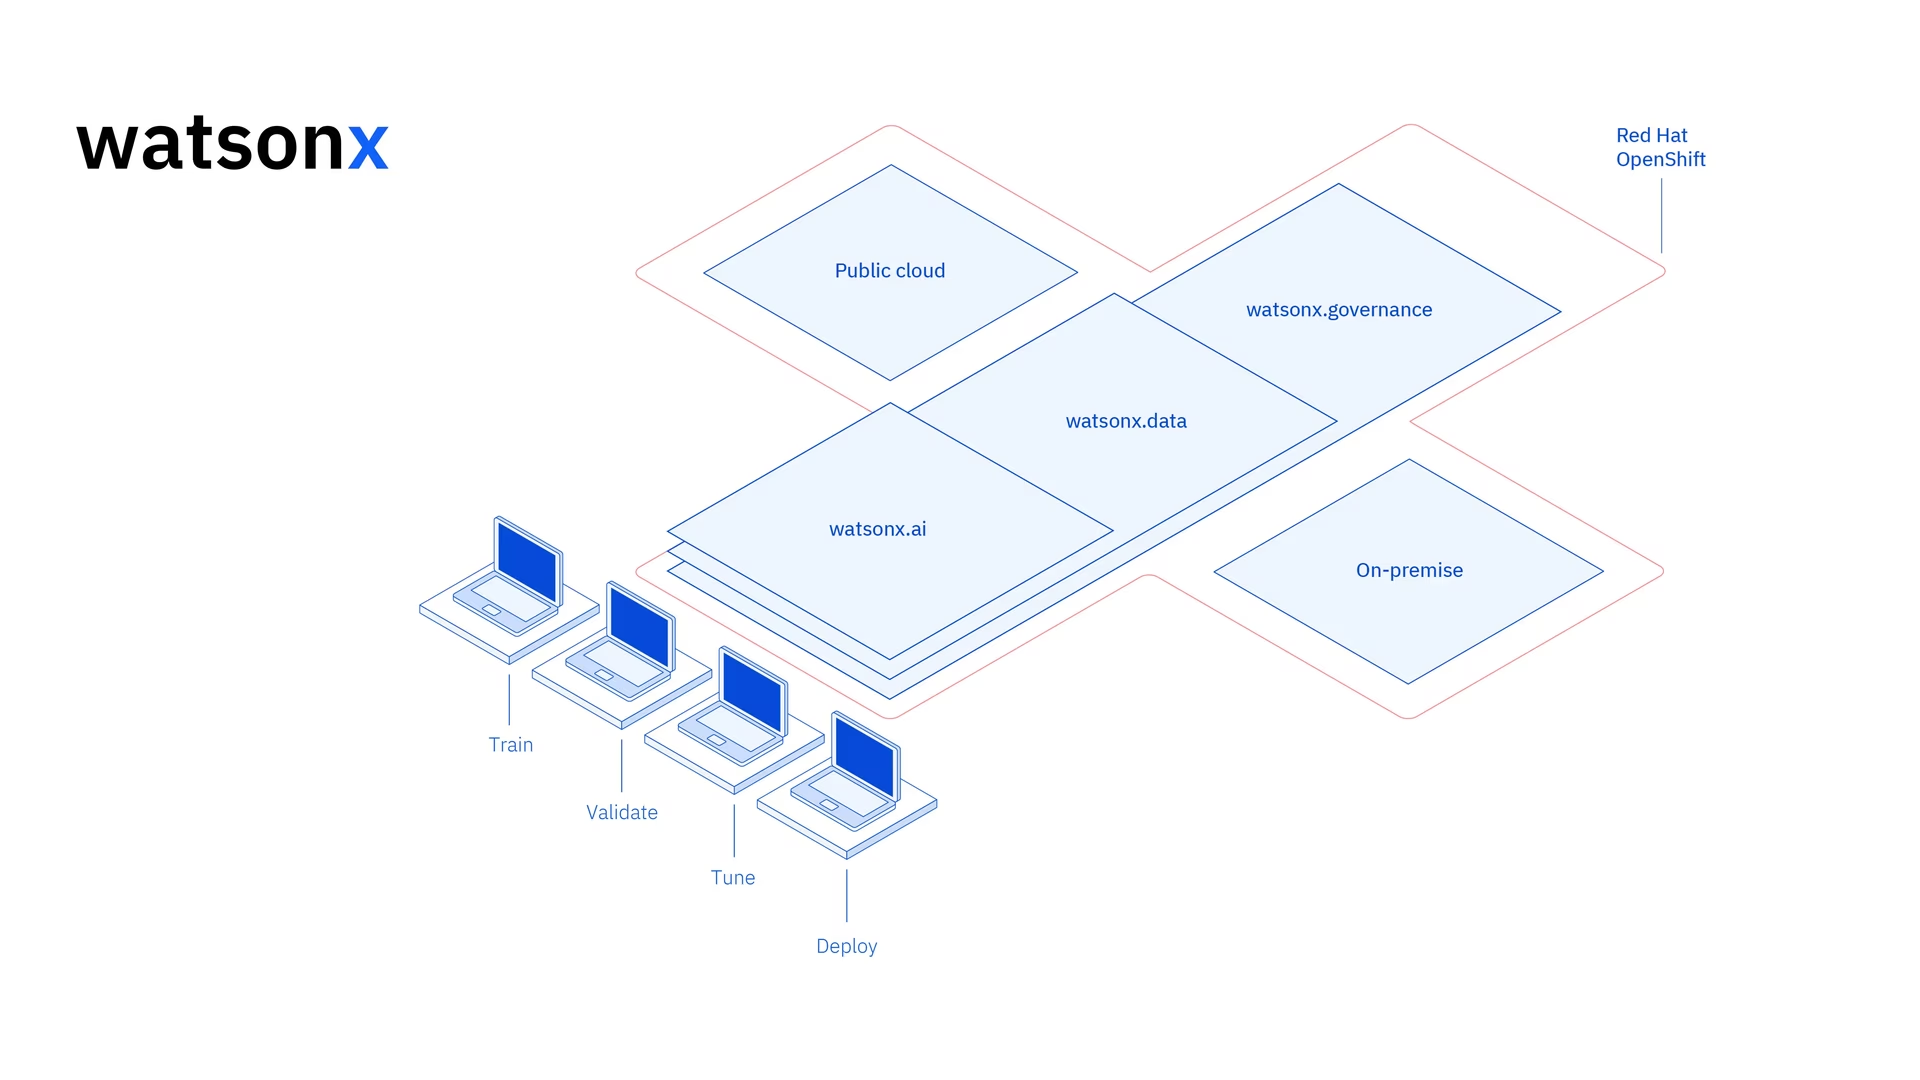
A sua interface e as funcionalidades de colaboração permitem desenvolver, gerir e implementar modelos. O IBM Watsonx é utilizado em aplicações de visão computacional, análise preditiva, processamento de linguagem natural e outras áreas da IA.
Principais funcionalidades do IBM Watsonx#
O IBM Watsonx é composto por três componentes principais: watsonx.ai, watsonx.data e watsonx.governance. Cada componente aborda um aspecto diferente de IA e gerenciamento de dados.
Watsonx.ai#
Watsonx.ai oferece ferramentas para desenvolvimento de IA e acesso a modelos personalizados compatíveis com IBM, modelos de terceiros como o Llama 3 e os próprios modelos Granite da IBM. Inclui o Prompt Lab para experimentar prompts de IA e o Tuning Studio para melhorar o desempenho dos modelos com dados rotulados. Também oferece ferramentas abrangentes para automatizar o ciclo de vida dos modelos de IA e conectar-se a várias APIs e bibliotecas.
Watsonx.data#
Watsonx.data oferece suporte a implantações na nuvem e locais. Seu console intuitivo fornece acesso centralizado aos dados em diferentes ambientes e facilita a exploração de dados com SQL comum. Ele otimiza cargas de trabalho com mecanismos de consulta eficientes, como Presto e Spark, acelera a obtenção de insights com uma camada semântica baseada em IA, inclui um banco de dados vetorial para relevância em IA e oferece suporte a formatos de dados abertos para facilitar o compartilhamento de dados de análise e IA.
Watsonx.governance#
Watsonx.governance facilita a conformidade ao identificar automaticamente mudanças regulatórias e aplicar políticas. A plataforma associa os requisitos aos dados internos de risco e fornece fichas técnicas de IA atualizadas. Ela ajuda a gerenciar riscos com alertas e ferramentas para detectar problemas como viés e deriva. Também automatiza o monitoramento e a documentação do ciclo de vida da IA, organiza o desenvolvimento de IA com um inventário de modelos e aprimora a colaboração com painéis intuitivos e ferramentas de geração de relatórios.
Como treinar o YOLO26 com o IBM Watsonx#
Podes usar o IBM Watsonx para acelerar o fluxo de trabalho de treino do teu modelo YOLO26.
Pré-requisitos#
Você precisa de uma conta do IBM Cloud para criar um projeto no watsonx.ai e também precisará de uma conta do Kaggle para carregar o conjunto de dados.
Passo 1: configura o teu ambiente#
Primeiro, tens de configurar uma conta IBM para usar um Jupyter Notebook. Inicia sessão no watsonx.ai com a tua conta IBM Cloud.
Em seguida, cria um projeto watsonx.ai e um Jupyter Notebook.
Depois disso, um ambiente de notebook será aberto para você carregar seu conjunto de dados. Você pode usar o código deste tutorial para treinar um modelo simples de detecção de objetos.
Passo 2: instala e importa as bibliotecas relevantes#
Em seguida, podes instalar e importar as bibliotecas Python necessárias.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Para obter instruções detalhadas e boas práticas relacionadas ao processo de instalação, consulte nosso guia de instalação da Ultralytics. Se tiver dificuldades ao instalar os pacotes necessários para YOLO26, consulte nosso guia de problemas comuns para ver soluções e dicas.
Depois, podes importar os pacotes necessários.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Passo 3: carrega os dados#
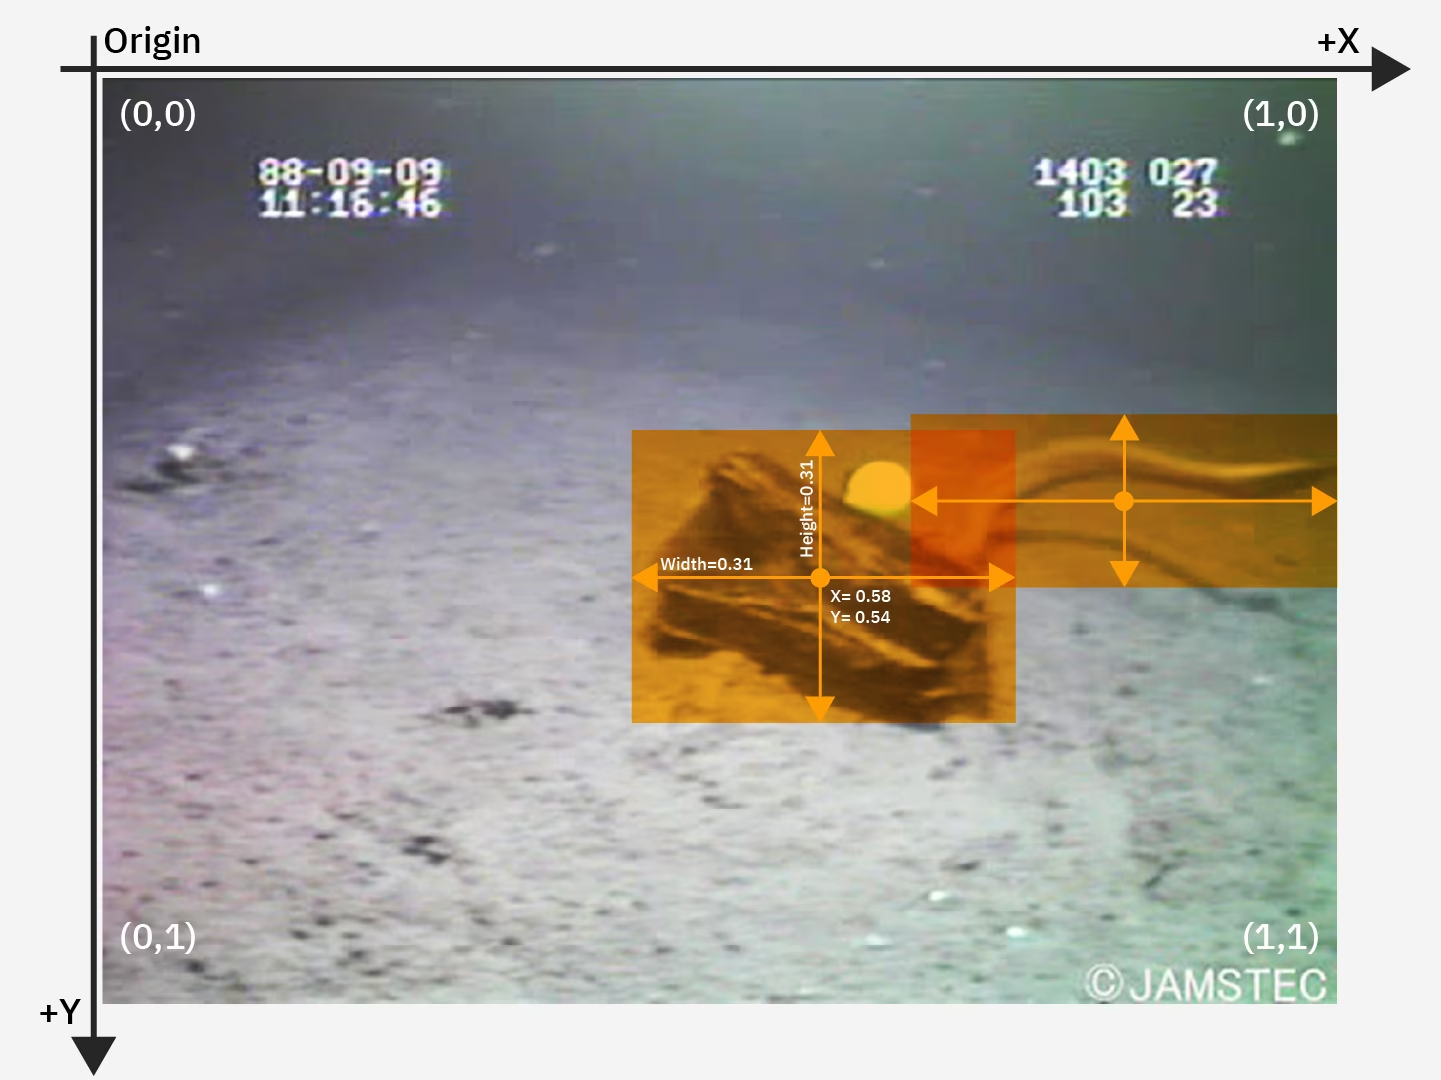
Neste tutorial, usaremos um conjunto de dados de lixo marinho disponível no Kaggle (também disponível como Trash-ICRA19 na Ultralytics Platform). Com esse conjunto de dados, treinaremos um modelo YOLO26 personalizado para detectar e classificar lixo e objetos biológicos em imagens subaquáticas.
Podemos carregar o conjunto de dados diretamente no notebook usando a API do Kaggle. Primeiro, cria uma conta gratuita no Kaggle. Depois de criares a conta, terás de gerar uma chave API. Encontras as instruções para gerar a chave na documentação da API do Kaggle, na secção "API credentials".
Copia e cola o teu nome de utilizador do Kaggle e a chave API no código seguinte. Depois, executa o código para instalar a API e carregar o conjunto de dados no Watsonx.
# Install kaggle
pip install kaggle
Depois de instalar o Kaggle, podemos carregar o conjunto de dados no Watsonx.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
Depois de carregar o conjunto de dados, exibimos e salvamos nosso diretório de trabalho. Também exibimos o conteúdo do diretório de trabalho para confirmar que o conjunto de dados "trash_ICRA19" foi carregado corretamente.
Se vires "trash_ICRA19" entre os conteúdos do diretório, significa que foi carregado com sucesso. Deves ver três ficheiros/pastas: um ficheiro config.yaml, um diretório videos_for_testing e um diretório dataset. Vamos ignorar o diretório videos_for_testing, por isso podes eliminá-lo.
Usaremos o arquivo config.yaml e o conteúdo do diretório do conjunto de dados para treinar nosso modelo de detecção de objetos. Aqui está uma imagem de exemplo do nosso conjunto de dados de lixo marinho.
Passo 4: pré-processa os dados#
Todos os rótulos do conjunto de dados de lixo marinho já estão formatados como arquivos .txt do YOLO. No entanto, precisamos reorganizar os diretórios de imagens e rótulos para que o modelo consiga encontrá-los. Atualmente, o diretório do conjunto de dados carregado tem esta estrutura:
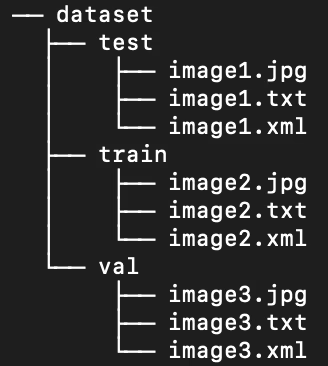
Por padrão, os modelos YOLO precisam de subdiretórios images e labels separados em cada divisão de treino/validação/teste. Precisamos reorganizar o diretório para que ele tenha a seguinte estrutura:
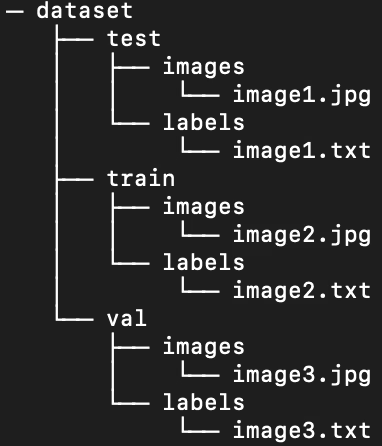
Para reorganizar o diretório do conjunto de dados, podemos executar o seguinte script:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Em seguida, precisamos modificar o arquivo YAML do conjunto de dados. Esta é a configuração que usaremos no nosso arquivo .yaml. Os números dos IDs das classes começam em 0:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
Execute o seguinte script para excluir o conteúdo atual de config.yaml e substituí-lo pela configuração que representa a nova estrutura de diretórios do conjunto de dados. O script usa automaticamente a variável work_dir que definimos anteriormente, então verifique se ela aponta para o seu conjunto de dados antes da execução e mantenha inalteradas as definições dos subdiretórios train, val e test.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Passo 5: treina o modelo YOLO26#
Execute o seguinte comando para ajustar um modelo YOLO26n pré-treinado.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueVejamos mais de perto os parâmetros do comando de treino do modelo:
- detect: A tarefa de visão computacional para a qual você está usando o modelo YOLO e o conjunto de dados especificados.
- train: o modo, que indica a finalidade para a qual estás a carregar o modelo e os dados especificados. Mais tarde, quando testarmos o desempenho do nosso modelo, usaremos
predict. - epochs: O número de vezes que o YOLO26 percorrerá todo o conjunto de dados.
- batch: O tamanho do lote de treinamento, ou seja, o número de imagens que o modelo processa antes de atualizar seus parâmetros.
- plots: Instrui o YOLO a gerar e salvar gráficos das métricas de treinamento e avaliação do nosso modelo.
Para entender detalhadamente o processo de treinamento do modelo e conhecer as práticas recomendadas, consulte o guia de treinamento de modelos YOLO26. Este guia vai ajudar você a aproveitar ao máximo seus experimentos e garantir o uso eficaz do YOLO26.
Etapa 6: testar o modelo#
Agora podemos executar a inferência para testar o desempenho do nosso modelo ajustado:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueEste comando gera rótulos previstos para cada imagem do conjunto de teste, além de novos arquivos de imagem de saída que sobrepõem a caixa delimitadora prevista à imagem original.
Os rótulos previstos em .txt de cada imagem são salvos por meio do argumento save_txt=True, e as imagens de saída com caixas delimitadoras sobrepostas são geradas pelo argumento save=True. O parâmetro conf=0.5 instrui o modelo a ignorar todas as previsões com nível de confiança inferior a 50%.
Por fim, iou=.5 define o limiar de supressão não máxima (NMS): caixas da mesma classe que se sobrepõem em mais de 50% a uma caixa com pontuação mais alta são descartadas. Isso reduz as caixas duplicadas geradas para o mesmo objeto. Podemos carregar as imagens com as caixas delimitadoras previstas sobrepostas para ver o desempenho do nosso modelo em algumas imagens.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
O código acima exibe dez imagens do conjunto de teste com as caixas delimitadoras previstas, acompanhadas de rótulos com os nomes das classes e níveis de confiança.
Etapa 7: avaliar o modelo#
Podemos gerar visualizações da precisão e da revocação do modelo para cada classe. Essas visualizações são salvas no diretório da execução de treinamento ({work_dir}/runs/detect/train/). A pontuação de precisão é exibida em BoxP_curve.png:
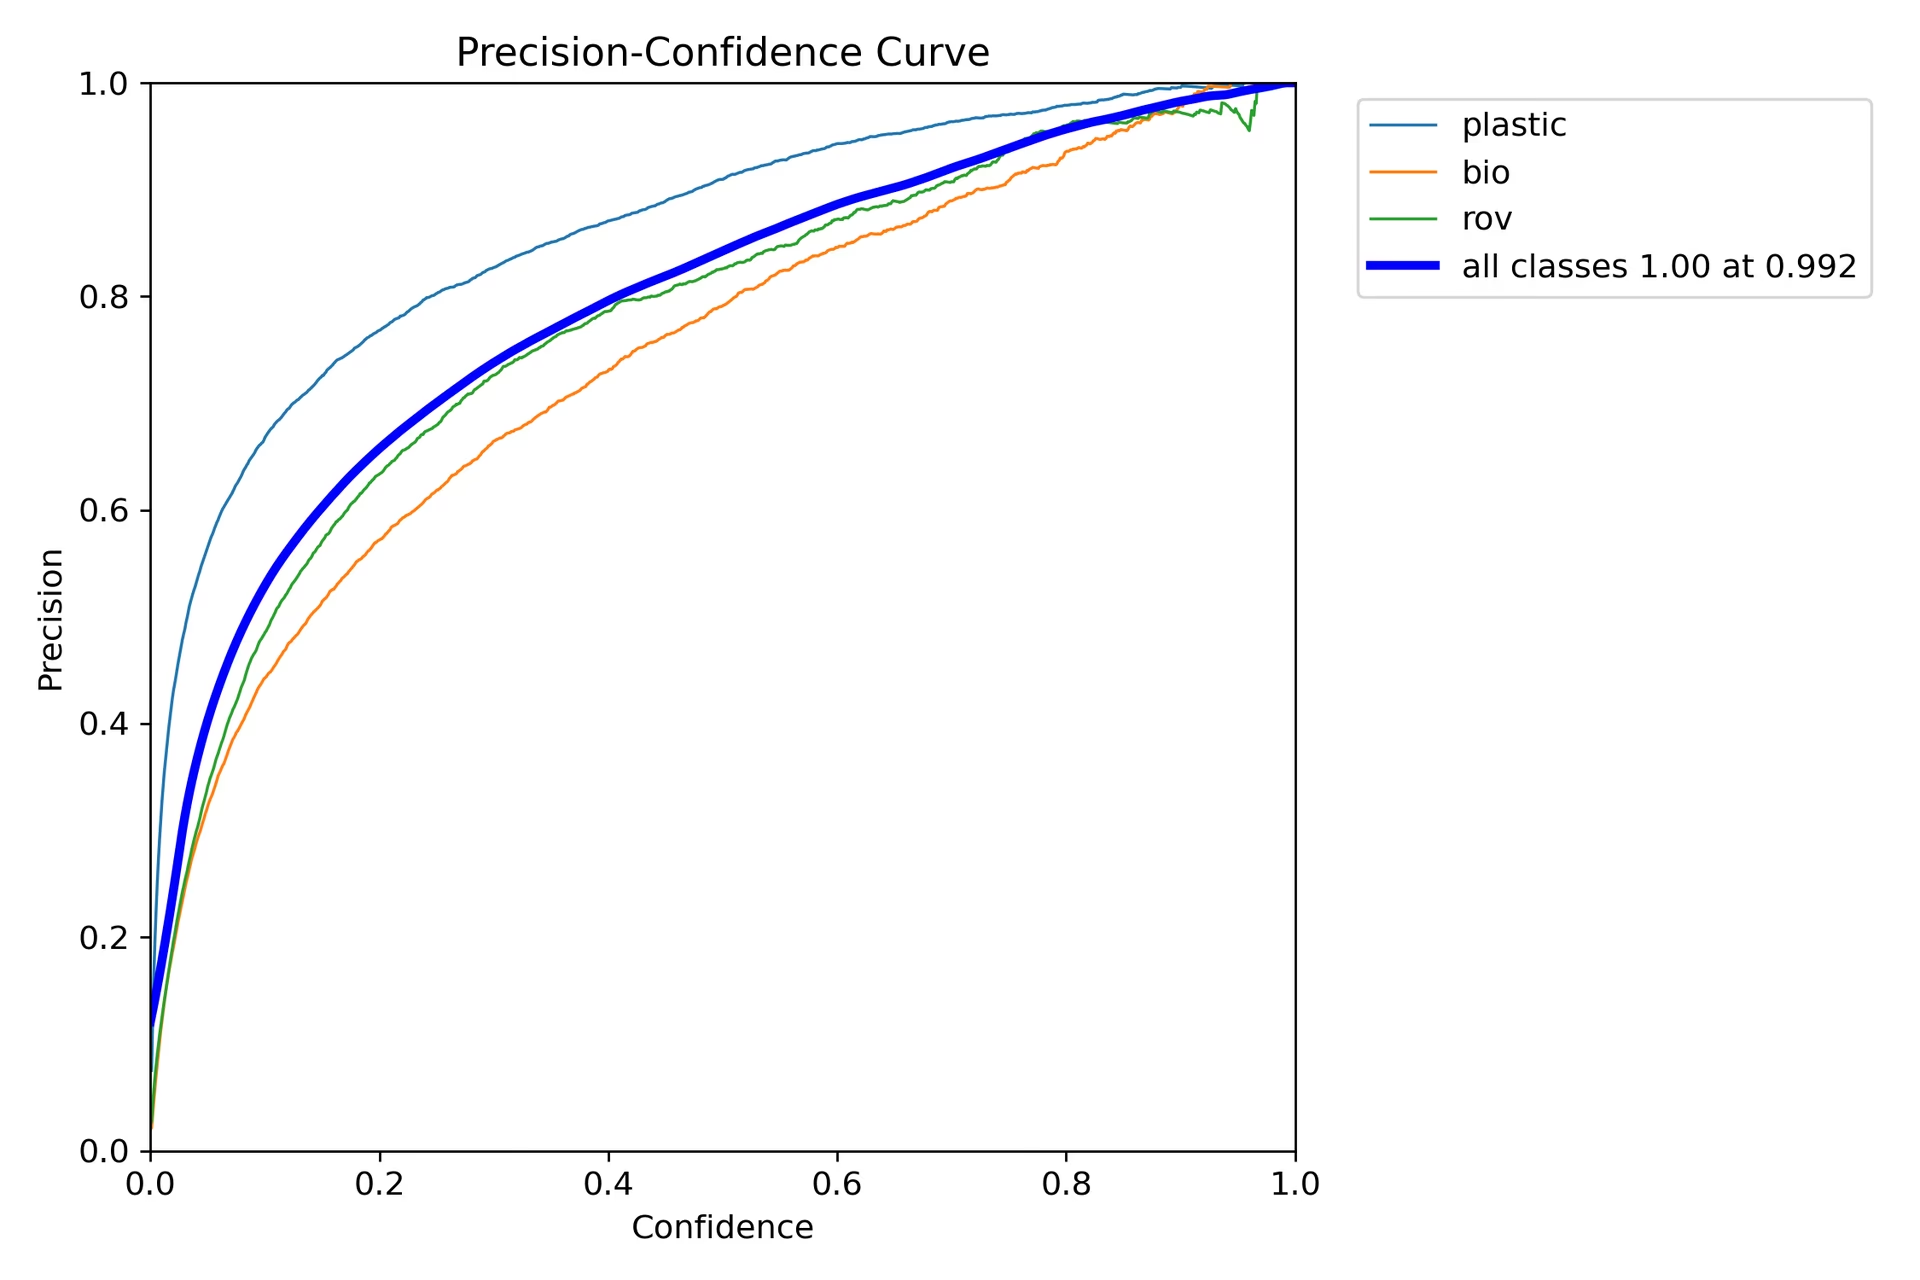
O gráfico mostra que a precisão aumenta à medida que o limiar de confiança das previsões sobe. No entanto, após duas épocas, a precisão do modelo ainda não estabilizou em determinado nível de confiança.
O gráfico de revocação (BoxR_curve.png) mostra uma tendência inversa:
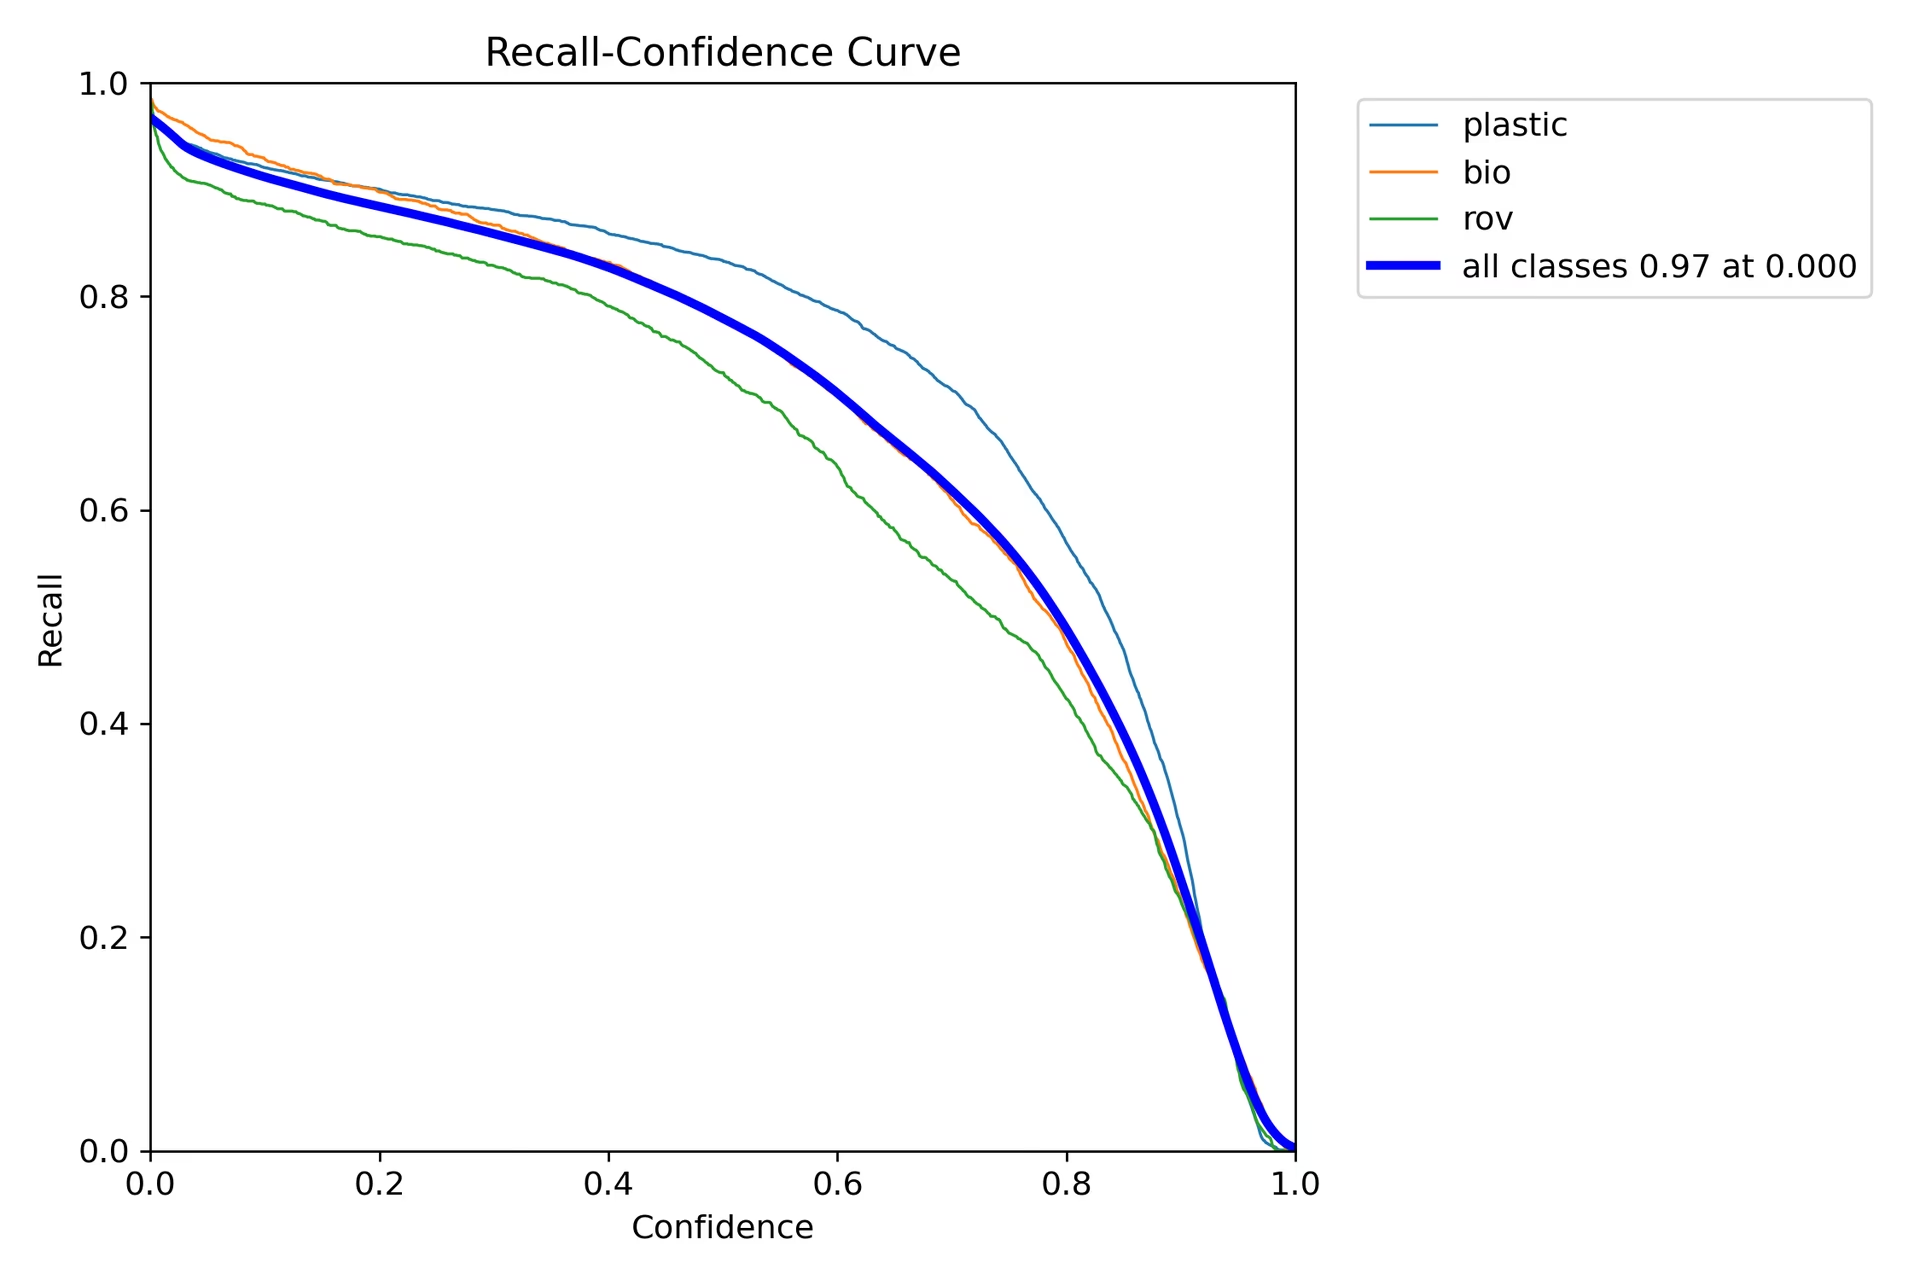
Ao contrário da precisão, a revocação é mais alta com limiares de confiança baixos e diminui à medida que o limiar aumenta. Isso ilustra a compensação entre precisão e revocação.
Etapa 8: cálculo da interseção sobre união#
Você pode medir a precisão da localização calculando a interseção sobre união (IoU) entre uma caixa delimitadora prevista e uma caixa delimitadora de referência do mesmo objeto.
Resumo#
Explorámos os principais recursos do IBM Watsonx e como treinar um modelo YOLO26 com ele. O IBM Watsonx também oferece ferramentas para criação de modelos, gestão de dados e conformidade.
Para mais detalhes sobre o uso, consulte a documentação oficial do IBM Watsonx.
Perguntas frequentes#
Para treinar um modelo YOLO26 usando o IBM Watsonx, siga estas etapas:
- Configure seu ambiente: crie uma conta do IBM Cloud e configure um projeto do Watsonx.ai. Use um Jupyter Notebook como ambiente de programação.
- Instale as bibliotecas: instale as bibliotecas necessárias, como
torch,opencveultralytics. - Carregue os dados: use a API do Kaggle para carregar seu conjunto de dados no Watsonx.
- Pré-processe os dados: organize seu conjunto de dados na estrutura de diretórios necessária e atualize o arquivo de configuração
.yaml. - Treinar o modelo: Use a interface de linha de comando do YOLO para treinar seu modelo com parâmetros como
epochsebatch. - Teste e avalie: execute a inferência para testar o modelo e avaliar seu desempenho usando métricas como precisão e revocação.
Para instruções detalhadas, consulte nosso guia de treinamento de modelos YOLO26.
O IBM Watsonx oferece vários recursos importantes para o treinamento de modelos de IA:
- Watsonx.ai: oferece ferramentas para desenvolvimento de IA, incluindo acesso a modelos personalizados compatíveis com IBM e modelos de terceiros como o Llama 3. Inclui o Prompt Lab e o Tuning Studio para o gerenciamento abrangente do ciclo de vida da IA.
- Watsonx.data: oferece suporte a implantações na nuvem e locais, com acesso centralizado a dados, mecanismos de consulta eficientes, como Presto e Spark, e uma camada semântica baseada em IA.
- Watsonx.governance: automatiza a conformidade, gerencia riscos com alertas e oferece ferramentas para detectar problemas como viés e deriva. Também inclui painéis e ferramentas de geração de relatórios para colaboração.
Para saber mais, consulte a documentação oficial do IBM Watsonx.
O IBM Watsonx é adequado para treinar o Ultralytics YOLO26, pois suas ferramentas cobrem todo o ciclo de vida da IA. Entre os principais benefícios estão:
- Escalabilidade: amplie facilmente o treinamento do seu modelo com os serviços do IBM Cloud.
- Integração: Conecte-se a várias fontes de dados e APIs.
- Interface fácil de usar: simplifica o processo de desenvolvimento com uma interface intuitiva e colaborativa.
- Ferramentas avançadas: acesse ferramentas como o Prompt Lab e o Tuning Studio para melhorar o desempenho dos modelos.
Para pré-processar seu conjunto de dados para treinar o YOLO26 no IBM Watsonx:
- Organize os diretórios: verifique se seu conjunto de dados segue a estrutura de diretórios do YOLO, com subdiretórios separados para imagens e rótulos nas divisões train/val/test.
- Atualize o arquivo .yaml: modifique o arquivo de configuração
.yamlpara refletir a nova estrutura de diretórios e os nomes das classes. - Execute o script de pré-processamento: use um script Python para reorganizar seu conjunto de dados e atualizar o arquivo
.yamlde acordo.
Veja a seguir um exemplo de script para organizar seu conjunto de dados:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Para saber mais, consulte nosso guia de pré-processamento de dados.
Antes de começar a treinar um modelo YOLO26 no IBM Watsonx, verifique se você atende aos seguintes pré-requisitos:
- Conta do IBM Cloud: crie uma conta no IBM Cloud para acessar o Watsonx.ai.
- Conta do Kaggle: para carregar conjuntos de dados, você precisará de uma conta do Kaggle e de uma chave de API.
- Jupyter Notebook: configure um ambiente Jupyter Notebook no Watsonx.ai para programar e treinar o modelo.
Para saber mais sobre como configurar seu ambiente, consulte nosso guia de instalação da Ultralytics.


Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.