Guia de início rápido: Seeed Studio reCamera com Ultralytics YOLO26
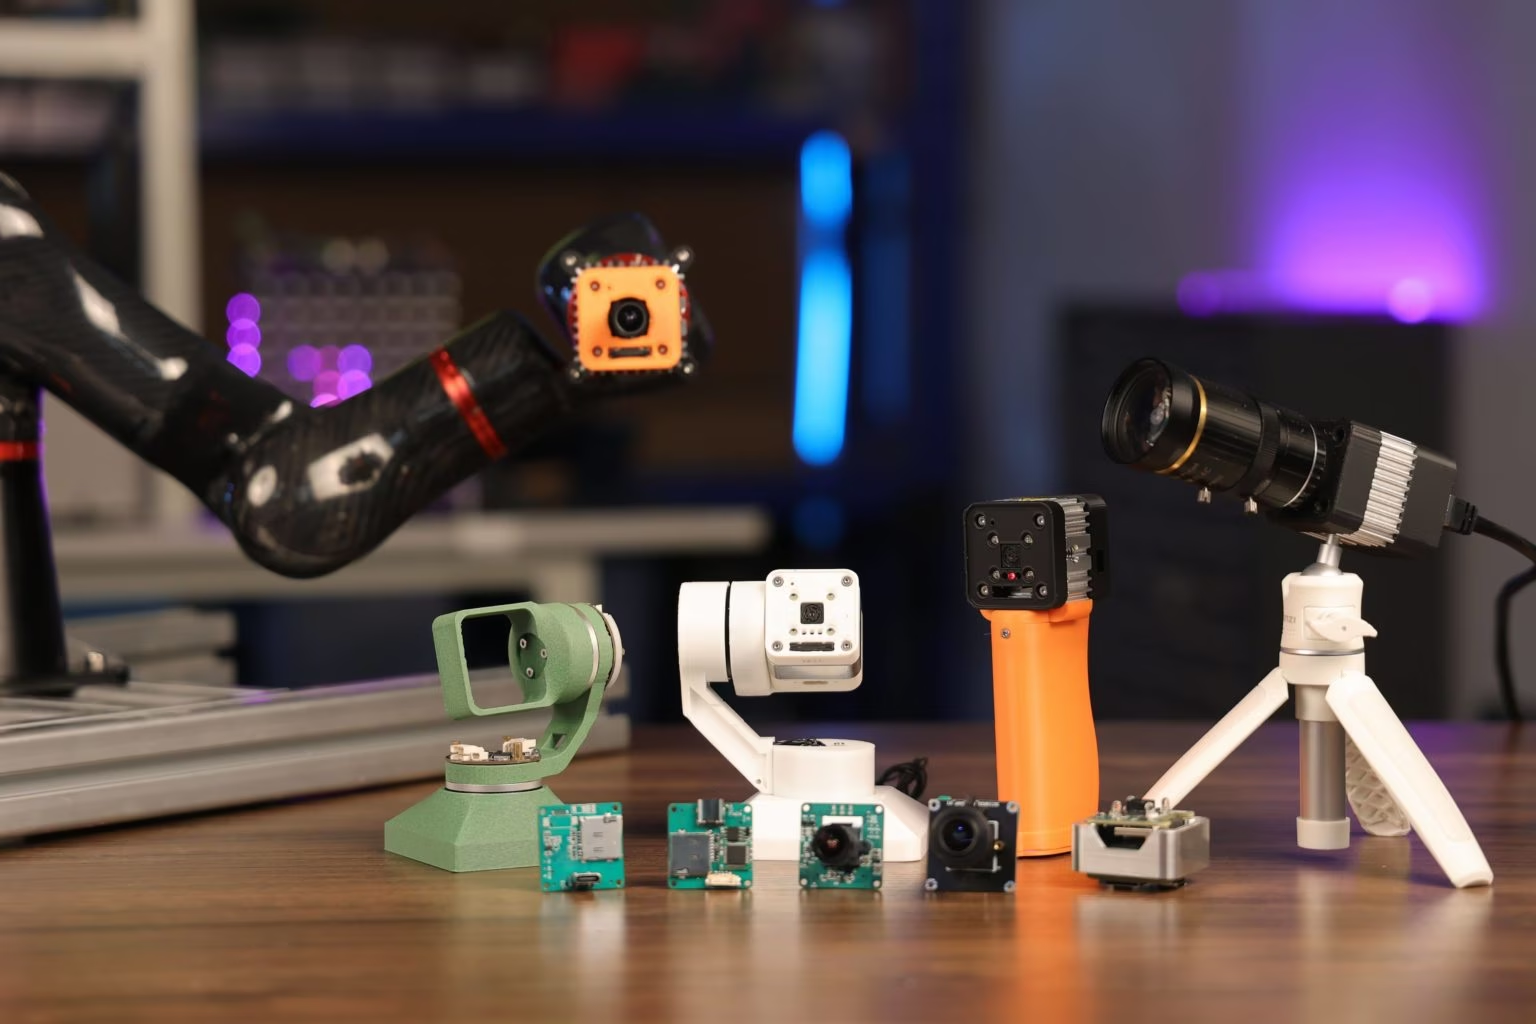
A reCamera foi apresentada à comunidade de IA no YOLO Vision 2024 (YV24), evento híbrido anual da Ultralytics. Ela foi projetada principalmente para aplicações de IA de borda, oferecendo processamento de IA no dispositivo e implantação simples.
Com suporte a diversas configurações de hardware e recursos de código aberto, ela é adequada para prototipar e implantar soluções de visão computacional na borda.
Por que escolher a reCamera?#
A série reCamera foi criada especificamente para aplicações de IA de borda e adaptada às necessidades dos desenvolvedores. Os principais recursos incluem:
-
Desempenho com RISC-V: o processador SG200X, baseado na arquitetura RISC-V, oferece desempenho eficiente para tarefas de IA de borda. Com capacidade para executar 1 trilhão de operações por segundo (1 TOPS), ele lida com tarefas como detecção de objetos em tempo real.
-
Tecnologias de vídeo otimizadas: oferece suporte a padrões avançados de compressão de vídeo, incluindo H.264 e H.265, para reduzir as necessidades de armazenamento e largura de banda sem sacrificar a qualidade. Recursos como imagens HDR, redução de ruído 3D e correção de lente mantêm a qualidade da imagem mesmo em ambientes desafiadores.
-
Processamento duplo com eficiência energética: enquanto o SG200X lida com tarefas complexas de IA, um microcontrolador menor de 8 bits gerencia operações mais simples para economizar energia, tornando a reCamera ideal para configurações alimentadas por bateria ou de baixo consumo.
-
Design modular e atualizável: a reCamera tem uma estrutura modular composta por três componentes principais: a placa principal, a placa do sensor e a placa-base. Esse design permite que os desenvolvedores substituam ou atualizem componentes conforme os projetos evoluem.
Configuração rápida do hardware da reCamera#
Siga a página Introdução à reCamera e selecione o seu dispositivo (como reCamera 2002 Series, Gimbal ou HQ POE) para abrir o Guia de início rápido e configurar o dispositivo, por exemplo, conectá-lo a uma rede e acessar a interface web do Node-RED para visualizar rapidamente os resultados da detecção.
Inferência usando modelos YOLO pré-instalados#
A reCamera vem com quatro modelos Ultralytics YOLO pré-instalados, e você pode escolher o modelo desejado no painel do Node-RED.
Etapa 1: se você conectou a reCamera a uma rede, digite o endereço IP da reCamera em um navegador para abrir o painel do Node-RED. Se você conectou a reCamera a um PC via USB, digite 192.168.42.1. O modelo de detecção é carregado por padrão.
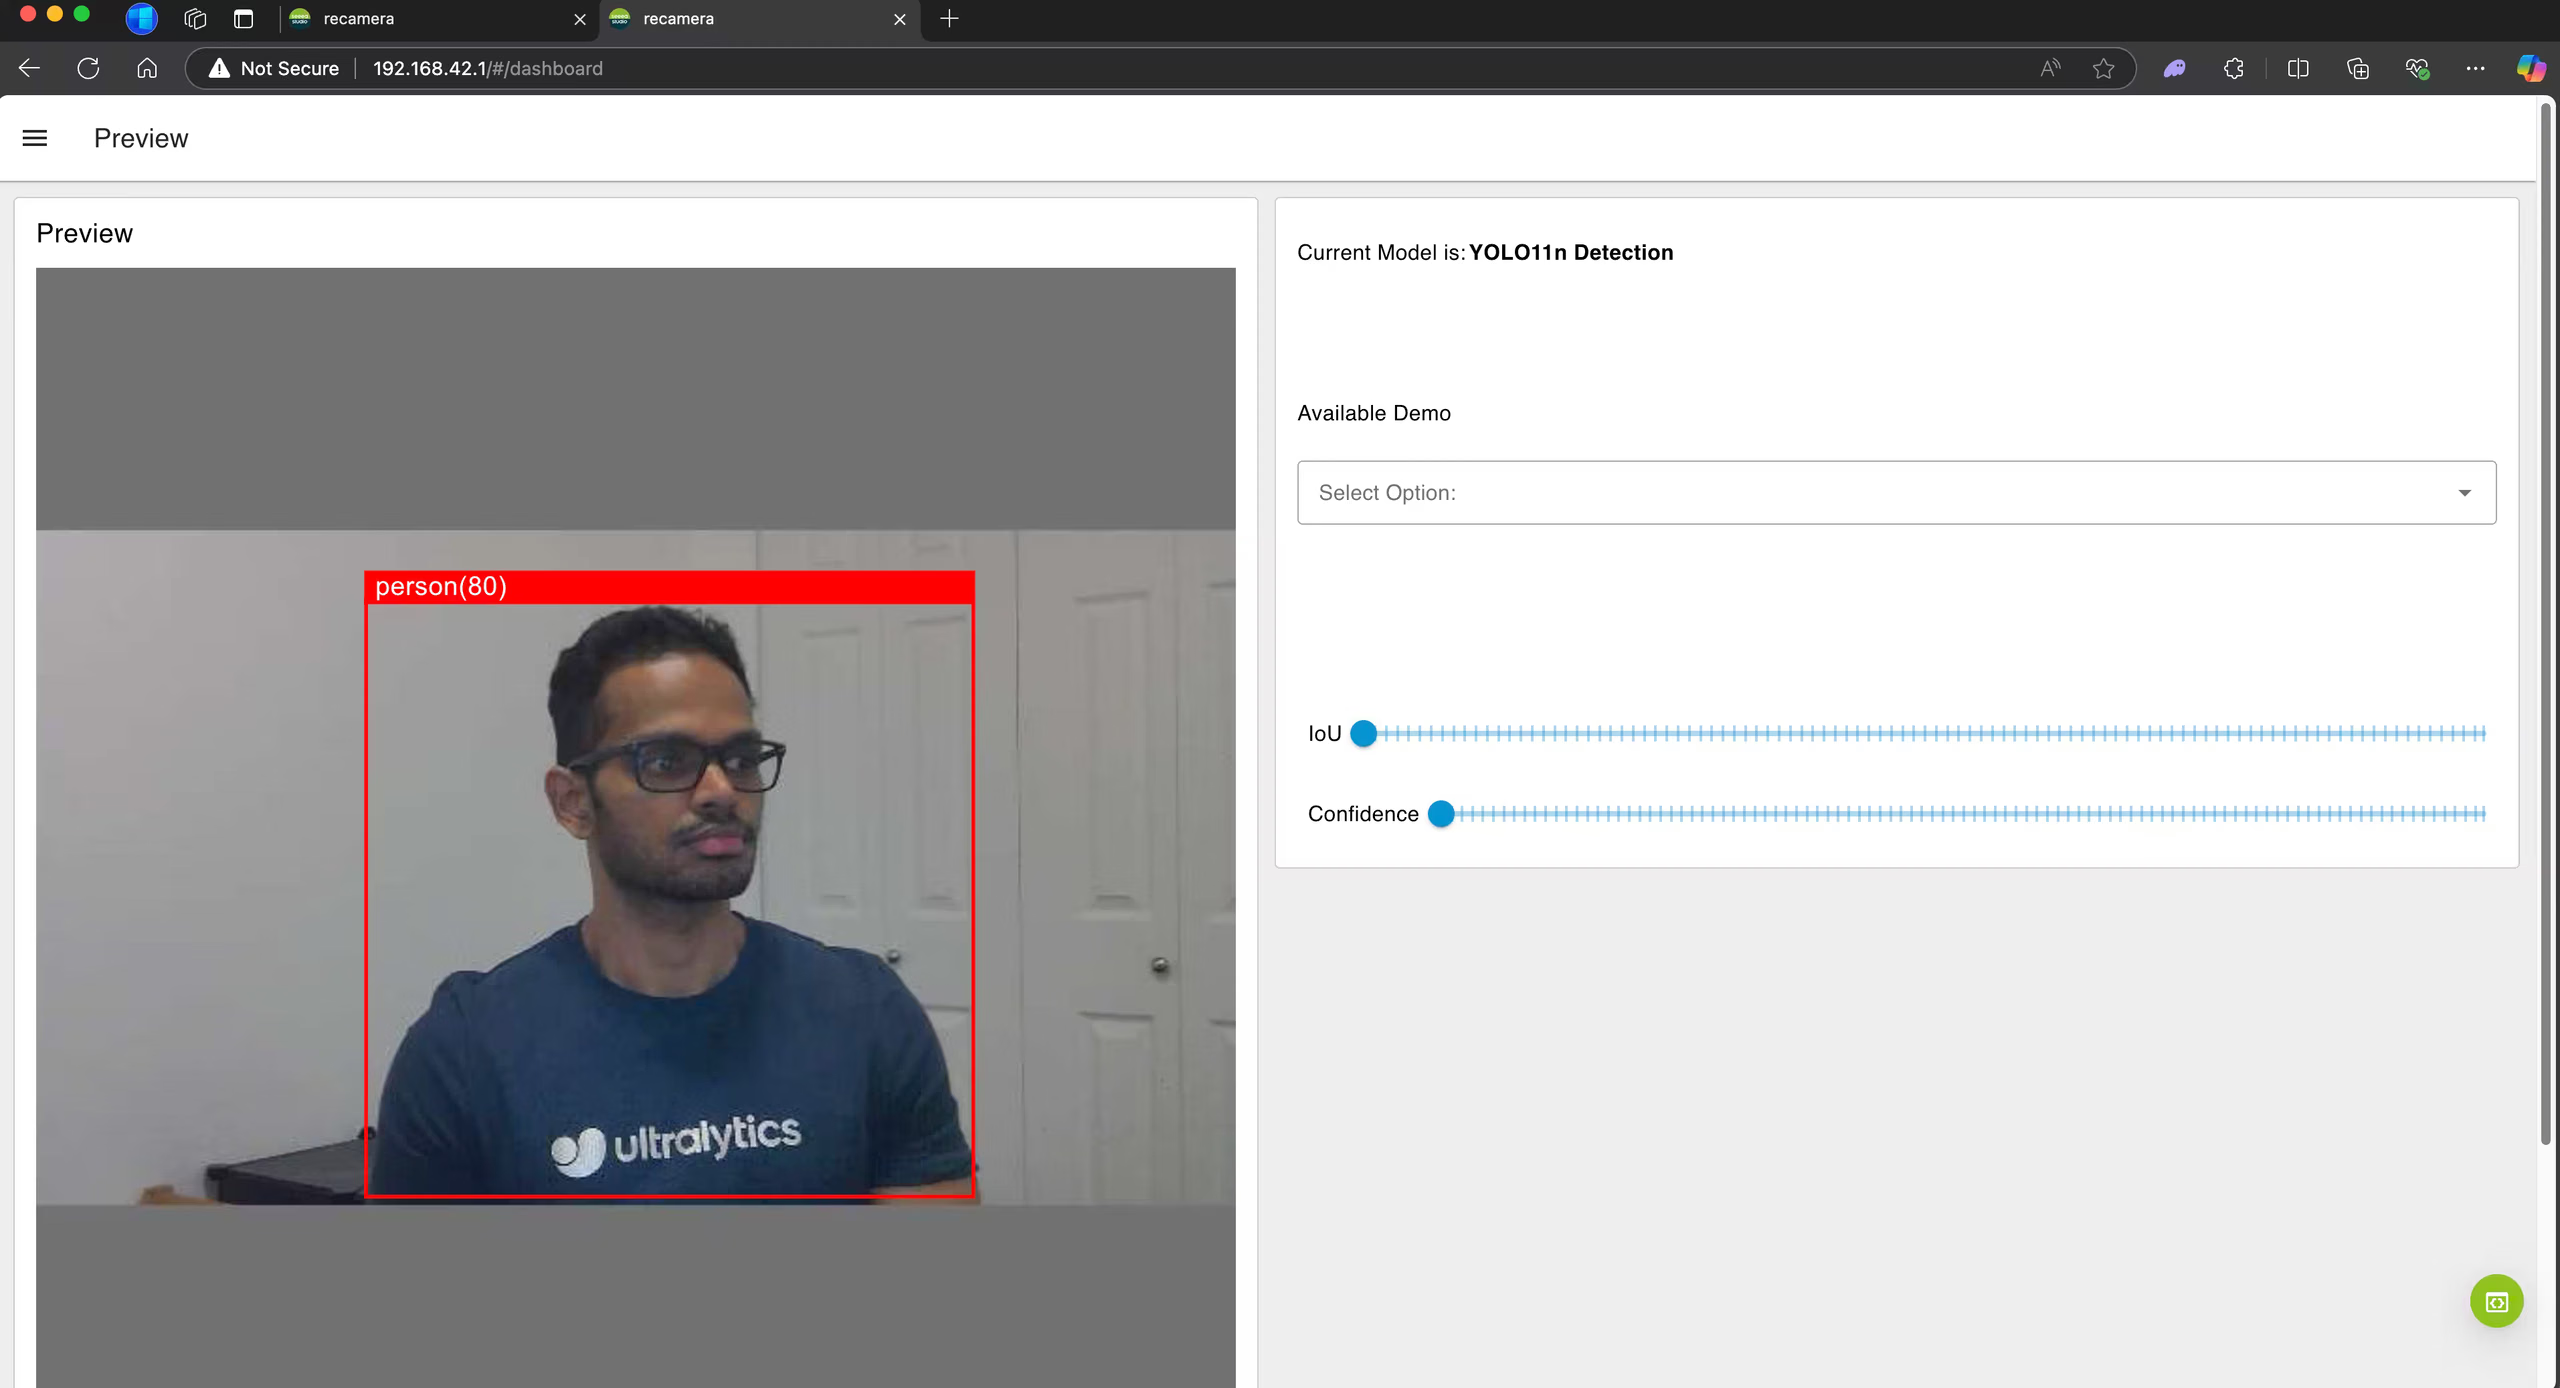
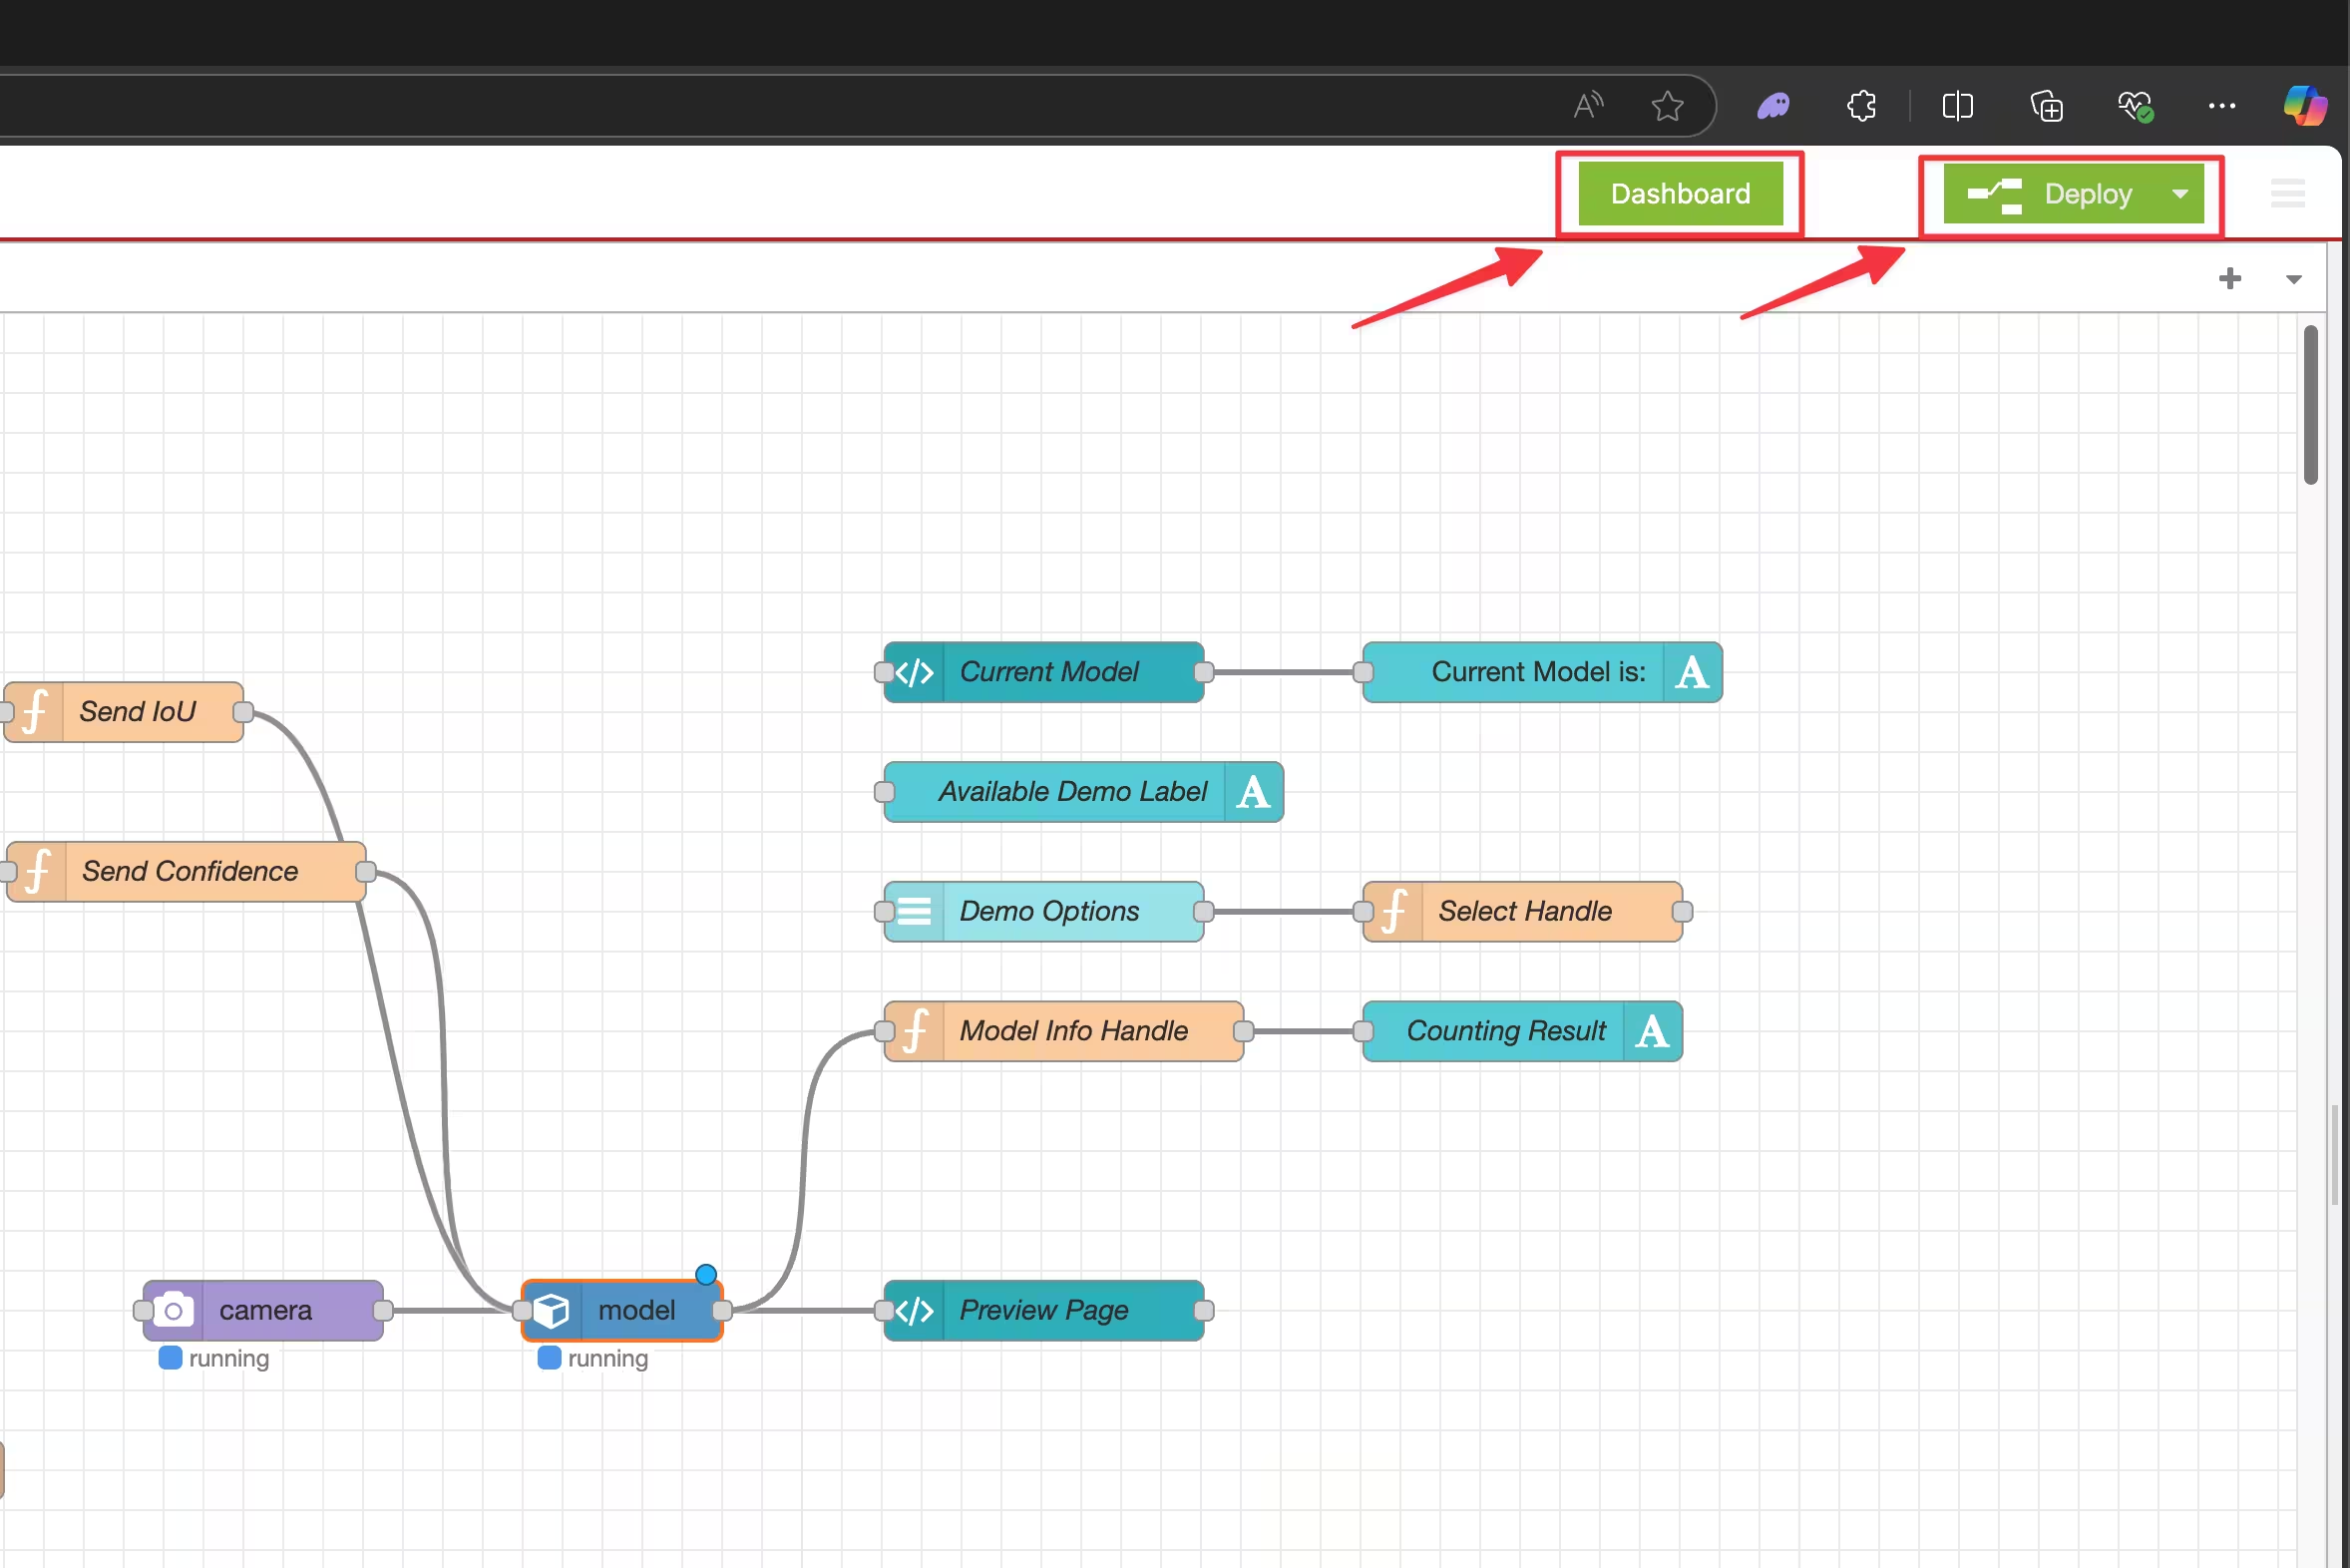
Etapa 2: clique no círculo verde no canto inferior direito para acessar o editor de fluxo do Node-RED.
Etapa 3: clique no nó model e depois em On Device.
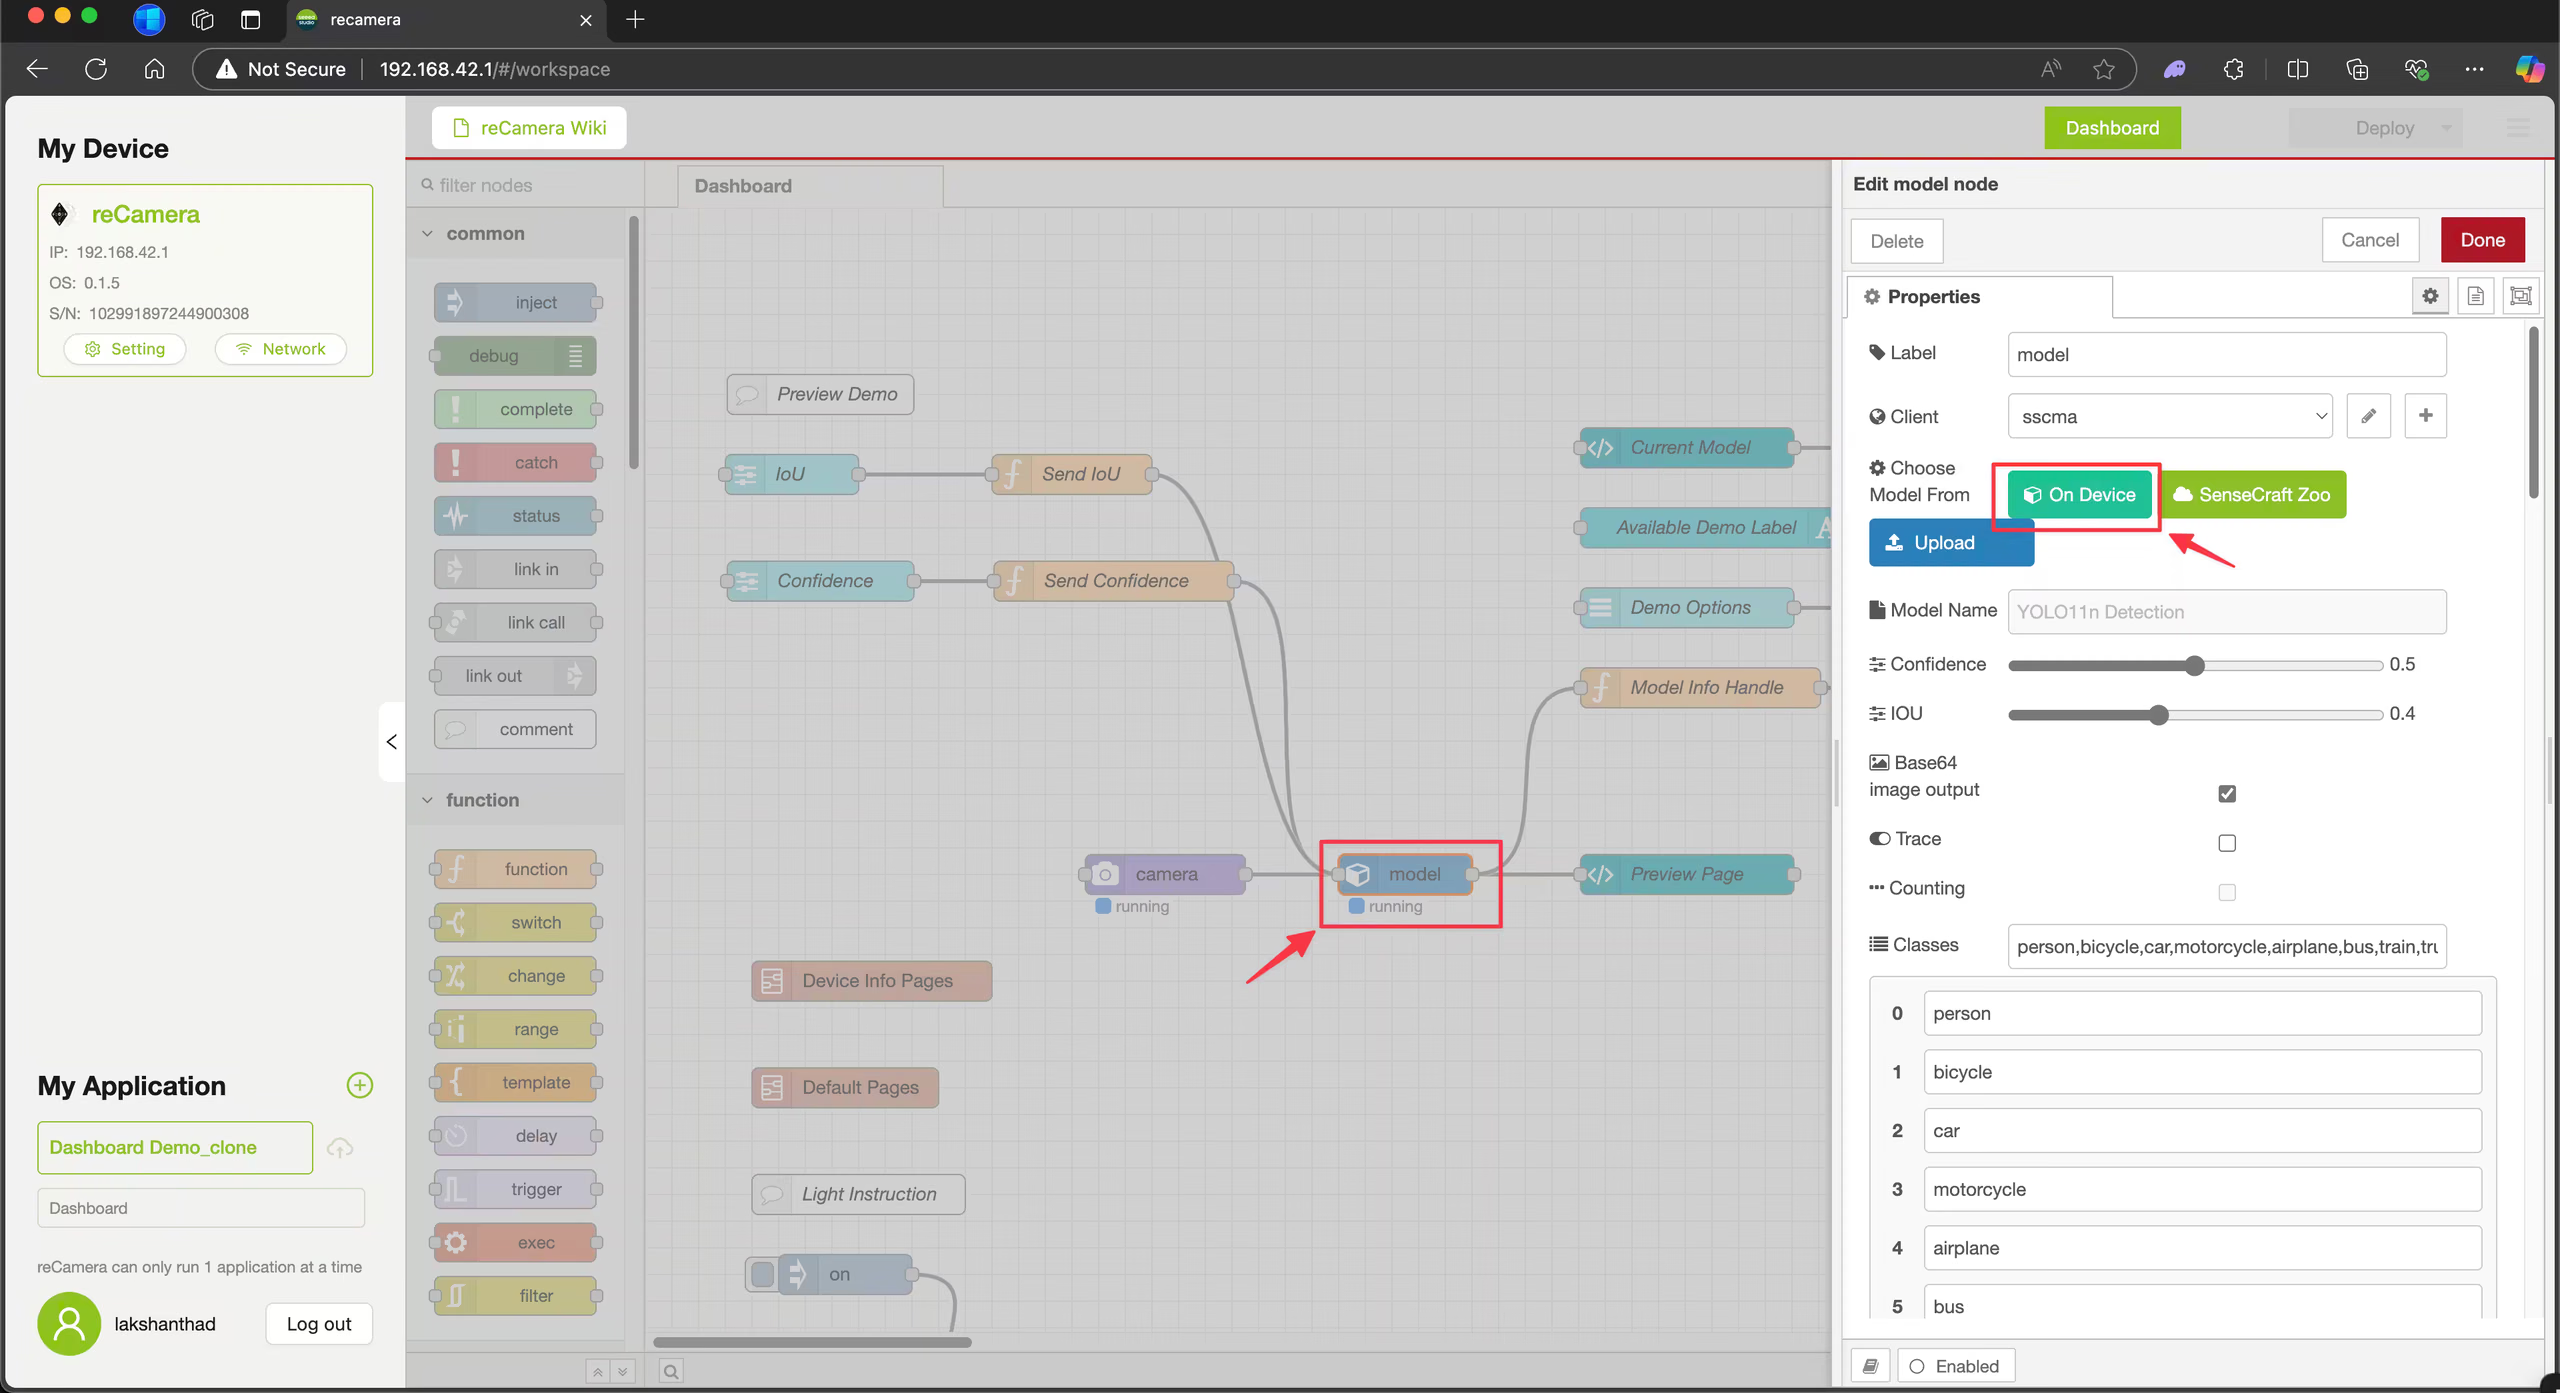
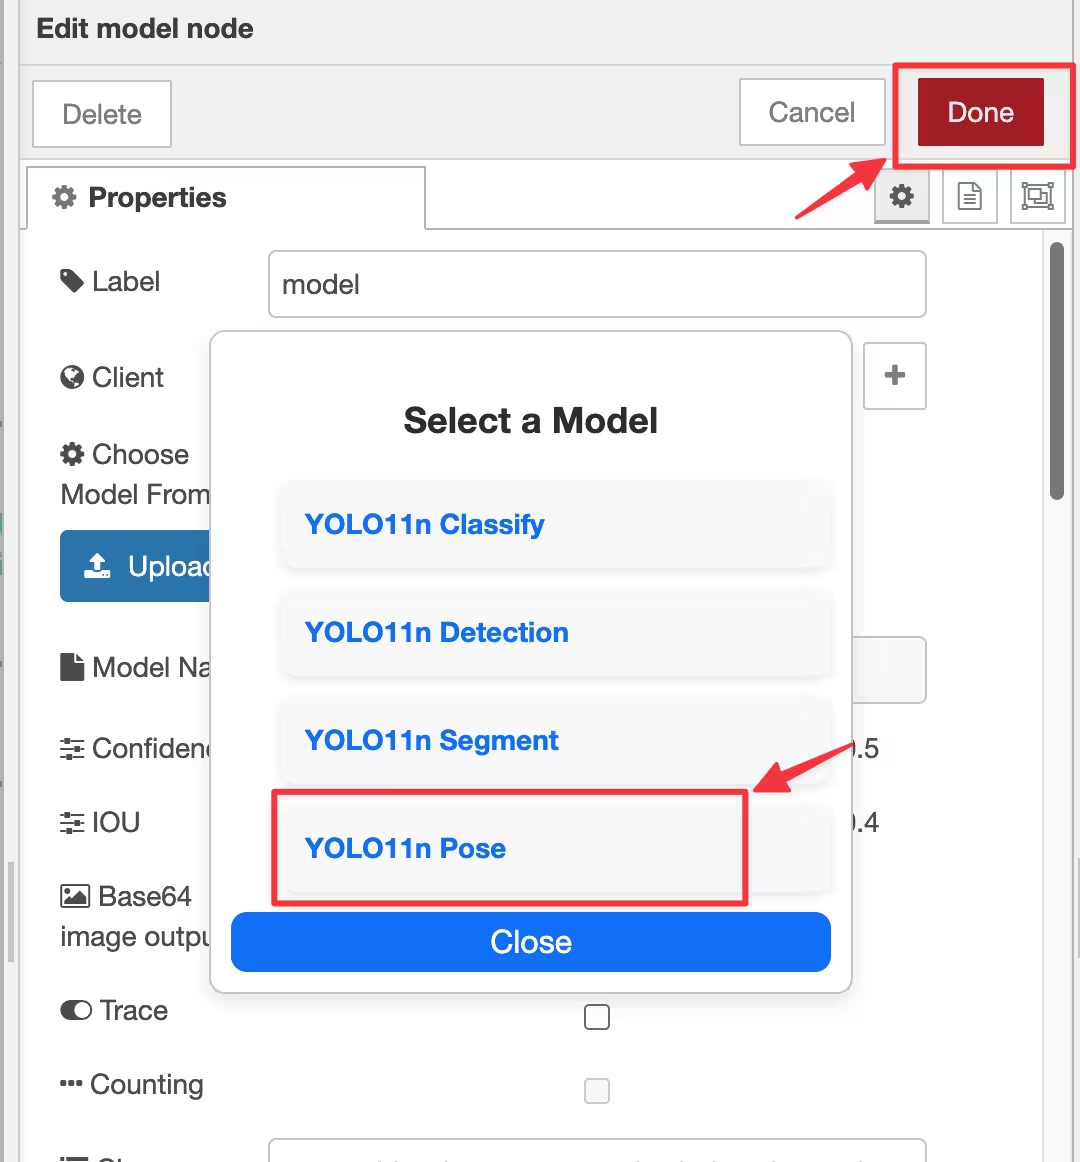
Etapa 4: escolha um dos quatro modelos pré-instalados e clique em Done. Neste exemplo, selecionamos o modelo de pose.
Etapa 5: clique em Deploy e, quando a implantação terminar, clique em Dashboard.
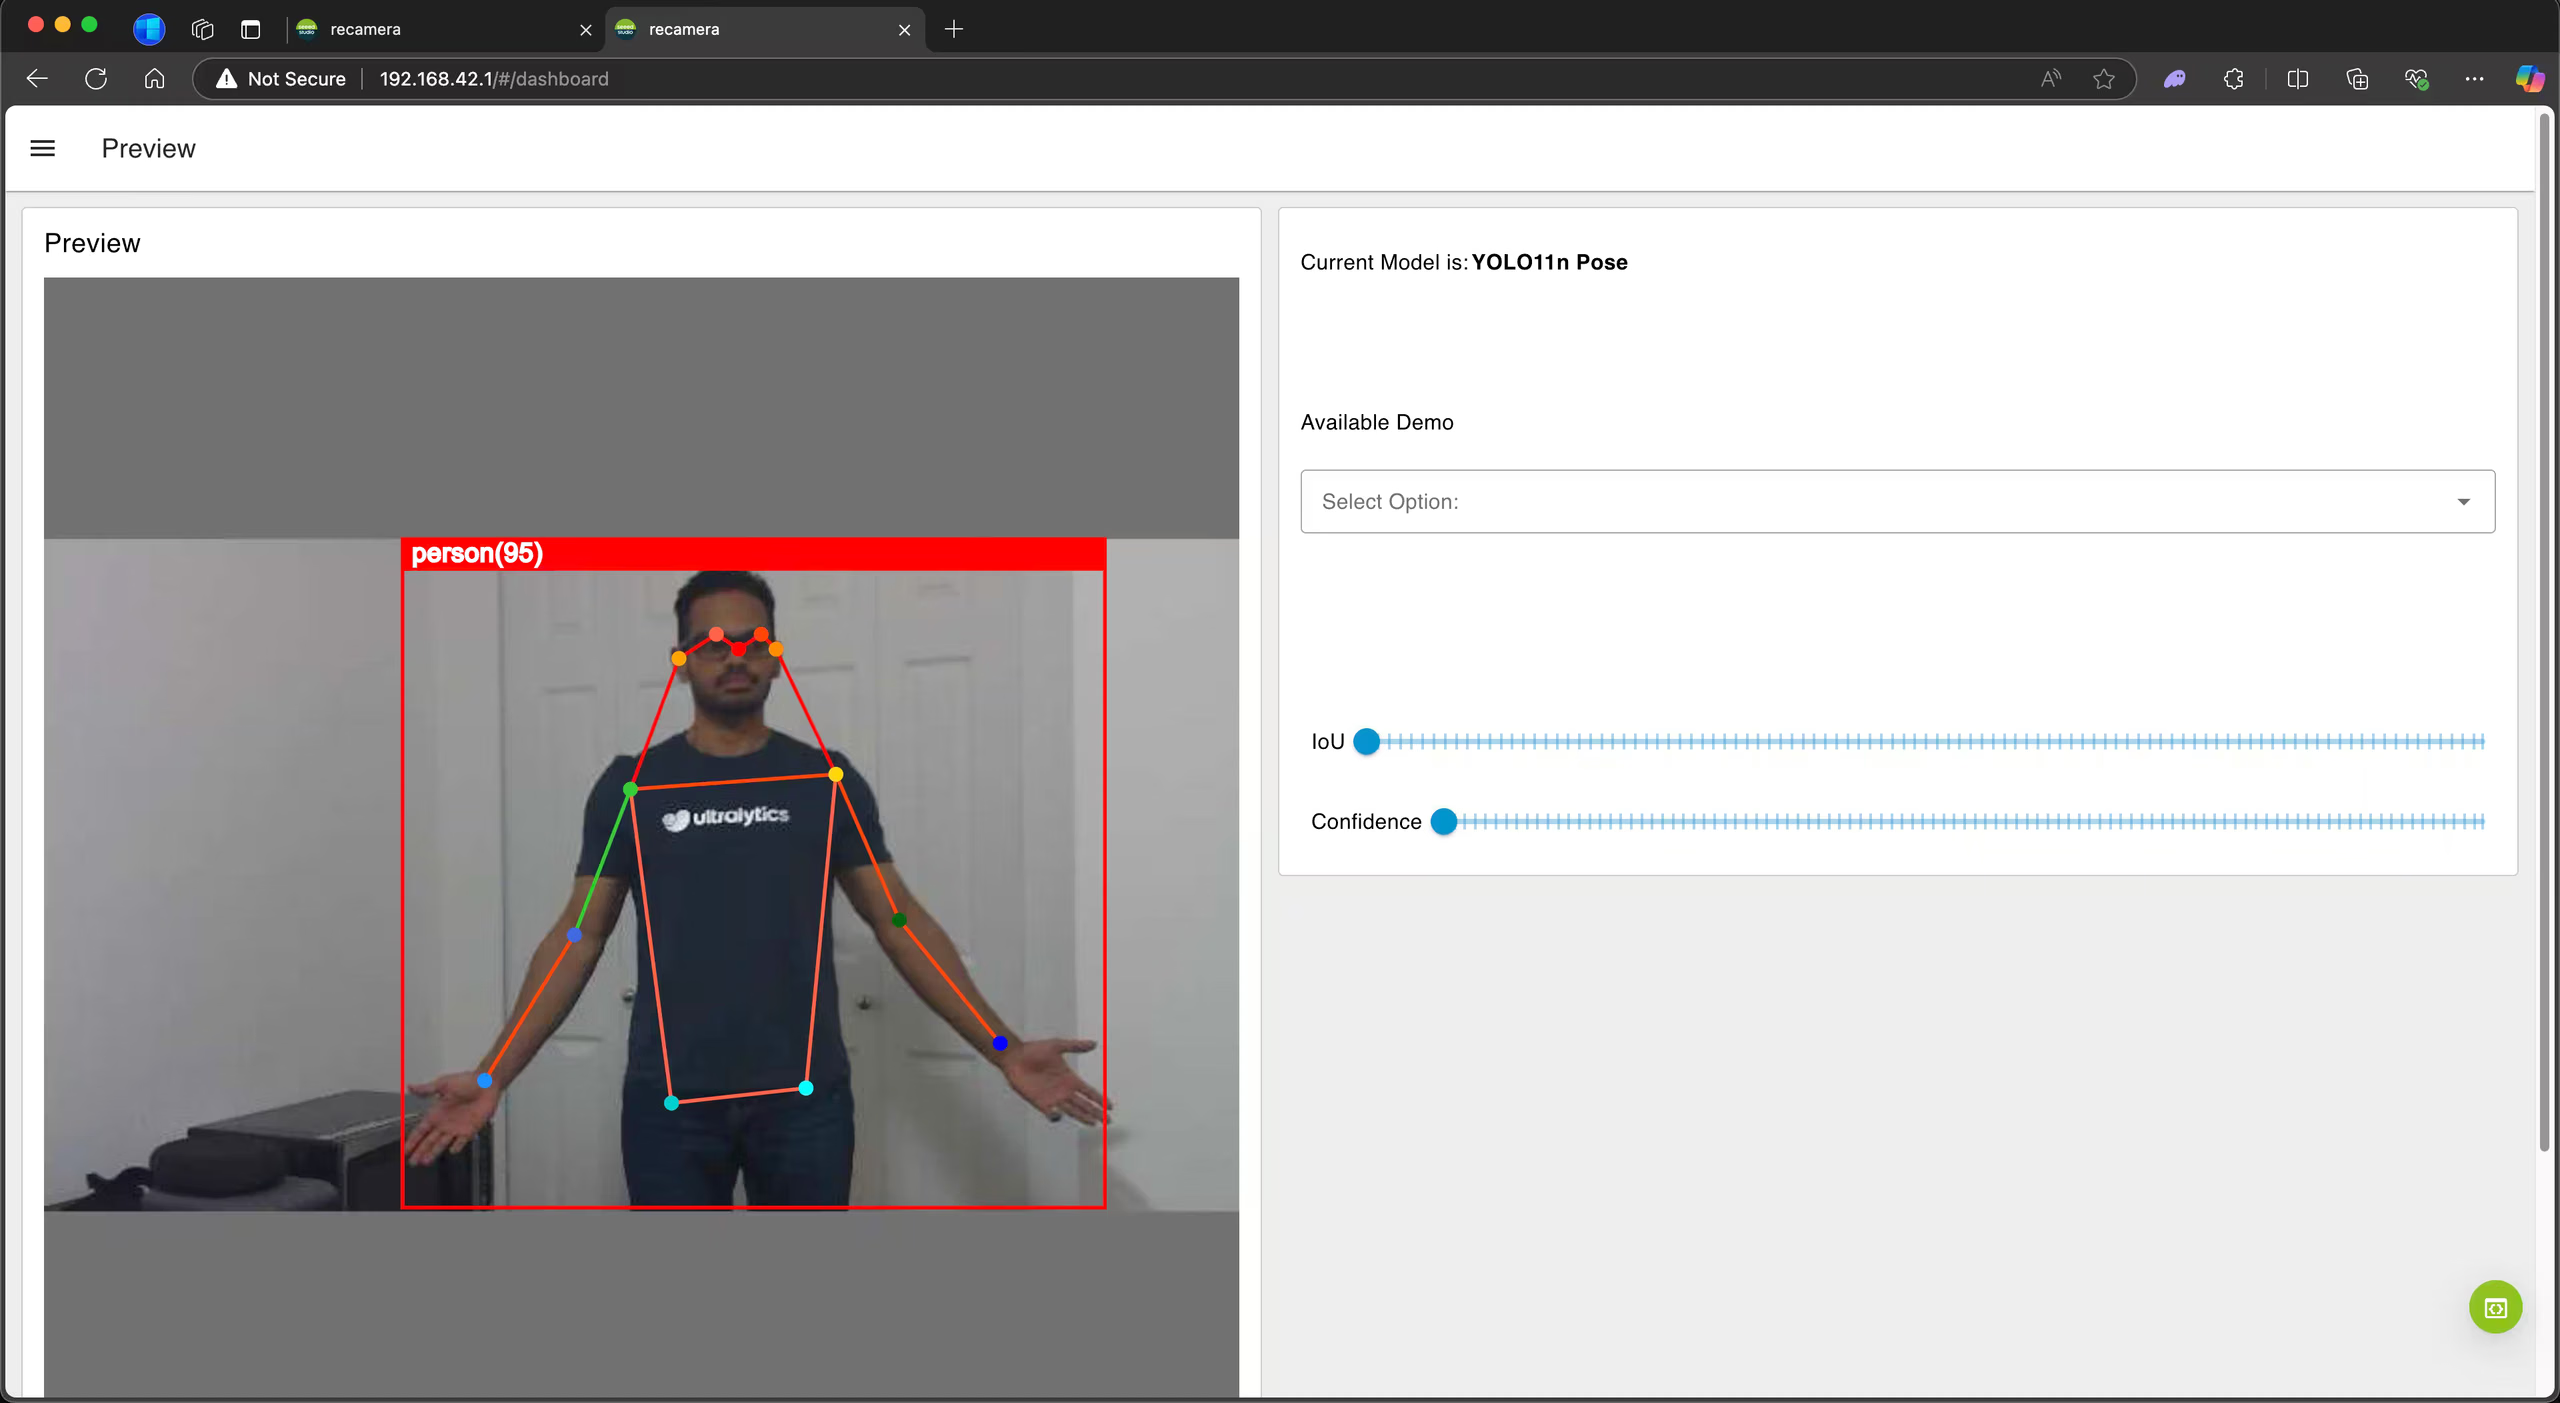
O painel agora mostra o modelo de estimativa de pose em execução no fluxo da câmera.
Exportar para cvimodel: convertendo seu modelo YOLO26#
Se quiser usar um modelo YOLO26 treinado sob medida com a reCamera, siga as etapas abaixo.
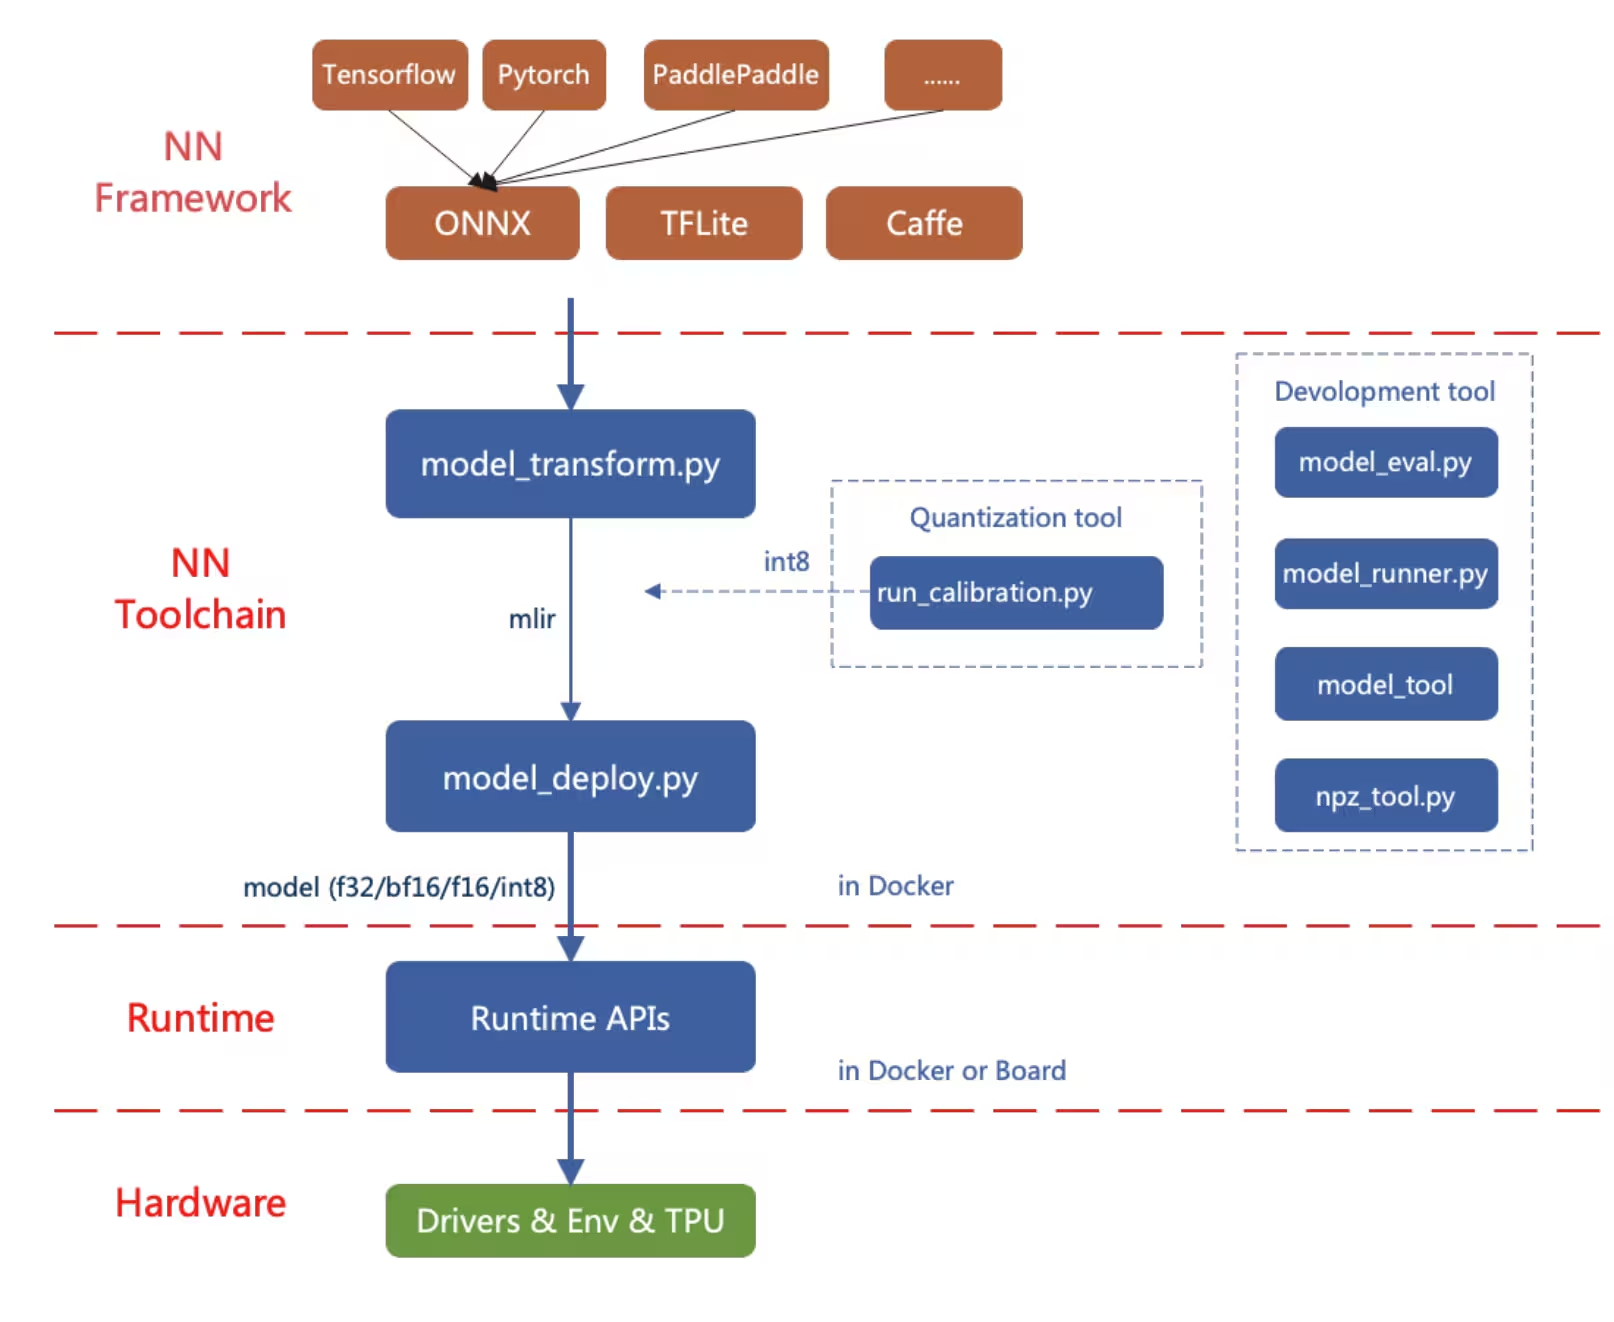
A conversão primeiro exporta um modelo PyTorch para ONNX, depois o converte para o formato de modelo MLIR e, por fim, converte MLIR para cvimodel para executar a inferência no dispositivo.
Exportar para ONNX#
Exporte um modelo Ultralytics YOLO26 para o formato de modelo ONNX.
Instalação#
Para instalar os pacotes necessários, executa:
pip install ultralyticsPara obter instruções detalhadas e boas práticas relacionadas ao processo de instalação, consulte nosso guia de instalação da Ultralytics. Se tiver dificuldades ao instalar os pacotes necessários para YOLO26, consulte nosso guia de problemas comuns para ver soluções e dicas.
Uso#
from ultralytics import YOLO

# Carrega um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta o modelo para o formato ONNX
model.export(format="onnx", opset=14)  # cria 'yolo26n.onnx'
Para mais detalhes sobre o processo de exportação, visita a página da documentação da Ultralytics sobre exportação.
Exportar ONNX para MLIR e cvimodel#
Depois de obter um modelo ONNX, consulte a página Converter e quantizar modelos de IA para converter o modelo ONNX em MLIR e, em seguida, em cvimodel.
Aplicações reais da reCamera#
A visão computacional executada no dispositivo e o design modular da reCamera tornam-na adequada para uma ampla variedade de cenários do mundo real.
-
Detecção de quedas: projetada para aplicações de segurança e saúde, a reCamera pode detectar quedas em tempo real, sendo adequada para cuidados com idosos, hospitais e ambientes industriais onde uma resposta rápida é fundamental.
-
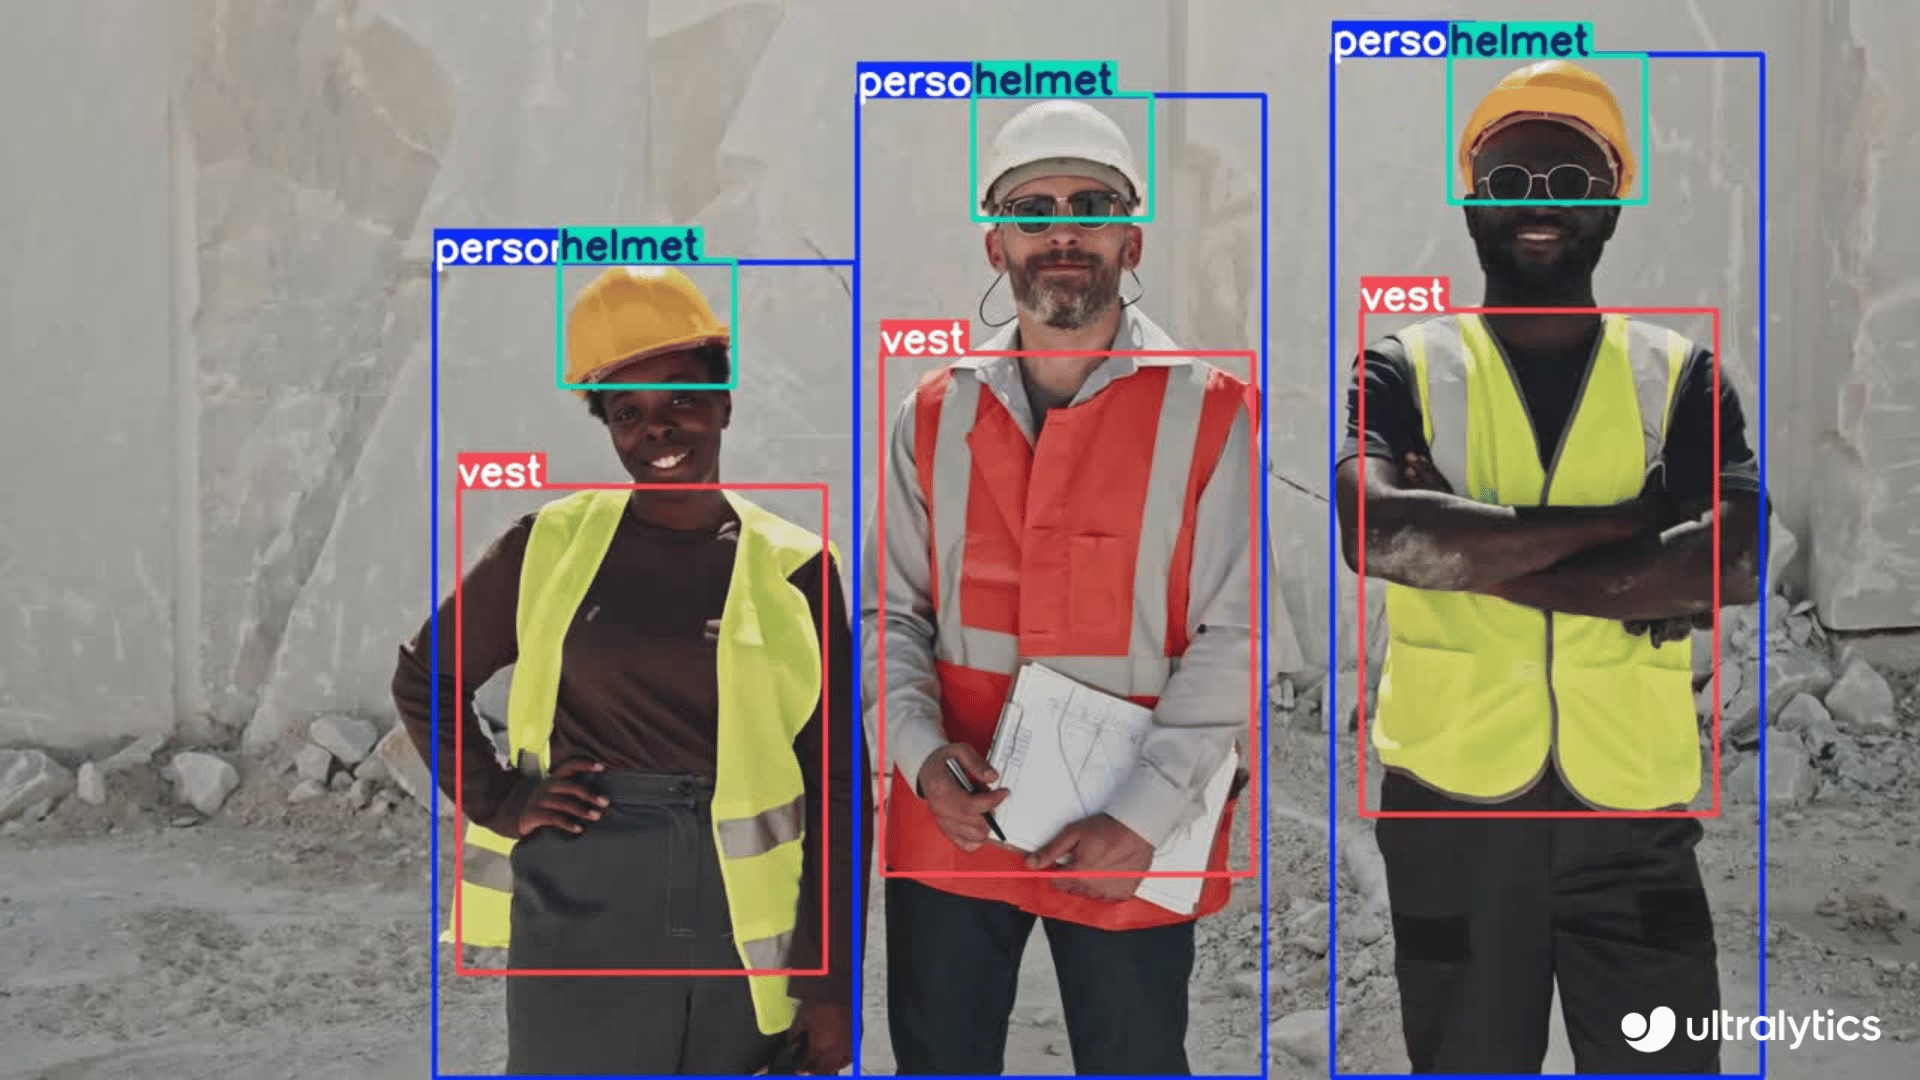
Detecção de equipamentos de proteção individual: a reCamera pode contribuir para a segurança no trabalho ao detectar o uso correto de EPI em tempo real. Ela ajuda a identificar se os trabalhadores estão usando capacetes, luvas ou outros equipamentos de segurança, reduzindo os riscos em ambientes industriais.
-
Detecção de incêndios: os recursos de processamento em tempo real da reCamera tornam-na adequada para a detecção de incêndios em áreas industriais e residenciais, fornecendo alertas antecipados para prevenir possíveis desastres.
-
Detecção de resíduos: também pode ser usada para detectar resíduos no monitoramento ambiental e na gestão de resíduos com YOLO11.
-
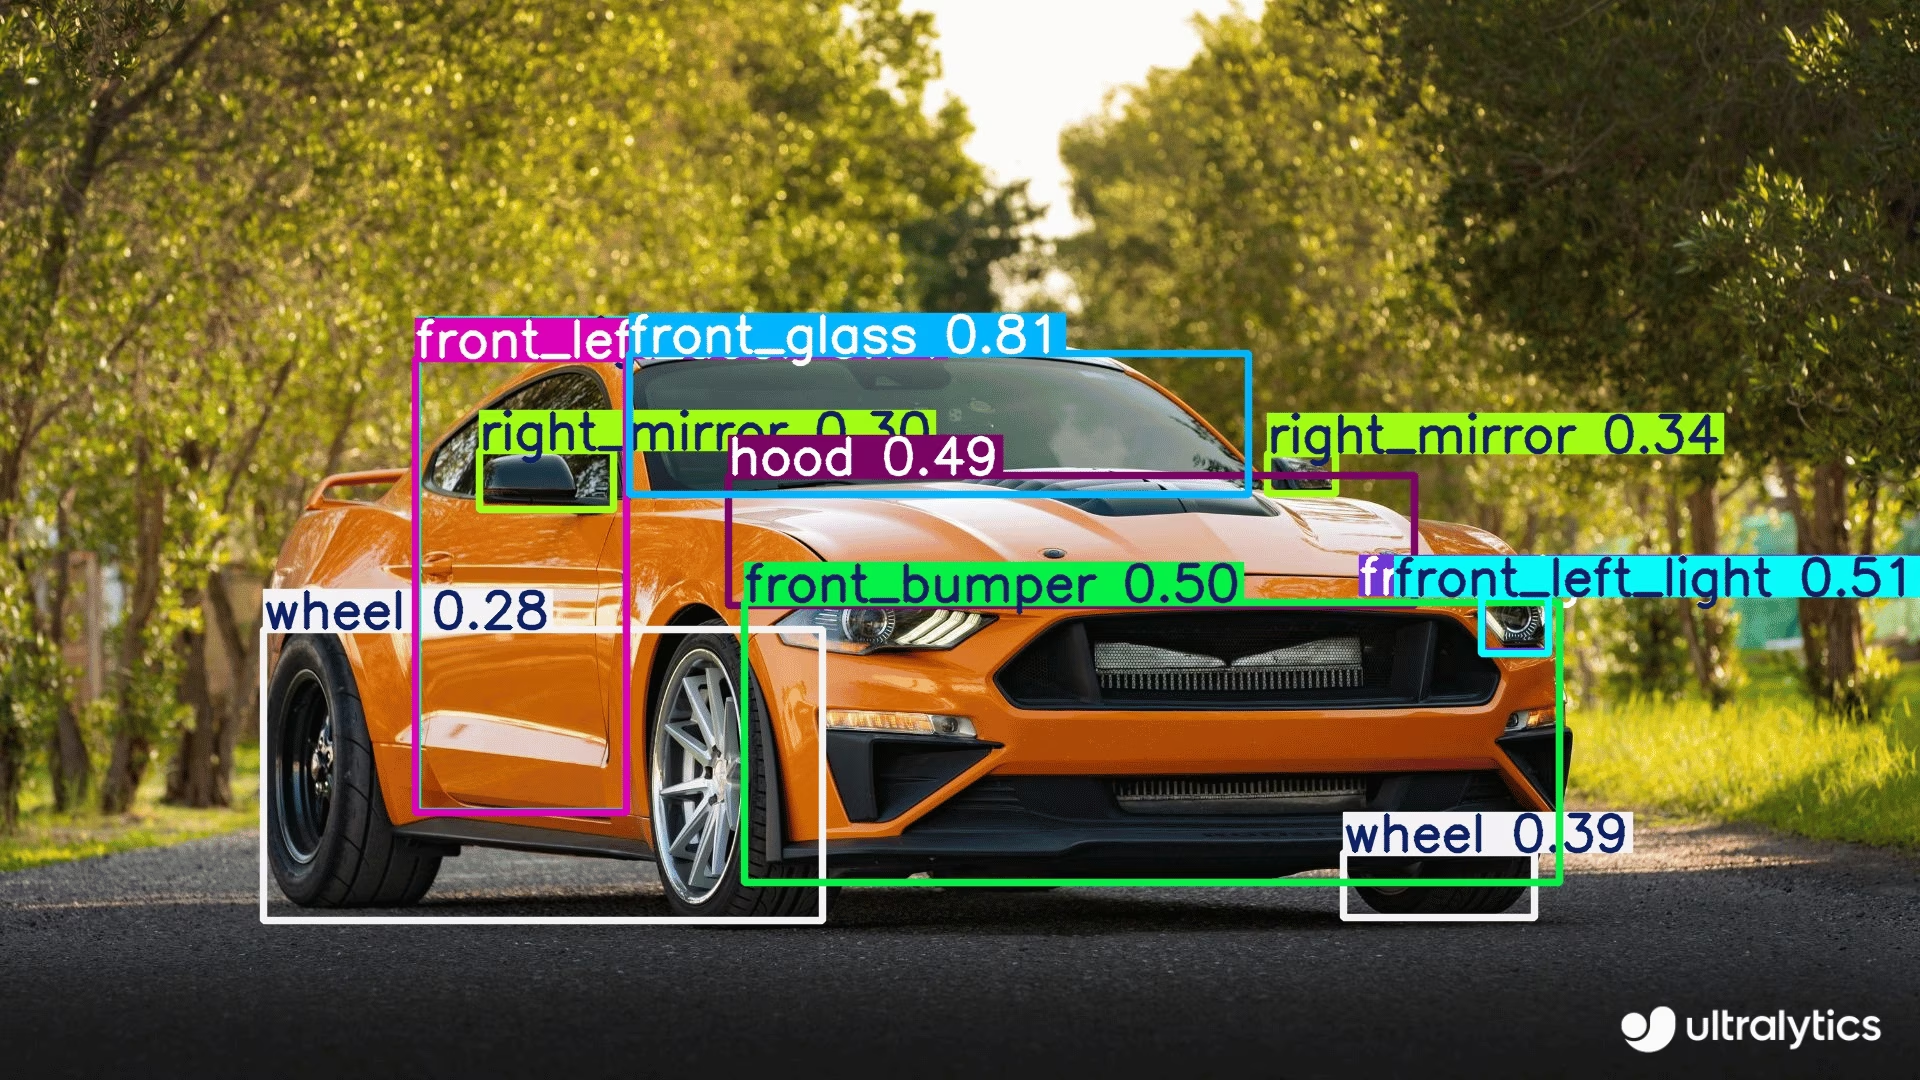
Detecção de peças automotivas: Nas indústrias de manufatura e automotiva, ela ajuda a detectar e analisar peças de veículos para controle de qualidade, monitoramento da linha de montagem e gestão de inventário.
Perguntas frequentes#
Para configurar a reCamera pela primeira vez, siga estas etapas:
- Conecte a reCamera a uma fonte de alimentação
- Conecte-a à sua rede usando a página Introdução à reCamera (selecione seu dispositivo para abrir o Guia de Início Rápido correspondente)
- Acesse a interface web do Node-RED inserindo o endereço IP do dispositivo em um navegador (ou use
192.168.42.1se estiver conectado via USB) - Começa a usar imediatamente os modelos YOLO pré-instalados pela interface do painel
Sim, você pode usar modelos YOLO26 treinados sob medida com a reCamera. O processo envolve:
- Exporte seu modelo PyTorch para o formato ONNX usando
model.export(format="onnx", opset=14) - Converta o modelo ONNX para o formato MLIR
- Converta o MLIR para o formato cvimodel para inferência no dispositivo
- Carregue o modelo convertido na reCamera
Para instruções detalhadas, consulte o guia Converter e quantizar modelos de IA.
- Exporte seu modelo PyTorch para o formato ONNX usando
Ao contrário das câmeras IP tradicionais, que exigem hardware externo para processamento, a reCamera:
- Integra o processamento de IA diretamente no dispositivo com seu processador RISC-V SG200X
- Oferece 1 TOPS de capacidade computacional para aplicações de IA de borda em tempo real
- Tem um design modular que permite atualizações e personalização dos componentes
- É compatível com tecnologias avançadas de vídeo, como compressão H.264/H.265, imagens HDR e redução de ruído 3D
- Vem com modelos Ultralytics YOLO pré-instalados, prontos para uso imediato
Esses recursos fazem da reCamera uma solução independente para aplicações de IA de borda, sem exigir hardware externo adicional para processamento.


Comentários50
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
tcpipchip
we wrote a book and trainned to yolo26 on ultralytics...i recall that works
 Glenn JocherUltralytics
Yes, a custom-trained
YOLO26model can run onreCamerausing theONNX -> MLIR -> cvimodelworkflow in the reCamera guide; if you hit a blocker, please share the exact step and full error here so the Ultralytics team can help.
HanJammer
This site mentions recamera comes with YOLO26 (which is why I bought two of them) yet YOLO11 is installed (which is visible on screenshots as well) and I can't load YOLO26 - how to do that? I can't find reliable guide :(
Ah nevermind, I think I got it, still it would be better not to advertise the camera "reCamera comes pre-installed with four Ultralytics YOLO26 models" which is basically not true.
I whipped out some 'single click' tool to convert YOLO26 onnx-es which makes it a bit easier... I need to test it a bit, for now it supports the base model. Perhaps I will push it to my github later this week.
This is fantastic.
When you finish it, i will add to the BOOK.
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
wow!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
i will test soon!
- Glenn JocherUltralytics
Thanks for sharing this; for anyone testing, the supported path today is still the reCamera integration guide together with Seeed’s model conversion guide, and we’ll review the docs wording around preinstalled models since some devices appear to ship with YOLO11 rather than YOLO26.
@glenn-jocher Have you a recamera ?
- Glenn JocherUltralytics
I don’t personally keep a reCamera on my desk, but the workflow in the Seeed Studio reCamera guide is the supported path; if you have a specific setup or export question, please drop it here and the Ultralytics team can take a look.
I tested on recamera with my trainned pose keypoint model... Same problem...no keypoint
Need to test on yolo8 on tdl sdk
- Glenn JocherUltralytics
Thanks for checking this; for custom pose models on reCamera, please drop the exact export and conversion steps here in the discussion so the Ultralytics team can take a look, since keypoints should work only after a correct
ONNX -> MLIR -> cvimodelpipeline as outlined in the reCamera guide and Seeed’s conversion guide, and it’s worth first confirming your exportedONNXmodel still produces keypoints before converting.
did you do calibration ? where the images to me to the calibration :(
- Glenn JocherUltralytics
Calibration isn’t done in the Ultralytics export step; for reCamera, you export to ONNX first with the reCamera guide, then calibration happens during Seeed’s ONNX→MLIR→
cvimodelflow using a small representative set of your own images, as described in Seeed’s Convert and Quantize AI Models guide. If you hit an error in that step, please drop the full log here and we’ll take a look.
still waiting...
send me your cvimodel too...yolo11 and yolo8
please, send me arguments used in your scripts...
did you train keypoints on animals and persons, right ?
tiruvijayakumar
NOO, i didnt train on animals, i trained on these classes for pose detection for persons using yolov11n-pose.pt weights. I fine‑tuned the YOLOv11n‑pose.pt model on my custom classes:
Running Walking Golf Skate Horse riding Kicking Diving I just uploaded animal detection model to justify that custom model deployment with quantization for object detection(yolo11n.pt) on recamera has no issues, it was another cvi model which i had no issues, it worked PERFECTLY. i only issue what i am facing is the pose detection quantized model where i am not able to see the keypoints on the inference output but bounding box is drawn along with predicted class label refer below:
now just trying to train the model for pose detection using yolov8 and then i would try quantizing the model and check if the keypoints are shown in the inference output
- Glenn JocherUltralytics
Thanks, that helps narrow it down — since detection
cvimodels work and only the quantized pose model loses keypoints, this looks more like a pose conversion or postprocessing issue in the ONNX → MLIR →cvimodelstep than a training problem. Please keep the details here so the Ultralytics team can see them, and share the exact conversion commands and full text logs from the reCamera guide and Seeed model conversion guide, plus whether the same pre-quantized ONNX shows keypoints before conversion. i ran predictions on ultralytics hub on the .pt model format, i attached the whole problem scenario and image content :https://github.com/orgs/ultralytics/discussions/22090?sort=new#discussioncomment-16346206 Any ways uploading the prediction on ultralytics hub in this thread also :
so on the model.pt file inference shows this data, this confirms that pose estimation model works. { "images": [ { "shape": [ 426, 640 ], "speed": { "preprocess": 1.41517, "inference": 130.14456, "postprocess": 0.99221 }, "results": [ { "name": "Kicking", "class": 5, "confidence": 0.80929, "box": { "x1": 0.26068, "y1": 0.10738, "x2": 0.55882, "y2": 0.85426 }, "keypoints": { "x": [ 0.41923001408576965, 0.42656999826431274, 0.4166699945926666, 0.45181000232696533, 0.42857998609542847, 0.488209992647171, 0.43380001187324524, 0.543470025062561, 0.41604000329971313, 0.5516700148582458, 0.4164600074291229, 0.46198999881744385, 0.4427199959754944, 0.357340008020401, 0.427839994430542, 0.29197001457214355, 0.43891000747680664 ], "y": [ 0.2315099984407425, 0.21907000243663788, 0.21740999817848206, 0.21602000296115875, 0.21322999894618988, 0.2783600091934204, 0.2824600040912628, 0.3255299925804138, 0.35097000002861023, 0.32879000902175903, 0.3619599938392639, 0.5179499983787537, 0.5104399919509888, 0.6517800092697144, 0.6389099955558777, 0.7586100101470947, 0.7324900031089783 ], "visible": [ 0.9994300007820129, 0.9990299940109253, 0.9990000128746033, 0.999019980430603, 0.9988300204277039, 0.9995700120925903, 0.9996600151062012, 0.998960018157959, 0.9992700219154358, 0.9985499978065491, 0.997439980506897, 0.9995700120925903, 0.9995700120925903, 0.9988800287246704, 0.9989299774169922, 0.982990026473999, 0.9852499961853027 ] } } ] } ], "metadata": { "imageCount": 1, "functionTimeAlive": 78321.917, "functionTimeCall": 0.138, "model": "best.pt", "version": { "ultralytics": "8.4.30", "torch": "2.11.0+cpu", "torchvision": "0.26.0+cpu", "python": "3.14.3" } }, "networkTime": 1.214 }
I didnt capture the conversion commands and text logs during the onnx->mlir->cvimodel, would repeat the same steps and paste the images in this thread itself.
Exported the yolov11n-pose.pt(finetuned) on google colab to onnx format
Uploaded the model on netron to view the structure, onnx is in the format IRv9 ,opset v20(would downgrade it). Classes are running, walking, golf-swing, skateboarding, riding-horse and kicking
Seeed studio guide for downgrading
Initial structure of workspace folder
Step1: pull sopho/tpuc_dev:v3.1
Step2: starting the container
Step3: installing onnx
Step4: Clone Downgrade Script
Step5: Downgrade Script settings IR v8 and Opset v17
Step6: Install TPU-MLIR tools inside container:
Step7: clone tpu-mlir
Step8: setup environment tpu-mlir(long step)
Step9: according to seeed studio guide, i have to include outputs before the model's head as the parameter for this particular step model_transform
--model_name yolo11n
--model_def yolo11n.onnx
--input_shapes "[[1,3,640,640]]"
--mean "0.0,0.0,0.0"
--scale "0.0039216,0.0039216,0.0039216"
--keep_aspect_ratio
--pixel_format rgb
--output_names "/model.23/cv2.0/cv2.0.2/Conv_output_0,/model.23/cv3.0/cv3.0.2/Conv_output_0,/model.23/cv2.1/cv2.1.2/Conv_output_0,/model.23/cv3.1/cv3.1.2/Conv_output_0,/model.23/cv2.2/cv2.2.2/Conv_output_0,/model.23/cv3.2/cv3.2.2/Conv_output_0"
--test_input ../image/dog.jpg
--test_result yolo11n_top_outputs.npz
--mlir yolo11n.mlir i have the onnx file, could someone of the team help me identify the outputs before the model's head? @glenn-jocher here is the onnx file https://drive.google.com/file/d/1UF25DK2zXx0GCWdcx55SPYHL71SylDeg/view?usp=sharing
and some animal pictures...