YOLOE: deteção e segmentação em tempo real com vocabulário aberto
Ultralytics YOLOE (enxergando tudo em tempo real) é um modelo de detecção de vocabulário aberto e segmentação de instâncias: em vez de usar uma lista de classes fixa no treinamento, ele recebe as categorias desejadas no momento da inferência, como uma solicitação de texto, um exemplo visual ou um vocabulário integrado com 4.585 nomes. Baseado nas arquiteturas YOLO da Ultralytics — YOLOv8, YOLO11 e YOLO26 — e inspirado no YOLO-World, YOLOE alcança alta precisão em zero-shot com velocidade próxima à do YOLO de conjunto fechado.
Assista: Como usar Ultralytics YOLOE-26 (novo) | Vocabulário aberto e visão de tudo em tempo real
Início rápido#
Informe as classes desejadas e execute o modelo. YOLOE-26 retorna caixas e máscaras de segmentação de instâncias para categorias com as quais nunca foi treinado.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# "double-decker bus" não é uma classe COCO; o YOLOE identifica-a apenas pelas palavras
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
A primeira chamada set_classes() transfere um codificador de texto; consulta Instalação e requisitos antes de implementares o sistema numa máquina sem acesso à rede.
Escolher um modo de prompting#
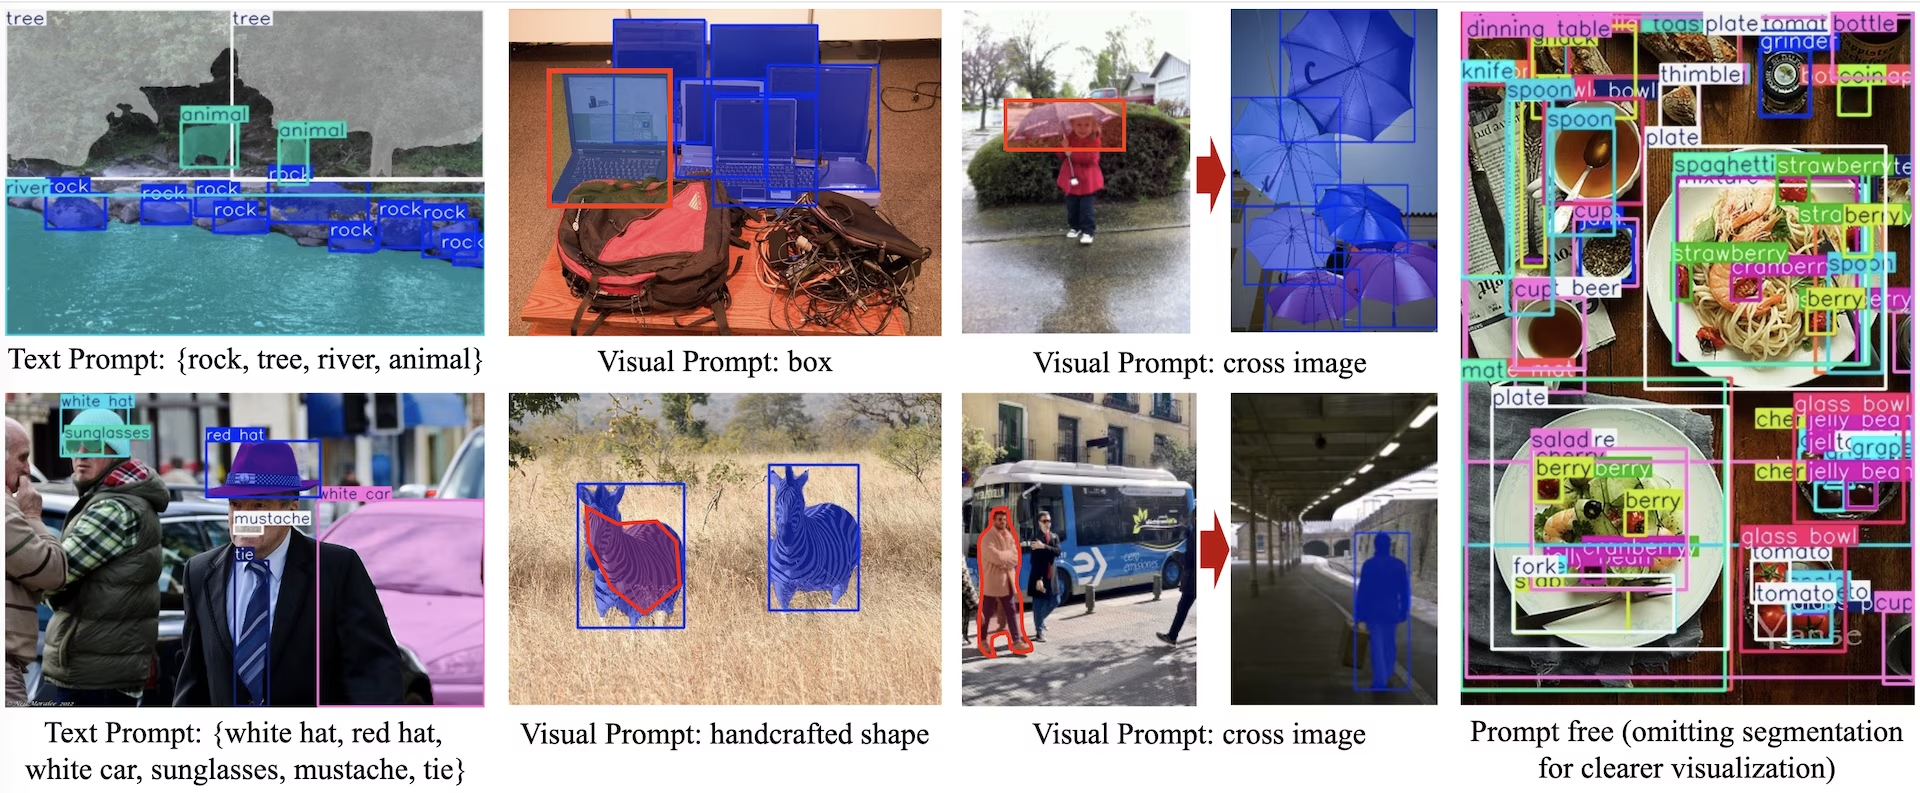
O YOLOE suporta três modos de prompting. A escolha determina qual checkpoint carregas e o aspeto das etiquetas das classes. Escolhe a linha correspondente ao que podes fornecer no momento da inferência.
| Modo | Checkpoint | O que forneces | Nomes das classes nos resultados | Quando usar |
|---|---|---|---|---|
| Prompt de texto | *-seg.pt | Nomes de classes como strings | Exatamente os nomes que forneceste | Podes descrever o alvo por palavras — a opção habitual |
| Prompt visual | *-seg.pt | Caixas de exemplo numa imagem de referência | Genéricos object0, object1, … | Não consegues descrever o alvo por palavras: uma peça específica, um logótipo ou um defeito |
| Sem prompt | *-seg-pf.pt | Nada | Nomes do vocabulário integrado com 4 585 nomes | Estás a catalogar ou a explorar e não sabes antecipadamente o que procurar |
- Os prompts visuais não incluem as tuas etiquetas. Os IDs de classe em
visual_promptsagrupam os exemplos; o modelo devolve-os comoobject0,object1e assim por diante. Tens de os associar manualmente aos teus próprios nomes. - Os checkpoints sem prompt rejeitam
set_classes(). Chamá-lo num modelo*-seg-pf.ptgeraAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Carrega um checkpoint*-seg.ptquando precisares das tuas próprias classes.
Instalação e requisitos#
O YOLOE está incluído no pacote principal da Ultralytics:
pip install -U ultralyticsAlém disso, o prompting por texto precisa de um codificador de texto, que é transferido na primeira utilização, e não durante a instalação:
- A primeira chamada
set_classes()instala ultralytics/CLIP do GitHub compip(que fornece o tokenizador) e transfere um codificador de texto TorchScript para o diretório de trabalho atual. O YOLOE-26 obtémmobileclip2_b.ts, com cerca de 254 MB; o YOLOE-11 e o YOLOE-v8 obtêmmobileclip_blt.ts. Executa a transferência uma vez a partir do diretório onde vais executar o sistema ou copia o ficheiro para lá; caso contrário, será transferido novamente. - Ambas as etapas precisam de acesso à rede. Por isso, executa uma previsão com prompt antes de implementar o sistema numa máquina offline ou isolada da rede.
- Os prompts visuais e os checkpoints sem prompt não precisam de nenhum codificador de texto.
Os checkpoints YOLOE-26 exigem ultralytics 8.4.0 ou posterior; as famílias YOLOE-11 e YOLOE-v8 estão disponíveis em versões anteriores. Uma previsão com prompt de texto testa todo o processo — transferência do checkpoint, instalação do CLIP, codificador de texto e inferência:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Para evitar por completo a transferência do codificador de texto no momento da inferência, incorpora os prompts nos pesos uma vez e reutiliza-os — consulta Reutilizar embeddings de prompts.
Visão geral da arquitetura#

O YOLOE mantém a estrutura YOLO padrão — um backbone convolucional para extração de características, um neck para fusão em várias escalas e uma head desacoplada sem âncoras que prevê classes e caixas — e acrescenta três módulos, um para cada modo de prompting:
- Alinhamento região-texto reparametrizável (RepRTA) refina os embeddings de texto do CLIP por meio de uma pequena rede auxiliar. Essa rede é executada uma vez por chamada de
set_classes()e é incorporada ao modelo na exportação, portanto não gera custo por quadro. O que é executado em cada passagem direta é a comparação dos embeddings de solicitações armazenados com os recursos das regiões; consulte Limitações para saber o custo de usar um conjunto grande de solicitações. - O Codificador de Prompt Visual Ativado por Semântica (SAVPE) codifica características semânticas e de ativação a partir de uma caixa de exemplo, condicionando o modelo a objetos com aspeto semelhante. Este é o caminho de disparo único para alvos difíceis de nomear, como um logótipo ou uma peça específica.
- O Contraste Preguiçoso entre Região e Prompt (LRPC) compara embeddings de regiões com um vocabulário integrado com 4 585 nomes, permitindo que os checkpoints sem prompt reconheçam objetos sem prompt externo nem codificador de texto.
A segmentação de instâncias é feita por um ramo de máscaras na cabeça de detecção, como no YOLOv8-Seg, e cada previsão inclui uma máscara em results[0].masks. Depois que o modelo é exportado, os módulos de mundo aberto são reparametrizados em uma cabeça YOLO padrão, de modo que o arquivo exportado executa o fluxo comum de detecção/segmentação.
Modelos disponíveis#
Cada checkpoint abaixo é um modelo de segmentação de instâncias e oferece suporte a val, predict, export e track. Carregue um arquivo *-seg.pt para solicitações de texto ou visuais e um arquivo *-seg-pf.pt para inferência sem solicitações; eles não são intercambiáveis. Consulte Escolher um modo de solicitação. Somente os arquivos *-seg.pt oferecem suporte a train; um checkpoint sem solicitações é produzido a partir de um modelo treinado com solicitações de texto. Consulte Treinar os modelos oficiais do zero.
| Modelo | Prompt de texto/visual | Sem prompt |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
Desempenho do YOLOE no LVIS#
Resultados zero-shot no minival do LVIS a 640 píxeis, retirados do artigo do Ultralytics YOLO26.
Prompts de texto e visuais#
Cada célula de precisão e parâmetros apresenta prompt de texto / prompt visual; os FLOPs são indicados uma única vez. Os parâmetros e FLOPs correspondem à configuração de deteção avaliada no artigo. A precisão é o valor Non-E2E do artigo, o único protocolo reportado para todos os modelos da comparação; a head end-to-end do YOLOE-26 fica, no máximo, 1,1 AP abaixo com prompts de texto e 2,6 AP abaixo com prompts visuais.
| Modelo | mAP50-95 | mAPr | mAPc | mAPf | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
Sem prompt#
Os checkpoints sem prompt respondem usando o vocabulário integrado, sem receber qualquer prompt. Cada célula de precisão apresenta end-to-end / Non-E2E, os dois protocolos em que o artigo avalia o YOLOE-26; a página do YOLO26 apresenta a coluna Non-E2E.
| Modelo | mAP50-95 | mAPr | mAPc | mAPf | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
Com prompts de texto e visuais, os modelos YOLOE-26 superam seus equivalentes YOLOE-11 e YOLOE-v8 em todas as escalas correspondentes no mAP50-95, mantendo-se abaixo da linha v8 em número de parâmetros e FLOPs. Na mesma divisão, o artigo relata 24.4 (S), 32.4 (M) e 35.5 (L) para o YOLO-Worldv2, e 26.0 para o GLIP-T, 27.4 para o GDINO-T e 34.4 para o DetCLIP-T, detectores baseados em Transformer, cada um com 155 a 232 M de parâmetros. O artigo original do YOLOE acrescenta dois resultados para os modelos na escala v8 que apresentou. No LVIS, o YOLOE-v8s supera o YOLO-Worldv2-S em 3.5 AP, com um terço do custo de treinamento e velocidade de inferência 1.4× maior. Transferido para o COCO, o YOLOE-v8l ganha 0.6 box AP e 0.4 mask AP em relação ao YOLOv8-L de conjunto fechado, com quase 4× menos tempo de treinamento.
O artigo do YOLO26 avalia uma configuração de detecção. Os pesos lançados são checkpoints de segmentação e incluem um ramo de máscara, SAVPE e a projeção de texto, por isso um yoloe-26l-seg.pt carregado informa 35.4 M e 142.0 B em vez dos 25.5 M e 89.0 B acima. Em ambos os casos, o valor de FLOPs exclui a similaridade entre região e texto, então o custo real aumenta com o tamanho do conjunto de prompts, embora o valor da coluna não mude; consulte Limitações.
Exemplos de uso#
Todos os exemplos de YOLOE abaixo são executados pela API Python. A previsão com prompt de texto, a validação, a exportação, o rastreamento e o treinamento simples também funcionam pela CLI; as receitas de ajuste fino passam uma classe de trainer, e o prompting visual passa arrays de prompts NumPy, que só são aceitos pela API Python.
Utilização no treino#
Faz ajuste fino de qualquer checkpoint *-seg.pt lançado usando o teu próprio conjunto de dados YOLO. Este processo segue, em grande parte, o procedimento padrão de treinamento YOLO; a diferença está no treinador que passas. YOLOEPESegTrainer integra os nomes das tuas classes na cabeça do modelo e faz o ajuste fino a partir daí, que é o que queres para os teus próprios rótulos; o treinador padrão não treina usando os nomes das tuas classes. O checkpoint resultante prevê diretamente as classes do teu conjunto de dados: a cabeça já não lê prompts, por isso set_classes() gera um erro se as classes mudarem, e o mesmo acontece com os prompts visuais. Usa o checkpoint original para solicitar outras classes.
Assista: Como treinar YOLOE no conjunto de dados de segmentação de peças automotivas | Modelo de vocabulário aberto, previsão e exportação
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Importante: o trainer de ajuste fino, não o padrão
)Todos os checkpoints lançados são modelos de segmentação. Para treinar um detector, crie o modelo a partir do YAML correspondente, carregue os pesos de segmentação da mesma escala e substitua pelo trainer de detecção. Todo o resto permanece igual.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Uso de predição#
A chamada com prompt de texto é a apresentada no Início rápido. O prompting visual adiciona um argumento visual_prompts, e a previsão sem prompts carrega um checkpoint -pf:
Os prompts visuais mostram ao modelo um exemplo, em vez de descrevê-lo. visual_prompts recebe um array bboxes de caixas de exemplo e um array cls de IDs de classe, um por caixa. Os IDs são agrupamentos temporários, não rótulos — precisam ser sequenciais a partir de 0, e os resultados são retornados como object0, object1, …, e não com os nomes que você escolher.
As caixas de exemplo podem estar na imagem em que você está fazendo a predição:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# Uma caixa de exemplo por alvo, cada uma com seu próprio ID de classe
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # pessoa, óculos
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
Ou em uma imagem de referência separada, passada como refer_image; nesse caso, bboxes e cls descrevem objetos nessa referência, não no alvo:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Imagem-alvo
    refer_image="ultralytics/assets/bus.jpg",  # Onde ficam as caixas de exemplo
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image também define as classes permanentemente, então as chamadas seguintes não precisam de prompts
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # E a exportação as mantémQuando source é um vídeo ou stream, o primeiro quadro se torna automaticamente o refer_image, então os prompts que você passa são aplicados a esse quadro e mantidos ao longo do restante do vídeo. Passe refer_image explicitamente para escolher outro quadro.
Tanto source quanto refer_image aceitam diretamente tensores torch, o que é útil quando as imagens já vêm de um pipeline existente. Informe as caixas nas próprias coordenadas de pixel do tensor:
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # tensor float (1, 3, H, W) em [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Para fazer predições em várias imagens de uma vez, aninhe os prompts em mais um nível: um array bboxes e um array cls para cada imagem de origem, na mesma ordem das imagens de origem.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: pessoa, óculos
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: pessoa
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Uso de validação#
A validação é executada como em qualquer outro modelo, usando um conjunto de dados de segmentação:
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # ou yoloe-26s/m-seg.pt para outros tamanhos

metrics = model.val(data="coco128-seg.yaml")
data também pode ser um arquivo NDJSON ou um URI de conjunto de dados da Platform ul://; ele é convertido para o formato YOLO antes de os prompts de texto ou visuais serem criados.
Duas variantes da mesma chamada abrangem os outros modos de prompting:
- Prompts visuais —
model.val(data="coco128-seg.yaml", load_vp=True)extrai do próprio conjunto de dados um embedding visual por categoria. Adicionerefer_data="coco.yaml"para obter os embeddings de outro conjunto de dados, que precisa conter exatamente as mesmas categorias. - Sem prompt — carregue um checkpoint
*-seg-pf.pte passesingle_cls=True.
Uso da exportação#
Os embeddings de prompt podem ser salvos uma vez e reutilizados ao gerar exportações estáticas como ONNX, OpenVINO, TensorRT, CoreML, LiteRT e RKNN. O perfil NPZ é carregado pelo modelo original PyTorch antes da exportação; não é uma entrada adicional em tempo de execução, e o modelo exportado não precisa do arquivo NPZ.
As classes configuradas com set_classes() (ou por meio de refer_image para prompts visuais) são incorporadas aos pesos exportados. Após a exportação, o modelo não pode mais aceitar novos prompts: chamar set_classes() ou passar visual_prompts=... para predict() em uma exportação carregada causará um erro. Para alterar as classes detectadas, exporte novamente a partir do checkpoint original .pt com os novos prompts configurados. O arquivo exportado funciona como um modelo YOLO padrão e também pode ser carregado com YOLO() em vez de YOLOE().
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# O perfil está vinculado ao checkpoint de origem e pode ser reutilizado em exportações posteriores.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
O mesmo perfil de prompt também pode configurar um modelo apenas de detecção, criado a partir da arquitetura YOLOE correspondente. Isso remove o ramo de máscara, mantendo as classes solicitadas por prompt:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
Uso do rastreamento#
As classes solicitadas por prompt são transferidas diretamente para o rastreamento, para que você possa acompanhar objetos para os quais o tracker nunca foi treinado:
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True mantém os IDs de rastreamento estáveis entre os quadros
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
Comparação do YOLOE#
O YOLOE fica entre um detector de conjunto fechado e um modelo de vocabulário aberto mais pesado. Três comparações ajudam a decidir se é a escolha certa:
- Em comparação com um YOLO de conjunto fechado. Depois de definir os prompts, o YOLOE faz predições pelo fluxo comum de detecção/segmentação e é exportado como qualquer outro modelo. O que ele acrescenta é a capacidade de alterar a lista de classes no momento da inferência, sem retreinar; o custo é uma precisão zero-shot muito inferior à de um modelo treinado com suas próprias classes.
- Em comparação com as famílias YOLOE anteriores. O YOLOE-26 herda a cabeça end-to-end sem NMS do YOLO26 e abrange cinco escalas (n/s/m/l/x), em comparação com as três anteriores (s/m/l), além de liderar em todas as escalas correspondentes em Desempenho.
- Em comparação com detectores de vocabulário aberto baseados em Transformer. O GLIP e o OWL-ViT executam um Transformer de visão e linguagem durante a inferência. O YOLOE codifica os prompts uma vez e depois os compara com os recursos das regiões dentro de uma cabeça convolucional.
As alternativas mais próximas aceitam todas um prompt de texto, mas apenas o YOLOE e o SAM 3 retornam máscaras, e os três respondem a perguntas diferentes:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Criado para | Detecção e segmentação em tempo real de classes nomeadas | Segmentação de conceitos e rastreamento com prompts | Detecção de vocabulário aberto em tempo real |
| Máscaras | Sim, com os checkpoints *-seg.pt | Sim | Não, apenas caixas |
| Prompts visuais | Sim (SAVPE) | Sim | Não |
| Modo sem prompt | Sim, vocabulário de 4,585 nomes | Não | Não |
| Escolha quando | Você precisa de alto rendimento e consegue nomear as classes | Você precisa da segmentação de conceitos mais robusta e pode usar mais recursos computacionais | Você já usa essa opção — consulte a nota de migração abaixo |
Vindo do YOLO-World? A API tem o mesmo formato: substitua YOLOWorld por YOLOE, carregue um checkpoint *-seg.pt e mantenha sua chamada set_classes() como está. Você ganha máscaras e prompts visuais; a nota sobre exportação referente às classes congeladas se aplica a ambos.
Casos de uso e aplicações#
A detecção de vocabulário aberto elimina a etapa de retreinamento por classe, o que é especialmente importante quando a lista de alvos não é conhecida de antemão:
- Detecção em ambientes abertos — robótica e sistemas de segurança que encontram objetos não enumerados durante o treinamento.
- Detecção one-shot a partir de um exemplo — os prompts visuais identificam uma peça, um logotipo ou um defeito específico usando uma única caixa de referência, algo útil na inspeção industrial.
- Catalogação de cauda longa — o vocabulário integrado de 4,585 nomes é amplo o bastante para levantamentos de monitoramento da biodiversidade ou de estoque no varejo.
- Inicialização de conjuntos de dados — faça a pré-rotulagem de imagens com caixas e máscaras antes da revisão humana e, em seguida, treine um modelo rápido de conjunto fechado com os resultados.
- Segmentação de alvos arbitrários — os checkpoints
*-seg.ptlançados retornam uma máscara para cada predição, então a imagiologia médica e a análise de imagens de satélite obtêm resultados precisos ao nível do pixel sem precisar de um segundo modelo.
Um padrão comum combina dois modos: execute uma vez sem prompt para descobrir o que está presente e, em seguida, use prompts de texto para as categorias relevantes.
Limitações#
O YOLOE troca precisão pela capacidade de alterar classes no momento da inferência. Estas são as consequências que você deve conhecer antes de adotá-lo:
- A precisão zero-shot é muito inferior à de um modelo treinado com suas classes. Os checkpoints com prompts ficam aproximadamente na faixa de 22-40 mAP no LVIS minival; um YOLO de conjunto fechado treinado com seus próprios dados terá melhor desempenho nessas classes. Use o YOLOE para abranger classes para as quais você não pode treinar, não para substituir o treinamento.
- Categorias raras são o ponto fraco. A coluna mAPr em Desempenho informa a precisão especificamente nas classes raras do LVIS e, com prompts de texto, fica abaixo das colunas de classes comuns e frequentes em todas as linhas. Confira esse valor, não apenas o mAP principal, quando seus alvos forem incomuns.
- Um prompt descreve a aparência, não as relações. A detecção funciona comparando os recursos das regiões com o embedding do prompt, então prompts que dependem de estado, contexto ou comparação — "danificado", "o mais à esquerda", "o que está sendo carregado" — não oferecem um critério confiável para correspondência. Prefira termos próximos aos nomes de categorias usados no dia a dia.
- Conjuntos grandes de prompts aumentam a latência. Os embeddings de prompt são calculados uma vez, mas são comparados com os recursos das regiões em cada passagem forward. Medida na CPU com
yoloe-26s-seg.pt, uma passagem forward aumenta cerca de 19% ao passar de 80 para 1,203 classes e cerca de 89% com o vocabulário completo de 4,585 nomes. Os FLOPs informados não mudam, pois a similaridade entre região e texto não é contabilizada, então o perfil não vai alertar você. - Os nomes das classes são provisórios até você definir os prompts. Um checkpoint
*-seg.ptrecém-carregado informanc=80com nomes numéricos ("0","1", …), então chameset_classes()antes de ler os rótulos. Os checkpoints sem prompt já vêm com o vocabulário completo.
Notas de implantação#
- Hardware. A inferência precisa de uma GPU NVIDIA com 4-8 GB de VRAM; as escalas
nesfuncionam em GPUs de borda como Jetson ou na CPU com resolução reduzida. O ajuste fino precisa de uma única GPU. - Por padrão, o NMS não considera as classes. O YOLOE faz predições com
agnostic_nms=True. Por padrão, isso suprime caixas sobrepostas com pontuação menor entre classes diferentes, em vez de apenas dentro da mesma classe, evitando duplicatas quando um objeto corresponde a várias categorias. Comnms=False, o YOLOE-26 não aplica supressão por IoU; o modo independente de classe mantém apenas a melhor classe por âncora, em vez de permitir que uma âncora emita vários rótulos de classe. Passeagnostic_nms=Falsepara substituir esse comportamento. - Os prompts visuais usam
conf=0.05por padrão. As caixas dos prompts visuais estão corretas com mais frequência do que suas pontuações sugerem: no LVIS minival, usando uma instância de uma classe como prompt,conf=0.25deixa de detectar 44 a 55% das outras instâncias que YOLOE-26 encontra emconf=0.05. Cenas densas com objetos quase idênticos, como prateleiras de lojas ou células, podem precisar de valores mais baixos e, comnms=False, a pontuação da cabeça um para um do YOLOE-26 é ainda mais baixa, com seu melhor limiar perto de0.01. Todas as outras chamadas mantêmconf=0.25, incluindo chamadas posteriores, embeddings salvos e exportações que reutilizam classes definidas porrefer_image. Passeconfpara substituir esse valor. - Processamento em lote. A inferência em lote funciona diretamente, e os prompts visuais podem ser diferentes para cada imagem na mesma chamada.
Treinar os modelos oficiais do zero#
A maioria das pessoas não precisa fazer isso. Esse processo reproduz os checkpoints de vocabulário aberto publicados a partir do Objects365, GQA e Flickr30k — cerca de 1.4 M de amostras de treinamento em 8× RTX 4090 — e não tem relação com o ajuste fino nos seus próprios dados, abordado acima em Uso do treinamento.
Todos os trainers que herdam YOLOETrainer recusam compile=True, incluindo o YOLOESegTrainer padrão e todos os trainers de treinamento do zero abaixo. Passe compile=False (o padrão). Os dois trainers de ajuste fino usados acima, YOLOEPESegTrainer e YOLOEPETrainer, não têm essa restrição.
O treinamento precisa de anotações de segmentos. Você pode baixar os arquivos processados abaixo ou gerar os seus com o script fornecido pela equipe oficial, baseado no SAM 2.1. A validação usa o LVIS minival.
| Conjunto de dados | Tipo | Amostras | Caixas | Anotações de segmentos processadas |
|---|---|---|---|---|
| Objects365v1 | Deteção | 609k | 9621k | objects365_train_segm.json |
| GQA | Aterramento | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Aterramento | 149k | 641k | final_flickr_separateGT_train_segm.json |
O modelo com prompt de texto é treinado primeiro, e os outros dois modos de prompting são refinamentos dele:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # ou o caminho para um arquivo YAML com a mesma estrutura
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
Os checkpoints de prompt visual e sem prompt partem desse modelo treinado com prompt de texto e atualizam um módulo cada. YOLOESegVPTrainer é a receita de prompt visual e YOLOEPEFreeTrainer é a receita sem prompt, mas nenhuma das classes congela nada por si só: o treinamento seletivo vem da lista freeze que você passa junto, que inclui todos os filhos da cabeça, exceto savpe (ou todas as torres de classificação), e a execução sem prompt também precisa de single_cls=True. O repositório upstream do YOLOE contém as receitas completas para os modelos da escala v8.
Uma execução sem prompt concluída é reparametrizada em um checkpoint que apresenta seus nomes sem prompt durante a inferência, usando get_vocab e set_vocab:
from ultralytics import YOLOE

# Pesos gravados pela execução sem prompt e pela execução com prompt de texto a partir da qual ela começou. Cada
# nova execução cria um diretório (train-2, train-3, ...), então use os caminhos exibidos pelas execuções.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # execução sem prompt, a cabeça já está fundida
text_model = YOLOE("runs/segment/train/weights/best.pt")  # execução com prompt de texto, a cabeça ainda não está fundida

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # o vocabulário de 4.585 nomes ou sua própria lista
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt")  # nunca sobrescreva o checkpoint publicado
get_vocab retorna o ramo selecionado pela flag end2end do modelo, e set_vocab reparametriza esse ramo. Já os arquivos YOLOE-26 publicados trazem um vocabulário por ramo, o que permite que nms continue selecionando entre eles; reproduza esse comportamento obtendo o segundo vocabulário de outra cópia do modelo com prompt de texto. YOLOE-11 e YOLOE-v8 têm um único ramo, então usam a chamada acima sem alterações.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab funde a cabeça que lê, então carregue uma segunda cópia
one2one_model.model.end2end = True  # leia o ramo sem NMS

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Citações e agradecimentos#
Se o YOLOE contribuiu para sua pesquisa ou projeto, cite o artigo original de Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han e Guiguang Ding, da Universidade Tsinghua:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Para saber mais, o artigo original do YOLOE está disponível no arXiv. O código-fonte do projeto e recursos adicionais podem ser acessados pelo repositório no GitHub.
Perguntas frequentes#
O Ultralytics YOLOE adiciona dois recursos que o YOLO-World não tem: prompts visuais, em que uma caixa de exemplo substitui o nome da classe, e checkpoints sem prompt, que respondem usando um vocabulário integrado de 4.585 nomes, sem nenhum prompt. Todas as previsões dos checkpoints
*-seg.ptpublicados também incluem uma máscara de segmentação de instâncias. Em termos de precisão, o artigo original do YOLOE mostra o YOLOE-v8s 3,5 AP à frente do YOLO-Worldv2-S no LVIS, com um terço do custo de treinamento e 1,4× a velocidade de inferência. A migração exige uma única alteração — consulte Comparação do YOLOE.O Ultralytics YOLOE oferece suporte a três modos de prompt. Um prompt de texto consiste em nomes de classes como strings em um checkpoint
*-seg.pte é a opção mais comum. Um prompt visual consiste em uma ou mais caixas de exemplo em uma imagem de referência, para objetos difíceis de descrever com palavras. A inferência sem prompt usa um checkpoint*-seg-pf.ptseparado, que responde com base em um vocabulário integrado de 4.585 nomes, sem receber nenhuma entrada. Os prompts de texto e visuais usam os mesmos checkpoints; os checkpoints sem prompt são arquivos diferentes e rejeitamset_classes(). Consulte Escolher um modo de prompt para ver a comparação completa.Comece com
yoloe-26s-seg.pt: a família YOLOE-26 supera YOLOE-11 e YOLOE-v8 em todas as escalas correspondentes, e a escalasé a menor que passa de 30 mAP no minival do LVIS. Passe param,louxquando a precisão em categorias raras for mais importante que a latência — a coluna mAPr em Desempenho é a que você deve comparar. Usenapenas para implantação em dispositivos de borda. Em vez disso, carregue o arquivo*-seg-pf.ptda mesma escala quando quiser usar o vocabulário integrado, e não seus próprios nomes de classe.Rótulos como
object0eobject1indicam que a previsão veio de um prompt visual, que agrupa as caixas de exemplo em classes numeradas temporárias, em vez de usar os nomes que você definiu. Os IDs de classe que você passa emvisual_prompts["cls"]servem apenas para esse agrupamento. O modelo os apresenta comoobject0,object1e assim por diante, na ordem dos IDs atribuídos; portanto, associe-os aos seus próprios rótulos no resultado. Se quiser que a saída inclua seus nomes, use um prompt de texto.Os checkpoints sem prompts (
*-seg-pf.pt) resolvem as classes através do vocabulário integrado e rejeitamset_classes()comAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Os prompts visuais geramAssertionError: Visual prompts need an unfused YOLOE model.. Carrega um checkpoint*-seg.ptquando precisares da tua própria lista de classes. Consulta Escolher um modo de prompt.O primeiro prompt de texto faz o Ultralytics YOLOE instalar ultralytics/CLIP do GitHub com
pipe baixar um codificador de texto TorchScript para o diretório de trabalho atual — cerca de 254 MB no YOLOE-26; consulte Instalação e requisitos para ver o recurso exato de cada família de modelos. Os prompts visuais e os checkpoints sem prompt não precisam de nenhum dos dois. Para evitar o download na máquina de destino, defina os prompts uma vez e salve-os comsave_prompt_embeddings(), ou exporte o modelo com as classes já configuradas.Não — o YOLOE incorpora as classes do prompt aos pesos durante a exportação, então uma exportação carregada rejeita tanto
set_classes()quantovisual_prompts=. Exporte novamente a partir do checkpoint original.ptcom os novos prompts configurados. O arquivo exportado funciona como um modelo YOLO padrão e também pode ser carregado comYOLO()eYOLOE().Use YOLOE quando precisar de alto desempenho em tempo real e puder nomear as classes, e SAM 3 quando a qualidade da segmentação de um conceito for mais importante que a velocidade. Ambos aceitam exemplos visuais; só o YOLOE tem um modo sem prompt. A comparação completa está em Comparação do YOLOE.


Comentários60
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(editado)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(editado)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.