Обслуживание моделей компьютерного зрения после развертывания#
Мониторинг и обслуживание модели компьютерного зрения означает непрерывное отслеживание ее предсказаний на предмет дрейфа данных и снижения точности, ее дообучение на свежих данных при ухудшении производительности и документирование каждого изменения, чтобы работа оставалась воспроизводимой. Это заключительный этап проекта компьютерного зрения — после того как ты собрал требования, разметил данные, обучил модель и развернул ее, — именно он помогает модели выполнять цели проекта после запуска в production.
Watch: How to Maintain Computer Vision Models after Deployment | Data Drift Detection
В этом руководстве мы подробно рассмотрим, как обслуживать модели компьютерного зрения после развертывания. Мы разберем, как мониторинг модели помогает заранее выявлять проблемы, поддерживать точность и актуальность модели, а также почему документация важна для устранения неполадок.
Мониторинг модели#
За развернутыми моделями компьютерного зрения необходимо внимательно следить. Без надлежащего мониторинга модели могут терять точность. Распространенная проблема — сдвиг распределения данных, или дрейф данных, когда данные, с которыми сталкивается модель, отличаются от данных, на которых она обучалась. Если модели приходится делать предсказания на незнакомых данных, это может приводить к неверной интерпретации и низкой производительности. Выбросы, то есть необычные точки данных, также могут снижать точность модели.
Регулярный мониторинг модели помогает разработчикам отслеживать производительность модели, выявлять аномалии и быстро устранять такие проблемы, как дрейф данных. Он также помогает управлять ресурсами, показывая, когда нужны обновления, предотвращая дорогостоящие переделки и сохраняя актуальность модели.
Рекомендации по мониторингу модели#
Вот несколько рекомендаций, которые стоит учитывать при мониторинге модели компьютерного зрения в production:
- Регулярно отслеживай производительность: непрерывно контролируй производительность модели, чтобы выявлять изменения со временем.
- Повторно проверяй качество данных: проверяй данные на наличие пропущенных значений и аномалий.
- Используй разнообразные источники данных: отслеживай данные из разных источников, чтобы получить полное представление о производительности модели.
- Комбинируй методы мониторинга: используй сочетание алгоритмов обнаружения дрейфа и подходов на основе правил, чтобы выявлять широкий спектр проблем.
- Отслеживай входные и выходные данные: следи и за данными, которые обрабатывает модель, и за результатами, которые она выдает, чтобы убедиться в корректной работе системы.
- Настрой оповещения: добавь оповещения о необычном поведении, например снижении производительности, чтобы можно было быстро принять корректирующие меры.
Мониторинг с помощью Ultralytics Platform#
Ultralytics Platform предоставляет встроенный мониторинг модели для развернутых конечных точек YOLO, поэтому ты можешь наблюдать за моделью в production без сборки отдельного стека мониторинга. На панели развертывания в реальном времени отслеживаются ключевые сигналы:
- Метрики запросов: общее количество запросов, частота ошибок и задержка P95 для каждой конечной точки, а также спарклайны с трендами за периоды от 1 часа до 30 дней.
- Проверки работоспособности: автоматический опрос состояния конечных точек, который отмечает неработоспособные развертывания и сообщает о задержке ответа.
- Журналы: журналы запросов с фильтрацией по уровню серьезности (от DEBUG до CRITICAL) для диагностики неудачных запросов и скачков задержки.
- Глобальный обзор: интерактивная карта мира и обзорные карточки, которые на одном экране обобщают информацию обо всех развертываниях в разных регионах.
Поскольку мониторинг доступен через стандартные URL конечных точек и проверку /health, ты также можешь включить эти сигналы в существующую систему наблюдаемости, если нужен более глубокий анализ. Подробнее о настройке см. в руководстве по мониторингу развертывания.
Обнаружение аномалий и системы оповещений#
Аномалия — это любая точка данных или закономерность, которые заметно отклоняются от ожидаемых. В контексте моделей компьютерного зрения аномалиями могут быть изображения, сильно отличающиеся от тех, на которых обучалась модель. Такие неожиданные изображения могут указывать на проблемы, например изменения распределения данных, выбросы или поведение, способное снизить производительность модели. Настройка систем оповещений для обнаружения этих аномалий — важная часть мониторинга модели.
Задавая стандартные уровни производительности и ограничения для ключевых метрик, ты можешь выявлять проблемы на раннем этапе. Когда производительность выходит за эти ограничения, срабатывают оповещения, что позволяет быстро исправить ситуацию. Регулярное обновление и дообучение моделей на новых данных помогает сохранять их актуальность и точность по мере изменения данных.
Настройка порогов и оповещений#
При настройке систем оповещений учитывай следующие рекомендации:
- Стандартизируй оповещения: используй единообразные инструменты и форматы для всех оповещений, например электронную почту или приложения для обмена сообщениями, такие как Slack. Стандартизация поможет тебе быстрее понимать оповещения и реагировать на них.
- Указывай ожидаемое поведение: в сообщениях об оповещениях четко указывай, что пошло не так, что ожидалось и какой период оценивался. Это помогает определить срочность и контекст оповещения.
- Настраивай оповещения: сделай оповещения легко конфигурируемыми, чтобы адаптировать их к изменяющимся условиям. Предусмотри возможность изменять пороги, откладывать, отключать и подтверждать оповещения.
Обнаружение дрейфа данных#
Обнаружение дрейфа данных — это подход, который помогает выявлять изменения статистических свойств входных данных со временем, способные ухудшить производительность модели. До того как ты решишь переобучить или скорректировать модели, этот метод помогает обнаружить наличие проблемы. Дрейф данных связан с изменениями общей картины данных со временем, тогда как обнаружение аномалий сосредоточено на выявлении редких или неожиданных точек данных, которые могут требовать немедленного внимания.
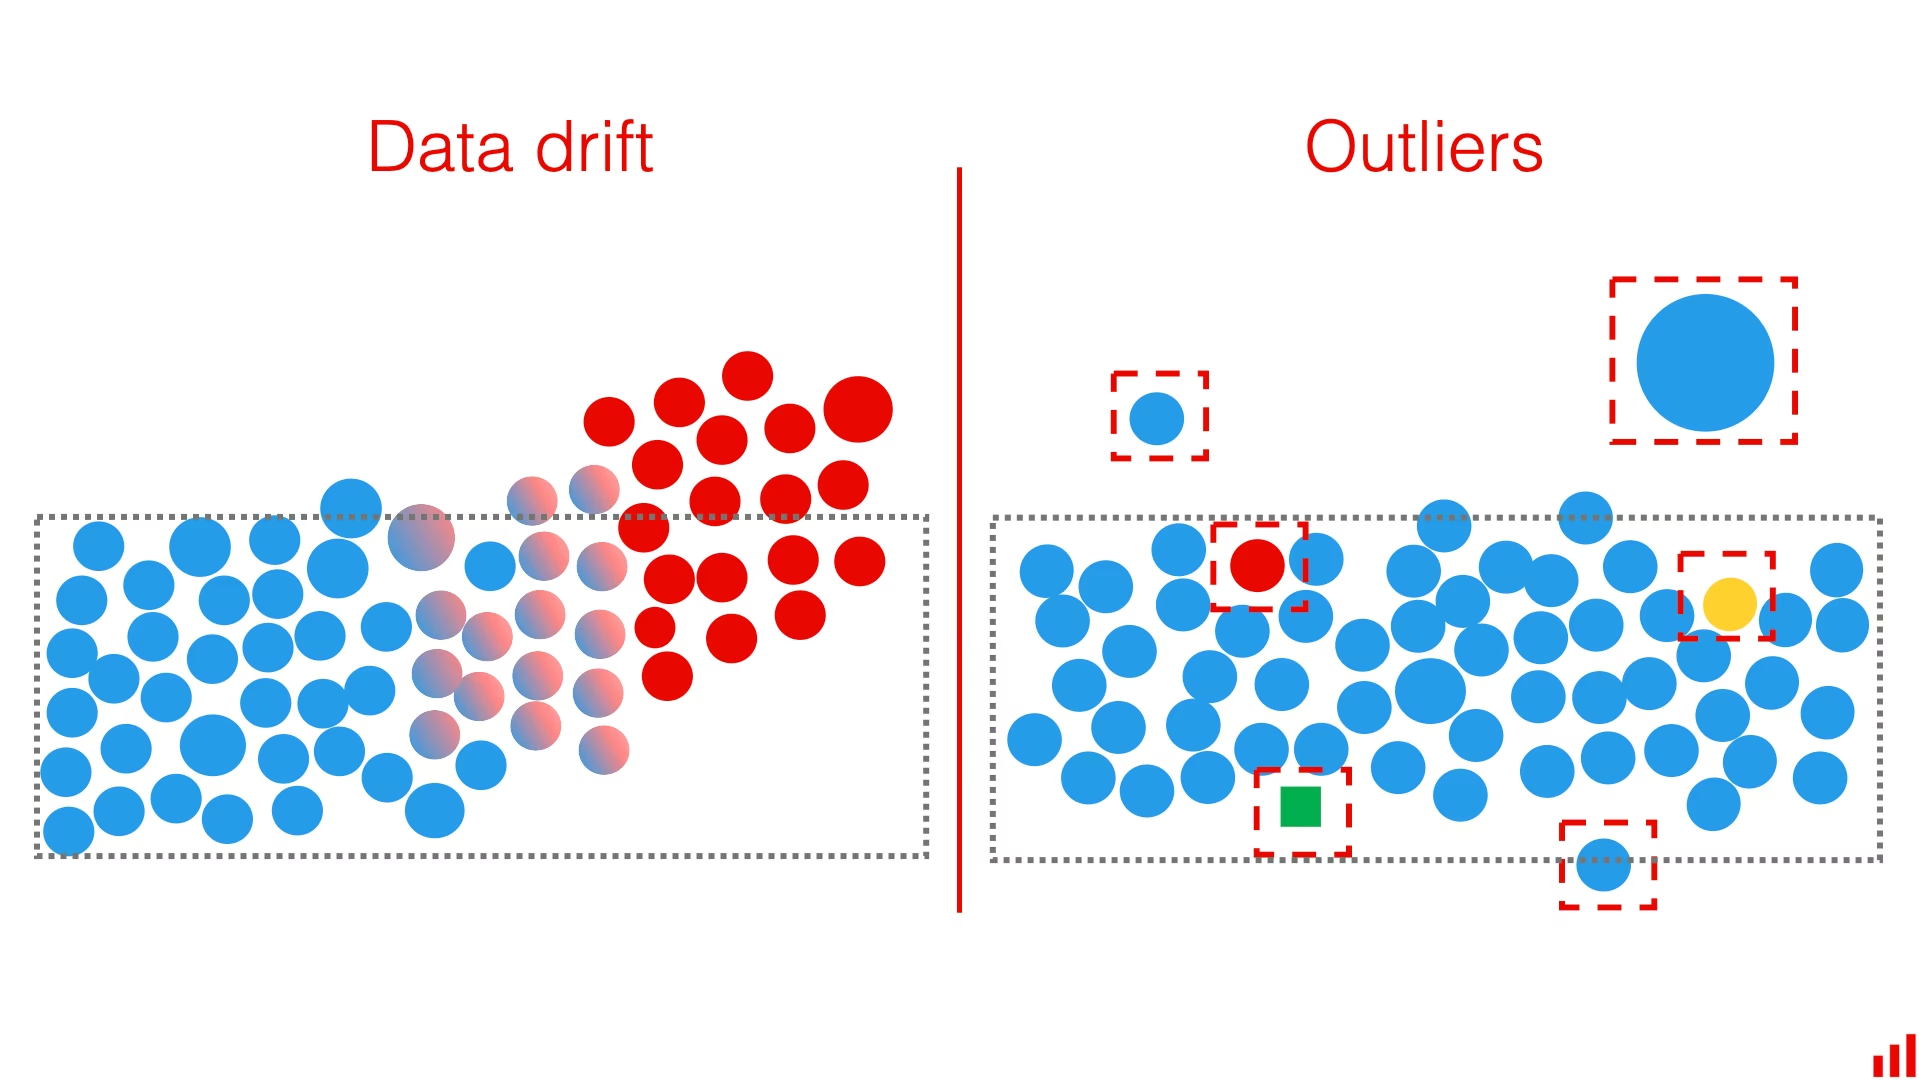
Вот несколько методов обнаружения дрейфа данных:
- Непрерывный мониторинг: регулярно отслеживай входные данные и выходы модели на предмет признаков дрейфа. Следи за ключевыми метриками и сравнивай их с историческими данными, чтобы выявлять существенные изменения.
- Статистические методы: используй такие методы, как критерий Колмогорова — Смирнова или индекс стабильности популяции (PSI), чтобы выявлять изменения в распределениях данных. Эти тесты сравнивают распределение новых данных с данными для обучения, чтобы обнаруживать существенные различия.
- Дрейф признаков: отслеживай дрейф отдельных признаков. Иногда общее распределение данных остается стабильным, но отдельные признаки могут смещаться. Выявление признаков, подверженных дрейфу, помогает точнее настроить процесс дообучения.
Обслуживание модели#
Обслуживание модели помогает сохранять точность и актуальность моделей компьютерного зрения с течением времени благодаря их регулярному обновлению и дообучению, устранению дрейфа данных и адаптации к изменениям данных и среды. Это дополнение к мониторингу: мониторинг в реальном времени следит за производительностью модели, чтобы заранее выявлять проблемы, а обслуживание направлено на их устранение.
Регулярное обновление и дообучение#
После развертывания модели во время мониторинга ты можешь заметить изменения в закономерностях данных или производительности, указывающие на дрейф модели. Регулярные обновления и дообучение становятся важными составляющими обслуживания модели, обеспечивая ее способность работать с новыми закономерностями и сценариями. В зависимости от изменений данных можно применять разные методы.
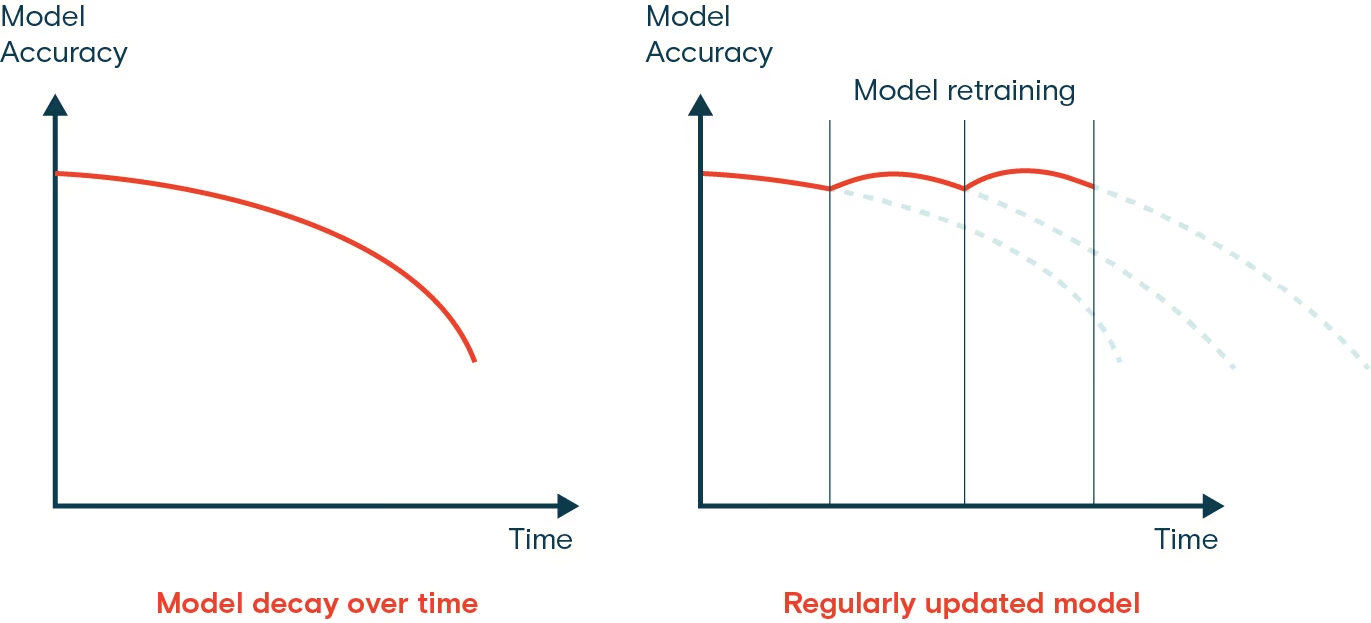
Например, если данные постепенно меняются со временем, хорошим подходом будет инкрементное обучение. Оно предполагает обновление модели на новых данных без полного переобучения с нуля, что позволяет экономить вычислительные ресурсы и время. Однако если данные существенно изменились, периодическое полное переобучение может быть более подходящим вариантом, чтобы модель не начала переобучаться на новых данных, теряя при этом старые закономерности.
Независимо от метода, после обновлений обязательно нужно проводить валидацию и тестирование. Важно валидировать модель на отдельном тестовом наборе данных, чтобы проверить улучшение или ухудшение производительности.
Когда следует переобучать модель#
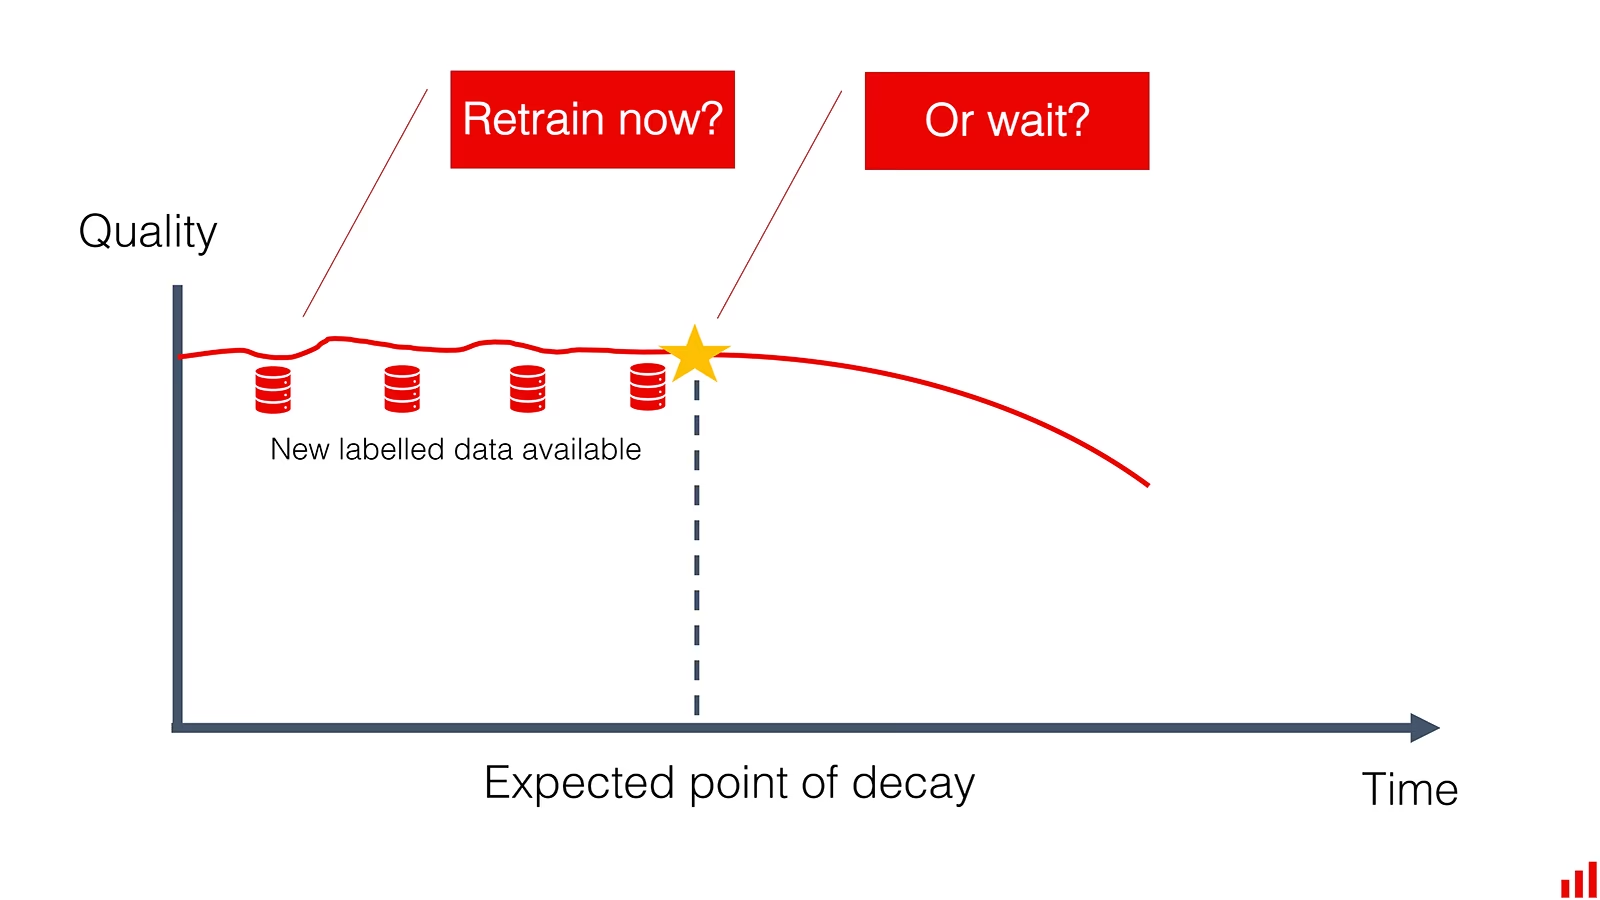
Частота переобучения модели компьютерного зрения зависит от изменений данных и производительности модели. Переобучай модель при каждом существенном снижении производительности или обнаружении дрейфа данных. Регулярные оценки помогают определить подходящий график переобучения путем тестирования модели на новых данных. Мониторинг метрик производительности и закономерностей в данных позволяет решить, нужны ли модели более частые обновления для сохранения точности.
Документация#
Документирование проекта компьютерного зрения упрощает его понимание, воспроизведение и совместную разработку. Качественная документация охватывает архитектуру модели, гиперпараметры, наборы данных, метрики оценки и многое другое. Она обеспечивает прозрачность, помогая членам команды и заинтересованным сторонам понять, что и почему было сделано. Документация также помогает при устранении неполадок, обслуживании и будущих улучшениях, предоставляя четкую информацию о принятых ранее решениях и использованных методах.
Ключевые элементы, которые нужно документировать#
Вот некоторые ключевые элементы, которые следует включить в документацию проекта:
- Обзор проекта: приведи общее описание проекта, включая формулировку проблемы, подход к ее решению, ожидаемые результаты и границы проекта. Объясни роль компьютерного зрения в решении проблемы и опиши этапы и результаты.
- Архитектура модели: подробно опиши структуру и устройство модели, включая ее компоненты, слои и связи между ними. Объясни выбранные гиперпараметры и обоснуй этот выбор.
- Подготовка данных: опиши источники, типы, форматы и размеры данных, а также этапы предварительной обработки. Расскажи о качестве и надежности данных и о преобразованиях, выполненных до обучения модели.
- Процесс обучения: задокументируй процедуру обучения, включая использованные наборы данных, параметры обучения и функции потерь. Объясни, как обучалась модель, и опиши возникшие во время обучения проблемы.
- Метрики оценки: укажи метрики, использованные для оценки производительности модели, такие как точность, precision, полнота и F1-мера. Добавь результаты и анализ этих метрик.
- Этапы развертывания: опиши этапы развертывания модели, включая использованные инструменты и платформы, конфигурации развертывания, а также конкретные проблемы или особенности.
- Процедура мониторинга и обслуживания: предоставь подробный план мониторинга производительности модели после развертывания. Включи методы обнаружения и устранения дрейфа данных и модели, а также опиши процесс регулярного обновления и дообучения.
Заключение#
Мониторинг, обслуживание и документирование модели помогают проекту компьютерного зрения оставаться успешным еще долго после развертывания: непрерывный мониторинг выявляет проблемы на раннем этапе, регулярное дообучение адаптирует модель к новым данным и дрейфу, а понятная документация упрощает каждое будущее обновление. Относись к этому как к непрерывному циклу и возвращайся к этапам проекта компьютерного зрения по мере изменения данных и требований.
Часто задаваемые вопросы#
Чтобы отслеживать производительность развернутой модели компьютерного зрения, контролируй в production объем запросов, частоту ошибок и задержку, одновременно отслеживая аномалии и дрейф данных, которые сигнализируют о снижении точности. Панель Deploy в Ultralytics Platform изначально предоставляет метрики production в реальном времени, автоматические проверки работоспособности и журналы с фильтрацией по уровню серьезности. Регулярно отслеживай входные и выходные данные, настраивай оповещения о необычном поведении и используй разнообразные источники данных, чтобы получить полное представление о производительности модели. Подробнее см. в разделе Мониторинг модели.
Обслуживание моделей компьютерного зрения включает регулярные обновления, дообучение и мониторинг, которые помогают сохранять точность и актуальность моделей. Основные рекомендации:
- Непрерывный мониторинг: регулярно отслеживай метрики производительности и качество данных.
- Обнаружение дрейфа данных: используй статистические методы для выявления изменений в распределениях данных.
- Регулярное обновление и дообучение: применяй инкрементное обучение или периодическое полное переобучение в зависимости от изменений данных.
- Документация: поддерживай подробную документацию архитектуры модели, процессов обучения и метрик оценки. Дополнительную информацию см. в разделе Обслуживание модели.
Обнаружение дрейфа данных необходимо, поскольку оно помогает выявлять изменения статистических свойств входных данных со временем, способные ухудшить производительность модели. Такие методы, как непрерывный мониторинг, статистические тесты (например, критерий Колмогорова — Смирнова) и анализ дрейфа признаков, помогают обнаруживать проблемы на раннем этапе. Устранение дрейфа данных позволяет сохранять точность и актуальность модели в изменяющихся условиях. Подробнее об обнаружении дрейфа данных см. в разделе Обнаружение дрейфа данных.
Для обнаружения аномалий в моделях компьютерного зрения задай стандартные уровни производительности для ключевых метрик и включай оповещения всякий раз, когда значения выходят за эти пределы. Ultralytics Platform поддерживает такой подход благодаря метрикам частоты ошибок и задержки в реальном времени, автоматическим проверкам работоспособности и журналам с фильтрацией по уровню серьезности, которые быстро выявляют необычное поведение. Настраиваемые оповещения и стандартизированные сообщения помогают быстро реагировать на потенциальные проблемы. Подробнее см. в разделе Обнаружение аномалий и системы оповещений.
Эффективная документация проекта компьютерного зрения должна включать:
- Обзор проекта: общее описание, формулировку проблемы и подход к ее решению.
- Архитектура модели: сведения о структуре модели, ее компонентах и гиперпараметрах.
- Подготовка данных: информацию об источниках данных, этапах предварительной обработки и преобразованиях.
- Процесс обучения: описание процедуры обучения, использованных наборов данных и возникших проблем.
- Метрики оценки: метрики, использованные для оценки и анализа производительности.
- Этапы развертывания: этапы развертывания модели и конкретные возникшие проблемы.
- Процедура мониторинга и обслуживания: план постоянного мониторинга и обслуживания. Более подробные рекомендации см. в разделе Документация.