Развертывание предварительно обученной модели YOLO с Ultralytics на Vertex AI для инференса#
В этом руководстве показано, как упаковать предварительно обученную модель YOLO26 с Ultralytics в контейнер, создать для неё сервер инференса на FastAPI и развернуть модель вместе с сервером инференса в Google Cloud Vertex AI. В примере рассматривается обнаружение объектов с помощью YOLO26, но те же принципы применимы и к другим задачам YOLO.
Для начала создай проект Google Cloud Platform (GCP). Новые пользователи получают 300 долларов кредитов GCP для бесплатного использования. Этой суммы хватит, чтобы проверить работающую конфигурацию, которую позже можно расширить для любых других задач с YOLO26, включая обучение, пакетный инференс и инференс в потоковом режиме.
Что ты узнаешь#
- Создать серверную часть инференса для модели Ultralytics YOLO26 с помощью FastAPI.
- Создать репозиторий GCP Artifact Registry для хранения образа Docker.
- Собрать образ Docker с моделью и отправить его в Artifact Registry.
- Импортировать модель в Vertex AI.
- Создать конечную точку Vertex AI и развернуть модель.
- Полный контроль над моделью с Ultralytics: ты можешь использовать собственную логику инференса и полностью контролировать предварительную обработку, постобработку и форматирование ответов.
- Vertex AI берёт на себя остальное: сервис автоматически масштабируется, но при этом позволяет гибко настраивать вычислительные ресурсы, память и GPU.
- Встроенные интеграции и безопасность GCP: простая настройка Cloud Storage, BigQuery, Cloud Functions, средств управления VPC, политик IAM и журналов аудита.
Предварительные требования#
- Установи Docker на свой компьютер.
- Установи Google Cloud SDK и настрой аутентификацию для работы с CLI gcloud.
- Настоятельно рекомендуем изучить краткое руководство Ultralytics по Docker, поскольку в ходе работы тебе потребуется расширить один из официальных образов Docker от Ultralytics.
1. Создание сервера инференса с FastAPI#
Сначала создай приложение FastAPI, которое будет обрабатывать запросы инференса модели YOLO26. Приложение будет отвечать за загрузку модели, предварительную обработку изображений и логику инференса (предсказания).
Основы соответствия требованиям Vertex AI#
Vertex AI требует, чтобы в контейнере были реализованы две специальные конечные точки:
-
Конечная точка Health (
/health): должна возвращать HTTP-статус200 OK, когда сервис готов к работе. -
Конечная точка Predict (
/predict): принимает структурированные запросы на предсказание с изображениями, закодированными в base64, и необязательными параметрами. В зависимости от типа конечной точки действуют ограничения на размер полезной нагрузки.Полезная нагрузка запросов к конечной точке
/predictдолжна соответствовать такой структуре JSON:{ "instances": [{ "image": "base64_encoded_image" }], "parameters": { "confidence": 0.5 } }
Структура папок проекта#
Основная часть сборки будет выполняться внутри контейнера Docker. Кроме того, Ultralytics загрузит предварительно обученную модель YOLO26, поэтому локальную структуру папок можно оставить простой:
YOUR_PROJECT/
├── src/
│   ├── __init__.py
│   ├── app.py              # Core YOLO26 inference logic
│   └── main.py             # FastAPI inference server
├── tests/
├── .env                    # Environment variables for local development
├── Dockerfile              # Container configuration
├── LICENSE                 # AGPL-3.0 License
└── pyproject.toml # Python dependencies and project configМодели Ultralytics YOLO26 и фреймворк распространяются по лицензии AGPL-3.0, которая предъявляет важные требования к соблюдению условий. Обязательно прочитай документацию Ultralytics о том, как соблюдать условия лицензии.
Создание pyproject.toml с зависимостями#
Для удобного управления проектом создай файл pyproject.toml со следующими зависимостями:
[project]
name = "YOUR_PROJECT_NAME"
version = "0.0.1"
description = "YOUR_PROJECT_DESCRIPTION"
requires-python = ">=3.10,<3.13"
dependencies = [
   "ultralytics>=8.4.0",
   "fastapi[all]>=0.89.1",
   "uvicorn[standard]>=0.20.0",
   "pillow>=9.0.0",
   "loguru",
]

[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"uvicornбудет использоваться для запуска сервера FastAPI.loguruбудет использоваться для ведения журналов на сервере FastAPI.pillowбудет использоваться для обработки изображений, но поддержка не ограничивается изображениями PIL: Ultralytics поддерживает множество других форматов.
Создание логики инференса с Ultralytics YOLO26#
Теперь, когда структура проекта и зависимости готовы, можно реализовать основную логику инференса YOLO26. Создай файл src/app.py, который будет отвечать за загрузку модели, обработку изображений и предсказания с использованием Python API Ultralytics.
# src/app.py

from ultralytics import YOLO

# Model initialization and readiness state
model_yolo = None
_model_ready = False

def _initialize_model():
    """Initialize the YOLO model."""
    global model_yolo, _model_ready

    try:
        # Use pretrained YOLO26n model from Ultralytics base image
        model_yolo = YOLO("yolo26n.pt")
        _model_ready = True

    except Exception as e:
        print(f"Error initializing YOLO model: {e}")
        _model_ready = False
        model_yolo = None

# Initialize model on module import
_initialize_model()

def is_model_ready() -> bool:
    """Check if the model is ready for inference."""
    return _model_ready and model_yolo is not None
Модель загрузится один раз при запуске контейнера и будет общей для всех запросов. Если модель будет обрабатывать большую нагрузку инференса, на следующем этапе при импорте модели в Vertex AI рекомендуется выбрать тип машины с большим объёмом памяти.
Затем создай две вспомогательные функции для обработки входных и выходных изображений с помощью pillow. YOLO26 изначально поддерживает изображения PIL.
def get_image_from_bytes(binary_image: bytes) -> Image.Image:
    """Convert image from bytes to PIL RGB format."""
    input_image = Image.open(io.BytesIO(binary_image)).convert("RGB")
    return input_image
def get_bytes_from_image(image: Image.Image) -> bytes:
"""Convert PIL image to bytes."""
return_image = io.BytesIO()
image.save(return_image, format="JPEG", quality=85)
return_image.seek(0)
return return_image.getvalue()Наконец, реализуй функцию run_inference для обнаружения объектов. В этом примере мы извлечём из предсказаний модели ограничивающие рамки, названия классов и оценки уверенности. Функция вернёт словарь с обнаруженными объектами и исходными результатами для дальнейшей обработки или аннотирования.
def run_inference(input_image: Image.Image, confidence_threshold: float = 0.5) -> Dict[str, Any]:
    """Run inference on an image using YOLO26n model."""
    # Check if model is ready
    if not is_model_ready():
        print("Model not ready for inference")
        return {"detections": [], "results": None}

    try:
        # Make predictions and get raw results
        results = model_yolo.predict(
            imgsz=640, source=input_image, conf=confidence_threshold, save=False, augment=False, verbose=False
        )

        # Extract detections (bounding boxes, class names, and confidences)
        detections = []
        if results and len(results) > 0:
            result = results[0]
            if result.boxes is not None and len(result.boxes.xyxy) > 0:
                boxes = result.boxes

                # Convert tensors to numpy for processing
                xyxy = boxes.xyxy.cpu().numpy()
                conf = boxes.conf.cpu().numpy()
                cls = boxes.cls.cpu().numpy().astype(int)

                # Create detection dictionaries
                for i in range(len(xyxy)):
                    detection = {
                        "xmin": float(xyxy[i][0]),
                        "ymin": float(xyxy[i][1]),
                        "xmax": float(xyxy[i][2]),
                        "ymax": float(xyxy[i][3]),
                        "confidence": float(conf[i]),
                        "class": int(cls[i]),
                        "name": model_yolo.names.get(int(cls[i]), f"class_{int(cls[i])}"),
                    }
                    detections.append(detection)

        return {
            "detections": detections,
            "results": results,  # Keep raw results for annotation
        }
    except Exception as e:
        # If there's an error, return empty structure
        print(f"Error in YOLO detection: {e}")
        return {"detections": [], "results": None}
При желании можно добавить функцию для аннотирования изображения ограничивающими рамками и метками с помощью встроенного метода построения графиков Ultralytics. Это пригодится, если ты захочешь возвращать аннотированные изображения в ответе на запрос предсказания.
def get_annotated_image(results: list) -> Image.Image:
    """Get annotated image using Ultralytics built-in plot method."""
    if not results or len(results) == 0:
        raise ValueError("No results provided for annotation")

    result = results[0]
    # Использование встроенного метода plot Ultralytics с выводом PIL
    return result.plot(pil=True)
Создание HTTP-сервера инференса с FastAPI#
Теперь, когда основная логика инференса YOLO26 готова, можно создать приложение FastAPI для её обслуживания. В него войдут конечные точки проверки работоспособности и предсказания, необходимые Vertex AI.
Сначала создай src/main.py, добавь импорты, создай приложение FastAPI и настрой журналирование для Vertex AI. Поскольку Vertex AI считает stderr потоком ошибок, журналы лучше перенаправлять в stdout.
# src/main.py

import sys

from fastapi import FastAPI
from loguru import logger

app = FastAPI()

# Настройка логгера
logger.remove()
logger.add(
    sys.stdout,
    colorize=True,
    format="<green>{time:HH:mm:ss}</green> | <level>{message}</level>",
    level=10,
)
logger.add("log.log", rotation="1 MB", level="DEBUG", compression="zip")
Чтобы полностью соответствовать требованиям Vertex AI, задай необходимые конечные точки в переменных окружения и установи ограничение на размер запросов. Для производственных развертываний рекомендуется использовать закрытые конечные точки Vertex AI. Так ты получишь более высокий лимит размера полезной нагрузки запроса (10 МБ вместо 1,5 МБ для общедоступных конечных точек), а также надёжную защиту и контроль доступа.
# Переменные окружения Vertex AI
AIP_HTTP_PORT = int(os.getenv("AIP_HTTP_PORT", "8080"))
AIP_HEALTH_ROUTE = os.getenv("AIP_HEALTH_ROUTE", "/health")
AIP_PREDICT_ROUTE = os.getenv("AIP_PREDICT_ROUTE", "/predict")

# Ограничение размера запроса (10 МБ для закрытых конечных точек, 1,5 МБ для общедоступных)
MAX_REQUEST_SIZE = 10 * 1024 * 1024  # 10 МБ в байтах
Добавь две модели Pydantic для проверки запросов и ответов:
# Модели Pydantic для запроса и ответа
class PredictionRequest(BaseModel):
    instances: list
    parameters: Optional[Dict[str, Any]] = None

class PredictionResponse(BaseModel):
    predictions: list
Добавь конечную точку проверки работоспособности, чтобы убедиться в готовности модели. Это важно для Vertex AI: без отдельной проверки работоспособности оркестратор будет отправлять запросы на случайные сокеты и не сможет определить, готова ли модель к инференсу. При успехе проверка должна возвращать 200 OK, а при ошибке — 503 Service Unavailable:
# Конечная точка проверки работоспособности
@app.get(AIP_HEALTH_ROUTE, status_code=status.HTTP_200_OK)
def health_check():
    """Health check endpoint for Vertex AI."""
    if not is_model_ready():
        raise HTTPException(status_code=503, detail="Model not ready")
    return {"status": "healthy"}
Теперь у тебя есть всё необходимое для реализации конечной точки предсказания, которая будет обрабатывать запросы инференса. Она примет файл изображения, выполнит инференс и вернёт результаты. Обрати внимание: изображение необходимо закодировать в base64, что может увеличить размер полезной нагрузки ещё на 33%.
@app.post(AIP_PREDICT_ROUTE, response_model=PredictionResponse)
async def predict(request: PredictionRequest):
    """Prediction endpoint for Vertex AI."""
    try:
        predictions = []

        for instance in request.instances:
            if isinstance(instance, dict):
                if "image" in instance:
                    image_data = base64.b64decode(instance["image"])
                    input_image = get_image_from_bytes(image_data)
                else:
                    raise HTTPException(status_code=400, detail="Instance must contain 'image' field")
            else:
                raise HTTPException(status_code=400, detail="Invalid instance format")

            # Extract YOLO26 parameters if provided
            parameters = request.parameters or {}
            confidence_threshold = parameters.get("confidence", 0.5)
            return_annotated_image = parameters.get("return_annotated_image", False)

            # Run inference with YOLO26n model
            result = run_inference(input_image, confidence_threshold=confidence_threshold)
            detections_list = result["detections"]

            # Format predictions for Vertex AI
            detections = []
            for detection in detections_list:
                formatted_detection = {
                    "class": detection["name"],
                    "confidence": detection["confidence"],
                    "bbox": {
                        "xmin": detection["xmin"],
                        "ymin": detection["ymin"],
                        "xmax": detection["xmax"],
                        "ymax": detection["ymax"],
                    },
                }
                detections.append(formatted_detection)

            # Build prediction response
            prediction = {"detections": detections, "detection_count": len(detections)}

            # Add annotated image if requested and detections exist
            if (
                return_annotated_image
                and result["results"]
                and result["results"][0].boxes is not None
                and len(result["results"][0].boxes) > 0
            ):
                annotated_image = get_annotated_image(result["results"])
                img_bytes = get_bytes_from_image(annotated_image)
                prediction["annotated_image"] = base64.b64encode(img_bytes).decode("utf-8")

            predictions.append(prediction)

        logger.info(
            f"Processed {len(request.instances)} instances, found {sum(len(p['detections']) for p in predictions)} total detections"
        )

        return PredictionResponse(predictions=predictions)

    except HTTPException:
        # Re-raise HTTPException as-is (don't catch and convert to 500)
        raise
    except Exception as e:
        logger.error(f"Prediction error: {e}")
        raise HTTPException(status_code=500, detail=f"Prediction failed: {e}")
Наконец, добавь точку входа приложения для запуска сервера FastAPI.
if __name__ == "__main__":
    import uvicorn

    logger.info(f"Starting server on port {AIP_HTTP_PORT}")
    logger.info(f"Health check route: {AIP_HEALTH_ROUTE}")
    logger.info(f"Predict route: {AIP_PREDICT_ROUTE}")
    uvicorn.run(app, host="0.0.0.0", port=AIP_HTTP_PORT)
Теперь у тебя есть готовое приложение FastAPI для обработки запросов инференса YOLO26. Чтобы протестировать его локально, установи зависимости и запусти сервер, например, с помощью uv.
# Install dependencies
uv pip install -e .

# Run the FastAPI server directly
uv run src/main.py
Чтобы проверить сервер, отправь запросы к конечным точкам /health и /predict с помощью cURL. Помести тестовое изображение в папку tests. Затем выполни в терминале следующие команды:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
В ответ должен прийти JSON с обнаруженными объектами. При первом запросе возможна небольшая задержка: Ultralytics требуется загрузить модель YOLO26.
2. Расширение образа Docker Ultralytics с помощью приложения#
Ultralytics предоставляет несколько образов Docker, которые можно использовать в качестве основы для образа приложения. В них уже включены Ultralytics и необходимые библиотеки CUDA, поэтому достаточно добавить поверх них приложение.
Чтобы использовать все возможности моделей Ultralytics YOLO, выбери образ с оптимизацией для CUDA, если нужен инференс на GPU. Если для задачи достаточно инференса на CPU, можно сэкономить вычислительные ресурсы и выбрать образ только для CPU:
- Dockerfile: образ с оптимизацией для CUDA для обучения и инференса YOLO26 на одном или нескольких GPU.
- Dockerfile-cpu: образ только для CPU-инференса YOLO26.
Создание образа Docker для приложения#
Создай Dockerfile в корневой папке проекта и добавь в него следующее содержимое:
# Extends official Ultralytics Docker image for YOLO26
FROM ultralytics/ultralytics:latest

ENV PYTHONUNBUFFERED=1

# Install FastAPI and dependencies
RUN uv pip install --system fastapi[all] uvicorn[standard] loguru

WORKDIR /app
COPY src/ ./src/
COPY pyproject.toml ./

# Install the application package
RUN uv pip install --system -e .

RUN mkdir -p /app/logs
ENV PYTHONPATH=/app/src

# Port for Vertex AI
EXPOSE 8080

# Start the inference server
ENTRYPOINT ["python", "src/main.py"]
В этом примере в качестве основы используется официальный образ Docker Ultralytics ultralytics:latest. В нём уже есть модель YOLO26 и все необходимые зависимости. Точка входа сервера такая же, как при локальном тестировании приложения FastAPI.
Сборка и тестирование образа Docker#
Теперь можно собрать образ Docker следующей командой:
docker build --platform linux/amd64 -t IMAGE_NAME:IMAGE_VERSION .Замени IMAGE_NAME и IMAGE_VERSION нужными значениями, например yolo26-fastapi:0.1. Обрати внимание: для развертывания в Vertex AI необходимо собрать образ под архитектуру linux/amd64. Параметр --platform нужно указать явно, если ты собираешь образ на Mac с Apple Silicon или на устройстве с другой архитектурой, отличной от x86.
После завершения сборки образа можно протестировать его локально:
docker run --platform linux/amd64 -p 8080:8080 IMAGE_NAME:IMAGE_VERSIONТеперь в контейнере Docker запущен сервер FastAPI на порту 8080, готовый принимать запросы инференса. Проверь конечные точки /health и /predict с помощью тех же команд cURL, что и ранее:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
3. Загрузка образа Docker в GCP Artifact Registry#
Чтобы импортировать модель в контейнере в Vertex AI, необходимо загрузить образ Docker в Google Cloud Artifact Registry. Если у тебя ещё нет репозитория Artifact Registry, сначала создай его.
Создание репозитория в Google Cloud Artifact Registry#
Открой страницу Artifact Registry в консоли Google Cloud. Если ты используешь Artifact Registry впервые, система может предложить сначала включить API Artifact Registry.

- Выбери «Создать репозиторий».
- Введи название репозитория. Выбери нужный регион, а для остальных параметров оставь значения по умолчанию, если нет особой необходимости изменить их.
Выбор региона может повлиять на доступность машин и некоторые ограничения вычислительных ресурсов для пользователей без Enterprise. Подробнее см. в официальной документации Vertex AI: квоты и ограничения Vertex AI
- После создания репозитория сохрани PROJECT_ID, Location (Region) и Repository Name в хранилище секретов или файле
.env. Позже они понадобятся, чтобы добавить тег к образу Docker и отправить его в Artifact Registry.
Аутентификация Docker в Artifact Registry#
Настрой аутентификацию клиента Docker для созданного репозитория Artifact Registry. Выполни в терминале следующую команду:
gcloud auth configure-docker YOUR_REGION-docker.pkg.devДобавление тега и отправка образа в Artifact Registry#
Добавь тег к образу Docker и отправь его в Google Artifact Registry.
При каждом обновлении образа рекомендуется использовать уникальный тег. Многие сервисы GCP, включая Vertex AI, используют теги образов для автоматического управления версиями и масштабирования, поэтому стоит применять семантическое версионирование или теги с датой.
Добавь к образу тег с URL репозитория Artifact Registry. Замени заполнители значениями, которые ты сохранил ранее.
docker tag IMAGE_NAME:IMAGE_VERSION YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONОтправь образ с тегом в репозиторий Artifact Registry.
docker push YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONДождись завершения процесса. Теперь изображение должно отображаться в репозитории Artifact Registry.
Подробные инструкции по работе с образами в Artifact Registry см. в документации Artifact Registry: Отправка и получение образов.
4. Импортируй модель в Vertex AI#
Теперь можно импортировать модель в Vertex AI с помощью только что отправленного Docker-образа.
-
В меню навигации Google Cloud перейди в Vertex AI > Model Registry. Также можно найти «Vertex AI» с помощью строки поиска в верхней части Google Cloud Console.

-
Нажми «Импортировать».
-
Выбери «Импортировать как новую модель».
-
Выбери регион. Можно выбрать тот же регион, что и для репозитория Artifact Registry, но при выборе учитывай доступность типов машин и квот в регионе.
-
Выбери «Импортировать существующий контейнер модели».

-
В поле «Образ контейнера» найди созданный ранее репозиторий Artifact Registry и выбери образ, который только что отправил в него.
-
Прокрути страницу до раздела «Переменные среды» и укажи эндпоинты predict и health, а также порт, заданный в приложении FastAPI.

-
Нажми «Импортировать». Vertex AI потребуется несколько минут, чтобы зарегистрировать модель и подготовить её к развёртыванию. Когда импорт завершится, ты получишь уведомление по электронной почте.
5. Создание конечной точки Vertex AI и развёртывание модели#
В терминологии Vertex AI конечные точки — это развёрнутые модели, поскольку они представляют собой HTTP-конечные точки, на которые отправляются запросы на инференс, а модели — это обученные ML-артефакты, хранящиеся в Model Registry.
Чтобы развернуть модель, нужно создать конечную точку в Vertex AI.
-
В меню навигации Vertex AI перейди в раздел Endpoints. Выбери регион, который использовал при импорте модели. Нажми Create.

-
Укажи название эндпоинта.
-
В разделе «Доступ» Vertex AI рекомендует использовать закрытые эндпоинты Vertex AI. Помимо преимуществ в плане безопасности, при выборе закрытого эндпоинта ты получишь более высокий лимит размера полезной нагрузки, однако для доступа к эндпоинту потребуется настроить сеть VPC и правила брандмауэра. Дополнительные инструкции смотри в документации Vertex AI о закрытых эндпоинтах.
-
Нажми «Продолжить».
-
В диалоговом окне «Настройки модели» выбери модель, которую импортировал ранее. Теперь можно настроить тип машины, память и параметры GPU для модели. Если ожидается высокая нагрузка на инференс, выдели достаточно памяти, чтобы избежать узких мест ввода-вывода и обеспечить надлежащую производительность YOLO26.
-
В разделе «Тип ускорителя» выбери тип GPU для инференса. Если не знаешь, какой GPU выбрать, начни с NVIDIA T4, который поддерживает CUDA.
Учти, что в некоторых регионах квоты на вычислительные ресурсы очень ограничены, поэтому там может быть недоступен выбор определённых типов машин или GPU. Если это критично, выбери для развёртывания регион с более высокой квотой. Подробнее см. в официальной документации Vertex AI: Квоты и ограничения Vertex AI.
- Выбрав тип машины, нажми Continue. На этом этапе можно включить мониторинг модели в Vertex AI — дополнительную службу, которая будет отслеживать производительность модели и предоставлять сведения о её поведении. Эта функция необязательна и оплачивается отдельно, поэтому выбирай её исходя из своих потребностей. Нажми Create.
Развёртывание модели в Vertex AI займёт несколько минут (в некоторых регионах — до 30 минут). Когда развёртывание завершится, ты получишь уведомление по электронной почте.
6. Тестирование развёрнутой модели#
После завершения развёртывания Vertex AI предоставит пример интерфейса API для тестирования модели.
Для проверки удалённого инференса можно использовать предоставленную команду cURL или создать собственную клиентскую библиотеку на Python, которая будет отправлять запросы к развёрнутой модели. Перед отправкой изображения на конечную точку /predict не забудь преобразовать его в формат base64.
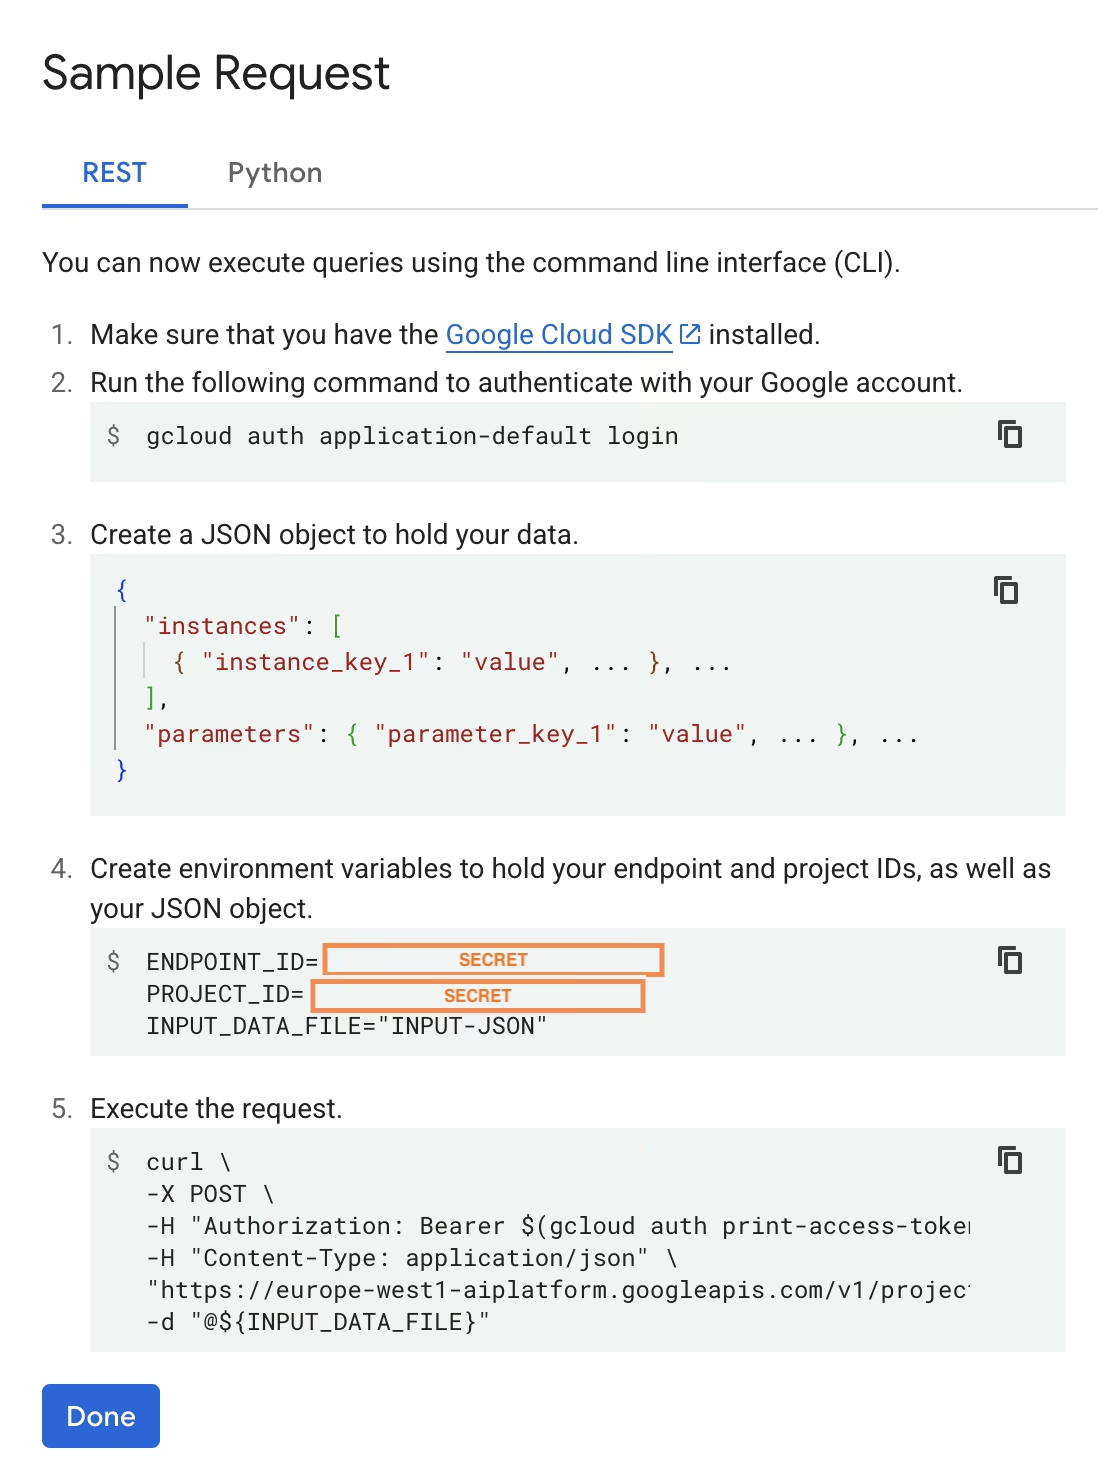
Как и при локальном тестировании, при первом запросе возможна небольшая задержка: Ultralytics потребуется загрузить модель YOLO26 в работающий контейнер.
Ты успешно развернул предварительно обученную модель YOLO26 с Ultralytics в Google Cloud Vertex AI.
Часто задаваемые вопросы#
Да, но сначала нужно экспортировать модель в формат, совместимый с Vertex AI, например TensorFlow, Scikit-learn или XGBoost. Google Cloud предоставляет руководство по запуску моделей
.ptв Vertex с подробным обзором процесса конвертации: Запуск моделей PyTorch в Vertex AI.Обрати внимание: такая настройка будет опираться только на стандартный уровень обслуживания Vertex AI и не будет поддерживать расширенные возможности фреймворка Ultralytics. Vertex AI полностью поддерживает модели в контейнерах и может автоматически масштабировать их в соответствии с конфигурацией развёртывания, поэтому ты сможешь использовать все возможности моделей Ultralytics YOLO без преобразования в другой формат.
FastAPI обеспечивает высокую пропускную способность для задач инференса. Асинхронная поддержка позволяет обрабатывать несколько параллельных запросов, не блокируя основной поток, что важно при обслуживании моделей компьютерного зрения.
Автоматическая проверка запросов и ответов в FastAPI помогает сократить количество ошибок времени выполнения в рабочих сервисах инференса. Это особенно важно для API обнаружения объектов, где критически важно, чтобы входные данные имели согласованный формат.
FastAPI создаёт минимальную вычислительную нагрузку в конвейере инференса, оставляя больше ресурсов для выполнения модели и обработки изображений.
FastAPI также поддерживает SSE (Server-Sent Events), что полезно для потокового инференса.
Это особенность Google Cloud Platform, обеспечивающая гибкость: регион нужно выбирать для каждой используемой службы. При развёртывании модели в контейнере на Vertex AI важнее всего выбрать регион для Model Registry. От него зависит доступность типов машин и квот для развёртывания модели.
Кроме того, если ты планируешь расширить эту конфигурацию и хранить данные предсказаний или результаты в Cloud Storage либо BigQuery, используй тот же регион, что и для Model Registry. Так ты уменьшишь задержку и обеспечишь высокую пропускную способность при доступе к данным.